


GPT-6.1 Terra giảm nửa giá: Rẻ hơn liệu có sửa bug rẻ hơn?
OpenAI lại đang cạnh tranh bằng giá.
Giá API tiêu chuẩn của GPT-6.1 Terra là 1 USD cho mỗi triệu token đầu vào và 5 USD cho mỗi triệu token đầu ra — thấp hơn khoảng 50% so với thế hệ trước. Nhưng đơn giá rẻ hơn không có nghĩa là một tác vụ hoàn thành sẽ rẻ hơn. Khi chọn model, hãy so sánh chi phí trên mỗi tác vụ được chấp nhận: chi phí model cộng với công sức dọn dẹp của con người, chia cho số tác vụ vượt qua khâu nghiệm thu. Một model rẻ nhưng tỷ lệ đạt thấp và phải thử lại nhiều lần thì tổng chi phí vẫn có thể cao hơn.
Sau khi Terra ra mắt, giá cả trở thành chủ đề được bàn tán nhiều nhất. Nếu giá niêm yết giảm một nửa, liệu việc viết code và sửa bug có cũng rẻ đi một nửa? Bài viết này sẽ đi qua các ví dụ để xem thực tế điều gì xảy ra.
GPT-6.1 Terra là mô hình như thế nào?
GPT-6.1 Terra là mô hình nhanh và hiệu quả của OpenAI, hướng đến việc cân bằng giữa suy luận thị giác, com
OpenAI định vị đây là một sự cân bằng mới giữa tốc độ, năng lực và chi phí. Kịch bản điển hình được nêu trong thông báo là tự động hóa với khối lượng lớn, chẳng hạn như đọc hóa đơn đến và nhập thông tin chi tiết vào phần mềm kế toán.
Giá cả và khả năng sử dụng
Tên model API là gpt-6.1-terra. Giá API tiêu chuẩn là 1 USD cho mỗi triệu token đầu vào, 0,05 USD cho mỗi triệu token đầu vào được lưu cache và 5 USD cho mỗi triệu token đầu ra. Mức giá API tiêu chuẩn này thấp hơn 50% so với GPT-5.6 Terra và GPT-6.1 Sol.
Người dùng Plus, Pro, Enterprise và Edu có thể sử dụng model này trong ChatGPT Work và Codex; lập trình viên có thể gọi nó thông qua OpenAI API. OpenAI cũng lưu ý rằng với cùng một hạn mức sử dụng trong ChatGPT Work và Codex, bạn có thể hoàn thành nhiều tác vụ hơn so với GPT-5.6 Terra.
Kết quả năng lực
Các con số dưới đây là benchmark do OpenAI công bố.
- Sử dụng máy tính: Trên Agents' Last Exam ở mức reasoning trung bình, điểm số cao hơn GPT-5.6 Terra khoảng 15 điểm phần trăm với chi phí chỉ bằng khoảng một phần ba. Trên OSWorld 2.1, mức reasoning trung bình đã vượt kết quả tốt nhất của GPT-5.6 Terra.
- Suy luận thị giác: Trên MMMU-Pro, nó vượt GPT-5.6 Terra ở mọi mức reasoning.
- Độ chính xác thực tế: Trên bài kiểm tra nội bộ của OpenAI được xây dựng từ những prompt dễ gây lỗi, tỷ lệ lỗi ở mức reasoning thấp giảm từ 53.6% xuống 16.7%, và xuống 4.3% ở mức reasoning tối đa.
- Kỹ thuật phần mềm: Trên Terminal-Bench 4.0 (lập trình dòng lệnh), nó giải được 50.3% nhiệm vụ ở mức reasoning tối đa; điểm công bố của GPT-5.6 Terra là 21.5%.
- Tốc độ: Hoàn thành nhiệm vụ nhanh hơn GPT-6 Astra và GPT-6.1 Sol hơn 3 lần.
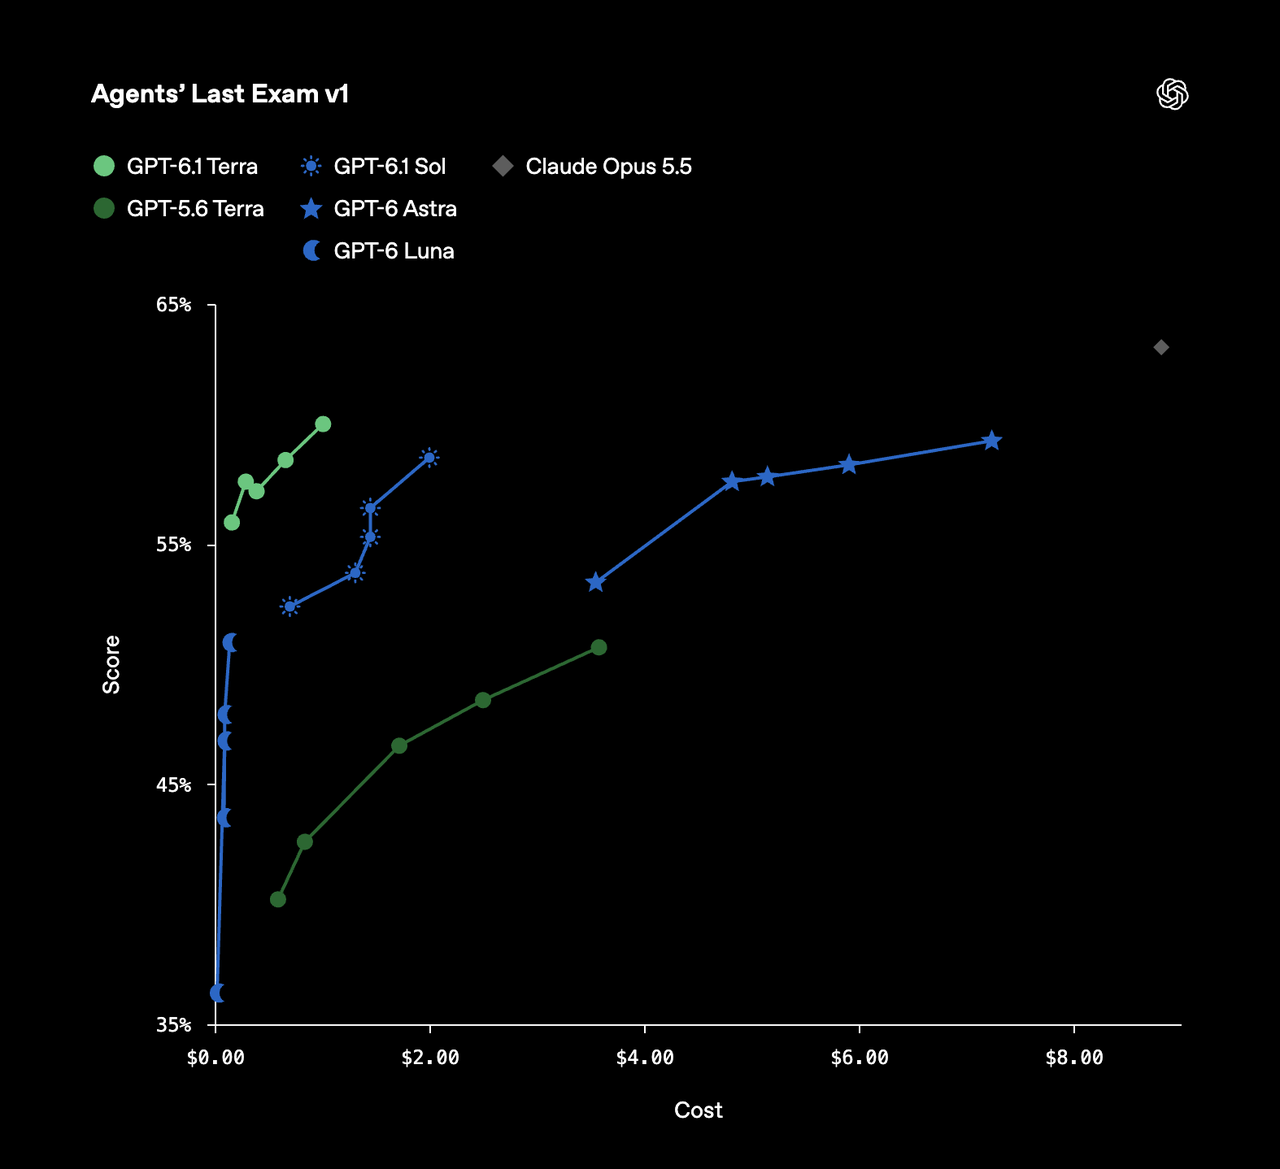
OpenAI cũng cho biết với những công việc lập trình phức tạp nhất, GPT-6.1 Sol và GPT-6 Astra vẫn là lựa chọn tốt hơn. Ranh giới đó chính là cơ sở cho các quy tắc chọn nhiệm vụ ở phần sau của bài viết này.
An toàn và căn chỉnh
OpenAI cho biết năng lực an ninh mạng của Terra đạt mức rủi ro Critical trong Preparedness Framework của mình, đồng thời vẫn giữ các lớp bảo vệ được xây dựng cho GPT-6 Astra. Trong các đánh giá về căn chỉnh, Terra có khả năng cao hơn GPT-5.6 Terra trong việc bám sát phạm vi nhiệm vụ và mô tả chính xác những giới hạn của bản thân. Ở các bài kiểm tra prompt injection, nó cũng thể hiện khả năng chống lại các chỉ dẫn độc hại một cách vững vàng. Chi tiết có trong system card chính thức.
“Một phần mười” và “một phần chín” thực sự đang so sánh điều gì
Phát biểu phổ biến nhất đang được lan truyền là “một phần mười”. Thông báo có hai câu nằm gần nhau với đối tượng so sánh khác nhau.
Thứ nhất, trên Agents' Last Exam, hiệu năng của Terra tương đương GPT-6 Astra trong khi mỗi token có giá chỉ bằng khoảng một phần mười. Đây là so sánh đơn giá token, với Astra, trên các tác vụ sử dụng máy tính.
Thứ hai, ở mức nỗ lực suy luận tối đa, hiệu quả token của Terra cao hơn Claude Opus 5.5 hơn 3 lần, và mỗi token có giá chỉ bằng khoảng một phần tư, nên chi phí cho mỗi tác vụ vào khoảng một phần chín.
Không phát biểu nào trong hai điều trên có nghĩa là sửa một lỗi tốn một phần mười chi phí. Phát biểu thứ hai đã dùng cách diễn đạt theo chi phí mỗi tác vụ — bản thân OpenAI cũng không đánh đồng đơn giá với tổng chi phí.
Vì sao đơn giá thấp không đồng nghĩa với tổng hoá đơn thấp
Nếu chỉ so sánh giá trên mỗi triệu token, ta sẽ bỏ sót ba loại chi phí.
- Một tác vụ hiếm khi chỉ cần một lần thử. Nếu bản sửa lỗi đầu tiên không qua được kiểm thử, bạn phải thử lại kèm log lỗi; mỗi vòng lặp thêm đều tính phí input và output thêm một lần nữa.
- Các lần thử thất bại vẫn bị tính phí. Một bản vá sai vẫn tiêu tốn token; khoản chi đó không được hoàn lại.
- Thất bại cần con người dọn dẹp. Mười lăm phút của kỹ sư để gỡ lỗi một thay đổi tồi từ model có thể tốn hơn hàng chục lần gọi API. Vì vậy, đơn giá thấp chỉ là điều kiện cần. Một model rẻ hơn nhưng có tỷ lệ vượt qua thấp hơn rõ rệt vẫn có thể tốn kém hơn về tổng thể. Khi tỷ lệ vượt qua tương đương nhau, đơn giá thấp mới thực sự trở thành khoản tiết kiệm.
Một số thảo luận công khai dùng một trường hợp duy nhất để lập luận rằng model rẻ hơn là lựa chọn hời hơn — ví dụ hoàn thành một game nhỏ trong vài phút với chi phí một hai đô la. Những câu chuyện đó rất sinh động, nhưng nếu thiếu một tiêu chuẩn nghiệm thu chung, và không nói rõ sản phẩm bàn giao có qua được kiểm thử hay phải làm lại, thì rất khó quy đổi thành chi phí trên mỗi tác vụ được nghiệm thu. Các case study được kể lại ở đây chưa được kiểm chứng độc lập; chúng chỉ là bối cảnh cho luận điểm này.
Hóa đơn được cấu thành từ những gì
Theo mức giá chính thức, chi phí của một lần gọi là tổng của ba phần.
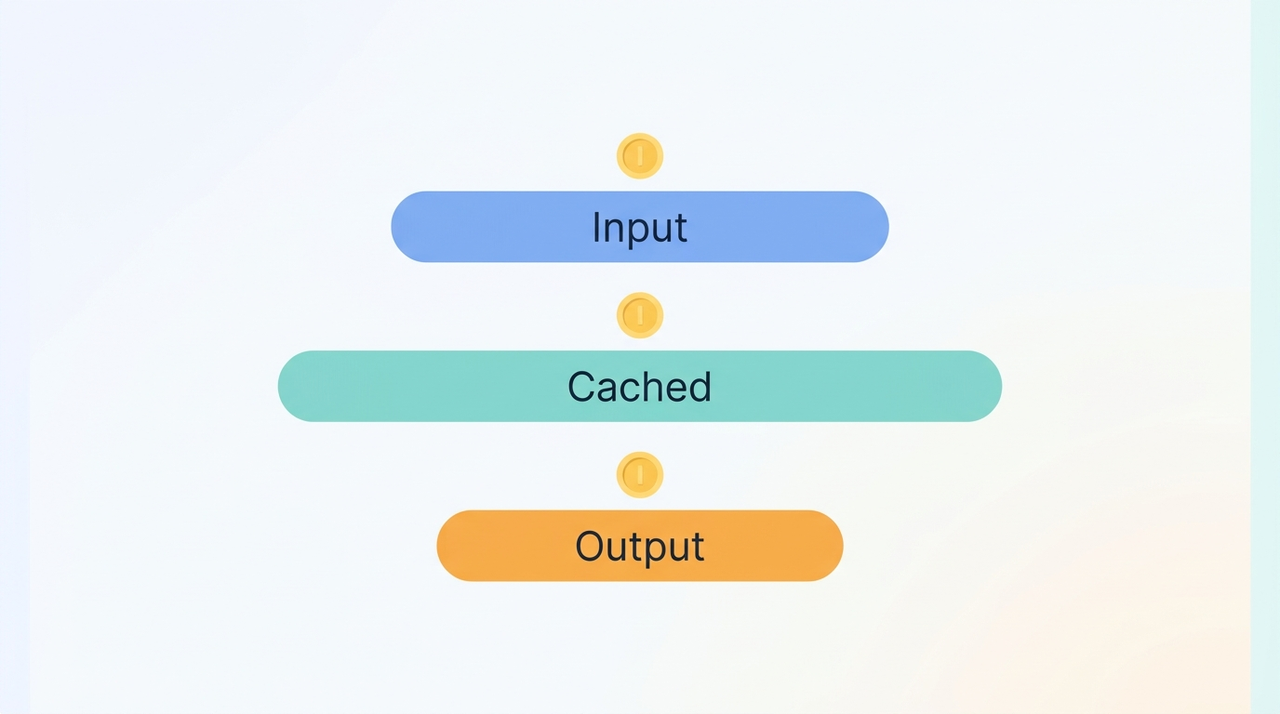
Input là các tệp mã nguồn, log lỗi và prompt, được tính 1 USD mỗi triệu token. Cached input là phần ngữ cảnh lặp lại qua các lần thử lại, được tính 0.05 USD mỗi triệu token — bằng một phần hai mươi so với input thông thường. Output là các bản vá, phần giải thích và các token suy luận, được tính 5 USD mỗi triệu token — gấp 5 lần đơn giá input.
Cache quan trọng nhất ở các lần thử lại. Mã nguồn và ngữ cảnh trước đó xuất hiện vòng này qua vòng khác; khi cache trúng, chi phí biên của một vòng nữa giảm mạnh. Việc cache có trúng hay không phụ thuộc vào tính nhất quán của tiền tố và các điều kiện khác; quy tắc chính xác và TTL theo tài liệu của OpenAI. Khi thiết kế prompt, hãy đặt các ghi chú dự án ổn định và nội dung tệp lên trước, còn phần văn bản lỗi của vòng này đặt sau cùng, để cache dễ trúng hơn.
Output đắt, nên việc nâng reasoning effort sẽ làm chi phí mỗi lần gọi tăng lên khi output tăng.
Năm bước từ đơn giá đến tổng hóa đơn
- Đơn giá: tra cứu bảng giá chính thức cho input, cached input và output.
- Số lần thử: ghi lại mỗi tác vụ cần bao nhiêu vòng và mỗi vòng dùng bao nhiêu token.
- Nghiệm thu: viết rõ tiêu chí đạt ngay từ đầu—các bài test được chỉ định đều pass, không gây regression trên các test hiện có, không sửa file test để ép cho pass.
- Dọn dẹp thủ công: ghi lại số phút con người phải can thiệp sau khi model thất bại, quy đổi theo một mức giá theo giờ duy nhất.
- Tổng: áp dụng công thức bên dưới.
Chi phí cho mỗi tác vụ được nghiệm thu = (tổng chi phí model + chi phí dọn dẹp thủ công) / số tác vụ được nghiệm thu
“Được nghiệm thu” ở đây bao gồm cả những tác vụ chỉ pass sau khi con người dọn dẹp; nếu không, công thức sẽ che mất chi phí của thất bại. Để đánh giá riêng bản thân model, cũng cần theo dõi tỷ lệ tác vụ pass mà không cần con người hỗ trợ.
Ví dụ tính toán: đơn giá bằng một nửa, nhưng tổng hoá đơn gấp hơn 10 lần
Đây là một ví dụ tính toán. Toàn bộ tham số đều là giả định; chúng không đại diện cho tỉ lệ pass thực tế của Terra hay bất kỳ model nào khác.
Giả định:
- Mỗi lần thử dùng 10.000 token đầu vào không cache, 30.000 token đầu vào đã cache và 8.000 token đầu ra.
- Tối đa 3 lần thử cho mỗi task; dừng khi thành công.
- Nếu cả 3 lần đều thất bại, việc dọn dẹp thủ công mất 15 phút với mức $60/giờ → $15.
- Model A dùng đơn giá của Terra với xác suất pass 40% cho mỗi lần thử.
- Model B có chi phí gấp 2 lần đơn giá của Terra với xác suất pass 80% cho mỗi lần thử.
- Với đơn giá của Terra, một lần thử tốn $0.01 đầu vào + $0.0015 đã cache + $0.04 đầu ra = $0.0515. Đoạn Python dưới đây tái tạo lại toàn bộ các con số.
def cost_per_accepted_task(p, price_mult, cap=3, manual_fix=15.0):
    # Chi phí mỗi lần thử (USD) theo đơn giá chuẩn của Terra trong ví dụ
    per_attempt = (10_000 * 1 + 30_000 * 0.05 + 8_000 * 5) / 1_000_000 * price_mult
    fail_all = (1 - p) ** cap                                   # xác suất tất cả các lần thử đều thất bại
    expected_attempts = sum((1 - p) ** i for i in range(cap))   # số lần thử kỳ vọng
    model_cost = expected_attempts * per_attempt
    manual_cost = fail_all * manual_fix                         # chi phí dọn dẹp thủ công kỳ vọng sau khi thất bại hoàn toàn
    return per_attempt, expected_attempts, fail_all, model_cost, manual_cost, model_cost + manual_cost

print(cost_per_accepted_task(0.4, 1))  # Model A: đơn giá Terra
print(cost_per_accepted_task(0.8, 2))  # Model B: đơn giá gấp 2 lần
Kết quả:
| Hạng mục | Model A (giá 1×, pass 40%) | Model B (giá 2×, pass 80%) |
|---|---|---|
| Chi phí mỗi lần thử | $0.0515 | $0.103 |
| Số lần thử kỳ vọng | 1.96 | 1.24 |
| Chi phí cho model | $0.101 | $0.128 |
| Xác suất tất cả đều thất bại | 21.6% | 0.8% |
| Chi phí dọn dẹp thủ công kỳ vọng | $3.24 | $0.12 |
| Chi phí cho mỗi task được chấp nhận | ~$3.34 | ~$0.25 |
Với các giả định trên, Model A có đơn giá bằng một nửa nhưng tổng chi phí gấp khoảng 13 lần Model B; chi phí dọn dẹp thủ công chiếm phần lớn. Nếu chỉ nhìn vào chi phí cho model, A tốn $0.101 mỗi task còn B là $0.128 — A rẻ hơn một chút.
Điều ngược lại cũng đúng. Nếu tỉ lệ pass của A tăng lên gần bằng B, chi phí dọn dẹp thủ công giảm nhanh và lợi thế về giá sẽ lộ ra. Điểm mấu chốt không phải là đơn giá — mà là tỉ lệ pass, và việc thất bại tốn bao nhiêu thời gian của con người.
Cách thiết kế một thí nghiệm có thể tái lập
Để kiểm chứng điều này trên dự án của chính bạn:
- Chọn task. Hãy chọn một bug có thể tái hiện ổn định, kèm một test đang fail, một repo công khai và một commit cố định. Độ khó ở mức trung bình: không phải loại giải quyết được ngay lần đầu, cũng không phải loại vô vọng.
- Tiêu chí nghiệm thu. Toàn bộ các test được chỉ định đều pass; không gây regression trên các test hiện có; không được sửa file test để ép pass.
- Nhóm kiểm soát. Cùng prompt, cùng snapshot mã nguồn, cùng giới hạn số lần thử lại. Giữ kênh tính phí nhất quán — không trộn số liệu từ API với hạn mức của gói subscription. Chạy mỗi model nhiều lần; chỉ một lần chạy thì kết quả rất nhiễu.
- Các trường cần ghi lại. Nên log những thông tin sau ở mỗi lần thử; số token có thể lấy từ các trường usage của API. | Hạng mục | Model A (giá 1×, 40% pass) | Model B (giá 2×, 80% pass) | | --- | --- | --- | | Chi phí mỗi lần thử | $0.0515 | $0.103 | | Số lần thử kỳ vọng | 1.96 | 1.24 | | Chi phí model | $0.101 | $0.128 | | Xác suất tất cả đều thất bại | 21.6% | 0.8% | | Chi phí con người dọn dẹp kỳ vọng | $3.24 | $0.12 | | Chi phí mỗi task được chấp nhận | ~$3.34 | ~$0.25 |
Quy tắc phân chia công việc khi chọn model
OpenAI cũng cho biết những công việc coding phức tạp nhất vẫn nên dùng GPT-6.1 Sol hoặc GPT-6 Astra. Kết hợp với bảng chi phí ở trên, bạn có thể bắt đầu bằng một cách phân chia sơ bộ rồi điều chỉnh lại bằng dữ liệu của chính mình.
Các bản sửa lỗi trong phạm vi hẹp và đã có test bao phủ là chỗ tốt để thử Terra trước. Tỉ lệ pass thường cao hơn, số lần retry ít hơn, và mức giá đơn vị thấp sẽ thể hiện rõ hơn. Những công việc lặp đi lặp lại với khối lượng lớn cũng phù hợp để thử Terra trước — ở quy mô lớn, khoảng cách về giá đơn vị sẽ bị khuếch đại.
Việc refactor xuyên module hoặc thay đổi dependency rối rắm nên được đánh giá trên một model mạnh hơn trước. Khi những việc đó thất bại, chi phí dọn dẹp thủ công rất lớn; số tiền tiết kiệm được trên một lần gọi sẽ không đủ bù.
Nếu yêu cầu còn mơ hồ và thiếu test, hãy bổ sung test trước khi chọn model. Không có tiêu chí nghiệm thu thì bạn không thể tính được chi phí cho mỗi task được chấp nhận, và mọi lựa chọn model chỉ là cảm tính.
Cách phân chia này chỉ là điểm khởi đầu. Bằng chứng đáng tin hơn chính là dữ liệu task của bạn. Hãy chạy một lô task, tính chi phí cho mỗi task được chấp nhận, rồi quyết định công việc nào giao cho model nào.
Cố định môi trường nghiệm thu với ServBay
Khi bạn so sánh chi phí, sự trôi dạt của môi trường sẽ làm kết quả trở nên mờ mịt. Cùng một lỗi có thể hành xử khác nhau giữa các phiên bản ngôn ngữ hoặc cơ sở dữ liệu. Lần thất bại đầu tiên của một mô hình có thể là do code tệ — hoặc cũng có thể chỉ là do các phụ thuộc không khớp nhau. Hai kiểu thất bại đó không nên bị trộn chung vào một sổ ghi.
ServBay có thể ghim PHP, Node.js, Python và các runtime khác trên máy của bạn, cùng với cấu hình cơ sở dữ liệu và site. Một khi môi trường nghiệm thu đã được cố định, mọi lần thử của từng mô hình đều chạy trong cùng một điều kiện, nhờ đó số lần thử và tỷ lệ vượt qua trở nên có thể so sánh được với nhau.
ServBay AI Gateway cũng hoạt động tốt như một điểm vào thống nhất cục bộ: gọi bằng virtual key và giữ key thật ở phía gateway; mức sử dụng, chi phí và độ trễ được tổng hợp về một nơi; và bạn có thể trỏ Claude Code, Codex cùng các công cụ tương tự về chung một endpoint cục bộ. Các đường dẫn tương thích với OpenAI / Anthropic / Gemini đều có sẵn.
FAQ
Đơn giá model thấp hơn có luôn giúp tiết kiệm chi phí?
Không hẳn. Đơn giá chỉ là một phần của tổng chi phí. Với tỷ lệ pass thấp, nhiều lần thử lại và khối lượng lớn công việc dọn dẹp do con người làm, một model rẻ vẫn có thể tốn kém hơn. Chỉ số đúng để đo là chi phí trên mỗi tác vụ được chấp nhận.
Cách tính chi phí trên mỗi tác vụ được chấp nhận?
Cộng tổng chi phí dành cho model với chi phí con người dọn dẹp, rồi chia cho số tác vụ được chấp nhận. Chi phí model phải bao gồm cả những lần thử thành công lẫn thất bại.
Giá API của GPT-6.1 Terra là bao nhiêu?
Theo thông báo ra mắt, giá API tiêu chuẩn là $1 cho mỗi triệu token đầu vào, $0.05 cho mỗi triệu token đầu vào được cache và $5 cho mỗi triệu token đầu ra. Giá có thể thay đổi; hãy dùng trang giá chính thức của OpenAI.
Terra có phù hợp với các tác vụ lập trình phức tạp không?
Trên Terminal-Bench 4.0 ở mức suy luận tối đa, Terra giải được 50.3% số tác vụ — một bước nhảy rõ ràng so với thế hệ trước. OpenAI cũng cho biết những công việc lập trình phức tạp nhất vẫn phù hợp hơn với GPT-6.1 Sol và GPT-6 Astra.
Cache hit có thể làm sai lệch việc so sánh chi phí không?
Có. Những tác vụ có tỷ lệ cache hit cao sẽ tốn ít hơn so với mức ước tính dựa trên giá đầu vào thông thường. Khi chạy so sánh, hãy ghi lại số token được cache của từng model và giữ cấu trúc prompt nhất quán.
Copilot có được tính phí giống như API không?
Không. Thông báo ra mắt không nêu rõ cách tính phí Copilot; hãy xem tài liệu tính phí chính thức của GitHub. Đừng áp dụng thẳng đơn giá token của API.
Tóm tắt
Terra đẩy giá, tốc độ và khả năng coding tiến lên cùng lúc — điều đó đã rõ qua các con số của OpenAI. Những con số đó đến từ những benchmark cụ thể. Còn liệu công việc của chính bạn có trở nên rẻ hơn hay không thì vẫn cần đến tiêu chí chấp nhận của bạn.
Cạnh tranh giữa các mô hình đang dịch chuyển từ điểm số trên bảng xếp hạng sang câu hỏi một tác vụ hoàn thành tốn bao nhiêu tiền và thời gian, và việc bàn giao có giữ được độ ổn định hay không. Với lập trình viên, một bước thực tế là lấy một bug có thể tái hiện, ghi lại token và số phút làm việc của con người cho mỗi lần thử, tính chi phí cho mỗi tác vụ được chấp nhận, rồi từ đó chọn mô hình.
All rights reserved
