

Linear Regression trong Data Science: Hiểu bản chất thuật toán hồi quy tuyến tính và thực hành với Python
Khi bắt đầu học Machine Learning, Linear Regression (Hồi quy tuyến tính) thường là một trong những thuật toán đầu tiên chúng ta tiếp cận.
Thoạt nhìn, Linear Regression khá đơn giản: tìm một đường thẳng phù hợp với dữ liệu để dự đoán giá trị. Tuy nhiên, đằng sau thuật toán này là nhiều khái niệm quan trọng như hàm mất mát, tối ưu hóa, overfitting và đánh giá mô hình.
Điều thú vị là dù đã xuất hiện từ rất lâu, Linear Regression vẫn được sử dụng rộng rãi trong Data Science, từ dự báo doanh thu, phân tích hiệu quả quảng cáo đến nghiên cứu các yếu tố ảnh hưởng đến giá bất động sản.
Trong bài viết này, chúng ta sẽ cùng tìm hiểu:
- Linear Regression là gì và hoạt động như thế nào?
- Công thức toán học của hồi quy tuyến tính.
- Hàm mất mát và cách mô hình tìm ra các tham số.
- Xây dựng mô hình dự đoán giá nhà bằng Python và Scikit-learn.
- Đánh giá mô hình bằng MAE, RMSE và R².
- Những giả định và sai lầm thường gặp khi sử dụng Linear Regression.
1. Linear Regression là gì?
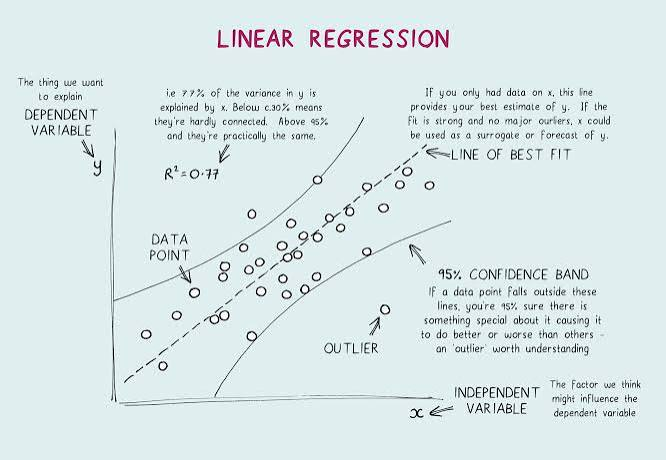
Linear Regression là một phương pháp thống kê và cũng là một thuật toán Supervised Learning (học có giám sát), được sử dụng để mô hình hóa mối quan hệ giữa một biến mục tiêu và một hoặc nhiều biến đầu vào.
Nói đơn giản, thuật toán cố gắng tìm ra một phương trình tuyến tính phù hợp với dữ liệu để dự đoán giá trị liên tục.
Ví dụ, chúng ta có dữ liệu về diện tích và giá bán của một số căn nhà:
| Diện tích (m²) | Giá nhà (triệu đồng) |
|---|---|
| 40 | 950 |
| 50 | 1.150 |
| 60 | 1.350 |
| 70 | 1.550 |
| 80 | 1.750 |
Quan sát bảng dữ liệu, chúng ta thấy diện tích càng lớn thì giá nhà có xu hướng càng cao.
Giả sử mối quan hệ này có thể được biểu diễn bằng phương trình:
Trong đó:
x: Diện tích căn nhà (m²).ŷ: Giá nhà dự đoán (triệu đồng).150: Hệ số chặn (intercept).20: Hệ số hồi quy (coefficient).
Nếu căn nhà có diện tích 90 m², giá dự đoán sẽ là:
Như vậy, mô hình dự đoán căn nhà có giá khoảng 1.950 triệu đồng (1,95 tỷ đồng).
Tất nhiên, giá nhà thực tế còn phụ thuộc vào vị trí, số phòng ngủ, tuổi căn nhà và nhiều yếu tố khác. Đây chỉ là ví dụ đơn giản để hiểu nguyên lý hồi quy tuyến tính.
2. Công thức toán học của Linear Regression
2.1. Simple Linear Regression
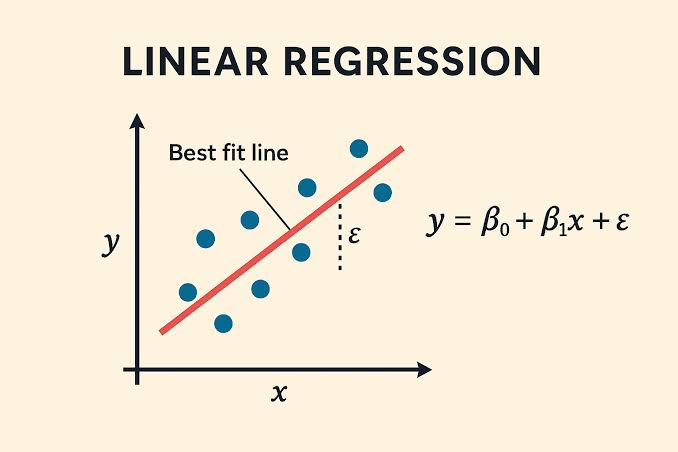
Hồi quy tuyến tính đơn là mô hình chỉ sử dụng một biến đầu vào.
Công thức tổng quát:
Trong đó:
ŷ: Giá trị dự đoán.x: Biến đầu vào.β₀: Hệ số chặn.β₁: Hệ số hồi quy.
Hệ số β₁ cho biết mức thay đổi dự đoán của y khi x tăng một đơn vị.
Ví dụ:
Nếu x là diện tích nhà và y là giá nhà tính bằng triệu đồng, mô hình cho biết mỗi khi diện tích tăng thêm 1 m², giá dự đoán tăng khoảng 15 triệu đồng.
Lưu ý rằng đây là mối quan hệ được mô hình ước lượng, không tự động chứng minh diện tích là nguyên nhân duy nhất làm tăng giá.
2.2. Multiple Linear Regression
Trong thực tế, dữ liệu thường có nhiều biến đầu vào.
Ví dụ, để dự đoán giá nhà, chúng ta có thể sử dụng:
- Diện tích.
- Số phòng ngủ.
- Tuổi căn nhà.
- Khoảng cách đến trung tâm.
Khi đó, mô hình hồi quy tuyến tính đa biến có dạng:
Trong đó:
x₁, x₂, ..., xₙlà các đặc trưng đầu vào.β₁, β₂, ..., βₙlà các hệ số tương ứng.β₀là hệ số chặn.
Điểm quan trọng cần nhớ là Linear Regression tuyến tính theo các tham số, không nhất thiết mọi đặc trưng đầu vào đều phải là biến gốc.
Chẳng hạn, mô hình sau vẫn là tuyến tính theo tham số:
Mặc dù có thành phần bậc hai, các hệ số vẫn xuất hiện tuyến tính trong phương trình.
Đây cũng là cơ sở của Polynomial Regression.
3. Linear Regression học từ dữ liệu như thế nào?
Đây là phần quan trọng nhất để hiểu bản chất thuật toán.
Giả sử chúng ta có nhiều điểm dữ liệu thực tế. Nhiệm vụ của mô hình là tìm ra các hệ số sao cho đường hồi quy có thể dự đoán các điểm dữ liệu một cách phù hợp nhất.
Nhưng làm thế nào để xác định một đường hồi quy là tốt?
Câu trả lời nằm ở Loss Function (Hàm mất mát).
3.1. Mean Squared Error (MSE)
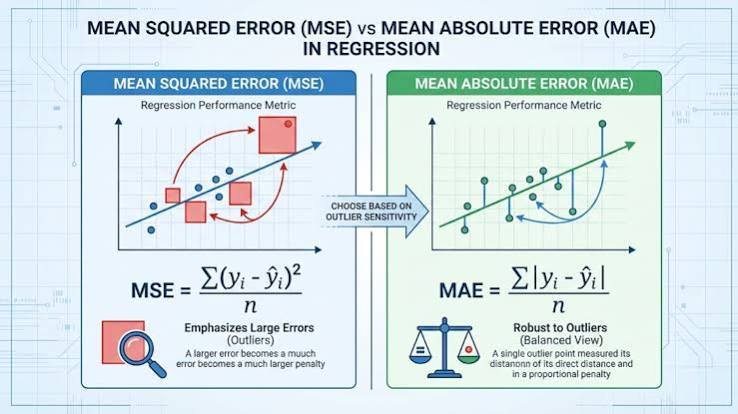
Một trong những hàm mất mát phổ biến của Linear Regression là Mean Squared Error.
Công thức:
Trong đó:
n: Số lượng mẫu.yᵢ: Giá trị thực tế.ŷᵢ: Giá trị dự đoán.
MSE đo trung bình bình phương sai lệch giữa giá trị thực tế và giá trị dự đoán.
Ví dụ, giả sử có ba căn nhà với dữ liệu:
| Giá thực tế | Giá dự đoán | Sai số |
|---|---|---|
| 1.000 | 950 | 50 |
| 1.500 | 1.600 | -100 |
| 2.000 | 1.900 | 100 |
Khi đó:
MSE càng nhỏ thì dự đoán càng gần dữ liệu thực tế theo tiêu chí bình phương sai số.
Tuy nhiên, cần lưu ý rằng MSE nhạy với những sai số lớn vì mỗi sai số đều được bình phương.
3.2. Ordinary Least Squares (OLS)
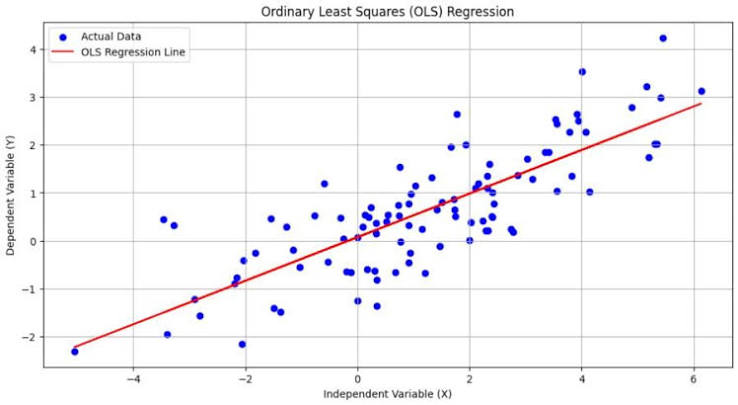
Linear Regression thường tìm các hệ số bằng phương pháp Ordinary Least Squares (bình phương tối thiểu thông thường).
Mục tiêu là tìm bộ tham số giúp tổng bình phương sai số nhỏ nhất:
Với ký hiệu ma trận, nghiệm OLS có thể được viết thành:
Công thức trên áp dụng khi ma trận XᵀX khả nghịch, với X đã bao gồm cột hệ số chặn.
Trong thực tế, các thư viện thường sử dụng phương pháp tính số ổn định hơn như QR decomposition hoặc SVD, thay vì trực tiếp tính ma trận nghịch đảo.
3.3. Gradient Descent
Ngoài nghiệm OLS, chúng ta còn có thể tìm tham số bằng Gradient Descent.
Gradient Descent là phương pháp tối ưu hóa lặp, trong đó các tham số được cập nhật theo hướng làm giảm hàm mất mát.
Với tham số θ, công thức cập nhật tổng quát là:
Trong đó:
α: Learning rate.J: Hàm mất mát.∂J/∂θ: Đạo hàm của hàm mất mát theo tham số.
Learning rate quá lớn có thể khiến thuật toán không hội tụ, còn learning rate quá nhỏ có thể làm quá trình tối ưu diễn ra chậm.
Về bản chất, OLS và Gradient Descent là hai cách tìm tham số của mô hình hồi quy tuyến tính. Chúng không phải hai thuật toán dự báo hoàn toàn khác nhau.
4. Thực hành Linear Regression với Python
Sau phần lý thuyết, chúng ta sẽ xây dựng một mô hình dự đoán giá nhà sử dụng Python và thư viện Scikit-learn.
Để thuận tiện cho việc thực hành, ví dụ sử dụng dữ liệu giả lập, không phải giá bất động sản thực tế.
Các thư viện cần thiết gồm:
- NumPy
- Pandas
- Matplotlib
- Scikit-learn
Cài đặt bằng lệnh:
pip install numpy pandas matplotlib scikit-learn
Bước 1: Import thư viện
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import (
    mean_absolute_error,
    mean_squared_error,
    r2_score
)
Bước 2: Tạo bộ dữ liệu
Giả sử giá nhà phụ thuộc vào ba đặc trưng:
- Diện tích (
area_m2). - Số phòng ngủ (
bedrooms). - Tuổi căn nhà (
house_age).
Chúng ta tạo 150 mẫu dữ liệu bằng NumPy.
rng = np.random.default_rng(42)

n = 150

area = rng.uniform(30, 120, n)
bedrooms = rng.integers(1, 5, n)
house_age = rng.integers(0, 26, n)

price = (
    250
    + 18 * area
    + 80 * bedrooms
    - 9 * house_age
    + rng.normal(0, 120, n)
)

df = pd.DataFrame({
    "area_m2": area,
    "bedrooms": bedrooms,
    "house_age": house_age,
    "price_million_vnd": price
})

print(df.head())
Trong ví dụ này, giá nhà được tính bằng triệu đồng.
Chúng ta cố tình tạo dữ liệu theo quan hệ gần tuyến tính và thêm nhiễu ngẫu nhiên để mô phỏng sự biến động.
Bước 3: Khám phá và trực quan hóa dữ liệu
Trước khi huấn luyện mô hình, nên tìm hiểu mối quan hệ giữa các đặc trưng và biến mục tiêu.
plt.figure(figsize=(8, 5))

plt.scatter(
    df["area_m2"],
    df["price_million_vnd"],
    alpha=0.7
)

plt.xlabel("Dien tich (m2)")
plt.ylabel("Gia nha (trieu VND)")
plt.title("Moi quan he giua dien tich va gia nha")

plt.show()
Biểu đồ scatter cho thấy xu hướng giá nhà tăng theo diện tích.
Tuy nhiên, các điểm không nằm hoàn toàn trên một đường thẳng vì giá còn phụ thuộc vào số phòng ngủ, tuổi nhà và nhiễu ngẫu nhiên.
Đây chính là lý do chúng ta nên sử dụng Multiple Linear Regression thay vì chỉ dựa vào một biến đầu vào.
Bước 4: Chia tập huấn luyện và kiểm thử
Trong Machine Learning, chúng ta cần đánh giá khả năng dự đoán trên dữ liệu chưa được sử dụng để huấn luyện.
Vì vậy, bộ dữ liệu được chia thành:
- Training set: 80%.
- Test set: 20%.
features = [
    "area_m2",
    "bedrooms",
    "house_age"
]

X = df[features]
y = df["price_million_vnd"]

X_train, X_test, y_train, y_test = train_test_split(
    X,
    y,
    test_size=0.2,
    random_state=42
)

print("Training samples:", len(X_train))
print("Testing samples:", len(X_test))
Việc tách dữ liệu trước khi huấn luyện giúp hạn chế nguy cơ đánh giá mô hình quá lạc quan.
Nếu dữ liệu có thứ tự thời gian, chúng ta không nên tự động chia ngẫu nhiên như ví dụ này mà cần sử dụng cách chia phù hợp với thời gian.
Bước 5: Huấn luyện mô hình Linear Regression
Scikit-learn giúp việc xây dựng mô hình trở nên đơn giản.
model = LinearRegression()

model.fit(X_train, y_train)

print("Intercept:", model.intercept_)
print("Coefficients:", model.coef_)
Trong đó:
fit(): Huấn luyện mô hình.intercept_: Hệ số chặn.coef_: Các hệ số hồi quy tương ứng với từng đặc trưng.
Khi chạy ví dụ trên, các hệ số thu được xấp xỉ:
| Tham số | Giá trị |
|---|---|
| Intercept | 269,29 |
| Diện tích | 17,67 |
| Số phòng ngủ | 83,66 |
| Tuổi nhà | -10,00 |
Mô hình có dạng:
Trong đó:
x₁: Diện tích.x₂: Số phòng ngủ.x₃: Tuổi nhà.
Theo mô hình giả lập này:
- Khi diện tích tăng thêm 1 m² và các biến khác giữ nguyên, giá dự đoán tăng khoảng 17,67 triệu đồng.
- Khi số phòng ngủ tăng thêm 1 và các biến khác giữ nguyên, giá dự đoán tăng khoảng 83,66 triệu đồng.
- Khi tuổi nhà tăng thêm 1 năm và các biến khác giữ nguyên, giá dự đoán giảm khoảng 10 triệu đồng.
Lưu ý: Đây là cách diễn giải hệ số trong mô hình, không phải kết luận nhân quả về giá nhà ngoài thực tế.
Bước 6: Dự đoán trên tập kiểm thử
Sau khi huấn luyện, chúng ta sử dụng mô hình để dự đoán giá nhà trên dữ liệu test.
y_pred = model.predict(X_test)

results = pd.DataFrame({
    "Actual": y_test.to_numpy(),
    "Predicted": y_pred
})

print(results.head())
Kết quả gồm hai cột:
Actual: Giá thực tế trong dữ liệu giả lập.Predicted: Giá mô hình dự đoán.
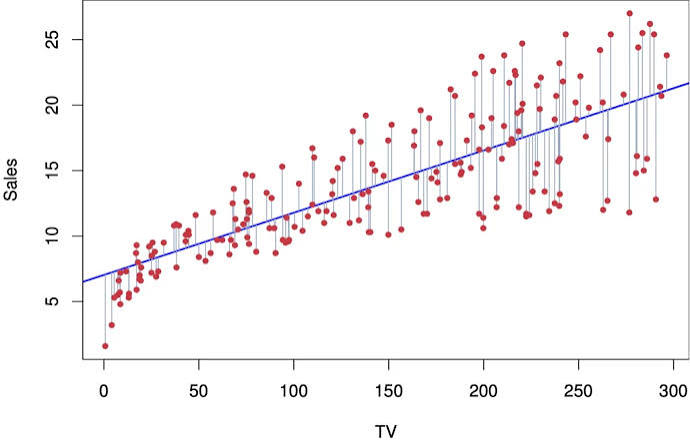
Sự khác biệt giữa hai cột chính là sai số dự báo.
5. Đánh giá mô hình Linear Regression
Một trong những sai lầm phổ biến của người mới học Machine Learning là chỉ xây dựng mô hình mà không đánh giá kết quả.
Đối với Linear Regression, ba chỉ số thường được sử dụng là MAE, RMSE và R².
5.1. Mean Absolute Error (MAE)
MAE đo trung bình giá trị tuyệt đối của sai số dự đoán.
Ưu điểm của MAE là dễ diễn giải vì có cùng đơn vị với biến mục tiêu.
Ví dụ, MAE bằng 100 triệu đồng có nghĩa mức sai lệch tuyệt đối trung bình của mô hình là 100 triệu đồng.
5.2. Root Mean Squared Error (RMSE)
RMSE là căn bậc hai của MSE:
Do bình phương sai số trước khi lấy trung bình, RMSE phản ứng mạnh hơn với những dự đoán sai lệch lớn.
Chỉ số này phù hợp khi chúng ta muốn các sai số lớn bị đánh giá nghiêm khắc hơn.
5.3. R-squared (R²)
R² đo mức độ mô hình cải thiện việc dự đoán so với phương án luôn dự đoán bằng trung bình của tập dữ liệu đánh giá.
Công thức:
Trong đó ȳ là giá trị trung bình thực tế.
R² có thể nhận giá trị âm trên tập test nếu mô hình dự đoán kém hơn phương án dùng giá trị trung bình của tập test.
Giá trị R² cao thường là tín hiệu tích cực, nhưng không nên sử dụng chỉ số này một cách độc lập.
Tính các chỉ số bằng Python
mae = mean_absolute_error(y_test, y_pred)

rmse = np.sqrt(
    mean_squared_error(y_test, y_pred)
)

r2 = r2_score(y_test, y_pred)

print(f"MAE: {mae:.2f}")
print(f"RMSE: {rmse:.2f}")
print(f"R2 Score: {r2:.4f}")
Kết quả khi chạy bộ dữ liệu giả lập:
MAE: 88.45
RMSE: 112.19
R2 Score: 0.9369
Có thể diễn giải:
- MAE khoảng 88,45 triệu đồng: Sai lệch tuyệt đối trung bình của dự đoán.
- RMSE khoảng 112,19 triệu đồng: Mức sai số có chú trọng nhiều hơn đến những dự đoán lệch lớn.
- R² khoảng 0,937: Mô hình có mức độ phù hợp cao trên tập test theo thước đo R².
Các kết quả này khá tốt vì dữ liệu được tạo ra từ một quan hệ gần tuyến tính.
Không nên kỳ vọng mọi bộ dữ liệu thực tế đều đạt R² tương tự. Hiệu quả phụ thuộc vào chất lượng dữ liệu, lựa chọn đặc trưng và mức độ phù hợp của mô hình.
6. Dự đoán giá cho một căn nhà mới
Giả sử chúng ta muốn dự đoán giá của một căn nhà có đặc điểm:
- Diện tích: 80 m².
- Số phòng ngủ: 3.
- Tuổi căn nhà: 5 năm.
Chúng ta thực hiện:
new_house = pd.DataFrame([{
    "area_m2": 80,
    "bedrooms": 3,
    "house_age": 5
}])

predicted_price = model.predict(new_house)[0]

print(
    f"Gia du doan: {predicted_price:.2f} trieu VND"
)
Kết quả:
Gia du doan: 1883.66 trieu VND
Như vậy, mô hình dự đoán giá của căn nhà vào khoảng 1,88 tỷ đồng.
Tuy nhiên, vì đây là dữ liệu giả lập, kết quả chỉ có ý nghĩa minh họa cách sử dụng thuật toán. Không thể dùng mô hình này để định giá bất động sản thật.
7. Phân tích sai số bằng Residual Plot
Ngoài các chỉ số đánh giá, chúng ta nên quan sát phần dư (residual) để kiểm tra mô hình.
Phần dư được tính bằng:
Chúng ta trực quan hóa phần dư như sau:
residuals = y_test - y_pred

plt.figure(figsize=(8, 5))

plt.scatter(
    y_pred,
    residuals,
    alpha=0.7
)

plt.axhline(
    y=0,
    color="red",
    linestyle="--"
)

plt.xlabel("Predicted values")
plt.ylabel("Residuals")
plt.title("Residual Plot")

plt.show()
Nếu mô hình tuyến tính phù hợp, các điểm phần dư thường phân bố quanh đường 0 mà không xuất hiện cấu trúc có hệ thống rõ rệt.
Ngược lại:
- Phần dư có dạng đường cong: Có thể tồn tại quan hệ phi tuyến chưa được mô hình hóa.
- Phần dư phân tán ngày càng rộng: Có thể xuất hiện hiện tượng phương sai sai số thay đổi.
- Một số điểm nằm rất xa: Có thể tồn tại outlier hoặc dự đoán bất thường.
Residual Plot không đủ để khẳng định mọi giả định đều thỏa mãn, nhưng là một công cụ chẩn đoán rất hữu ích.
8. Những giả định quan trọng của Linear Regression
Linear Regression có cấu trúc đơn giản nhưng việc sử dụng đúng vẫn cần hiểu một số giả định.
8.1. Quan hệ tuyến tính theo các tham số
Mô hình giả định giá trị kỳ vọng có điều kiện của biến mục tiêu có thể biểu diễn bằng tổ hợp tuyến tính của các đặc trưng đã chọn.
Nếu quan hệ thực tế phức tạp, có thể cần bổ sung biến tương tác, biến đa thức hoặc lựa chọn mô hình khác.
8.2. Không có đa cộng tuyến hoàn hảo
Nếu một đặc trưng có thể được biểu diễn chính xác bằng tổ hợp tuyến tính của những đặc trưng khác, các hệ số OLS sẽ không được xác định duy nhất.
Đa cộng tuyến mạnh, dù không hoàn hảo, cũng có thể khiến hệ số nhạy với những thay đổi nhỏ của dữ liệu.
8.3. Sai số có kỳ vọng bằng 0 khi biết các đặc trưng
Đây là giả định quan trọng nếu muốn diễn giải các hệ số OLS theo phương pháp thống kê thông thường.
Nếu thiếu những biến quan trọng hoặc xảy ra quan hệ nội sinh, hệ số ước lượng có thể bị sai lệch.
8.4. Phương sai sai số không đổi
Giả định này còn gọi là Homoscedasticity.
Nếu phương sai sai số thay đổi theo các đặc trưng, mô hình vẫn có thể tạo dự đoán, nhưng những kết luận thống kê dựa trên sai số chuẩn thông thường có thể không còn đáng tin cậy.
8.5. Tính độc lập của sai số
Giả định độc lập có vai trò đặc biệt quan trọng đối với việc suy luận thống kê.
Với dữ liệu chuỗi thời gian, sai số có thể tương quan theo thời gian. Khi đó, chúng ta cần sử dụng các phương pháp đánh giá và mô hình hóa phù hợp.
Một điểm thường bị hiểu nhầm là phần dư bắt buộc phải có phân phối chuẩn để Linear Regression dự đoán được.
Thực tế, giả định phân phối chuẩn không phải điều kiện bắt buộc để thực hiện dự đoán bằng OLS. Nó chủ yếu liên quan đến một số kết quả suy luận thống kê, đặc biệt trong mẫu nhỏ.
9. Những sai lầm phổ biến khi sử dụng Linear Regression
Sai lầm 1: Không tách training và testing data
Nếu đánh giá mô hình trên chính dữ liệu đã huấn luyện, kết quả có thể quá lạc quan.
Cần sử dụng tập kiểm thử độc lập hoặc Cross-Validation phù hợp.
Sai lầm 2: Bỏ qua Data Leakage
Data Leakage xảy ra khi quá trình huấn luyện sử dụng thông tin không thực sự có sẵn tại thời điểm dự đoán.
Ví dụ, sử dụng dữ liệu được ghi nhận sau thời điểm bán nhà để dự đoán giá tại thời điểm rao bán có thể làm mô hình đạt điểm cao giả tạo.
Để tránh leakage, mọi bước tiền xử lý có học tham số từ dữ liệu nên được fit trên tập train, sau đó áp dụng lên tập test.
Có thể sử dụng Pipeline của Scikit-learn để quản lý quy trình này.
Sai lầm 3: Cho rằng R² cao đồng nghĩa mô hình tốt
R² cao không đảm bảo mô hình phù hợp với mục tiêu kinh doanh.
Một mô hình có R² tốt nhưng sai số dự đoán vẫn có thể quá lớn so với mức chấp nhận của doanh nghiệp.
Vì vậy, nên đánh giá kết hợp MAE, RMSE, phân tích phần dư và bối cảnh thực tế.
Sai lầm 4: Bỏ qua outlier
Linear Regression sử dụng bình phương sai số nên những điểm dữ liệu bất thường có thể ảnh hưởng đáng kể đến kết quả ước lượng.
Cần tìm hiểu nguyên nhân của outlier thay vì tự động xóa bỏ mọi giá trị khác biệt.
Sai lầm 5: Ngoại suy quá xa phạm vi dữ liệu
Một mô hình được huấn luyện trên những căn nhà có diện tích từ 30 đến 120 m² không nhất thiết dự đoán đáng tin cậy cho một bất động sản rộng 1.000 m².
Linear Regression có thể tạo ra giá trị dự báo cho đầu vào bất kỳ, nhưng không đảm bảo dự báo đó hợp lý ngoài phạm vi dữ liệu đã quan sát.
10. Khi nào nên sử dụng Linear Regression?
Linear Regression phù hợp khi:
- Biến mục tiêu là một giá trị liên tục.
- Quan hệ giữa biến mục tiêu và các đặc trưng có thể được xấp xỉ bằng mô hình tuyến tính.
- Cần mô hình dễ diễn giải.
- Muốn xây dựng một baseline để so sánh với các thuật toán phức tạp hơn.
- Dữ liệu và bối cảnh đáp ứng tương đối tốt các giả định cần thiết.
Một số ứng dụng phổ biến trong Data Science gồm:
Dự báo doanh thu: Ước lượng doanh thu dựa trên chi phí quảng cáo, lượng khách hàng và những yếu tố kinh doanh liên quan.
Phân tích bất động sản: Nghiên cứu mối quan hệ giữa giá nhà, diện tích, vị trí và đặc điểm công trình.
Marketing Analytics: Ước lượng mối liên hệ giữa ngân sách quảng cáo và kết quả chiến dịch.
Phân tích tài chính: Nghiên cứu quan hệ giữa các biến kinh tế và một chỉ số tài chính liên tục.
Tuy nhiên, không phải mọi bài toán đều phù hợp với Linear Regression.
Nếu dữ liệu có quan hệ phi tuyến phức tạp, nhiều tương tác hoặc cấu trúc đặc biệt, có thể cân nhắc những mô hình như Random Forest, Gradient Boosting hoặc các phương pháp phù hợp khác.
Ngoài ra, khi số lượng đặc trưng lớn hoặc xảy ra đa cộng tuyến mạnh, các biến thể như Ridge Regression và Lasso Regression có thể giúp kiểm soát độ phức tạp của mô hình.
11. Linear Regression có còn quan trọng trong Data Science hiện đại?
Khi những mô hình AI ngày càng phức tạp như Deep Learning và Large Language Models phát triển mạnh, nhiều người đặt câu hỏi liệu Linear Regression còn đáng học hay không.
Theo mình, câu trả lời là có.
Linear Regression không chỉ là một công cụ dự báo mà còn là nền tảng giúp chúng ta hiểu nhiều khái niệm cốt lõi của Machine Learning.
Thông qua thuật toán này, người học có thể tiếp cận:
- Sự khác biệt giữa biến đầu vào và biến mục tiêu.
- Cách mô hình học từ dữ liệu.
- Hàm mất mát và tối ưu hóa.
- Training và Testing.
- Overfitting và khả năng tổng quát hóa.
- Phân tích sai số và đánh giá chất lượng mô hình.
Những kiến thức này tiếp tục xuất hiện trong rất nhiều thuật toán nâng cao.
Ví dụ, Gradient Descent cũng là một khái niệm quan trọng khi huấn luyện mạng Neural Network.
Tương tự, việc chia dữ liệu, tránh Data Leakage và lựa chọn chỉ số đánh giá vẫn là những yêu cầu bắt buộc đối với các hệ thống Machine Learning hiện đại.
Với người mới bắt đầu, Linear Regression là bước khởi đầu phù hợp để xây dựng tư duy Machine Learning trước khi học những thuật toán phức tạp hơn.
Nếu muốn tìm hiểu một lộ trình đầy đủ từ Python, SQL, thống kê đến Machine Learning và thực hành dự án, bạn có thể tham khảo khóa học Data Science cho người mới bắt đầu tại COLE.
12. Tổng kết
Qua bài viết này, chúng ta đã tìm hiểu những kiến thức quan trọng về Linear Regression:
- Linear Regression là thuật toán học có giám sát, thường được dùng để dự đoán các giá trị liên tục.
- Mô hình tìm mối quan hệ tuyến tính giữa biến mục tiêu và các đặc trưng đầu vào.
- Ordinary Least Squares là phương pháp phổ biến để ước lượng tham số.
- MAE, RMSE và R² giúp đánh giá hiệu quả dự đoán theo những góc nhìn khác nhau.
- Phân tích phần dư, kiểm tra giả định và tránh Data Leakage là những bước quan trọng.
- Linear Regression là một baseline hữu ích trước khi thử nghiệm những thuật toán Machine Learning phức tạp hơn.
Điểm quan trọng nhất khi học Machine Learning không phải chỉ biết gọi model.fit() hay model.predict(), mà là hiểu mô hình đang học điều gì, tại sao nó đưa ra dự đoán và kết quả có đáng tin cậy hay không.
Hy vọng bài viết giúp các bạn mới học Data Science hiểu rõ hơn về Linear Regression và có thể tự xây dựng mô hình dự báo đầu tiên bằng Python.
Anh em nào đã từng áp dụng Linear Regression vào dự án thực tế có thể chia sẻ thêm kinh nghiệm, đặc biệt là cách xử lý outlier, lựa chọn đặc trưng và kiểm tra các giả định của mô hình nhé!
Tài liệu tham khảo
All rights reserved
