

Hết “vibe coding”: Tech team cần gì trong kỷ nguyên AI?
Một hệ thống AI bắt đầu rất đơn giản: một API, một prompt, một model và một màn hình trả lời. Sáu tháng sau, cùng công ty đó có ba model, một kho tài liệu nội bộ, RAG, vài tool gọi CRM/ERP, một agent chạy nền, nhiều nhóm dùng chung API key và một hóa đơn không biết quy về sản phẩm nào.
Cloud có Cloud Architect. Kỷ nguyên AI cũng cần một năng lực tương tự: thiết kế trade-off giữa model, dữ liệu, quyền truy cập, độ tin cậy và chi phí.
Cloud từng đi qua một chu kỳ tương tự. Khi hạ tầng cloud còn nhỏ, đội ứng dụng tự tạo resource. Khi workload tăng, identity, networking, observability, resilience và FinOps trở thành kiến trúc chung. AI cũng đang đi theo hướng này, nhưng đối tượng cần điều phối không chỉ là compute: đó là “intelligence” được tiêu thụ qua model, context, agent và tool.
Mục tiêu không phải là dùng model mạnh nhất. Mục tiêu là xây đúng kiến trúc AI cho từng business outcome.
Bài này không xem AI Architect là một chức danh bắt buộc. Đây là một function: thiết kế cả hệ thống AI, thay vì chỉ chọn một model.
Tech team đang đứng ở đâu sau làn sóng vibe coding?
AI đang làm một việc rất thật: rút ngắn đáng kể thời gian từ ý tưởng đến prototype. Một product có thể có chatbot, workflow tự động hay agent đầu tiên chỉ sau vài ngày. Nhưng khi người dùng thật, dữ liệu thật và các hệ thống nội bộ cùng đi vào luồng đó, tech team thường là nơi nhận phần việc còn lại.
Backend phải xử lý identity, rate limit và integration. Platform phải lo secrets, observability, reliability và cost. Security phải trả lời dữ liệu nào được phép ra ngoài. Product phải xác định output nào đủ tốt để người dùng tin. Không hẳn có một người được giao sở hữu toàn bộ những câu hỏi này, nhưng chúng vẫn phải được trả lời trước khi AI trở thành một capability production.
Đây không phải lúc vai trò của tech team bị AI thay thế. Đây là lúc giá trị của team dịch chuyển: từ chỉ xây nhanh một tính năng sang thiết kế cách intelligence, data, controls và economics cùng hoạt động trong một hệ thống.
Khi nhìn từ góc đó, model chỉ là một thành phần trong kiến trúc, không phải toàn bộ kiến trúc.
Sau giai đoạn “ai cũng dùng AI”, doanh nghiệp sẽ phải giải hai bài toán
Việc doanh nghiệp đổ xô dùng các model AI là tất yếu. Khi một capability mới giúp viết nhanh hơn, phân tích nhanh hơn hay dựng product nhanh hơn, không ai muốn đứng ngoài. Nhưng giai đoạn phổ cập model không đồng nghĩa doanh nghiệp đã biết dùng AI hiệu quả.
Khi AI bắt đầu xuất hiện trong nhiều team và nhiều workflow, hai bài toán mới lộ ra.
Tối ưu vận hành và quản trị AI. Model nào dùng cho việc nào, dữ liệu nào được phép đi vào model, agent được quyền làm gì, chi phí quy về đâu, chất lượng đo thế nào và ai chịu trách nhiệm khi hệ thống sai.
Tối ưu năng lực sử dụng AI. Đây không chỉ là biết viết prompt. Người dùng, domain expert và tech team cần biết cách mô tả đúng công việc, đưa đúng context, kiểm tra kết quả, nhận ra khi nào AI không đáng tin và đưa feedback ngược lại để workflow tốt hơn.
Nói cách khác, sau giai đoạn mọi người chạy theo model mới, khác biệt không còn nằm ở việc doanh nghiệp có dùng AI hay không. Nó nằm ở việc doanh nghiệp có biến AI thành một năng lực vận hành được hay không.
AI Solution Architect hay AI Architect chỉ là một cách gọi cho function kết nối hai bài toán đó: kiến trúc hệ thống AI cho đúng workload, đồng thời thiết kế cách con người, quy trình và controls cùng vận hành quanh nó.
Một model không phải một kiến trúc
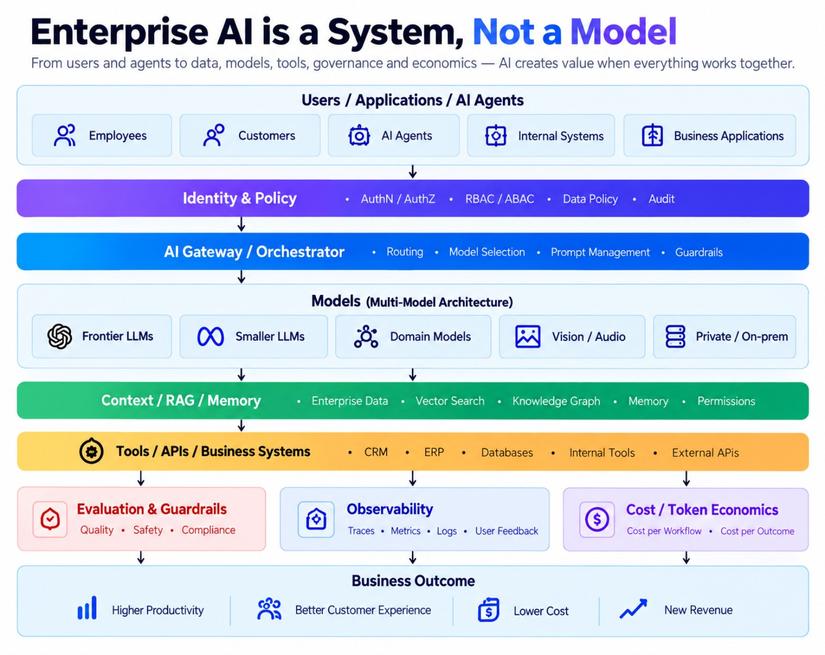
Một luồng production thường gần với:
User / application
  -> Identity + policy
  -> AI gateway / routing
  -> Model tier
  -> Context / RAG / memory
  -> Tools / APIs / business systems
  -> Evaluation, guardrails, observability, cost telemetry
Nếu ta chỉ benchmark model, ta bỏ qua những điểm hay gây incident hơn cả model: context lấy sai ACL, tool được cấp quyền quá rộng, retry loop làm tăng bill, hay không có eval nào phát hiện retrieval xuống chất lượng sau khi đổi index.
Tài liệu, framework và checklist về GenAI trên mạng không thiếu. Nhưng khi đưa AI vào doanh nghiệp, tech team thường cần một cách nhìn đủ rộng để không chỉ dừng ở model, prompt hay một demo chạy được.
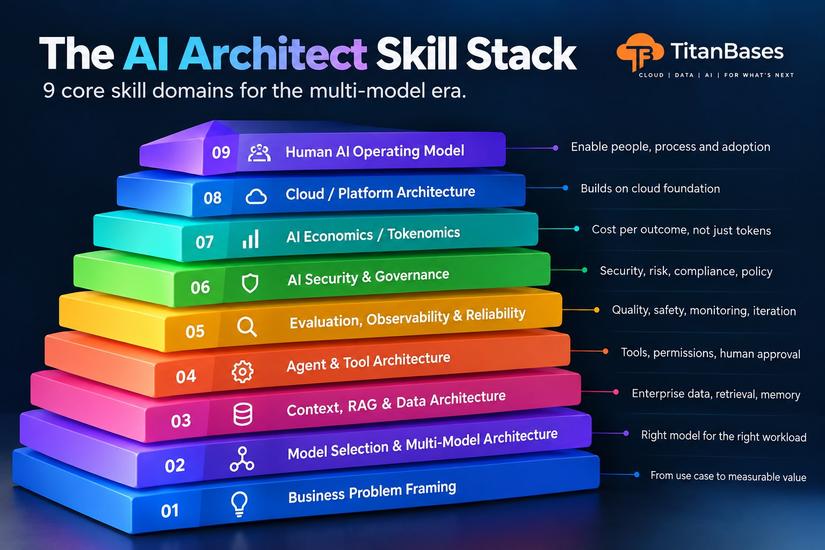
Phần tiếp theo không phải một checklist bắt buộc hay một job description mới. Đây là một số đúc kết thực dụng về skill stack mà team cần dần xây khi AI trở thành một capability production.
Không team nào cần xây đủ chín skill stack ngay từ đầu. Đây không phải roadmap để mua thêm công cụ hay lập ngay một phòng ban mới. Nó là bản đồ để tech team biết: khi một use case AI bắt đầu được dùng thật, vấn đề tiếp theo có thể xuất hiện ở đâu và ai cần cùng chịu trách nhiệm.
9 skill stack mà tech team cần xây trong kỷ nguyên AI
1. Bắt đầu từ business problem, không phải “cần AI”
Nhiều doanh nghiệp đang coi AI như một cách giảm người, rút ngắn thời gian làm sản phẩm và thay thế một phần công việc. Giai đoạn đầu thường rất tích cực: prototype ra nhanh, demo chạy được, team nhỏ hơn vẫn giao hàng. Nhưng khi AI đi vào quy trình thật, business problem mới bắt đầu lộ ra: ai chịu trách nhiệm cho quyết định sai, dữ liệu nào được phép đi vào model, chi phí tăng theo người dùng ai kiểm soát, agent được quyền tác động đến hệ thống nào và khi lỗi thì ai xử lý?
Vì vậy, điểm xuất phát không phải là “cần AI” hay chọn model nào. Nó là xác định AI đang giải quyết một vấn đề vận hành cụ thể nào, cho ai và với mức rủi ro nào.
Một request tốt phải trả lời: người dùng nào, quyết định hay thao tác nào được cải thiện, sai ở mức nào là chấp nhận được, và chỉ số nào chứng minh giá trị.
Anti-pattern: “Hãy làm chatbot cho toàn bộ tài liệu.”
Câu hỏi tốt hơn: “Agent có thể giúp nhân viên tìm đúng quy trình trong 30 giây, với trích dẫn nguồn và không lộ tài liệu ngoài quyền truy cập của họ không?” Khi problem được giới hạn, mới chọn được data, eval set, SLO và model tier.
2. Model selection và multi-model routing
Sau khi xác định đúng bài toán, sai lầm tiếp theo thường là đi tìm “model tốt nhất” rồi cố dùng nó cho mọi thứ. Trong production, một model mạnh không mặc nhiên là một kiến trúc tốt. Mỗi workload có yêu cầu khác nhau về độ chính xác, tốc độ, chi phí, dữ liệu và mức rủi ro chấp nhận được.
Classification khối lượng lớn, tóm tắt ticket, phân tích hợp đồng và agent cần gọi tool là bốn workload khác nhau. Không có lý do kỹ thuật để route tất cả sang model mạnh nhất.
Hãy coi model registry như một contract: capability cần có, input/output schema, context requirement, latency target, cost ceiling, fallback và cách đánh giá. Router có thể dựa trên task class, confidence, sensitivity hoặc load; nhưng routing cần được đo bằng quality và outcome, không chỉ token.
Anti-pattern: model mặc định duy nhất cho mọi request vì “an toàn”. Kết quả thường là chi phí cao, latency dài và không có đường nâng cấp hay rollback.
Trong thực tế, doanh nghiệp không đi multi-model chỉ vì đó là một khái niệm kiến trúc. Có team đã thành công với một use case và muốn mở rộng giá trị: tận dụng điểm mạnh khác nhau của nhiều model cho các tác vụ như phân tích tài liệu, hỗ trợ khách hàng, reasoning hay agent xử lý workflow.
Cũng có team buộc phải dùng nhiều model vì chi phí, usage limit hoặc rate limit. Không phải workload nào cũng cần model mạnh nhất; nếu mọi request đều chạy qua một model frontier, chi phí tăng rất nhanh và khả năng vận hành cũng phụ thuộc vào một nhà cung cấp hoặc một quota duy nhất.
Vì vậy, câu hỏi không phải là “model nào mạnh nhất?”, mà là workload này cần mức năng lực nào, cần truy cập dữ liệu và công cụ nào, và một outcome thành công có chi phí bao nhiêu. Multi-model, nếu làm đúng, là cách ghép năng lực, kiểm soát và economics phù hợp cho từng bài toán nghiệp vụ.
Multi-model trong thực tế: route theo workload, không theo hype
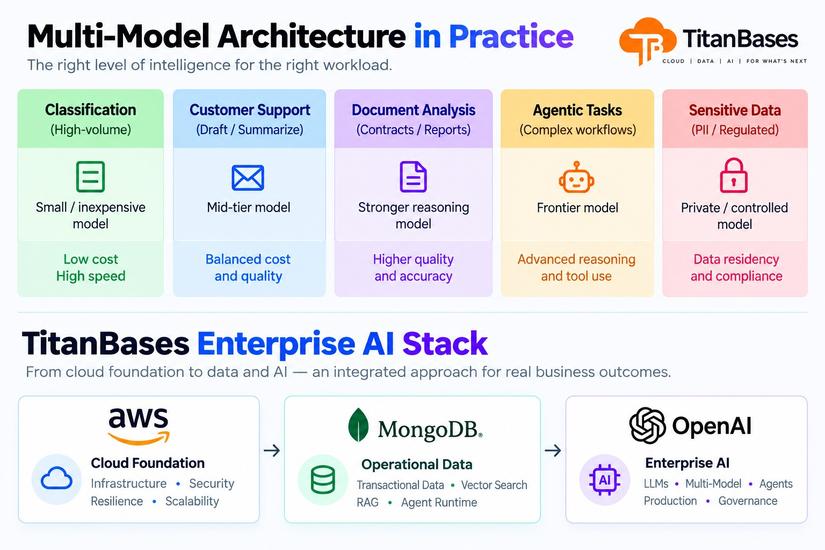
| Workload | Ưu tiên kiến trúc |
|---|---|
| Classification số lượng lớn | model nhỏ, schema chặt, confidence threshold |
| Customer support draft | model cân bằng, RAG có ACL, human handoff |
| Document analysis | context/retrieval tốt, eval độ chính xác, citation |
| Agentic workflow | tool boundary, approval, audit, deadline và retry budget |
| Dữ liệu nhạy cảm | residency, policy, provider boundary, kiểm soát truy cập |
Bảng này không phải rule cố định. Nó ép đội ngũ giải thích vì sao một model và một cách vận hành phù hợp với workload. AWS GenAI Lens cũng khuyến nghị tối ưu model và inference theo yêu cầu hiệu năng thực tế, đồng thời kiểm soát prompt length, response size và những biến làm tăng consumption.
Điều quan trọng là: khi AI đã đi qua giai đoạn thử nghiệm, doanh nghiệp gần như không thể đơn giản “bỏ AI” để quay về cách làm cũ. Sự phụ thuộc được tạo ra từ thời vibe coding sẽ kéo theo nhiều model, nhiều luồng dữ liệu, nhiều quota, nhiều cách tính chi phí và nhiều điểm có thể lỗi. Multi-model không phải bài toán chỉ của người chọn model; nó là bài toán vận hành của cả hệ thống.
AI Architecture lúc này không nhất thiết phải bắt đầu bằng một platform lớn hay một router phức tạp. Việc đầu tiên là làm rõ các workload đang có, model nào đang phục vụ chúng, dữ liệu và tool nào chúng được phép chạm tới, ai là owner và success được đo bằng gì. Từ đó, tech lead, platform, security, data và product cùng thiết kế các guardrail chung: model registry, gateway hoặc routing khi cần, policy truy cập, telemetry về chất lượng và chi phí, cùng cơ chế fallback khi một provider hay quota gặp vấn đề.
3. Context, RAG và dữ liệu sẵn sàng cho AI
Model không tự biết dữ liệu nội bộ của doanh nghiệp, cũng không tự phân biệt đâu là dữ liệu đúng, mới hay được phép sử dụng. Nếu context sai, retrieval sai hoặc quyền truy cập sai, câu trả lời nghe có vẻ thuyết phục vẫn có thể dẫn đến quyết định sai. Vì vậy bài toán data không nằm ngoài AI - nó nằm ngay trong chất lượng và độ tin cậy của AI.
RAG không phải một vectorSearch() rồi nối vào prompt. Một kiến trúc retrieval cần quyết định:
- tài liệu nào được ingest, version thế nào và ai là owner; - chunk theo cấu trúc nào, metadata nào được filter; - ACL được enforce ở retrieval layer ra sao; - khi nào dùng lexical search, vector search hoặc reranking; - context budget bao nhiêu và câu trả lời phải trích nguồn thế nào.
Chất lượng dữ liệu, lineage, privacy và access control đều là phần của kiến trúc. AWS cũng nhấn mạnh GenAI cần data chất lượng, được quản trị và có context phù hợp. Một model tốt vẫn tạo câu trả lời tệ nếu context stale, sai tenant hoặc quá dài.
4. Agent và tool architecture: quyền lực nằm ở tool, không nằm ở câu trả lời
Khi AI chỉ trả lời, rủi ro còn có thể giới hạn ở một câu trả lời. Khi AI bắt đầu gọi API, truy cập CRM, tạo ticket, gửi email hay tác động vào quy trình nghiệp vụ, nó đã trở thành một thành phần có quyền hành động. Lúc đó câu hỏi không còn là agent “thông minh” đến đâu, mà là nó được phép làm gì, trong điều kiện nào và ai có quyền chặn nó.
Một chatbot nói sai gây trải nghiệm kém. Một agent có thể gọi CRM, tạo ticket, sửa dữ liệu hoặc gửi email thì sai lầm trở thành side effect.
Thiết kế tool nên có schema hẹp, identity rõ, least privilege, giới hạn hành động, idempotency key, audit event và approval cho action có tác động. OWASP gọi rủi ro này là Excessive Agency: hệ thống có thể thực hiện hành động gây hại vì chức năng, permission hoặc autonomy quá rộng.
Anti-pattern: cho agent một token “admin” và để model tự quyết định tất cả tool call. Thay vào đó, tách read/write, giới hạn scope theo tenant, thêm policy check trước execution và đưa action nhạy cảm qua human approval.
5. Evaluation, observability và reliability
Một demo có thể được đánh giá bằng cảm giác: câu trả lời có hay không, có giống người không. Nhưng production không vận hành bằng cảm giác. Tech team phải biết AI đang sai ở đâu, sai với ai, chất lượng thay đổi thế nào sau mỗi lần đổi prompt, model hay dữ liệu, và liệu hệ thống có còn phục vụ được khi upstream gặp vấn đề hay không.
AI output có tính không xác định. Vì vậy “không có exception” không đồng nghĩa hệ thống đúng.
Một release production cần eval set đại diện cho task thực tế: câu hỏi dễ/khó, dữ liệu lỗi thời, prompt injection, trường hợp không có đáp án, input dài, tool failure. Theo dõi tối thiểu gồm task success, groundedness/citation correctness khi có RAG, retrieval recall proxy, latency, error rate, fallback rate và cost per completed task.
Nên có regression gate khi đổi model, prompt, chunking, embedding hoặc tool schema. Microsoft Well-Architected cũng coi workload AI cần thực hành design, testing, evaluation và operations riêng do hành vi nondeterministic.
6. AI security và governance
Đưa AI vào doanh nghiệp đồng nghĩa đưa thêm một bề mặt truy cập mới vào dữ liệu, tri thức và quy trình nội bộ. Nếu không có policy, phân quyền, audit và ranh giới rõ ràng, đội ngũ có thể vô tình tạo ra một đường đi vòng qua những kiểm soát mà doanh nghiệp vốn đã mất nhiều năm để xây dựng.
Governance không phải một file policy ở cuối dự án. Nó phải trở thành control trong luồng chạy: approved provider/model, classification trước khi đưa data ra ngoài, secrets isolation, retention, audit, owner của risk và cách tắt một capability khi có incident.
NIST AI RMF Generative AI Profile là một khung tham chiếu hữu ích để nối rủi ro với design, development, use và evaluation. Điều quan trọng với engineering team là biến nó thành cơ chế kỹ thuật có thể kiểm tra: policy-as-code, model allowlist, trace có identity và evidence cho từng tool call.
7. AI Economics: token là meter, không phải KPI
Chi phí AI ban đầu thường nhỏ đến mức dễ bị bỏ qua. Nhưng khi product có người dùng, prompt dài hơn, agent gọi nhiều bước hơn và nhiều team cùng triển khai, chi phí không còn là vài dòng token usage. Cần nhìn được chi phí thuộc về workload nào, đội nào, outcome nào - trước khi nó trở thành một khoản bill không ai giải thích được.
Token usage cho biết ta đã tiêu thụ bao nhiêu, chứ không cho biết hệ thống có tạo giá trị hay không. Một maturity path thực dụng là:
- Token consumption: tổng token và tổng bill.
- Usage attribution: team, product, tenant hay workflow nào dùng.
- Workflow cost: một luồng end-to-end tốn bao nhiêu.
- Cost per outcome: một ticket được giải quyết, một báo cáo được duyệt hay một lead được qualify tốn bao nhiêu.
- Business value: outcome đó có đáng chi phí vận hành không.
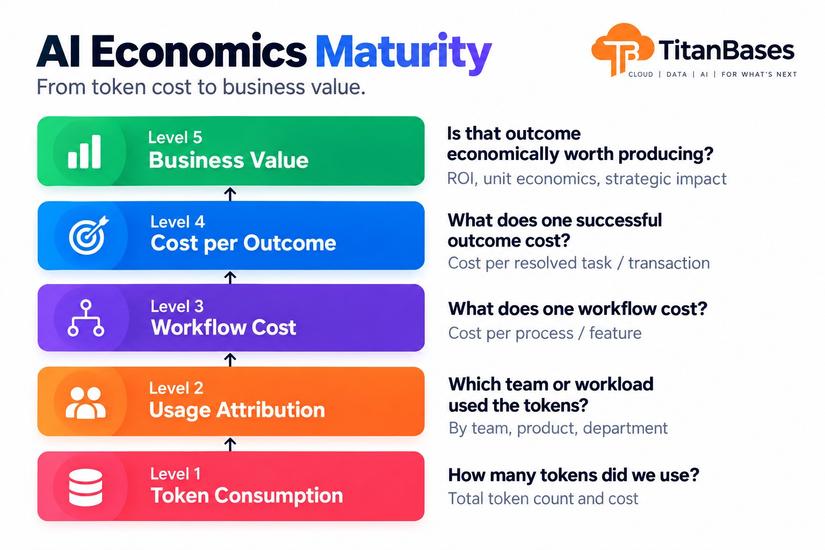
FinOps Foundation khuyến nghị chọn model theo value-driven consumption thay vì mặc định model có capability cao nhất. Điều này dẫn đến các control cụ thể: budget theo tenant/workflow, context ceiling, cache cho request phù hợp, batch cho workload không tương tác, rate limit và trace liên kết usage với outcome.
Anti-pattern: dashboard chỉ có “tokens today”. Không có owner, không có workload, không có nguyên nhân và không giúp đội nào thay đổi quyết định kiến trúc.
8. Cloud và platform vẫn là nền móng
AI không chạy độc lập với phần còn lại của hệ thống. Nó cần identity, networking, secrets, logging, môi trường triển khai, scaling và cơ chế vận hành giống mọi workload production khác. Nếu foundation này yếu, team sẽ liên tục chữa cháy ở tầng ứng dụng dù model hay prompt có được tối ưu đến đâu.
AI không thay thế các bài toán platform: identity, networking, queue, cache, secrets, deployment, rollback, DR và observability vẫn quyết định hệ thống chịu tải và chịu lỗi thế nào.
Ví dụ, khi upstream throttling, cần admission control, queue, bounded retry và degraded response; không phải “thử lại vô hạn”. Khi RAG ingest chậm, cần pipeline tách biệt với serving path. Khi provider lỗi, fallback chỉ an toàn nếu schema, eval và policy của model thay thế đã được kiểm chứng.
Để xem góc nhìn rộng hơn về việc đi từ PoC đến hệ thống có models, context, tools, security, evaluation và operations, xem AI PoC tới production.
9. Human AI operating model
Cuối cùng, AI không thay thế nhu cầu về con người trong vận hành - nó thay đổi vị trí con người cần tham gia. Doanh nghiệp cần xác định việc nào AI được tự động xử lý, việc nào phải có người review, ai sở hữu quality, ai chịu trách nhiệm khi kết quả gây tác động thật. Đây là phần quyết định AI trở thành năng lực của tổ chức hay chỉ là một công cụ được dùng rời rạc.
Một kiến trúc đúng vẫn thất bại nếu con người dùng nó sai. Cần quy định ai được dùng AI cho việc gì, khi nào phải verify output, ai sở hữu knowledge source, ai xử lý feedback và ai quyết định release model/prompt mới.
Điều này không phải “đào tạo cách viết prompt”. Nó là thiết kế workflow giữa người, policy và hệ thống. Một agent hỗ trợ CSKH cần biết khi nào trả lời, khi nào draft để người duyệt và khi nào escalate. Một công cụ phân tích tài liệu cần ghi rõ output là gợi ý hay quyết định có thể thực thi.
Cách dùng nine-skill stack khi review một use case
Lấy ví dụ “trợ lý trả lời chính sách nội bộ”. Trước khi làm PoC, review theo thứ tự:
- Outcome: giảm thời gian tìm quy trình nào, cho nhóm nào?
- Model: cần reasoning mạnh hay chỉ cần extraction + answer có citation?
- Context: nguồn nào được phép; ACL có lọc trước retrieval không?
- Tools: có cần action hay chỉ read-only?
- Eval: bộ câu hỏi nào chứng minh câu trả lời đúng và biết từ chối khi thiếu nguồn?
- Governance: log có chứa PII không; policy nào chặn prompt injection?
- Economics: cost/query, cost/successful resolution và budget theo tenant là bao nhiêu?
- Platform: rate limits, queue, retry, cache, rollback hoạt động ra sao?
- Operating model: owner của knowledge base, eval và incident là ai?
Nếu không trả lời được vài dòng trong danh sách này, chưa phải lúc “thử model mới”.
Sau vibe coding, từng team sẽ dịch chuyển sang đâu?
AI Architect không phải một layer mới đứng trên frontend, backend hay vận hành. Đó là cách các vai trò hiện có cùng thiết kế một hệ thống AI có thể chạy thật. AI không làm các team này ít quan trọng hơn - nó đẩy trách nhiệm của họ lên gần hơn với business outcome.
Frontend và product experience
Frontend không chỉ là nơi dựng một khung chat hay một nút “Ask AI”. Phần việc sẽ dịch chuyển sang thiết kế cách người dùng đưa context vào hệ thống, hiểu AI đang làm gì, xem nguồn nào được dùng, biết lúc nào cần kiểm tra lại và xác nhận trước khi AI tạo ra một action có tác động. Product cần xác định rõ output nào là gợi ý, output nào có thể tự động thực thi và khi nào phải handoff sang con người.
Backend và application engineering
Backend là nơi biến khả năng của model thành một capability có contract. Công việc không chỉ là gọi API, mà là quản lý identity, tool contract, schema, idempotency, queue, retry, rate limit, fallback và audit. Khi một agent có thể chạm vào CRM, ERP hay workflow nội bộ, backend là lớp giữ ranh giới giữa “trả lời thông minh” và “hành động an toàn”.
Data, platform và SRE
Data team sở hữu chất lượng, freshness, lineage và quyền truy cập của context. Platform và SRE sở hữu gateway, secrets, logging, telemetry, capacity, reliability và cách hệ thống chịu lỗi khi provider hay quota có vấn đề. Đây là phần khiến AI không trở thành một tập hợp API key rải rác trong nhiều product.
Security, risk và governance
Security không chỉ review một lần trước khi release. Khi AI đi vào luồng chạy, team này cần cùng biến policy thành control: model nào được phép dùng, loại dữ liệu nào được gửi ra ngoài, tool nào được phép gọi, log giữ lại những gì và ai có quyền dừng một capability khi có incident.
Vận hành doanh nghiệp và domain owner
Vận hành không phải người đứng ngoài chờ kỹ thuật bàn giao. Họ hiểu workflow nào đang tốn thời gian, exception nào AI không được tự xử lý, dữ liệu nào thiếu hoặc sai và outcome nào thực sự có giá trị. Domain owner cần đồng sở hữu eval, feedback loop và human handoff; nếu không, team kỹ thuật chỉ đang tối ưu một demo chứ chưa tối ưu công việc của doanh nghiệp.
Không cần tuyển ngay một AI Architect để bắt đầu. Ở team nhỏ, tech lead cùng product owner có thể kéo các vai trò này lại quanh một use case. Khi hệ thống lớn dần, ownership mới tách rõ hơn cho platform, data, security, FinOps và domain team. Việc đầu tiên vẫn là làm rõ những gì đã chạy: use case, owner, model/provider, dữ liệu, tool, success metric, chi phí và rủi ro. Khi những thứ này rõ, tổ chức mới biết nên đầu tư vào người, platform hay control nào tiếp theo.
Tech team nên bắt đầu từ đâu?
Không cần có sẵn một AI platform lớn, một đội AI riêng hay một title mới để bắt đầu. Điều cần tránh là tiếp tục mở thêm use case khi những gì đang chạy còn không rõ ai sở hữu và tạo giá trị đến đâu.
Làm rõ cái đang chạy. Liệt kê các use case AI đã có, owner, model hoặc provider, dữ liệu và tool mà chúng chạm tới, cùng chi phí và success metric hiện tại. Đây là bước để nhìn ra chỗ nào đang chỉ là thử nghiệm, chỗ nào đã thành dependency.
Chọn một workflow có người dùng thật. Với một luồng đủ quan trọng, xác định output nào được chấp nhận, khi nào phải human handoff, dữ liệu nào được phép dùng và cách đo chất lượng sau mỗi thay đổi. Đừng mở rộng model hoặc agent trước khi trả lời được những câu này.
Giao ownership trước khi mở rộng. Quality, cost và incident phải có người chịu trách nhiệm. Khi ownership rõ, tech team mới biết nên đầu tư tiếp vào data, platform, security, evaluation hay năng lực sử dụng AI của người dùng.
Kết luận
Làn sóng AI hiện tại đang giúp mọi người build nhanh hơn: prototype nhanh hơn, viết code nhanh hơn, đưa một product lên màn hình nhanh hơn. “Vibe coding” có giá trị thật ở giai đoạn khám phá; nhưng nó không tự giải quyết những câu hỏi khó khi AI đi vào doanh nghiệp: dữ liệu nào được phép dùng, model nào phù hợp, agent được quyền làm gì, chất lượng được kiểm chứng thế nào, chi phí được quy cho đâu và ai chịu trách nhiệm khi hệ thống sai.
Giai đoạn đua nhau dùng AI để làm nhanh sẽ trôi qua. Giá trị của tech team không biến mất; nó được trả lại ở một vị trí mới: thiết kế, vận hành và kiểm soát một hệ thống AI có thể tạo giá trị bền vững. “AI Architect” chỉ là một cách gọi cho năng lực đó. Bài viết này muốn diễn đạt một góc nhìn về tương lai gần: sau làn sóng vibe coding, doanh nghiệp sẽ cần những kiến trúc sư thực sự để AI vận hành như một phần đáng tin cậy của doanh nghiệp, không chỉ là một bản demo gây ấn tượng.
Đội ngũ trưởng thành không cố chuẩn hóa mọi thứ về một model. Họ xây một hệ thống có thể phân bổ đúng mức intelligence, context, control và cost cho từng outcome.
Nguồn đọc thêm
- AWS Generative AI lifecycle - AWS Generative AI Lens - cost optimization - FinOps Foundation - AI Model Selection - NIST AI RMF Generative AI Profile - OWASP LLM06:2025 Excessive Agency
Ghi chú tác giả
Tác giả làm việc tại TitanBases trong các dự án liên quan đến cloud, data và AI architecture. Bài viết tổng hợp góc nhìn kỹ thuật về thiết kế hệ thống AI production; các framework và nguồn được dẫn để người đọc đối chiếu thêm.
All rights reserved
