

Case Study: Thiết kế Data Warehouse chuẩn Ralph Kimball & Tự động hóa ELT Pipeline cho hệ thống E-Commerce đa kênh
Trong quá trình đồng hành cùng nhiều doanh nghiệp bán lẻ và thương mại điện tử (Omnichannel E-commerce), tôi nhận thấy một quy luật lặp đi lặp lại: Khi doanh nghiệp tăng trưởng từ vài trăm lên vài chục nghìn đơn hàng mỗi ngày, hệ sinh thái phân tích dữ liệu thường sụp đổ trước tiên.
Các triệu chứng kinh điển xuất hiện:
- Hệ thống Transactional DB (OLTP) bị khóa bảng (deadlock) hoặc CPU tăng vọt lên 100% mỗi khi phòng Kế toán hoặc BI bấm "Xuất báo cáo tháng".
- Báo cáo doanh thu của phòng Marketing (dựa trên Facebook/Google Ads API và Webhook đơn hàng) lệch hàng trăm triệu so với số liệu đối soát của phòng Tài chính (dựa trên phần mềm ERP/POS).
- Khách hàng thay đổi địa chỉ hoặc hạng thành viên (Loyalty Tier), dẫn đến toàn bộ dữ liệu lịch sử mua hàng trong quá khứ bị gán sai địa bàn và sai chính sách chiết khấu.
Để giải quyết tận gốc cuộc khủng hoảng này, giải pháp bền vững duy nhất là tách rời hoàn toàn môi trường vận hành (OLTP) khỏi môi trường phân tích (OLAP) thông qua một Kho dữ liệu tập trung (Enterprise Data Warehouse - EDW).
Bài viết này là một case study Data Engineer kỹ thuật chi tiết: từ tư duy mô hình hóa dữ liệu chiều (Dimensional Modeling theo trường phái Ralph Kimball), xử lý chiều biến đổi chậm (SCD Type 2), cho đến việc hiện thực hóa toàn bộ luồng tự động hóa bằng bộ đôi công nghệ tiêu chuẩn của Modern Data Stack: Apache Airflow và dbt (data build tool).
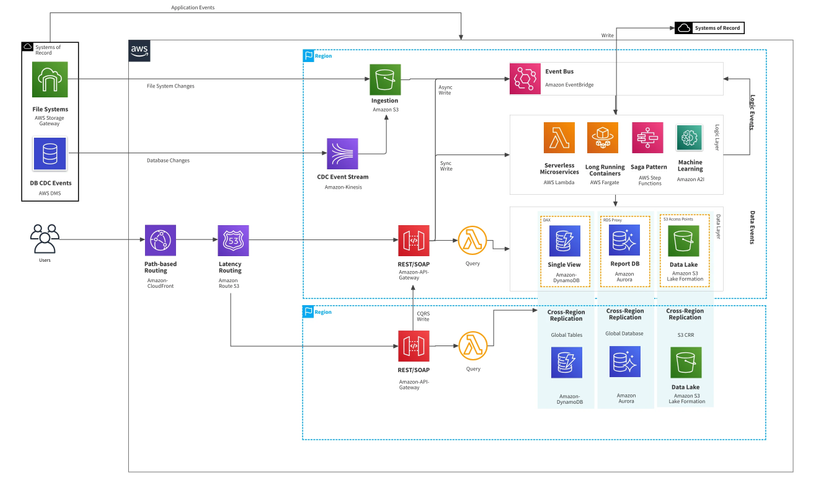
1. Bức tranh kiến trúc tổng thể (Architecture Overview)
Thay vì đi theo mô hình ETL (Extract - Transform - Load) truyền thống vốn đòi hỏi các cụm máy chủ trung gian nặng nề, hệ thống được thiết kế theo tư duy ELT hiện đại (Extract - Load - Transform) trên nền tảng Cloud Data Warehouse (Google BigQuery / Snowflake).
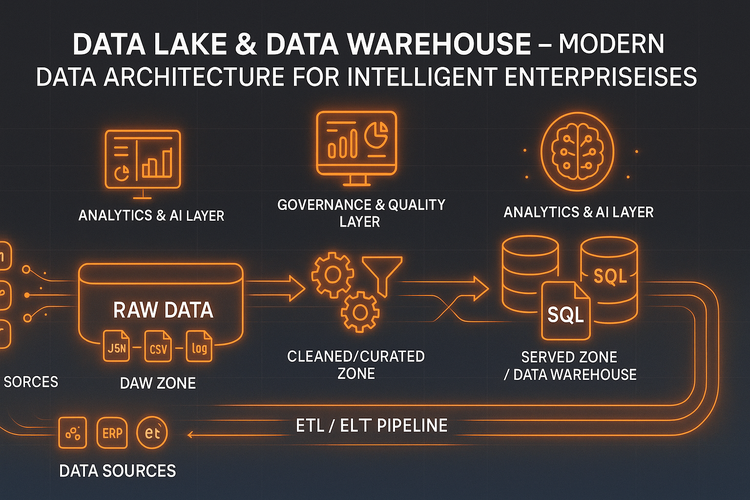
Dữ liệu tuân theo Kiến trúc Medallion (Bronze Silver Gold):
[POS Database]     [E-com MySQL]     [CRM API]
 (PostgreSQL)       (Shopify/Web)    (HubSpot)
       │                  │              │
       └──────────────────┼──────────────┘
                          │ (Airflow Daily Ingestion / CDC)
                          ▼
            +---------------------------+
            |  Cloud Storage (GCS/S3)   |  <--- Bronze Layer (Raw Parquet)
            +---------------------------+
                          │ (External Table / Batch Load)
                          ▼
            +---------------------------+
            |  BigQuery: Staging Area   |  <--- Bronze/Silver Entry
            +---------------------------+
                          │
                   (dbt Core Engine)
             ┌────────────┴────────────┐
             ▼                         ▼
      [Silver Layer]            [Gold Layer]
  * Làm sạch & Trừ trùng   * Star Schema (Kimball)
  * Chuẩn hóa Data Type     * Fact_Sales_Transactions
  * Deduplication           * Dim_Customer (SCD Type 2)
                            * Dim_Product, Dim_Store
             │                         │
             └────────────┬────────────┘
                          ▼
             +--------------------------+
             |   Power BI / Looker BI   |  <--- DirectQuery / Dual Mode
             +--------------------------+
Các lớp dữ liệu:
- Bronze Layer (Staging): Lưu trữ dữ liệu thô nguyên bản từ các nguồn transactional dưới định dạng cột nén
Apache Parquet(tối ưu chi phí lưu trữ và tốc độ I/O). - Silver Layer (Intermediate): Dữ liệu được loại bỏ bản ghi trùng lặp (deduplicated), chuẩn hóa múi giờ UTC, xử lý chuỗi ký tự và ép kiểu dữ liệu chặt chẽ.
- Gold Layer (Production Data Marts): Dữ liệu được mô hình hóa thành các bảng Fact và Dimension theo chuẩn Star Schema, sẵn sàng cho các công cụ BI kết nối truy vấn tốc độ cao.
2. Mô hình hóa dữ liệu chiều: Thiết kế Star Schema chuẩn Ralph Kimball
Sai lầm phổ biến nhất của các lập trình viên Backend khi bước sang thiết kế Data Warehouse là cố gắng áp dụng các dạng chuẩn hóa cơ sở dữ liệu (3NF - Third Normal Form).
- Trong OLTP, 3NF giúp triệt tiêu dư thừa dữ liệu và tăng tốc độ ghi (Insert/Update/Delete).
- Trong OLAP, 3NF là "kẻ thù" của hiệu năng truy vấn, bởi nó buộc các câu lệnh phân tích phải
JOINqua hàng chục bảng liên kết, gây nghẽn thông lượng bộ nhớ.
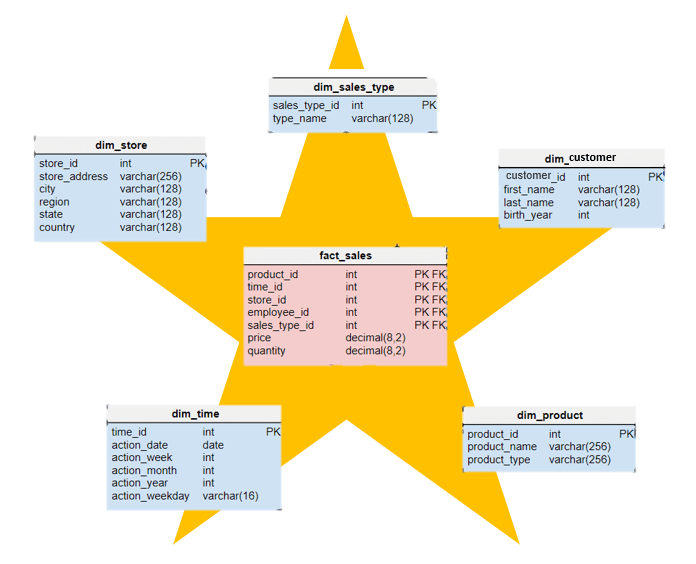
Ralph Kimball đã đề xuất phương pháp tiếp cận ngược lại: Dimensional Modeling (Mô hình hóa dữ liệu chiều) với cấu trúc Star Schema (Lược đồ hình sao).
                  +-----------------------+
                  |      dim_date         |
                  +-----------------------+
                  | PK  date_key          |
                  |     full_date         |
                  |     fiscal_year       |
                  |     quarter           |
                  |     is_weekend        |
                  +-----------------------+
                              │ 1
                              │
                              │ N
+--------------------+   +----------------------------+   +--------------------+
|    dim_customer    |   |         fact_sales         |   |    dim_product     |
+--------------------+   +----------------------------+   +--------------------+
| PK  customer_skey  |1  | FK  customer_skey          |  1| PK  product_skey   |
|     customer_id    ├───┤ FK  product_skey           ├───┤     product_id     |
|     full_name      |N  | FK  store_skey             |  N|     sku_code       |
|     loyalty_tier   |   | FK  date_key               |   |     category_name  |
|     effective_from |   |     order_id (Degenerate)  |   |     cost_price     |
|     effective_to   |   |     quantity_sold          |   +--------------------+
|     is_current     |   |     unit_selling_price     |
+--------------------+   |     discount_amount        |
                         |     net_revenue            |
                         +----------------------------+
                                      │ N
                                      │
                                      │ 1
                         +----------------------------+
                         |         dim_store          |
                         +----------------------------+
                         | PK  store_skey             |
                         |     store_code             |
                         |     region_name            |
                         |     store_manager          |
                         +----------------------------+
2.1. Xác định Grain (Hạt nhân dữ liệu) của Fact Table
Quy tắc vàng của Kimball: Phải luôn xác định mức độ chi tiết nhỏ nhất (Atomic Grain) của bảng Fact trước khi viết bất kỳ câu lệnh DDL nào.
- Grain lựa chọn: Mỗi dòng trong bảng
fact_salesđại diện cho một dòng sản phẩm (Line Item) trong một hóa đơn giao dịch thành công. - Tránh tuyệt đối việc gộp chung các dòng sản phẩm vào mức hóa đơn (Order Level) trong bảng Fact chi tiết, vì điều này sẽ làm mất khả năng phân tích giỏ hàng (Market Basket Analysis) và biên lợi nhuận theo từng danh mục hàng hóa.
2.2. DDL Bảng Fact: fact_sales
CREATE TABLE gold.fact_sales (
    -- Foreign Keys liên kết tới các bảng Dimensions (Surrogate Keys)
    customer_skey INT64 NOT NULL,
    product_skey INT64 NOT NULL,
    store_skey INT64 NOT NULL,
    date_key INT64 NOT NULL,

    -- Degenerate Dimension (Chiều suy biến: mã đơn hàng dùng để nhóm mà không cần bảng phụ)
    order_id STRING NOT NULL,
    order_line_number INT64 NOT NULL,

    -- Additive Numeric Measures (Các chỉ số đo lường có tính cộng dồn)
    quantity_sold INT64 NOT NULL,
    unit_selling_price NUMERIC(15, 2) NOT NULL,
    unit_cost_price NUMERIC(15, 2) NOT NULL,
    discount_amount NUMERIC(15, 2) DEFAULT 0.00,
    gross_revenue NUMERIC(15, 2) NOT NULL,
    net_revenue NUMERIC(15, 2) NOT NULL,
    cost_amount NUMERIC(15, 2) NOT NULL,
    gross_profit NUMERIC(15, 2) NOT NULL,

    -- Metadata phục vụ kiểm toán dữ liệu (Data Auditing)
    dw_created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP()
)
PARTITION BY RANGE_BUCKET(date_key, GENERATE_ARRAY(20250101, 20301231, 100)) -- Partition theo ngày
CLUSTER BY store_skey, product_skey; -- Cluster tối ưu hóa bộ lọc truy vấn
3. Kỹ thuật nâng cao: Xử lý Chiều biến đổi chậm (SCD Type 2) cho dim_customer
Trong thực tế, thông tin khách hàng không đứng yên:
- Ngày 10/01/2026: Khách hàng Nguyễn Văn A ở TP. Hồ Chí Minh thuộc hạng Silver.
- Ngày 25/02/2026: Khách hàng nâng cấp lên hạng Gold và chuyển địa chỉ ra Hà Nội.
Nếu ta dùng câu lệnh UPDATE đè dữ liệu mới lên dữ liệu cũ (SCD Type 1), toàn bộ các đơn hàng anh A mua vào tháng 1 sẽ bị hệ thống báo cáo tính cho khu vực Hà Nội với hạng Gold. Điều này bóp méo hoàn toàn phân tích lịch sử!
Giải pháp: Áp dụng Slowly Changing Dimension Type 2 (SCD Type 2) nhằm lưu lại toàn bộ vết lịch sử thay đổi bằng cách thêm các cột:
customer_skey: Khóa thay thế (Surrogate Key) tự tăng, độc lập vớicustomer_idcủa hệ sinh thái nghiệp vụ.effective_from: Thời điểm bắt đầu áp dụng phiên bản dữ liệu này.effective_to: Thời điểm phiên bản này hết hiệu lực (NULLhoặc9999-12-31nếu đang là bản ghi mới nhất).is_current: Cờ nhị phân (TRUE/FALSE) đánh dấu trạng thái hiện tại.
DDL Bảng dim_customer (SCD Type 2)
CREATE TABLE gold.dim_customer (
    customer_skey INT64 NOT NULL,           -- Khóa đại diện duy nhất (Hash Key hoặc Sequence)
    customer_id STRING NOT NULL,             -- Natural Key / Business Key từ nguồn CRM/App
    full_name STRING NOT NULL,
    email STRING,
    phone_number STRING,
    city STRING,
    loyalty_tier STRING NOT NULL,            -- Regular, Silver, Gold, Platinum

    -- Dải hiệu lực phiên bản bản ghi
    effective_from TIMESTAMP NOT NULL,
    effective_to TIMESTAMP,
    is_current BOOLEAN NOT NULL,

    dw_updated_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP()
)
CLUSTER BY customer_id;
4. Tự động hóa Pipeline với dbt (data build tool) & Apache Airflow
Để hiện thực hóa quy trình từ Staging lên Gold, chúng ta kết hợp dbt (đóng vai trò "đầu não" biến đổi dữ liệu SQL bên trong Warehouse) và Apache Airflow (đóng vai trò người điều phối, lên lịch và giám sát tổng thể).
4.1. Cấu hình dbt Snapshot để tự động hóa SCD Type 2
Thay vì phải tự viết các câu lệnh MERGE INTO bằng tay hàng trăm dòng dễ sinh lỗi, dbt cung cấp cơ chế Snapshot vô cùng mạnh mẽ dựa trên cột timestamp hoặc hash giá trị kiểm tra (check strategy).
Tạo tệp: snapshots/customer_snapshot.sql
{% snapshot customer_snapshot %}

{{
    config(
      target_schema='silver',
      unique_key='customer_id',
      strategy='timestamp',
      updated_at='updated_at',
      invalidate_hard_deletes=True
    )
}}

SELECT
    id AS customer_id,
    name AS full_name,
    email,
    phone AS phone_number,
    city,
    tier AS loyalty_tier,
    updated_at
FROM {{ source('staging', 'raw_customers') }}

{% endsnapshot %}
Khi chạy lệnh dbt snapshot, dbt sẽ tự động:
- Thêm các cột quản lý dải thời gian:
dbt_valid_from,dbt_valid_to,dbt_scd_id. - Kiểm tra các bản ghi thay đổi. Nếu
updated_atcủa mộtcustomer_idmới hơn bản ghi cũ, dbt sẽ setdbt_valid_to = current_timestampcho dòng cũ và chèn một dòng mới vớidbt_valid_to = NULL.
4.2. Xây dựng Data Transformation Model cho fact_sales.sql
Tạo tệp: models/gold/fact_sales.sql
{{
    config(
        materialized='incremental',
        unique_key=['order_id', 'order_line_number'],
        partition_by={
            "field": "date_key",
            "data_type": "int64",
            "range": {"start": 20250101, "end": 20301231, "interval": 100}
        },
        cluster_by=["store_skey", "product_skey"]
    )
}}

WITH raw_orders AS (
    SELECT * FROM {{ ref('stg_pos_order_items') }}
    {% if is_incremental() %}
        -- Kỹ thuật Incremental: Chỉ quét các giao dịch mới phát sinh trong 3 ngày gần nhất
        WHERE transaction_timestamp >= TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL 3 DAY)
    {% endif %}
),

customers AS (
    -- Link tới phiên bản snapshot SCD Type 2 đúng tại thời điểm giao dịch diễn ra
    SELECT * FROM {{ ref('dim_customer') }}
),

products AS (
    SELECT * FROM {{ ref('dim_product') }}
),

stores AS (
    SELECT * FROM {{ ref('dim_store') }}
)

SELECT
    -- Lấy Surrogate Key thông qua phép JOIN với dải hiệu lực của SCD Type 2
    c.customer_skey,
    p.product_skey,
    COALESCE(s.store_skey, -1) AS store_skey, -- -1 cho trường hợp đơn hàng Online
    CAST(FORMAT_TIMESTAMP('%Y%m%d', o.transaction_timestamp) AS INT64) AS date_key,

    o.order_id,
    o.line_item_id AS order_line_number,

    o.quantity AS quantity_sold,
    o.selling_price AS unit_selling_price,
    p.standard_cost AS unit_cost_price,
    o.discount_amount,

    -- Tính toán các chỉ số kinh doanh tại tầng SQL
    (o.quantity * o.selling_price) AS gross_revenue,
    (o.quantity * o.selling_price - o.discount_amount) AS net_revenue,
    (o.quantity * p.standard_cost) AS cost_amount,
    (o.quantity * o.selling_price - o.discount_amount) - (o.quantity * p.standard_cost) AS gross_profit,

    CURRENT_TIMESTAMP() AS dw_created_at
FROM raw_orders o
INNER JOIN customers c
    ON o.customer_id = c.customer_id
    -- Kỹ thuật Point-in-time Lookup (Truy vấn đúng phiên bản của khách hàng lúc mua)
    AND o.transaction_timestamp >= c.effective_from
    AND (o.transaction_timestamp < c.effective_to OR c.effective_to IS NULL)
INNER JOIN products p
    ON o.product_id = p.product_id
LEFT JOIN stores s
    ON o.store_code = s.store_code
4.3. Viết Data Tests tự động đảm bảo độ tin cậy (Data Quality Assertion)
Một Data Warehouse không được kiểm thử là một "bãi mìn" trực chờ phát nổ. dbt cho phép định nghĩa các bài test tự động ngay trong file YAML.
Tạo tệp: models/gold/schema.yml
version: 2

models:
  - name: fact_sales
    description: "Bảng lưu trữ giao dịch bán hàng chi tiết theo từng dòng sản phẩm."
    tests:
      - dbt_utils.unique_combination_of_columns:
          combination_of_columns:
            - order_id
            - order_line_number
    columns:
      - name: customer_skey
        tests:
          - not_null
          - relationships:
              to: ref('dim_customer')
              field: customer_skey
      - name: net_revenue
        tests:
          - not_null
          - dbt_expectations.expect_column_values_to_be_between:
              min_value: 0
              row_condition: "quantity_sold > 0" # Doanh thu không được phép âm nếu số lượng bán > 0
4.4. Đóng gói quy trình điều phối bằng Apache Airflow DAG
Airflow đóng vai trò điều khiển nhịp điệu của toàn bộ hệ thống mỗi đêm: Trích xuất dữ liệu Đẩy lên Cloud Storage Nạp vào BigQuery Staging Kích hoạt dbt biến đổi Kiểm thử chất lượng Làm mới bộ nhớ cache của Power BI.
Tạo tệp: dags/omnichannel_elt_pipeline.py
from datetime import datetime, timedelta
from airflow import DAG
from airflow.operators.bash import BashOperator
from airflow.providers.google.cloud.transfers.gcs_to_bigquery import GCSToBigQueryOperator
from airflow.operators.empty import EmptyOperator

default_args = {
    'owner': 'data_engineering_team',
    'depends_on_past': False,
    'start_date': datetime(2026, 1, 1),
    'email_on_failure': True,
    'email': ['data-alerts@example.com'],
    'retries': 2,
    'retry_delay': timedelta(minutes=5),
}

with DAG(
    dag_id='omnichannel_elt_pipeline_daily',
    default_args=default_args,
    schedule_interval='0 2 * * *', # Chạy định kỳ lúc 02:00 AM mỗi ngày
    catchup=False,
    max_active_runs=1,
    tags=['production', 'dbt', 'bigquery', 'edw'],
) as dag:

    start_task = EmptyOperator(task_id='start_pipeline')

    # Task 1: Chạy Python container để trích xuất dữ liệu từ các hệ thống nguồn và đẩy Parquet lên GCS
    extract_pos_to_gcs = BashOperator(
        task_id='extract_pos_to_gcs',
        bash_command='python3 /opt/airflow/scripts/extract_pos_cdc.py --date "{{ ds }}"',
    )

    # Task 2: Nạp tệp Parquet từ Cloud Storage vào bảng Staging của BigQuery
    load_gcs_to_bq_staging = GCSToBigQueryOperator(
        task_id='load_gcs_to_bq_staging',
        bucket='retail-data-lake-raw',
        source_objects=['pos/{{ ds }}/*.parquet'],
        destination_project_dataset_table='retail_edw.staging_pos_order_items',
        source_format='PARQUET',
        write_disposition='WRITE_TRUNCATE',
    )

    # Task 3: Kích hoạt dbt snapshot để cập nhật các bảng SCD Type 2
    dbt_snapshot_task = BashOperator(
        task_id='dbt_snapshot_scd2',
        bash_command='cd /opt/dbt/retail_analytics && dbt snapshot --profiles-dir .',
    )

    # Task 4: Chạy dbt run để transform dữ liệu sang Silver và Gold layers
    dbt_run_task = BashOperator(
        task_id='dbt_run_models',
        bash_command='cd /opt/dbt/retail_analytics && dbt run --select gold --profiles-dir .',
    )

    # Task 5: Kích hoạt toàn bộ bộ kiểm tra tự động dbt test
    dbt_test_task = BashOperator(
        task_id='dbt_test_quality',
        bash_command='cd /opt/dbt/retail_analytics && dbt test --profiles-dir .',
    )

    end_task = EmptyOperator(task_id='end_pipeline')

    # Định nghĩa cấu trúc luồng thực thi (Dependency Flow)
    start_task >> extract_pos_to_gcs >> load_gcs_to_bq_staging
    load_gcs_to_bq_staging >> dbt_snapshot_task >> dbt_run_task >> dbt_test_task >> end_task
5. Kết quả vận hành và Tối ưu chi phí thực tế
Sau 3 tháng đưa hệ thống Data Warehouse chuẩn Kimball và pipeline tự động vào vận hành chính thức, doanh nghiệp ghi nhận những bước chuyển mình rõ rệt:
-
Hiệu năng truy vấn (Query Latency):
- Các báo cáo phân tích đa chiều (Doanh thu theo vùng danh mục sản phẩm nhóm khách hàng) trên Power BI trước đây mất 8-12 phút để tải (hoặc văng lỗi Timeout), nay phản hồi trong dưới 1.5 giây.
- Nhờ thiết kế phân vùng (
PARTITION BY date_key) và gom cụm (CLUSTER BY store_skey, product_skey), dung lượng dữ liệu quét qua của BigQuery giảm đến 78%, giúp tiết kiệm hàng nghìn USD chi phí tính toán Cloud mỗi tháng.
-
Tính toàn vẹn dữ liệu (Data Integrity):
- Cơ chế SCD Type 2 giúp bộ phận kế toán và kiểm toán đối soát chính xác 100% doanh thu theo từng thời kỳ của khách hàng, loại bỏ hoàn toàn các tranh cãi về số liệu sai lệch giữa các phòng ban.
- Khi một lỗi schema từ nguồn xuất hiện (ví dụ: trường giá trị bị null bất thường),
dbt testsẽ kích hoạt cảnh báo và chặn pipeline ngay tại tầng Silver, không để "dữ liệu rác" rò rỉ lên tầng Gold của các nhà quản trị.
6. Lời kết và Góc nhìn định hướng năng lực
Thành công của một dự án Kho dữ liệu không nằm ở việc chúng ta sử dụng những công nghệ thời thượng hay cố gắng nhồi nhét các mô hình phân tích quá phức tạp. Trái lại, nó nằm ở năng lực thấu hiểu tường tận nghiệp vụ kinh doanh, tư duy tổ chức dữ liệu chuẩn hóa theo Ralph Kimball, và kỹ năng xây dựng những đường ống dữ liệu (Pipeline) tự động, chịu lỗi và có khả năng scale.
Một Data Engineer xuất sắc không chỉ biết viết SQL thuần thục, mà còn phải là một "kiến trúc sư" có thể kết nối liền mạch từ cơ sở dữ liệu gốc, kho Data Warehouse cho đến giao diện hiển thị dữ liệu (Data Visualization) mà các CEO/CFO nhìn vào hàng ngày.
All rights reserved
