Xây Dựng Agent Runtime Xác Định Với Kỹ Thuật Context Pruning
Một agent LLM thường chạy rất mượt trong các bài demo ngắn chừng năm lượt gọi. Bạn đưa ra một prompt gọn gàng, nối hai mock tools, bảo nó tra cứu mã khách hàng rồi soạn email xác nhận, và mọi thứ hoàn tất mà không vấp phải lỗi nào. Cảm giác lúc đó như thể bạn vừa tự động hóa xong nửa ngày làm việc trước giờ ăn trưa.
Nhưng khi đưa agent đó vào môi trường staging thực tế với ba mươi tools và một cơ sở dữ liệu thật, bạn sẽ thấy nó bắt đầu gãy từ lượt gọi thứ hai mươi tám.
Sự cố này hiếm khi xuất phát từ việc mô hình bị giảm khả năng suy luận. Mô hình không hề quên ngữ pháp hay mất đi tư duy logic cơ bản. Vấn đề thực tế nằm ở chỗ: hai mươi bảy lần gọi tool trước đó đã nhồi nhét hơn tám mươi kilobyte dữ liệu JSON thô, log terminal và các chuỗi HTTP error trace vào lịch sử tin nhắn. System prompt ban đầu bị đẩy văng khỏi vùng tập trung của cơ chế attention. Mô hình bắt đầu bịa ra một tham số không hề tồn tại trong API schema, nghẽn vì database timeout, rồi rơi vào vòng lặp retry vô tận và đốt cháy mười hai đô la tiền API credits trước khi rate limiter kịp ngắt.
Trong môi trường production thực tế, các autonomous LLM agent thất bại sau nhiều lượt chạy chủ yếu do tình trạng ngộ độc ngữ cảnh và trôi lệch trạng thái, chứ không phải do năng lực suy luận của mô hình bị giảm sút. Một agent harness chuẩn production giải quyết triệt để vấn đề này bằng cách thay thế mảng tin nhắn thô bằng máy trạng thái xác định, kỹ thuật semantic context pruning, schema kiểm soát chặt chẽ và cơ chế rollback theo checkpoint.
Bài học xương máu sau hơn hai năm triển khai các hệ thống agent thực tế là: mô hình nền tảng giờ đây là hàng hóa phổ thông (commodity), nhưng harness (bộ khung điều khiển) mới chính là con hào kinh doanh (moat). Nếu muốn agent chạy bền bỉ qua bốn mươi bước, bạn phải ngừng coi agent loop là một cuộc trò chuyện mở rộng dần, và bắt đầu đối xử với nó như một tiến trình được quản lý bởi hệ điều hành.
Tại Sao Mảng Tin Nhắn Kiểu Append-Only Lại Đầu Độc Attention Window?
Đa số các triển khai agent sơ khởi đều dùng mảng append-only. Bước một chạy, bạn gắn prompt của user. Bước hai gọi tool, bạn gắn thông tin tool call. Bước ba nhận kết quả, bạn gắn toàn bộ payload thô trả về vào mảng.
Sau mười lăm lượt, danh sách tin nhắn của bạn không khác gì một ngăn kéo chứa rác:
| Chỉ số tin nhắn | Loại tin nhắn | Dung lượng | Giá trị vận hành ở bước 25 |
|---|---|---|---|
0 |
System Prompt | 1.8 KB | Tối quan trọng (các ràng buộc bất biến) |
1 |
User Request | 0.2 KB | Tối quan trọng (mục tiêu ban đầu của user) |
2-14 |
Tool Calls từ bước 1-6 | 8.4 KB | Bằng không (các hành động trung gian đã xong) |
15 |
SQL Output thô | 42.1 KB | Bằng không (thực tế chỉ cần 2 dòng dữ liệu) |
16-24 |
Scratchpad từ bước 7-12 | 14.2 KB | Rất thấp (nhiễu và các nhánh đã bỏ) |
25 |
Bước hiện tại | 0.5 KB | Ngữ cảnh làm việc đang hoạt động |
Đến bước hai mươi lăm, hơn 80% ngữ cảnh đang hoạt động là tải trọng chết: dump database thô, các lỗi API cũ từ những lần retry trước, và những dòng suy luận dài dòng cho các tác vụ đã giải quyết từ hai mươi phút trước.
Hệ quả là hai lỗi kiến trúc nghiêm trọng:
- Pha loãng Recency Bias: Mô hình chú ý nhiều hơn vào khối dữ liệu SQL khổng lồ nằm ngay sát bên dưới thay vì để tâm vào ràng buộc an toàn nằm ở system prompt cách đó sáu mươi nghìn token.
- Phình to Token và Chi Phí: Mỗi lượt gọi, bạn đều phải trả tiền để mô hình đọc lại toàn bộ tám mươi kilobyte rác đó. Chi phí token sẽ tăng theo hàm bậc hai dựa trên số lượt gọi nếu giữ nguyên mảng tin nhắn thô.
Mô Hình Leo Núi: Tách Biệt Tải Trọng Đeo Lưng và Trạm Dừng Chân
Khi leo một ngọn núi cao, bạn không gom toàn bộ vỏ chai nước rỗng, giấy gói lương khô hay móc sắt hỏng từ trạm một để mang lên đỉnh. Bạn chỉ mang đồ thiết yếu, để lại các trạm lưu trữ phía sau, và chỉ vác những gì cần cho đoạn dốc hiện tại.
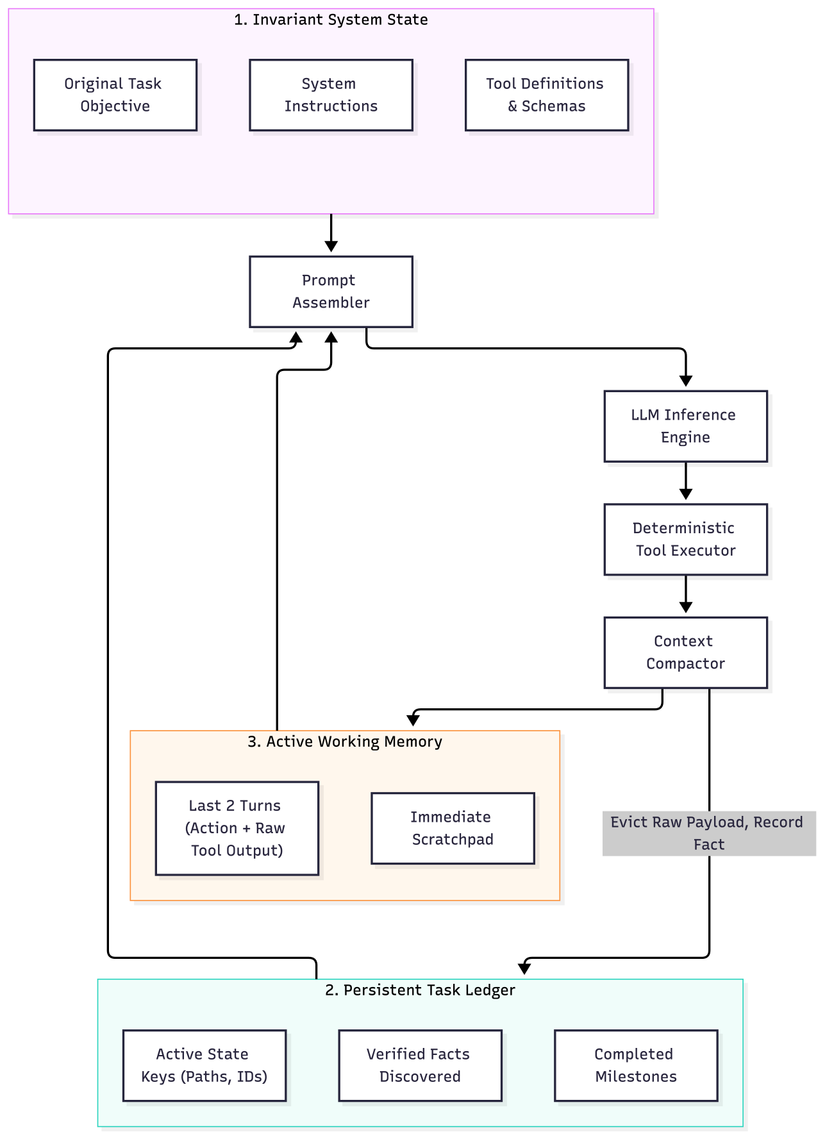
Trong một agent runtime, điều này đồng nghĩa với việc chia trạng thái thực thi thành ba tầng rõ rệt:
Tầng 1: Trạng Thái Bất Biến (Invariant State)
Không bao giờ thay đổi trong suốt phiên chạy. Chứa các ràng buộc cốt lõi, schema của các tool được duyệt, và yêu cầu gốc của user. Phần này luôn nằm ở đầu prompt để tận dụng tối đa cơ chế KV cache qua các lượt gọi.
Tầng 2: Sổ Cái Tác Vụ (Persistent Task Ledger)
Đây là bảng tóm tắt có cấu trúc được duy trì độc lập ngoài mảng hội thoại. Khi agent chạy truy vấn database để tìm khách hàng, kết quả thô bốn mươi kilobyte được bóc tách ngay lập tức. Sổ cái chỉ ghi nhận: Mã khách hàng: 89412, Trạng thái: Hoạt động, Gói: Doanh nghiệp. Payload thô bị loại bỏ hoàn toàn khỏi prompt ở các lượt sau.
Tầng 3: Bộ Nhớ Làm Việc Tức Thời (Active Working Memory)
Chỉ có bước hiện tại và bước liền trước là giữ lại output thô của tool. Ngay khi bước N hoàn thành và được kiểm tra hợp lệ, kết quả của nó được nén thành một dòng sự thật đưa vào sổ cái, và dữ liệu thô sẽ bị dọn dẹp khỏi prompt của lượt suy luận kế tiếp.
Triển Khai Kỹ Thuật Semantic Compaction Bằng Python
Dưới đây là đoạn code mẫu minh họa cách harness thực hiện việc cắt tỉa output của tool mà không làm mất trạng thái của agent:
from dataclasses import dataclass, field
from typing import Any, Dict, List


@dataclass
class AgentState:
    original_objective: str
    invariant_rules: List[str]
    facts_ledger: Dict[str, Any] = field(default_factory=dict)
    active_history: List[Dict[str, str]] = field(default_factory=list)

    def record_fact(self, key: str, value: Any) -> None:
        """Lưu trữ sự thật nghiệp vụ đã kiểm chứng vào sổ cái."""
        self.facts_ledger[key] = value

    def append_turn(self, role: str, content: str) -> None:
        self.active_history.append({"role": role, "content": content})
        # Chỉ giữ tối đa 4 tin nhắn gần nhất trong bộ nhớ làm việc
        if len(self.active_history) > 4:
            self.active_history = self.active_history[-4:]

    def assemble_prompt_messages(self) -> List[Dict[str, str]]:
        """Lắp ráp prompt hoàn chỉnh từ luật bất biến, sổ cái và tin nhắn gần nhất."""
        ledger_lines = [
            f"- {k}: {v}" for k, v in self.facts_ledger.items()
        ]
        ledger_block = (
            "CAC SU THAT DA XAC MINH:\n" + "\n".join(ledger_lines)
            if ledger_lines
            else "Chua co su that nao duoc ghi nhan."
        )

        system_content = (
            f"MUC TIEU: {self.original_objective}\n\n"
            f"QUY TAC BAT BIEN:\n" + "\n".join(f"- {r}" for r in self.invariant_rules) + "\n\n"
            f"{ledger_block}"
        )

        messages = [{"role": "system", "content": system_content}]
        messages.extend(self.active_history)
        return messages
Với cấu trúc này, độ dài của prompt luôn được chặn trên (bounded) ngay cả khi agent chạy hàng trăm bước. System prompt luôn nằm cố định tại vị trí đầu tiên, sổ cái chỉ tăng thêm vài chục token sau mỗi cột mốc, và các payload thô không bao giờ tích tụ quá bốn tin nhắn.
Transactional Tool Calls Và Cơ Chế Checkpoint Rollback
Chuyện gì sẽ xảy ra khi agent chạy một lệnh shell bị lỗi, hoặc cố ghi dữ liệu vào một đường dẫn không tồn tại?
Trong các agent loop thông thường, runtime sẽ nhét nguyên đoạn traceback vào mảng chat: FileNotFoundError: [Errno 2] No such file or directory. Mô hình nhìn thấy lỗi, bắt đầu giải thích, xin lỗi user, thử một đường dẫn hỏng khác, rồi lãng phí hai mươi lượt gọi để tự tranh cãi với chính log lỗi của mình.
Trong một harness xác định, việc gọi tool phải mang tính transaction (giao dịch). Nếu tool thực thi thất bại:
- Hành động lỗi và log traceback không được ghi vào lịch sử hoạt động chính.
- Harness đối chiếu với máy trạng thái nội bộ. Nếu lỗi có thể khắc phục, nó chỉ gửi lại một dòng chỉ dẫn súc tích:
Error: duong dan /var/data/out.csv khong ton tai. Cac thu muc hop le: /var/data/raw, /var/data/processed. - Nếu phát hiện agent bị kẹt vòng lặp (ba lần thất bại liên tiếp với cùng một dạng lỗi), harness sẽ kích hoạt checkpoint rollback: khôi phục bộ nhớ làm việc về đúng trạng thái sạch trước khi gọi lệnh lỗi đầu tiên, đồng thời ép agent chọn một nhánh thực thi khác.
Ba Nguyên Tắc Vàng Khi Thiết Kế Agent Runtime
- Tuyệt Đối Không Để Payload Thô Lọt Vào Context: Nếu một tool trả về mảng JSON hai mươi trường, hãy chạy bộ lọc schema trước. Chỉ đưa vào context đúng các trường phục vụ bước hiện tại.
- Tách Rời Dữ Liệu Khỏi Ngữ Cảnh Suy Luận: Lưu trữ file, tài liệu lớn và các bản ghi database ở storage ngoài (SQLite, Redis, ổ đĩa). Chỉ truyền identifier và đoạn trích ngắn cho mô hình.
- Chặn Trên Cho Vòng Lặp: Bất kỳ phiên chạy nào cũng phải có giới hạn cứng về thời gian thực tế và số lượt bước. Nếu agent không đạt được mốc xác minh sau mười lăm bước, việc escalate lên con người hoặc chủ động dừng luồng xử lý luôn tốt hơn việc để nó tự do sinh ra thêm hai mươi bước ảo giác.
Để xây dựng các agent chạy tin cậy trong thực tế, tụi mình không cần phải chờ đợi thế hệ mô hình tiếp theo ra mắt. Cái tụi mình cần là xây dựng bộ khung kỹ thuật vững chắc xung quanh các mô hình hiện tại để giữ cho sự chú ý của chúng luôn tập trung, trạng thái luôn được kiểm chứng, và bộ nhớ luôn sạch sẽ.
FAQ
- Tại sao các autonomous LLM agent thường bị lỗi sau nhiều lượt chạy?
Các agent thường lỗi do tình trạng ngộ độc ngữ cảnh và trôi lệch trạng thái. Khi nhiều lệnh gọi tool nhồi nhét payload thô và log lỗi vào lịch sử, mô hình mất tập trung vào các ràng buộc ban đầu và bắt đầu sinh ảo giác về tham số hoặc rơi vào vòng lặp retry vô tận.
2.Kỹ thuật semantic context compaction trong agent harness là gì?
Semantic context compaction là mô hình phân tách trạng thái agent thành quy tắc bất biến, sổ cái sự thật nghiệp vụ và bộ nhớ làm việc tức thời. Ngay khi tool chạy xong, kết quả thô được nén thành các sự thật ngắn gọn, tránh làm phình to cửa sổ ngữ cảnh.
All rights reserved