

Tự train model 29 MB đọc note chi tiêu tiếng Việt on-device
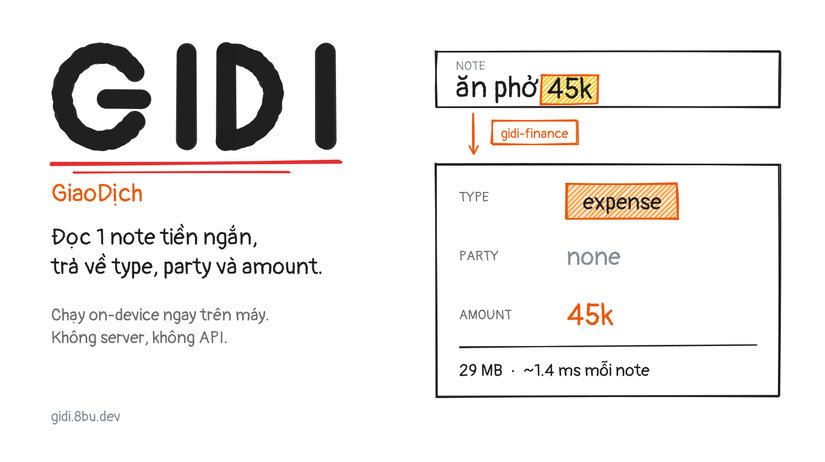
Tóm tắt nhanh cho anh em: Thay vì gọi LLM API vừa chậm vừa ngại khoản lộ dữ liệu tài chính cá nhân, mình tập tành train một classifier nhỏ (29.3 MB INT8 ONNX) kết hợp 500 dòng code parser để đọc note chi tiêu tiếng Việt (
phở bò 60,Long tra 5 lit,ck cho Vũ mượn 700k). Model chạy 100% on-device trong trình duyệt bằng WebAssembly, mất khoảng 1.4 ms/note trên 1 CPU thread, không cần backend hay server nào ở giữa. Live demo: gidi.8bu.dev | Repo: github.com/8bu/gidi | Model: huggingface.co/x8bu/gidi-finance
1. Lại thêm một app chi tiêu nữa à?
Mỗi lập trình viên trong đời dường như đều có ít nhất một lần nảy ra ý định làm app ghi chép chi tiêu cá nhân. Mình cũng không ngoại lệ. Mình định nhảy vào phong trào "mỗi nhà một app chi tiêu" cho vui.
Nhưng rồi mình khựng lại: Nếu chỉ làm một cái form nhập tiền, chọn danh mục (Ăn uống, Đi lại, Mua sắm) rồi bấm Submit... thì chán quá. Bản thân mình cũng sẽ lười dùng sau đúng 3 ngày. Cách con người ghi chép tự nhiên nhất trên điện thoại là mở một tờ note ra gõ vội một dòng, kiểu:
phở bò 60Long tra 5 litck cho Vũ mượn 700kmượn chú hai 5 xị
Không dấu cũng được, viết tắt cũng được, tiếng lóng địa phương cũng được.
Thế là mình đổi ý: Không làm thêm app chi tiêu bình thường nữa. Train luôn một model AI để đọc hiểu mấy dòng note này.
2. Sao không gọi ChatGPT hay Claude API cho xong?
Lúc mới nảy ra ý tưởng, phản xạ đầu tiên của thời đại AI bây giờ là: "Viết cái prompt, gắn API key OpenAI hoặc Claude vào là xong trong 15 phút, việc gì phải khổ?"
Nhưng nghĩ kỹ lại thì cách đó có 3 vấn đề chí mạng đối với một pet project ghi chép cá nhân:
- Tiền API (Cost): Mỗi lần người dùng gõ một note ăn sáng 30k mà bắn một request lên GPT-4o-mini hay Claude Haiku thì tiền API cộng dồn sau một tháng khéo còn nhiều hơn tiền ăn phở.
- Độ trễ (Latency): Gọi API qua mạng mất từ 600 ms đến 2.5 giây. Người ta gõ note chi tiêu cần cảm giác gõ xong Enter là ăn ngay lập tức, không ai muốn ngồi nhìn cái spinner loading quay vòng vòng.
- Quyền riêng tư (Privacy) - Yếu tố quan trọng nhất: Ghi chép tài chính, nợ nần, tên bạn bè, chuyển khoản... là dữ liệu cực kỳ nhạy cảm. Không ai muốn gửi toàn bộ nhật ký chi tiêu của mình lên server của bên thứ ba nếu có thể xử lý nó ngay trên máy.
Đúng lúc đó, mình lướt thấy 2 dự án truyền cảm hứng rất lớn:
- gpu-lexer của Vercel Labs: Một model siêu nhỏ chạy cú pháp syntax highlighting ngay trong browser, tác giả nói thẳng là build ra để học.
- Jev của TypeSafe AI: Một mô hình System One chuyên đưa ra các decision có cấu trúc (structured decision) thay vì cố làm chatbot sinh văn bản.
Xem xong là ngứa tay. Model đâu cần to xác, làm đúng một việc duy nhất và làm thật gọn là đủ xài!
3. GIDI là gì?
Dự án này mình đặt tên là GIDI, viết gọn của GiaoDịch.
Mục tiêu rất cụ thể: Bạn ném vào một câu ghi chú tài chính ngắn, GIDI bóc tách ra 3 thành phần:
- Type (Loại giao dịch): Phân loại vào 1 trong 8 nhóm (
expense,income,borrow,lend,repayment_in,repayment_out,transfer,refund). - Target (Đối tác): Ai là người liên quan trong giao dịch (Long, Vũ, chú hai...).
- Value (Số tiền): Bóc tách chính xác số tiền thành con số chuẩn VND.
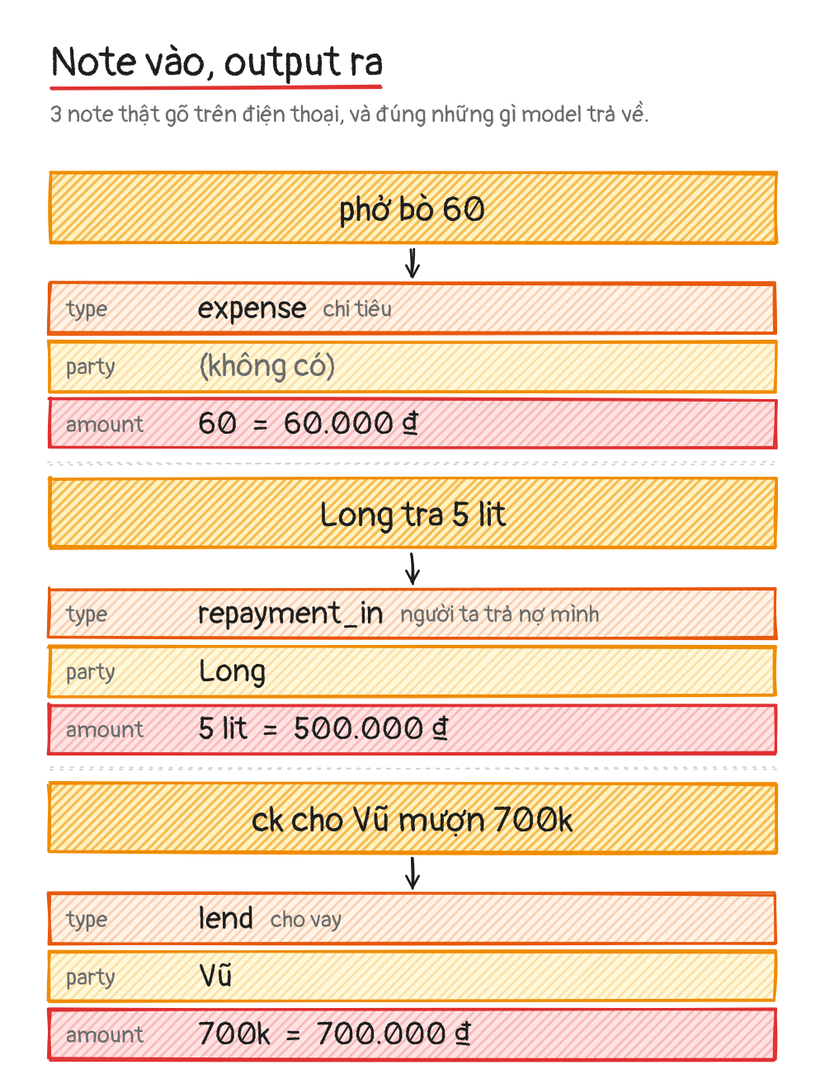
Ví dụ thực tế:
- Gõ
phở bò 60➔type: expense, không có target, số tiền60.000 ₫. - Gõ
Long tra 5 lit(không dấu) ➔type: repayment_in(Long trả nợ mình), targetLong, số tiền500.000 ₫. - Gõ
ck cho Vũ mượn 700k➔type: lend, targetVũ, số tiền700.000 ₫.
Toàn bộ gói model nặng đúng 29.3 MB, chạy bằng WebAssembly (ONNX Runtime Web) ngay trong trình duyệt. Tốc độ inference đo được rơi vào khoảng 1.4 ms p50 trên 1 CPU thread. Dữ liệu note không gửi qua bất kỳ backend nào hết.
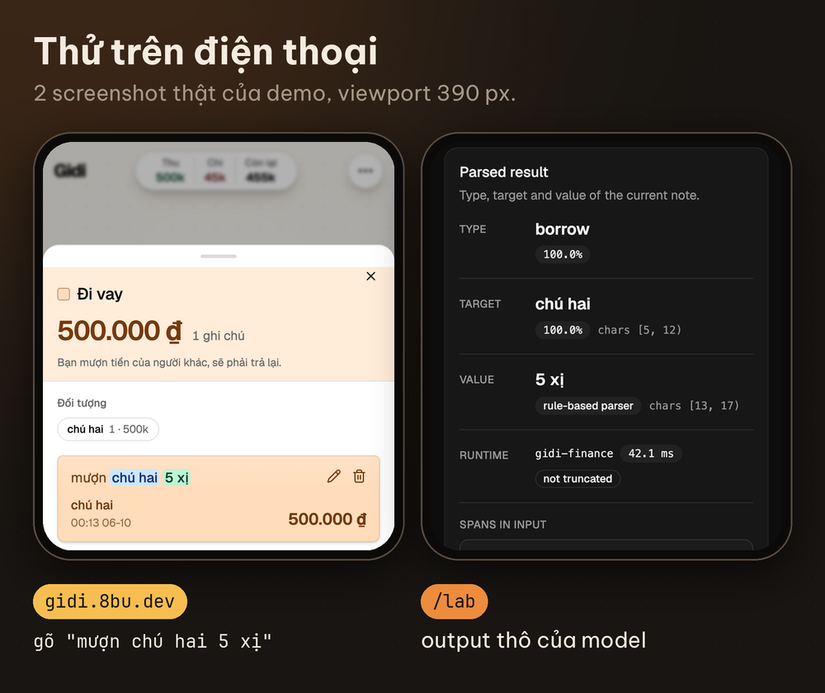
Nghe kết quả thì gọn gàng vậy, nhưng hành trình đi tới con số 29 MB này là một chuỗi những lần "ăn hành" đáng nhớ.
4. Kiến trúc Hybrid: Đừng ép AI làm mọi thứ
Ban đầu, mình mang tư duy "dùng búa tạ": Cố nhồi cả 3 việc (đoán type, tìm target, bóc số tiền) vào một neural network duy nhất. Và đây chính là sai lầm làm mình mất nhiều thời gian nhất.
Sau 6 lần thử nghiệm thất bại, mình nhận ra một bài học kiến trúc cốt lõi: AI chỉ nên làm phần mơ hồ mà code thường khó xử lý; còn phần nào có quy luật chặt chẽ, hãy trả nó về cho code tất định (deterministic code).
Thế là GIDI v3 được thiết kế theo kiến trúc 2 luồng song song:
               ┌────────────────────────────────────────────────────────┐
               │           Input Text: "mượn chú hai 5 xị"               │
               └──────────────────────────┬─────────────────────────────┘
                                          │
                  ┌───────────────────────┴───────────────────────┐
                  ▼                                               ▼
    ┌───────────────────────────┐                   ┌───────────────────────────┐
    │     Encoder Nhỏ (INT8)    │                   │   Rule-based Parser       │
    │     (ONNX - 29.3 MB)      │                   │   (~500 dòng TypeScript)  │
    ├───────────────────────────┤                   ├───────────────────────────┤
    │ - Dự đoán Type: `borrow`  │                   │ - Nhận diện tiếng lóng    │
    │ - Trích Target: `chú hai` │                   │ - Map `5 xị` ➔ 500.000 ₫  │
    └─────────────┬─────────────┘                   └─────────────┬─────────────┘
                  │                                               │
                  └───────────────────────┬───────────────────────┘
                                          ▼
                      Output: { type, target, value, amount }
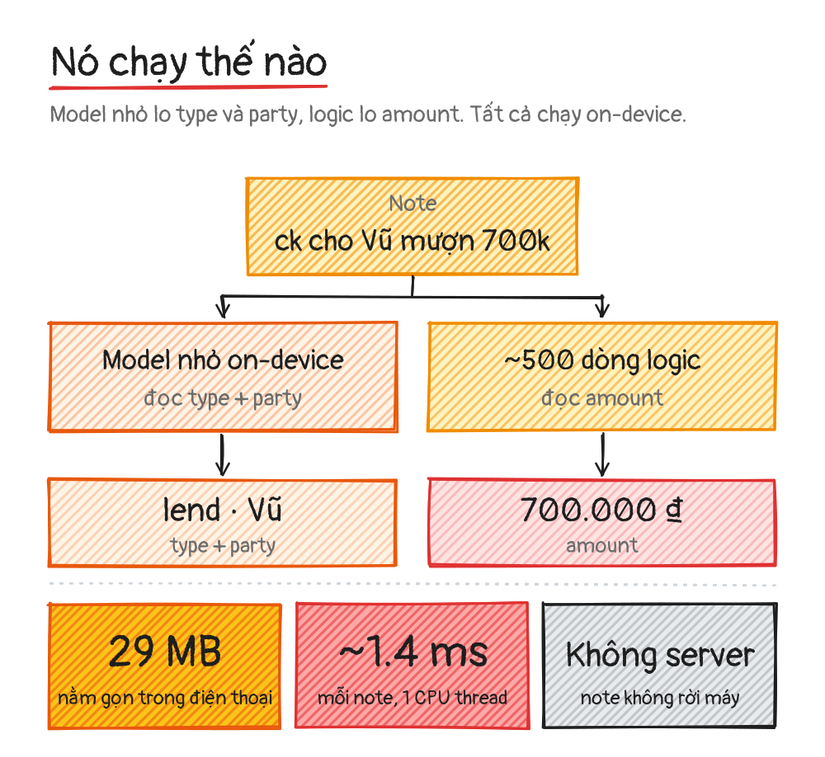
- Luồng 1 (Neural Encoder - 29 MB): Chịu trách nhiệm đoán
Typevà định vị span củaTarget. Ngữ nghĩa tiếng Việt cực kỳ phong phú và lắt léo nên phải nhờ model. - Luồng 2 (Deterministic Parser - 0 MB): Chịu trách nhiệm bóc
Valuevà tính ra số tiền. Số tiền trong tiếng Việt tuy đa dạng nhưng quanh đi quẩn lại vẫn có cấu trúc rõ ràng.
5. Trận chiến đọc Amount: 6 lần thất bại và cú "quay xe" 500 dòng code
Phần mình tưởng dễ nhất lại là phần hành mình nhiều nhất.
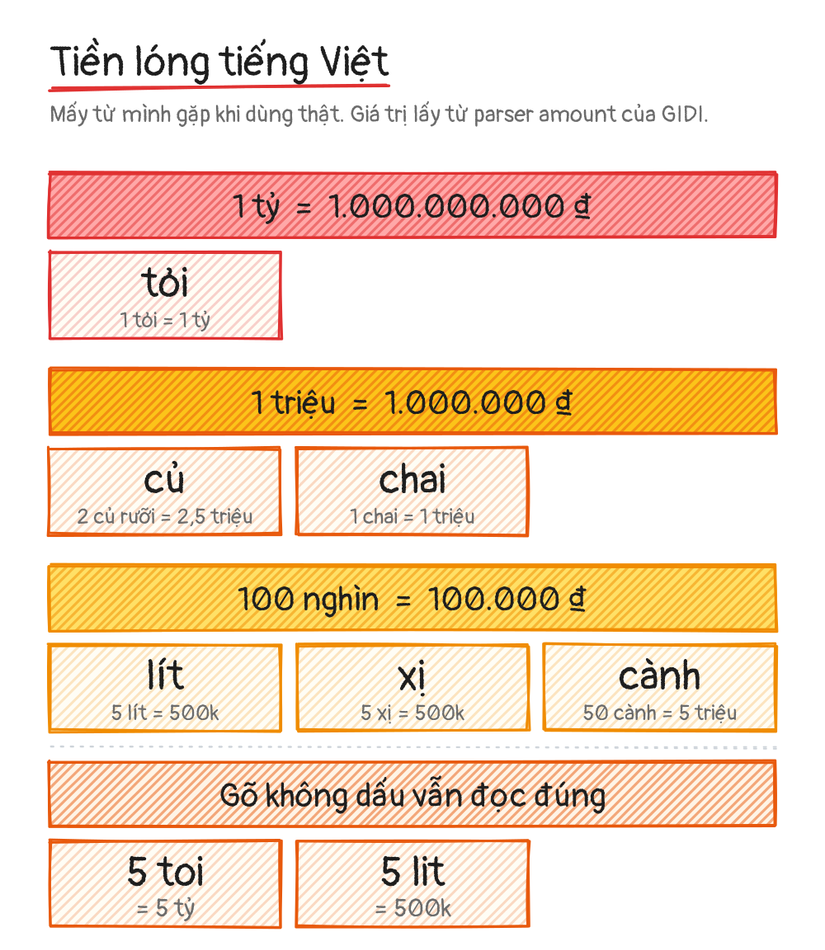
Người Việt viết tiền muôn hình vạn trạng: 2 củ rưỡi, 1tr2, 250.000đ, 5 lít, 3 tỏi, 8 xị. Nhưng oái oăm ở chỗ: 5 lít có thể là 500k tiền mặt, nhưng cũng có thể là... 5 lít xăng!
Mình đã thử nhét việc đọc Amount vào model qua 6 kiến trúc khác nhau:
- Train chung chung với Type: Độ chính xác của Type tụt thảm hại.
- Gắn thêm Linear head lên model đã freeze: Type giữ được nhưng đọc Amount rất ngô nghê.
- Thử MLP, CRF head: Vẫn lệch span liên tục.
- Dùng Adapter layer: Không cải thiện bao nhiêu.
- Dùng hẳn 1 Encoder thứ hai chuyên đọc Value (GIDI v2): Kết quả đọc ngon, nhưng kích thước model phình từ 29 MB lên 58.1 MB, độ trễ tăng lên 3.5 ms. Quá nặng cho môi trường web/mobile!
Cuối cùng, mình quyết định vứt bỏ hoàn toàn encoder thứ hai. Mình ngồi viết tay một parser thuần logic bằng Python trước, rồi port sang TypeScript (khoảng 500 dòng code).
Cách parser hoạt động: Linear pass & Tier ranking
Thay vì dùng một mớ regex rối rắm dễ dính lỗi ReDoS, parser duyệt qua chuỗi một lần (single linear pass) với tọa độ NFC code points và một bản shadow đã chuẩn hóa (bỏ dấu, lowercase):
// playground/src/runtime/value-parser.ts
const TIER_MONEY = 1 // Có đơn vị rõ ràng: k, tr, nghìn, triệu, >= 5 chữ số
const TIER_SLANG = 2 // Tiếng lóng: củ, xị, chai, lít, tỏi, cành
const TIER_BARE  = 3 // Số trần không có đơn vị: "phở 45"

interface Candidate {
  start: number
  end: number
  tier: number
}
Các ứng viên (candidates) được xếp hạng theo thứ tự ưu tiên:
- Tier 1 (Explicit Money): Chứa hậu tố tiền tệ (
k,tr,nghìn,đ) hoặc số được phân tách dấu chấm/phẩy (50.000,1,200,000). - Tier 2 (Slang): Chứa các từ lóng tiền tệ Việt Nam (
củ,chai,lít,xị,tỏi,cành). - Tier 3 (Bare Number): Một số đứng trần không có bối cảnh phủ định (
phở 45➔ 45k).
Parser đồng thời loại trừ thẳng tay các trường hợp "bẫy":
- Số tài khoản / Mã đơn hàng: Chuỗi số liên tục dài hơn 10 chữ số.
- Ngày tháng (
12/10,ngày 15). - Số điện thoại.
- Đại lượng không phải tiền: Nhận diện từ đứng sau như
lít xăng,kg thịt,tháng,năm.
Kết quả: Bộ parser 500 dòng code này đạt 100% độ chính xác trên toàn bộ test set do người gán nhãn, chạy trong microsecond và giúp cắt giảm 50% dung lượng toàn bộ dự án (từ 58 MB xuống 29 MB).
6. Huấn luyện model: Từ Teacher to đùng đến 29 MB INT8 ONNX
Nếu Amount đã có code lo, thì model làm gì? Model tập trung 100% công lực vào việc phân loại 8 loại giao dịch và chỉ ra ai là người liên quan.
6.1. Định nghĩa trước, train sau
Việc quan trọng nhất không phải nhảy vào chọn transformer nào, mà là ngồi viết định nghĩa rành mạch cho 8 loại giao dịch. Nghe chán ngắt nhưng đây là chỗ dễ cãi nhau nhất:
- Trả tiền cơm giùm bạn: Là
lend(cho mượn), không phảiexpense(tiêu xài cá nhân), vì bạn còn nợ mình. - Chuyển tiền tiết kiệm: Là
transfer, không phải tiêu. - Đòi được nợ cũ: Là
repayment_in, không phảiincome(thu nhập).
Dữ liệu được mình gán nhãn bằng tay qua Quet — một công cụ TUI (Terminal UI) nhỏ mình viết riêng bằng Rust/Python để phục vụ việc label nhanh trên bàn phím.
6.2. Distillation & Quantization
Huấn luyện một model nhỏ từ con số 0 (train from scratch) là bất khả thi vì thiếu dữ liệu pretrain tiếng Việt đủ lớn. Cách làm hiệu quả là:
- Huấn luyện một Teacher Model to trên tập ngữ liệu hoàn chỉnh.
- Dùng kỹ thuật Knowledge Distillation để truyền tri thức sang một encoder nhỏ gọn.
- Prune bớt các trọng số thừa và áp dụng INT8 Dynamic Quantization.
Mục tiêu ban đầu của mình là nén trong khoảng 10 - 30 MB. Kết quả ra 29.3 MB, vừa khít ngưỡng target!
7. Xài thật mới thấy: Những pha "ngáo ngơ" kinh điển của tiếng Việt
Trong phòng lab với test set thì điểm rất đẹp, nhưng khi đưa vào thực tế cho bạn bè gõ thử thì model bắt đầu bộc lộ những pha "ngơ ngác" đậm chất tiếng Việt:
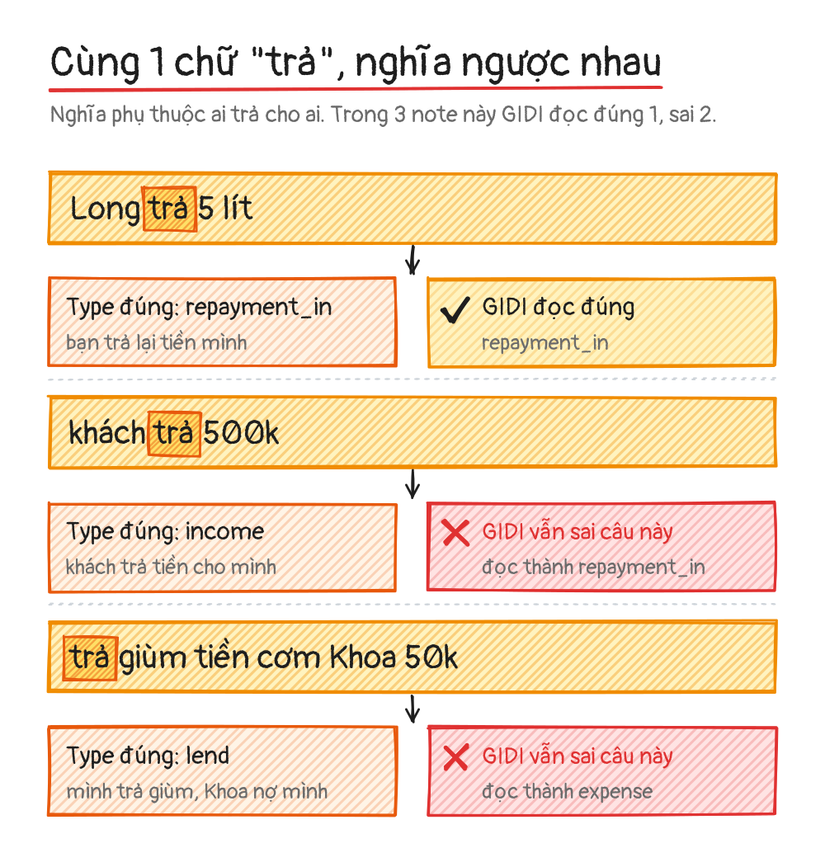
Case 1: Cùng một chữ "trả" nhưng 3 nghĩa trái ngược hoàn toàn!
Đây là ca đau đầu nhất trong NLP tiếng Việt:
Long trả 5 lít: Long trả nợ mình ➔ Bản chất làrepayment_in(GIDI đoán đúng).Khách trả 500k: Khách thanh toán tiền mua hàng ➔ Bản chất làincome(GIDI v3 vẫn đang đoán nhầm thànhrepayment_in).Trả giùm tiền cơm Khoa 50k: Trả hộ bạn ➔ Bản chất làlend(GIDI đang nhầm thànhexpense).
Case 2: Phương ngữ vùng miền
Trong tập dữ liệu huấn luyện ban đầu của mình ít có từ lóng miền Nam. Kết quả là khi gõ câu:
moi lanh luong 26tr
Model chưa từng thấy chữ "lãnh lương" bao giờ, thế là nó tự tin phán luôn thành: borrow (đi vay nợ) =)).
Mấy ca này mình quyết định gom lại thành một test set riêng để bổ sung dữ liệu và retrain trong đợt tiếp theo, chứ nhất quyết không viết patch vá víu thủ công vào weights của model.
8. Chạy thử inference trong trình duyệt: ONNX Runtime Web
Để chạy được model 29 MB này mượt mà trên browser của điện thoại, mình dùng onnxruntime-web với backend WebAssembly (WASM).
Dưới đây là đoạn code tóm tắt cách load và chạy inference trong React/TypeScript:
import * as ort from "onnxruntime-web";
import { parseValue } from "./value-parser";

// 1. Cấu hình ONNX Runtime WASM threads
ort.env.wasm.numThreads = 1; // 1 CPU thread là đủ cho latency ~1.4ms
ort.env.wasm.proxy = false;

// 2. Load model INT8 từ static asset
const session = await ort.InferenceSession.create("/models/gidi-finance-v3.onnx", {
  executionProviders: ["wasm"],
});

// 3. Hàm predict kết hợp 2 luồng
export async function predictNote(text: string) {
  // Luồng 1: Bóc số tiền bằng deterministic parser (microsecond)
  const valueResult = parseValue(text);

  // Luồng 2: Tokenize và đưa qua ONNX Model
  const inputs = tokenize(text);
  const feeds = {
    input_ids: new ort.Tensor("int64", inputs.inputIds, [1, inputs.length]),
    attention_mask: new ort.Tensor("int64", inputs.attentionMask, [1, inputs.length]),
  };

  const output = await session.run(feeds);
  const typeId = argmax(output.type_logits.data);
  const targetSpan = decodeSpan(output.target_logits.data, text);

  return {
    type: TAXONOMY_TYPES[typeId],
    target: targetSpan,
    value: valueResult?.text ?? null,
    amount: valueResult?.numericValue ?? 0,
  };
}
Nhờ chạy trực tiếp trong browser, ứng dụng hoạt động hoàn hảo cả khi offline, bật chế độ máy bay, không tốn một xu tiền hosting backend API.
9. Tổng kết & Mời anh em vào "phá" thử
Làm xong pet project này, mình rút ra được vài điều:
- Không phải bài toán nào cũng cần gọi LLM: Với các tác vụ phân loại và trích xuất thực thể đơn giản, một mô hình nhỏ chạy on-device giải quyết trọn vẹn bài toán về tốc độ (1.4 ms), hoàn toàn bảo mật cho dữ liệu cá nhân và không tốn chi phí server.
- Kỹ thuật phần mềm bổ trợ cho ML: 500 dòng code parser đã cứu dự án khỏi việc phải gánh một model 58 MB. Đừng cố ép neural network làm việc mà vài trăm dòng logic thông thường xử lý tốt hơn và nhẹ hơn.
- Chấp nhận chưa hoàn hảo để ship: Model hiện tại đạt ~78.9% end-to-end accuracy trên tập test thực tế. Chưa chạm mốc 95% nhưng đã đủ chạy được một app note hoàn chỉnh.
Model GIDI hiện vẫn còn nhiều chỗ ngây ngô và học vẹt. Rất mong anh em ghé qua trải nghiệm thử và gõ các câu note thật dị, tiếng lóng địa phương của anh em xem nó đoán đúng hay sai nhé:
- 🌐 Live Demo (Web & Mobile): https://gidi.8bu.dev
- 🛠️ Dev Tools (/lab): https://gidi.8bu.dev/lab
- 📦 GitHub Source Code: https://github.com/8bu/gidi
- 🤗 Hugging Face Model: https://huggingface.co/x8bu/gidi-finance
Anh em test thấy câu nào model đọc "ngáo" thì cứ comment bên dưới chia sẻ với mình để mình gom data cho đợt train tới nghen! Cảm ơn mọi người đã theo dõi bài viết.
All rights reserved
