

Top 10 mô hình AI: biến thứ hạng trong bảng xếp hạng thành lựa chọn kiểm chứng được
Top 10 mô hình AI: biến thứ hạng trong bảng xếp hạng thành lựa chọn kiểm chứng được
Ngày viết: 12/10/2026. Toàn bộ số liệu được thu thập trong cùng ngày. Bảng xếp hạng và danh mục mô hình của nhà cung cấp thay đổi rất nhanh — hãy kiểm tra ngày trước khi áp dụng bất kỳ con số nào.
Về phương pháp: điểm số, chi phí và độ trễ lấy từ bảng xếp hạng công khai. Phần đo đạc API là do tôi tự chạy, mỗi hạng mục lặp lại hai lần. Bài viết có sử dụng AI hỗ trợ biên tập; toàn bộ số liệu và mã nguồn đều đã được kiểm tra thủ công.
Vấn đề: chọn mô hình theo thứ hạng thì dễ, nhưng thường sai
Khi tích hợp một mô hình ngôn ngữ lớn vào dự án, quyết định dễ làm nhất là mở bảng xếp hạng và chọn vị trí số 1.
Nhưng bảng xếp hạng trả lời câu hỏi "mô hình nào có điểm tổng hợp cao nhất". Còn câu hỏi của bạn là "mô hình nào phù hợp với công việc của tôi". Hai câu hỏi này cho ra hai đáp án khác nhau, và khoảng cách giữa chúng lớn hơn ta tưởng.
Con số thuyết phục nhất trong bài này: mô hình đứng đầu bảng, ở đúng cấu hình giúp nó đứng đầu, mất 748 giây để trả về token đầu tiên. Tức là hơn mười hai phút. Trong khi đó mô hình hạng hai, chỉ cần đổi mức suy luận, trả token đầu tiên sau 0,87 giây.
Bài viết này ghi lại toàn bộ quá trình: đọc bảng xếp hạng, gọi API thật từng mô hình, rồi đưa ra quyết định dựa trên các trường trong usage.
Một số thuật ngữ trước khi bắt đầu
| Thuật ngữ | Ý nghĩa trong bài |
|---|---|
| TTFT (Time to First Token) | Thời gian từ lúc gửi yêu cầu đến khi nhận được ký tự đầu tiên. Đây là thứ người dùng thực sự cảm nhận |
| Mức suy luận (reasoning effort) | Tham số max / high / medium / low. Mức càng cao, mô hình "nghĩ" càng lâu |
prompt_tokens |
Số token đầu vào được tính phí cho một lần gọi |
reasoning_tokens |
Số token mô hình dùng để suy luận — bạn không nhìn thấy nội dung này nhưng vẫn trả tiền cho nó |
Bối cảnh: bảng xếp hạng cho ta những gì
Thứ tự dưới đây theo Artificial Analysis Intelligence Index v4.3.2, với trọng số: Agent 30%, lập trình 20%, suy luận khoa học 20%, năng lực tổng quát 30%.
| Hạng | Mô hình (cấu hình) | Điểm | Chi phí/tác vụ (USD) | tok/s | TTFT |
|---|---|---|---|---|---|
| 1 | Claude Opus 5.5 (max with fallback) | 58 | 5,98 | 96 | 748,61 s |
| 2 | Claude Sonnet 5.5 (max with fallback) | 56 | 5,46 | 137 | 484,09 s |
| 3 | Claude Fable 5.1 (max with fallback) | 53 | 7,63 | 65 | 250,30 s |
| 3 | GPT-6 Astra (max) | 53 | 3,26 | 64 | 383,62 s |
| 3 | Gemini 4 Argon (high) | 53 | 1,99 | — | — |
| 6 | GPT-6.1 Sol (max) | 52 | 0,72 | 65 | 330,58 s |
| 7 | Muse Spark 1.3 (max) | 48 | 1,60 | 121 | 48,89 s |
| 8 | Grok 4.7 (xhigh) | 46 | 3,74 | 83 | 88,14 s |
| 8 | MiMo-V2.6-Pro | 46 | 0,13 | 48 | 3,51 s |
| 10 | Qwen3.8 Max (0902) | 45 | 5,41 | 36 | 2,82 s |
| 10 | GLM-5.3 (max) | 45 | 2,01 | 66 | 3,36 s |
Điểm bằng nhau thì xếp đồng hạng, nên "Top 10" ở đây có 11 mô hình.
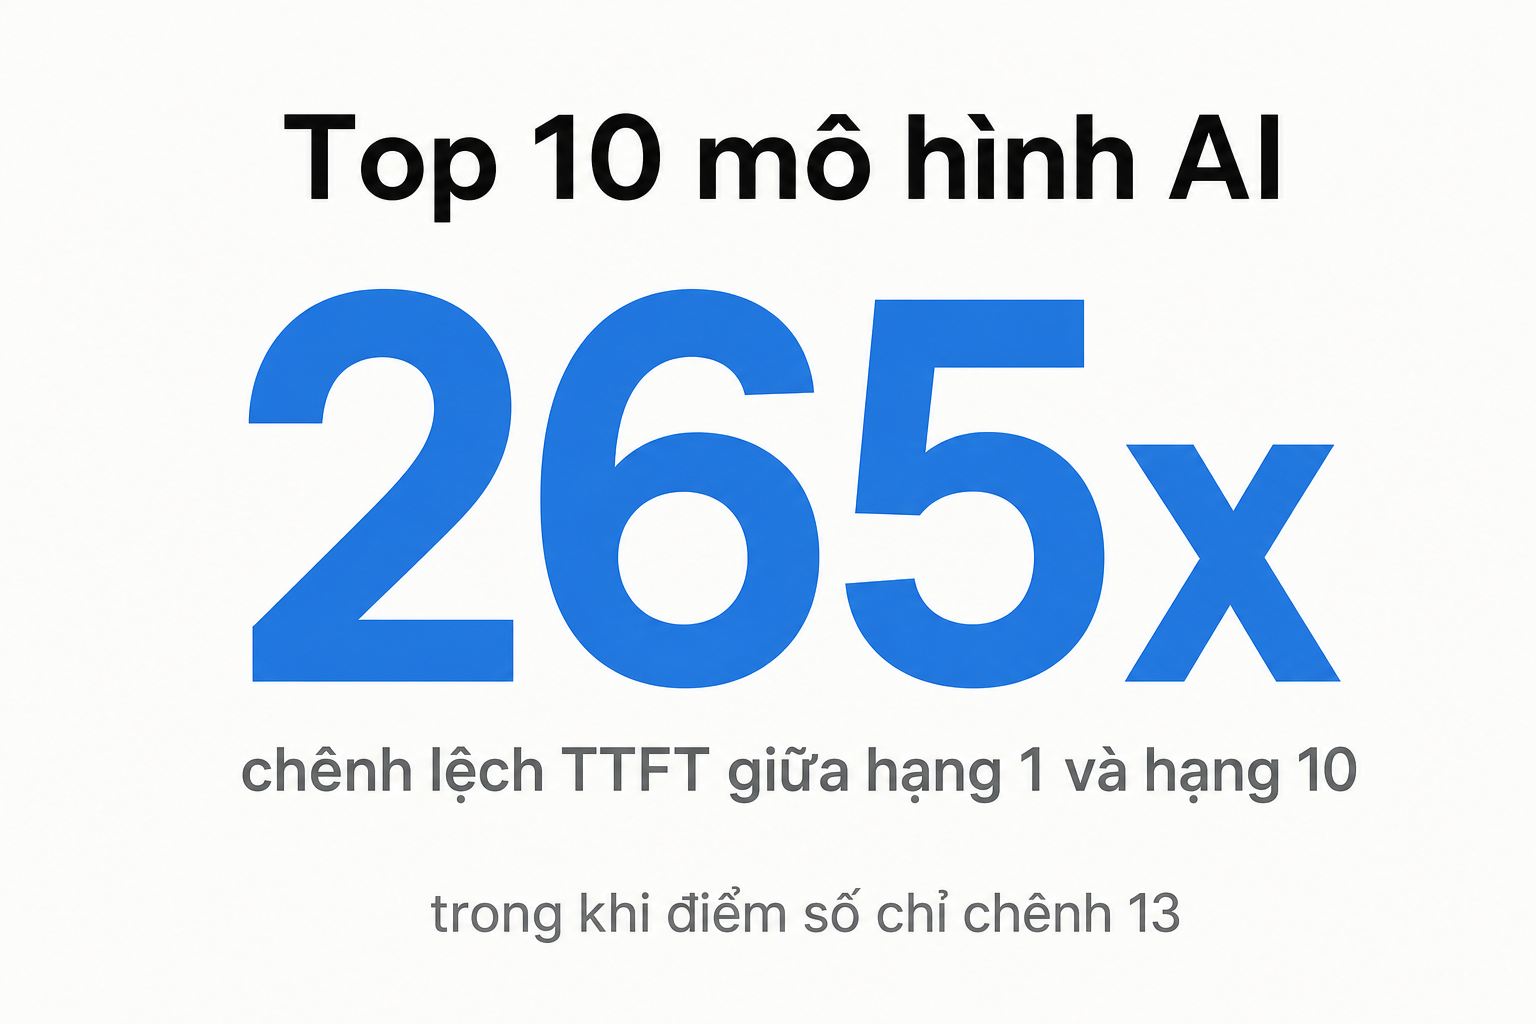
Điều đáng chú ý nhất không nằm ở cột thứ hạng, mà ở cột cuối cùng. Điểm số trải từ 58 xuống 45 — chênh 13 điểm. TTFT trải từ 748,61 giây xuống 2,82 giây — chênh 265 lần.
Đơn vị so sánh là cấu hình, không phải tên mô hình
Đây là điểm dễ bỏ sót nhất. Cùng một mô hình, đổi mức suy luận thì trở thành một sản phẩm khác hẳn:
| Mô hình | Mức | Điểm | Chi phí/tác vụ | TTFT |
|---|---|---|---|---|
| Claude Opus 5.5 | max | 58 | 5,98 | 748,61 s |
| Claude Opus 5.5 | high | 54 | 1,82 | 44,34 s |
| Claude Opus 5.5 | medium | 51 | 1,34 | 21,61 s |
| GPT-6.1 Sol | max | 52 | 0,72 | 330,58 s |
| GPT-6.1 Sol | medium | 48 | 0,21 | 7,55 s |
Hạ Opus 5.5 từ max xuống high: mất 4 điểm, chi phí giảm khoảng 70%, TTFT giảm từ 748 giây còn 44 giây — tức khoảng 94%.
Mất 4 điểm để tiết kiệm mười hai phút chờ đợi. Với dịch vụ trực tuyến, đây gần như không phải là lựa chọn khó.
Bài học không phải "luôn dùng mức thấp", mà là: hãy coi mức suy luận là một tham số cần kiểm thử, đừng để nguyên giá trị mặc định.
Ba mô hình trong bảng tôi không gọi được
Gemini 4 Argon và Muse Spark 1.3 không có trong danh mục đang bán. Grok là trường hợp khác: bảng xếp hạng ghi Grok 4.7 (xhigh), còn thứ đang bán là Grok 4.6. Đây là hai phiên bản khác nhau, không phải tên gọi khác của cùng một mô hình — nên không thể lấy điểm của 4.7 để suy ra 4.6.
Đây chính là kiểu thất bại phổ biến nhất khi chọn mô hình theo bảng xếp hạng: chép đúng tên, nhưng khi gọi thì nhận về lỗi "model không tồn tại". Cách làm đúng là đảo ngược thứ tự — xác định trước những model ID bạn thực sự gọi được, rồi mới tra điểm của chúng.
Thực hành: hợp đồng kết quả trước, đo đạc sau
Bước 1 — Định nghĩa thế nào là "đạt"
Trước khi gọi bất kỳ API nào, hãy viết ra tiêu chí nghiệm thu. Nếu không có bước này, bạn sẽ chỉ đang cảm tính so sánh các đoạn văn bản.
Ví dụ tiêu chí cho một tác vụ trích xuất:
- JSON phân tích cú pháp được, không có ký tự thừa
- Các trường bắt buộc đều có mặt
- Trường thiếu dữ liệu phải là
null, không được bịa - Thời gian tới token đầu tiên dưới 3 giây
Bước 2 — Kiểm tra kết nối tối thiểu
Đặt khoá API vào biến môi trường, không viết thẳng vào mã nguồn.
export API_KEY="khoá_của_bạn"
curl -s -X POST https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-haiku-5-5",
    "messages": [{"role": "user", "content": "Reply with exactly: OK"}],
    "max_tokens": 512
  }'
Phản hồi thực tế, mất 2,69 giây (chỉ trích phần quan trọng):
{
  "model": "claude-haiku-5-5",
  "choices": [{"message": {"content": "OK"}, "finish_reason": "stop"}],
  "usage": {
    "prompt_tokens": 42,
    "completion_tokens": 4,
    "total_tokens": 46,
    "completion_tokens_details": {"reasoning_tokens": 0}
  }
}
Bước 3 — Luôn in ra ba trường này
| Trường | Lý do phải xem |
|---|---|
prompt_tokens |
So với độ dài bạn thực sự gửi. Chênh lệch lớn nghĩa là có chi phí cố định |
reasoning_tokens |
Bao nhiêu hạn mức đã tiêu vào phần bạn không nhìn thấy |
completion_tokens |
Nếu bằng đúng max_tokens bạn đặt, nghĩa là đã bị cắt — nội dung có thể rỗng |
Không cần framework đánh giá nào cả, một vòng lặp là đủ. Tôi đã gọi 10 mô hình, tất cả trả về HTTP 200, thời gian từ 1,80 đến 7,80 giây.
Kết quả: hai lỗi im lặng mà bảng xếp hạng không cho biết
Cả hai lỗi dưới đây đều trả về HTTP 200 và không có thông báo lỗi nào.
Lỗi 1 — Gửi hai ký tự, bị tính 4223 token đầu vào
Tôi gửi cho gpt-6.1-sol một yêu cầu có nội dung chỉ là hi:
"prompt_tokens": 4223
Cùng thời điểm, claude-sonnet-5-5 với yêu cầu 18 token trả về đúng prompt_tokens: 18. Đo lại hai lần, kết quả ổn định trong khoảng 4223–4227.
Nghĩa là mô hình này có chi phí đầu vào cố định khoảng 4200 token cho mỗi lần gọi.
Với tác vụ xử lý văn bản dài vài nghìn token, con số này không đáng kể. Nhưng nếu hệ thống của bạn gửi vài trăm nghìn yêu cầu ngắn mỗi ngày, phần cố định này chính là hoá đơn của bạn.
Điều trớ trêu: trên bảng xếp hạng, gpt-6.1-sol là lựa chọn đáng tiền nhất — 52 điểm với chi phí 0,72 USD, cấu hình duy nhất đạt trên 50 điểm mà dưới 1 USD. Chỉ nhìn bảng, bạn sẽ chọn nó cho kịch bản tần suất cao, mà đó lại chính là cách dùng bất lợi nhất.
Cách kiểm tra: gửi một lần yêu cầu ngắn nhất trong hệ thống của bạn, in usage.prompt_tokens ra và đối chiếu với độ dài dự kiến. Mất mười giây.
Lỗi 2 — max_tokens không phải giới hạn độ dài câu trả lời
Tôi đặt max_tokens=64 cho glm-5.3, phần nội dung trả về gần như rỗng. Nhìn usage mới rõ nguyên nhân:
"completion_tokens": 64,
"completion_tokens_details": { "reasoning_tokens": 60 }
Trong 64 token đầu ra, 60 token đã bị phần suy luận tiêu hết, chỉ còn 4 token cho nội dung thật.
Đổi sang max_tokens=512: đầu ra 34 token, suy luận chiếm 32, nội dung trả về bình thường. Cùng yêu cầu đó gửi cho claude-sonnet-5-5 thì reasoning_tokens bằng 0.
Vậy mô hình này bật suy luận theo mặc định, và token suy luận ăn vào hạn mức max_tokens. Nếu bạn đặt giá trị này theo "độ dài câu trả lời mong muốn", kết quả nhận được sẽ là nội dung rỗng — mà log thì hoàn toàn sạch.
Cách kiểm tra: in usage.completion_tokens_details.reasoning_tokens. Nên chạy kiểm tra này cho mọi mô hình bật suy luận mặc định.
Mở rộng phép thử mà không tự lừa mình
Một lần gọi thành công không chứng minh được gì. Để biến nó thành cơ sở quyết định:
- Lấy 30–50 tác vụ từ nghiệp vụ thật, bao gồm cả các trường hợp biên dễ hỏng và đầu vào dài.
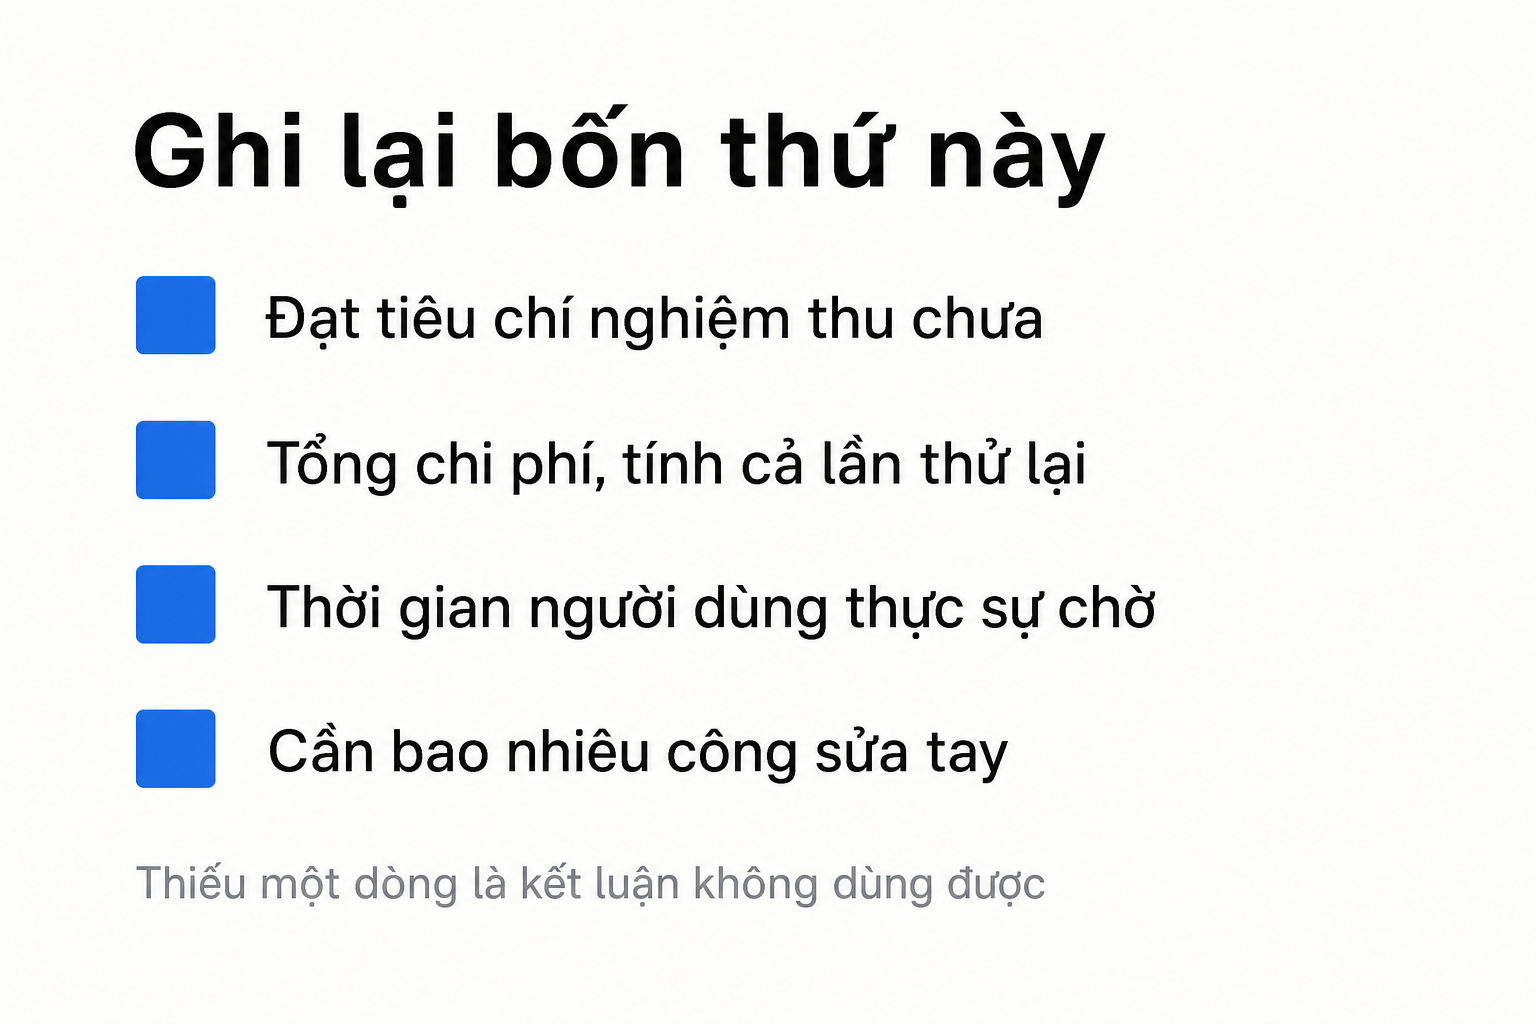
- Ghi lại bốn thứ, thiếu một thứ là kết luận không dùng được:
- Tác vụ có đạt tiêu chí nghiệm thu không
- Tổng chi phí hoàn thành, tính cả các lần thất bại và thử lại
- Thời gian người dùng thực sự chờ (TTFT cộng tổng thời gian)
- Cần bao nhiêu công sửa tay
- 30–50 tác vụ chỉ đủ để sàng lọc vòng đầu, không đủ để chứng minh tỷ lệ lỗi thấp. Khi đã vào danh sách ứng viên sản xuất, phải mở rộng mẫu và kiểm thêm phân bố độ trễ, giới hạn đồng thời và khả năng phục hồi sau lỗi.
Nếu bạn định phân luồng nhiều mô hình: để mô hình rẻ xử lý phần việc rõ ràng, dễ kiểm chứng; chỉ nâng cấp lên cấu hình mạnh khi kiểm chứng thất bại hoặc tác vụ chạm điều kiện phức tạp. Căn cứ nâng cấp phải là tín hiệu quan sát được — kết quả test, kiểm tra trường dữ liệu, bằng chứng truy xuất — chứ không phải việc mô hình tự nói rằng nó "khá chắc chắn".
Danh sách model ID đang bán và các mức tính phí tương ứng có thể tra trực tiếp ở trang mô hình và giá; API tra cứu cũng mở công khai, không cần khoá, nên bạn có thể tự kéo một bản để đối chiếu các con số trong bài.
Tổng kết: khi nào bảng xếp hạng thực sự hữu ích
| Công việc của bạn | Ứng viên | Lý do | Vẫn phải tự kiểm tra |
|---|---|---|---|
| Rà soát kiến trúc, refactor quan trọng (ngoại tuyến) | claude-opus-5-5 |
Điểm 58, cao nhất kỳ này | Thử mức high trước; nếu đạt thì không cần max |
| Lập trình hằng ngày, có người ngồi chờ | claude-sonnet-5-5 |
137 tok/s; mức medium có TTFT 0,87 s |
Đo P95 chứ không đo trung bình |
| Agent lập trình, gọi công cụ nhiều vòng | claude-fable-5-1 |
Xếp hạng Agent cao hơn hạng tổng hợp | Phải đo trong harness của chính bạn |
| Xử lý theo lô ban đêm, cần tiết kiệm đầu ra | gpt-6-astra |
~27K token đầu ra mỗi tác vụ, so với ~119K | Đếm tổng đầu ra để hoàn thành việc, không đếm một lần |
| Cần năng lực cao mà ngân sách hẹp (ngoại tuyến) | gpt-6.1-sol |
Cấu hình duy nhất trên 50 điểm dưới 1 USD | Kiểm prompt_tokens trước (Lỗi 1) |
| Phân loại số lượng lớn, cần tự triển khai | mimo-v2.6-pro |
0,13 USD, TTFT 3,51 s, trọng số mở | Định tiêu chí nghiệm thu trước, đừng loại theo thứ hạng |
| Đầu ra ngắn, cần phản hồi đầu tiên nhanh | qwen3.8-max |
TTFT 2,82 s thấp nhất, nhưng tốc độ đầu ra chậm nhất | Đo tách riêng TTFT và tổng thời gian |
| Dùng chung, có gọi công cụ | glm-5.3 |
Ba chỉ số đều không có điểm yếu rõ rệt | Đặt max_tokens dư ra (Lỗi 2) |
| Phân loại ticket, thông lượng cao | claude-haiku-5-5 |
235 tok/s, 0,21 USD — không nằm trong Top 10 | Nén tải bằng mức đồng thời thật |
Dòng cuối cùng là điều tôi muốn nói nhất: một mô hình 43 điểm có thể thắng mô hình 58 điểm, nếu đúng việc.
Bảng xếp hạng hữu ích ở chỗ nó thu hẹp danh sách ứng viên từ hàng trăm xuống còn mười. Nhưng bước từ mười xuống một thì bảng xếp hạng không làm thay bạn được — bước đó nằm ở hợp đồng kết quả và phép đo của chính bạn.
Giới hạn của bài viết này
- Điểm số, chi phí, tốc độ và độ trễ lấy từ bảng xếp hạng công khai, không phải tôi chạy lại bộ benchmark đầy đủ. Phần tôi tự đo chỉ gồm khả năng kết nối và phép đếm token, trên 10 mô hình.
- Ngày thu thập là 12/10/2026. Ngày thu thập không phải ngày đo của từng mô hình.
- Chỉ số này thiên về tiếng Anh và tác vụ văn bản thuần. Không nên đọc nó như thước đo cho tiếng Việt, hình ảnh hay giọng nói.
- Ba mô hình không tra được trong danh mục đang bán — bài viết không đưa ra khuyến nghị cho chúng.
- Chi phí mỗi tác vụ là giá trị trung bình có trọng số theo cách đo của bên thứ ba, không phải đơn giá mỗi triệu token, cũng không phải chi phí một lần gọi của bạn.
Nguồn dữ liệu
- Artificial Analysis: LLM Leaderboard — điểm số, cấu hình, chi phí, tốc độ, TTFT
- Artificial Analysis: Intelligence Benchmarking — thành phần và trọng số của chỉ số v4.3.2
- Artificial Analysis: Benchmarking Methodology — token tính theo bộ tách từ o200k_base, chỉ số là trung vị trên cửa sổ trượt 72 giờ
- Anthropic: Introducing Claude Opus 5.5 — cơ chế fallback mặc định đằng sau hậu tố
with fallback - Danh mục model ID và mức tính phí: API giá công khai của nhà cung cấp, giá trị ngày 12/10/2026
Toàn bộ đoạn mã trong bài đều đã được chạy thật; hai phát hiện về prompt_tokens và reasoning_tokens mỗi phát hiện được đo lặp lại hai lần.
All rights reserved
