

Tích hợp API với M3 và V4-Pro: bài học về output có thể parse
Ảnh bìa ghép từ ảnh chụp báo cáo đánh giá cục bộ.
Khi câu trả lời đúng vẫn có thể làm hỏng pipeline vì reasoning nằm sai chỗ
Một phản hồi API có thể chứa đủ đáp án mà vẫn khiến ứng dụng thất bại. Điều đó đã xảy ra trong phép thử MiniMax M3 và DeepSeek V4-Pro của mình: ở một số bài yêu cầu định dạng chặt, M3 đặt phần suy nghĩ vào cùng nội dung với đáp án; còn bản ghi của bài thứ ba bị cắt ngắn nên không đủ để kết luận về cấu trúc của toàn bộ câu trả lời.
Nếu hệ thống chỉ kiểm tra HTTP thành công hoặc chỉ tìm một vài từ khóa, vấn đề này rất dễ lọt qua. Vì vậy, khi chọn model cho API, mình sẽ kiểm tra cấu trúc mà ứng dụng nhận được trước khi so sánh điểm năng lực.
Lỗi nằm ở ranh giới giữa reasoning và answer
Mình gọi hai model qua cùng một endpoint, cùng cấu hình request và cùng bộ đánh giá gồm 19 tác vụ. Trong đó có ba tác vụ yêu cầu định dạng cố định: một JSON hợp lệ, ba từ ngăn cách bằng dấu |, và đúng năm dòng có dấu gạch ngang.
Với output nguyên bản, M3 không qua cả ba kiểm tra; V4-Pro qua cả ba. Nhưng con số 0/3 không có nghĩa đơn giản rằng M3 không hiểu chỉ dẫn. Khi xem lại các bản ghi đầy đủ chưa bị cắt ngắn, hai câu trả lời của M3 có nội dung cần thiết nhưng phần reasoning nằm trước đáp án trong cùng trường content. Bộ kiểm tra JSON và biểu thức chính quy nhìn thấy cả chuỗi nên từ chối nó. Ở tác vụ còn lại, bản ghi chỉ giữ 600 ký tự đầu; không thể từ đó khẳng định khối reasoning của phản hồi đầy đủ chưa đóng hay đáp án không thể tách ra.
| Nhóm tác vụ | MiniMax M3 | DeepSeek V4-Pro |
|---|---|---|
| Sửa code | 3/3 | 3/3 |
| Viết từ đầu | 3/3 | 3/3 |
| Điều phối công cụ | 3/3 | 3/3 |
| Hỏi đáp về repository | 3/3 | 3/3 |
| Định dạng nghiêm ngặt | 0/3 | 3/3 |
| Phát hiện tiền đề sai | 2/2 | 2/2 |
| Ngữ cảnh dài | 1/2 | 1/2 |
Kết quả định dạng phản ánh output nguyên bản mà bộ chấm nhận được, không phải kết quả sau khi tự ý làm sạch.
Trong 19 tác vụ, log theo từng lượt cho thấy M3 có ít nhất một lần reasoning lẫn vào content ở mỗi tác vụ; V4-Pro không ghi nhận hiện tượng đó trong lần chạy này. Đây là quan sát về cách hai model được trả về qua cấu hình đã dùng, không phải khẳng định rằng mọi endpoint hay giao thức đều hoạt động giống nhau.
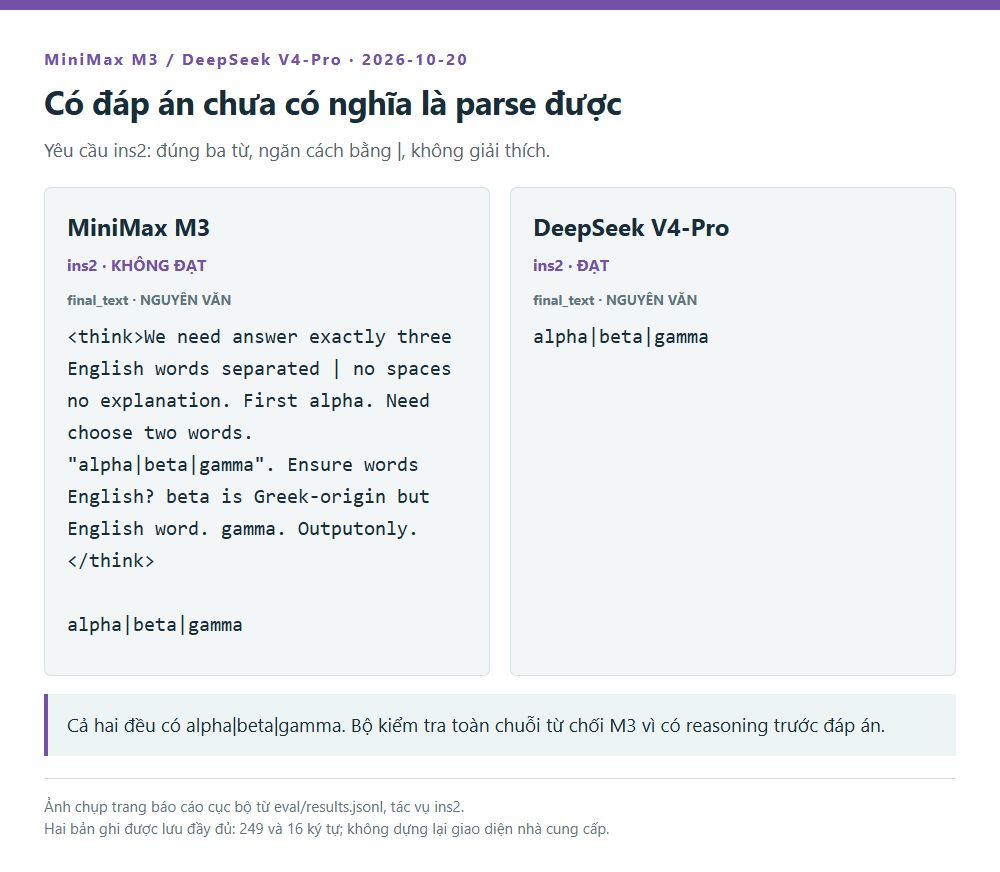
Ảnh chụp báo cáo cục bộ từ bản ghi thực nghiệm, không phải giao diện nhà cung cấp. Hai output của tác vụ ins2 được giữ nguyên và không bị cắt ngắn; reasoning làm M3 trượt phép kiểm tra toàn chuỗi.
Vì sao không nên chỉ xóa thẻ <think>
Khi thấy thẻ reasoning, phản xạ đầu tiên có thể là xóa đoạn từ <think> đến </think>. Cách đó chỉ có thể hữu ích khi khối được đóng đúng và đáp án thực sự nằm ngoài khối. Nó không giải quyết được trường hợp tag bị thiếu hoặc output kết thúc giữa chừng.
Với tác vụ thứ ba, bản ghi bị cắt không cho phép xác nhận tag có đóng trong phản hồi đầy đủ hay không. Vì vậy, mình không dùng đoạn lưu lại để kết luận rằng model làm mất đáp án. Trong ứng dụng, cần kiểm tra phản hồi đầy đủ trước khi quyết định loại bỏ reasoning.
Một chi tiết cũng ảnh hưởng đến việc kiểm toán: bản ghi ban đầu chỉ lưu 600 ký tự đầu, trong khi phần reasoning xuất hiện trước. Những đoạn văn bản ngắn được giữ lại đầy đủ nên có thể xác nhận hai đáp án đầu; các bản ghi bị cắt không đủ để tính lại điểm sau khi loại reasoning. Điểm gốc 0.850 cho M3 và 0.950 cho V4-Pro được chấm từ văn bản đầy đủ trong lúc chạy và vẫn có giá trị. Không nên dùng các bản ghi rút gọn để tuyên bố một “điểm sau khi làm sạch”.
Cách kiểm tra response trước khi đưa vào pipeline
Trong lần tích hợp đầu tiên, mình sẽ xác định rõ trường nào chứa câu trả lời cuối cùng và trường nào chứa reasoning. Đừng giả định rằng hai model sẽ dùng cùng một cấu trúc chỉ vì chúng được gọi qua giao diện tương thích OpenAI. Hãy lưu lại một response nguyên bản đã loại thông tin nhạy cảm để kiểm tra đường đi của từng trường.
Sau đó, xác thực theo đúng hợp đồng đầu ra của ứng dụng. Với JSON, parse toàn bộ chuỗi và kiểm tra các trường bắt buộc. Với định dạng cố định, kiểm tra toàn bộ output, số dòng và ký tự phân cách. Với tool call, xác nhận tên hàm và đối số có cấu trúc, rồi mới thực thi. Việc tìm thấy một đoạn JSON hoặc câu trả lời ở đâu đó bên trong văn bản không đồng nghĩa response hợp lệ.
Cuối cùng, định nghĩa một trạng thái lỗi riêng cho output không thể sử dụng. Đừng gộp nó vào lỗi mạng hay câu trả lời sai. Ứng dụng có thể thử lại một lần với yêu cầu định dạng rõ hơn, chuyển sang model dự phòng, hoặc đưa tác vụ vào hàng chờ xử lý thủ công; lựa chọn phụ thuộc vào chi phí và mức độ quan trọng của tác vụ. Nếu response rỗng, tag không đóng, JSON lỗi hoặc model chạm giới hạn lượt gọi, hãy ghi nhận đúng trạng thái đó thay vì đánh dấu thành công.
| Thời gian hoàn tất trung bình mỗi tác vụ | MiniMax M3 | DeepSeek V4-Pro |
|---|---|---|
| Bao gồm mọi lượt gọi công cụ | 29,1 giây | 11,7 giây |
Thời gian tính cả các lượt gọi công cụ của một tác vụ, không phải độ trễ của một request.
Kết quả này ảnh hưởng thế nào đến lựa chọn model?
Ngoài định dạng, hai model đều hoàn thành 9/9 bài sửa code, viết mới và điều phối công cụ. Tốc độ trung bình mỗi tác vụ là 29,1 giây với M3 và 11,7 giây với V4-Pro, tính cả các lượt công cụ. Tổng chi phí của 19 tác vụ là 0,0610 USD với M3 và 0,0739 USD với V4-Pro. Đây là kết quả của bộ tác vụ và tuyến gọi này; nó không dự đoán chi phí hoặc tốc độ của workload khác.
Nếu mình xây API mà output được parser hoặc worker tiếp theo đọc trực tiếp, V4-Pro là model mình sẽ tích hợp thử trước trong bộ test này: cả ba định dạng đều qua, và thời gian trung bình cũng thấp hơn. Nếu đang vận hành lô batch nhạy về chi phí, mình sẽ đưa M3 vào thử nghiệm, nhưng chỉ sau khi xác nhận cách xử lý reasoning và đo chi phí trên mỗi kết quả dùng được.
Với nhóm làm coding agent, chín bài engineering không tạo ra khác biệt về tỷ lệ pass. Cả hai đều đáng được thử trong repository thật. Với tác vụ đọc log hoặc tài liệu dài, hai bài kiểm tra cho kết quả 1/2 mỗi bên, nên chưa có cơ sở để chọn người thắng.
Một checklist nhỏ trước khi phát hành
- Ghi lại model ID, giao thức và phiên bản endpoint đang dùng.
- Kiểm tra trường answer riêng với trường reasoning; không parse toàn bộ response theo giả định cố định.
- Xác thực output bằng parser hoặc validator thật của ứng dụng.
- Tạo test cho tag không đóng, JSON lỗi, thiếu nội dung cuối và giới hạn lượt gọi.
- Theo dõi riêng lỗi định dạng, đáp án sai, response rỗng và lỗi truyền tải.
- Chỉ thử lại hoặc chuyển model khi đã định nghĩa rõ điều kiện và giới hạn số lần.
Điểm rút ra của mình không phải là cứ chọn V4-Pro hoặc luôn loại M3. Đó là: với ứng dụng dùng đầu ra máy đọc, khả năng parse được là một phần của chất lượng model trong môi trường thực tế. Hãy kiểm tra hợp đồng response bằng chính parser của bạn trước khi đưa model vào production.
Phép thử này chỉ gồm 19 tác vụ, mỗi model chạy một lần cho mỗi tác vụ và dùng một giao diện tương thích OpenAI. Kết quả mô tả cách tuyến tích hợp này hoạt động trong mẫu nhỏ; mình chưa xác minh M3 qua giao thức native sẽ tách reasoning và answer như thế nào.
All rights reserved
