

So sánh Kimi K3.1 Pro và Claude Fable 5.2 trên cùng 19 câu hỏi: năng lực hòa nhau, hóa đơn chênh 3,3 lần
Mình ngồi đọc bảng xếp hạng gần một tiếng, rồi nhận ra không có con số nào trả lời được câu mình cần: việc này giao cho model nào thì đỡ phải sửa lại. Nên mình bỏ nửa ngày, dựng một bộ 19 câu, chạy cả hai model trên cùng một endpoint, cùng một máy, chỉ đổi chuỗi model.
Kết quả là 18 so với 17. Nhưng điểm không phải chỗ đáng nói. Bảy nhóm, năm nhóm hòa tuyệt đối; hai câu bị trượt đều là lỗi thao tác, không phải lỗi hiểu. Thứ thực sự khác nhau nằm ở cấu trúc token, và đó mới là chỗ quyết định hóa đơn của bạn.
Bài này viết theo hướng làm lại được: điều kiện, bộ câu hỏi, cách chấm, rồi kết quả. Cuối bài có ba bước để bạn tự đo trong hai mươi phút.
Điều kiện cố định trước khi chạy
| Hạng mục | Giá trị |
|---|---|
| Ngày chạy | 12/11/2026, cả hai model trong cùng buổi |
| Số câu | 19, chia thành 7 nhóm |
| Endpoint | một endpoint tương thích OpenAI, một khóa |
| Số lần gọi | 19 lần cho mỗi model |
| Vòng sửa cho nhóm code | tối đa 3 |
| Các nhóm còn lại | một lượt, không sửa |
| max_tokens | từ 2048 trở lên |
| Cách chấm | script chấm tự động |
Mình chấm bằng script vì một lý do rất thực dụng: nếu tự đọc rồi tự cho điểm, câu trả lời nào mình thấy hay sẽ được điểm cao hơn. Mỗi câu có một điều kiện đạt kiểm tra được bằng máy — chạy bộ test ẩn, parse JSON rồi so trường và kiểu dữ liệu, so chuỗi chính xác, đếm số dòng bảng. Phần giải thích của model không được tính điểm, chỉ tính thứ nộp ra cuối cùng.
19 câu gồm những gì
- Sửa code (3). Một hàm parse duration có ba lỗi cùng lúc: đầu vào sai không trả None, chuỗi thiếu đơn vị ở cuối, đơn vị bị lặp. Một hàm phân trang lệch một đơn vị ở biên. Một phép so sánh thời gian nổ khi gặp datetime aware.
- Viết từ đầu (3). LRU cache, gộp log, token bucket. Cả ba đều có bộ test ẩn do mình viết.
- Bố trí công cụ (3). Tra thời tiết, tìm trong tài liệu, chạy SQL. Mỗi câu phải chọn đúng công cụ và đúng tham số.
- Hỏi đáp repo (3). Đưa vào ba file, hỏi những câu buộc phải đọc chéo mới trả lời được.
- Tuân thủ hướng dẫn (3). JSON thuần, không bọc code block; một đoạn 140–160 ký tự với ba điểm bán hàng bắt buộc và bốn từ bị cấm; một bảng ba dòng hai cột.
- Chống gây nhiễu (2). Một câu khẳng định sai về list trong Python; một câu xin thông số của một model không tồn tại.
- Ngữ cảnh dài (2). Khóa giấu ở dòng 287 trong file log 400 dòng; hằng số
LAST_RETRY = 43nằm gần cuối module 800 dòng.
Kết quả
| Nhóm | Số câu | Kimi K3.1 Pro | Claude Fable 5.2 |
|---|---|---|---|
| Sửa code | 3 | 3/3 | 3/3 |
| Viết từ đầu | 3 | 3/3 | 3/3 |
| Bố trí công cụ | 3 | 2/3 | 2/3 |
| Hỏi đáp repo | 3 | 3/3 | 3/3 |
| Tuân thủ hướng dẫn | 3 | 2/3 | 3/3 |
| Chống gây nhiễu | 2 | 2/2 | 2/2 |
| Ngữ cảnh dài | 2 | 2/2 | 2/2 |
| Tổng | 19 | 17/19 | 18/19 |
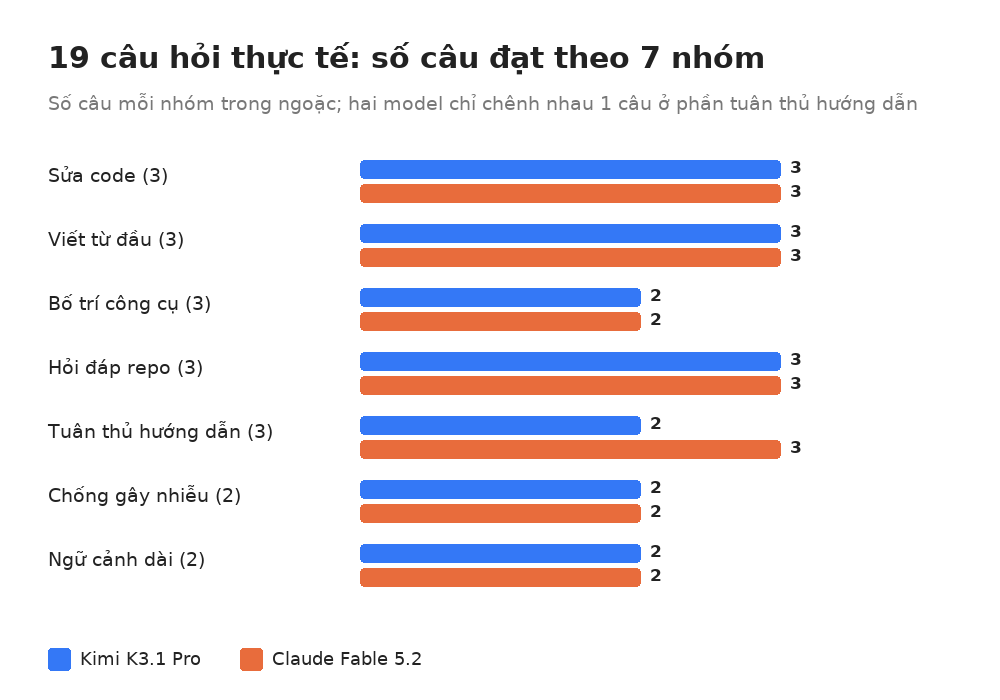
Sáu câu code của hai nhóm đầu, cả hai model đều qua ngay vòng đầu, test ẩn không trượt câu nào. Code của Fable ngắn hơn khoảng ba mươi phần trăm, và ở câu token bucket nó viết thêm chú thích về ngữ nghĩa thời gian — test vẫn qua.
Hỏi đáp repo và ngữ cảnh dài sạch. Ở câu model không tồn tại, cả hai đều không bịa thông số; Fable từ chối rồi dán thêm một bảng giá của model cũ, có ghi là tham khảo và chưa kiểm chứng — mình vẫn tính là đạt, chỉ ghi lại chỗ đó.
Hai câu bị trượt, và vì sao đừng đọc thành "yếu hơn"
Câu SQL. "Tính tổng tiền đơn hàng tháng trước." Kimi gọi search_docs và đi tìm trong tài liệu. Fable gọi run_sql nhưng câu lệnh truy vấn information_schema chứ không phải bảng đơn hàng. Cả hai sai, sai theo hai kiểu khác nhau — nghĩa là đây không phải phép so sánh hai trình độ, mà là hai chỗ hỏng khác nhau của cùng một kỹ năng.
Câu viết. Khung 140–160 ký tự, ba điểm bán hàng bắt buộc, bốn từ bị cấm. Lần này Kimi vượt khung nên bị tính là trượt; Fable qua. Nhưng chính câu này ở lần chạy thử trước, Kimi viết 155 ký tự và qua. Vì vậy mình đọc đây là dao động đầu ra, không phải giới hạn năng lực, và không lấy nó làm kết luận.
Cả hai kiểu trượt đều không tạo ra lỗi ở production. Chúng tạo ra việc phải làm lại.
Chỗ tiền thực sự đi: cấu trúc token
Đây là phần mình muốn bạn nhớ nhất.
| Chỉ số | Kimi K3.1 Pro | Claude Fable 5.2 |
|---|---|---|
| Token đầu vào | 27.131 | 36.074 |
| Token đầu ra (gồm suy luận) | 10.896 | 6.386 |
| Trong đó suy luận | 9.175 | 0 |
| Phần chữ đọc được | 1.721 | 6.386 |
| Tổng thời gian | 401,6 giây | 130,1 giây |
| Trung bình mỗi câu | khoảng 21,1 giây | khoảng 6,8 giây |
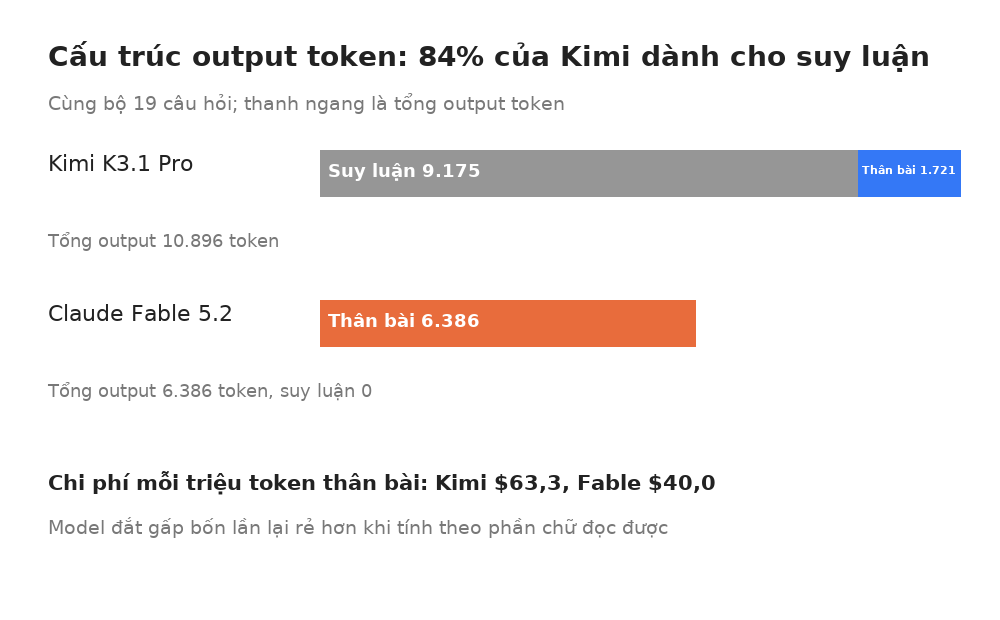
84% đầu ra của Kimi là suy luận. Tiền của nó đi vào chỗ "nghĩ", không đi vào chỗ "viết". Fable không có token suy luận, nên mỗi token bạn trả tiền đều là token đọc được.
Đổi cách tính sang phần chữ đọc được thì kết luận đảo chiều: Kimi khoảng $63,3 cho một triệu token chữ, Fable khoảng $40,0. Model đắt gấp bốn lần về giá niêm yết lại rẻ hơn nếu bạn chỉ tính phần đọc được — vì không có phần nào bị giấu đi.
Hình dạng hai bên ngược nhau hẳn: Kimi vào ít, ra nhiều, nghĩ nhiều, tổng thời gian dài; Fable vào nhiều, ra toàn chữ, nghĩ bằng không, tổng thời gian ngắn. Việc của bạn nặng ở đầu nào thì đáp án nghiêng về bên đó.
Ngữ cảnh dài: đạt, nhưng chưa chạm trần
Hai câu vật liệu: tìm khóa ở dòng 287 trong log 400 dòng, tìm hằng số ở gần cuối module 800 dòng. Cả hai model tìm đúng: KX9-2077 và 43, đầu ra chỉ vài token.
Nhưng vật liệu chỉ khoảng 14 nghìn token. Kimi công bố cửa sổ 1.048.576 token, trang sản phẩm của Fable 5.2 không ghi con số nào. Nghĩa là hai câu này chỉ nói được một điều: ở mức 14 nghìn token, cả hai không đọc sót. Nó không nói gì về khả năng "một triệu token". Muốn kiểm tra trần thì phải dựng đầu vào sát trần, lần này mình không làm.
Bốn cái bẫy chỉ lộ ra khi tích hợp
Phần này không liên quan đến việc chọn ai, mà đến việc bạn gắn nó vào hệ thống thì có nổ hay không. Mình thử luôn trên sáu model trong cùng một buổi.
temperature không phải tham số dùng chung. Kimi trả 400 khi gửi 0.7, và thông báo lỗi không nêu tên trường nào. gpt-6.1-terra bắt buộc phải bằng 1. Tuyến Claude nhận cả 2 rồi lặng lẽ bỏ qua. Gemini trả 429 khi gửi 5, trông y như bị giới hạn tần suất. DeepSeek trả 400 rõ ràng. Sáu model, năm kiểu phản ứng.
200 mà thân bài rỗng. Đặt max_tokens 1200, Kimi trả 200, finish_reason là length, nội dung 0 ký tự, 1197 token dồn hết vào suy luận. Điều kiện kiểm tra phải là finish_reason cộng độ dài nội dung, không phải mã trạng thái.
Đầu ra có cấu trúc cũng có phương ngữ riêng. Tuyến Claude không nhận json_object, trả 400, phải đổi sang json_schema; các nhà còn lại nhận json_object.
Gọi công cụ không phải mặc định. gpt-6.1-terra ba lần trả "dịch vụ tạm thời không khả dụng". Gemini buộc phải đặt tool_choice: required; để auto thì bốn trong năm lần trả thân bài rỗng kèm content_filter.
Chọn theo việc, không theo điểm
| Việc của bạn | Chọn | Vì sao |
|---|---|---|
| Chat cho người dùng, cần trả lời ngay | Claude Fable 5.2 | Tổng thời gian 130,1 giây so với 401,6 giây |
| Chạy hàng loạt, không cần đồng bộ | Kimi K3.1 Pro | Gói batch tính 60% giá niêm yết |
| Đầu ra đưa thẳng cho chương trình khác đọc | Cả hai, nhưng phải thêm lớp kiểm | JSON và bảng đều qua; Kimi từng vượt khung ký tự một lần |
| Tìm trong vật liệu dài | Cả hai, ở mức 14 nghìn token | Trần chưa kiểm chứng, hãy đo bằng vật liệu của bạn |
| Điều phối công cụ | Cả hai đều phải thêm kiểm tra | Cùng một câu SQL, cả hai đều sai |
Hóa đơn: vì sao 3,3 lần chứ không phải 4
| Hạng mục | Kimi K3.1 Pro | Claude Fable 5.2 |
|---|---|---|
| Token vào | 27.131 | 36.074 |
| Token ra | 10.896 | 6.386 |
| Hóa đơn bộ 19 câu | $0,163 | $0,544 |
| Mỗi câu | $0,0086 | $0,0286 |
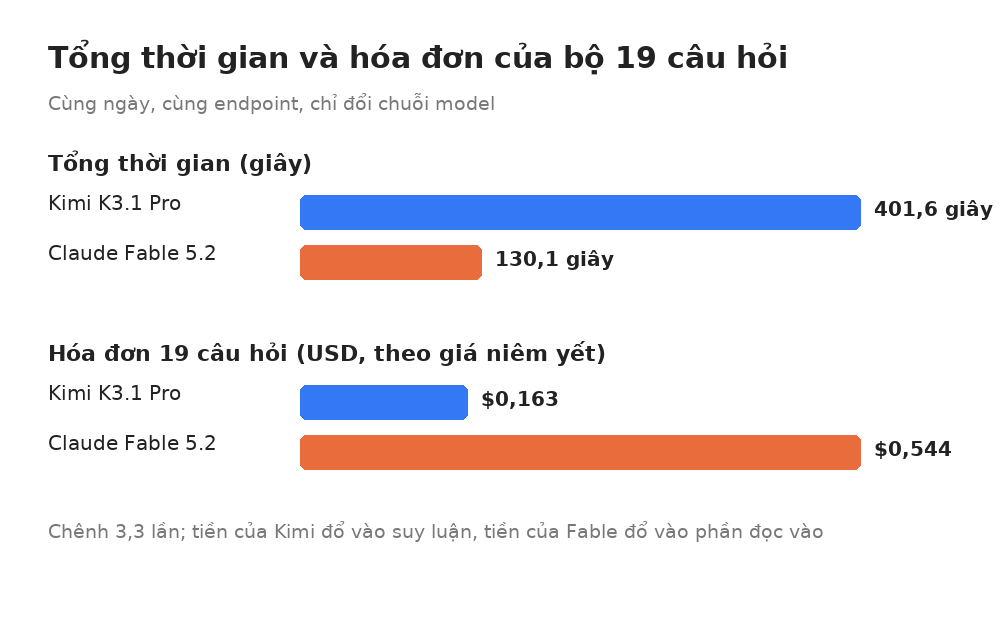
Giá niêm yết chênh bốn lần, nhưng hóa đơn chỉ chênh 3,3 lần, vì lượng token chạy ngược chiều nhau: Fable vào nhiều hơn 33% và đắt gấp bốn ở đầu vào, trong khi đầu ra của nó không có token suy luận nên chỉ đắt hơn khoảng 2,3 lần.
Ba mức tải điển hình theo giá niêm yết: bot chăm sóc khách hàng 100 nghìn lượt (800 vào / 300 ra) khoảng $460 so với $1.840; xử lý 1.000 tài liệu (8k vào / 1,5k ra) khoảng $31 so với $124; trợ lý code cho một lập trình viên mỗi tháng (2M vào / 400k ra) khoảng $8 so với $32.
Một endpoint cho cả hai model
Mình không tạo hai tài khoản. Cả hai model nằm sau một endpoint tương thích OpenAI của Crazyrouter, cùng một khóa, cùng một định dạng request; đổi model chỉ là đổi một trường trong body.
https://api.crazyrouter.com/v1
Danh sách model đang mở và định dạng request nằm trong tài liệu: https://docs.crazyrouter.com/llms.txt
Với cách chạy này, việc so sánh mới có nghĩa: giữ nguyên mọi thứ trừ model, nên chênh lệch đo được mới quy về model chứ không quy về SDK, về khóa, hay về việc bên này bị giới hạn tần suất còn bên kia thì không.
Giới hạn, và cách bạn tự kiểm trong hai mươi phút
19 câu, hai model, một ngày. Vậy là đủ để thấy hướng, không đủ để kết luận. Ba thứ mình chưa đo: ngữ cảnh dài hơn, gọi công cụ nhiều lượt, và giá của Fable 5.2 ngoài mức $8/$40 cùng giá đọc cache $0,20.
Nếu muốn số của chính bạn, ba bước:
- Lấy câu bạn hỏi nhiều nhất, hỏi mười lần, ghi lại trung vị và lần chậm nhất. Con số đó quan trọng hơn mọi bảng xếp hạng.
- Lấy một bài thật sắp đăng, để model viết theo đúng quy định của nền tảng bạn đăng, rồi đếm số chỗ bạn phải sửa. Đây là phép đo sát công việc nhất.
- Đặt
max_tokensở hai mức, mỗi mức chạy ba lần, đếm xem bao nhiêu lầnfinish_reasonlàlength. Chỗ này hay bị bỏ qua nhất, và nó là nguồn của những lần "200 mà rỗng".
Ba bước chưa tới hai mươi phút. Số bạn tự đo sẽ đáng tin hơn bài này.
All Rights Reserved
