

RAG cho tài liệu nội bộ tiếng Việt: chunking và cách đánh giá
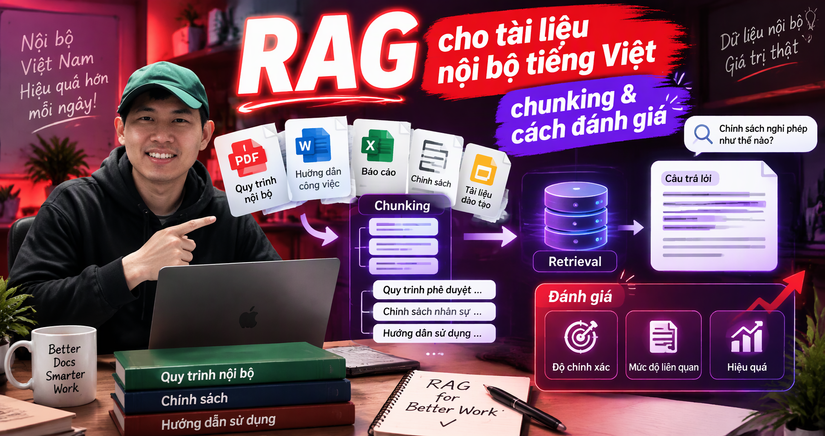
Làm RAG với tài liệu tiếng Anh đã khó, với tài liệu nội bộ tiếng Việt còn khó hơn. Văn bản hay có bảng biểu, đề mục đánh số kiểu "Điều 1, Khoản 2", câu dài và nhiều từ ghép. Nếu cắt đoạn (chunking) sai, mô hình tốt đến đâu cũng trả lời lệch.
Bài này mình chia sẻ cách chunking và một cách đánh giá đơn giản mà mình hay dùng khi làm RAG cho quy trình, quy chế nội bộ.
Vì sao chunking quan trọng hơn bạn nghĩ
Khi người dùng hỏi, hệ thống chỉ lấy vài đoạn liên quan nhất đưa cho mô hình. Nếu đoạn bị cắt giữa chừng, câu trả lời mất ngữ cảnh. Nếu đoạn quá dài, thông tin cần tìm bị lẫn giữa nhiều nội dung khác.
Với văn bản nội bộ tiếng Việt, mình thấy lỗi phổ biến nhất là cắt theo số ký tự cố định. Cách này hay cắt đôi một điều khoản, khiến điều kiện nằm ở đoạn này còn ngoại lệ nằm ở đoạn khác.
Cắt theo cấu trúc văn bản
Cách mình ưu tiên là cắt theo đề mục trước, rồi mới giới hạn độ dài. Đoạn code dưới đây tách văn bản theo các dòng bắt đầu bằng "Điều", "Chương" hoặc số thứ tự, và giữ lại tiêu đề cho mỗi đoạn.
import re

HEADING = re.compile(r"^(Chương\s+\w+|Điều\s+\d+|\d+(\.\d+)*\.)\s", re.MULTILINE)

def split_by_headings(text: str, max_chars: int = 1500) -> list[dict]:
    starts = [m.start() for m in HEADING.finditer(text)] or [0]
    if starts[0] != 0:
        starts.insert(0, 0)
    chunks = []
    for i, start in enumerate(starts):
        end = starts[i + 1] if i + 1 < len(starts) else len(text)
        section = text[start:end].strip()
        if not section:
            continue
        title = section.splitlines()[0][:120]
        # Đoạn quá dài thì chia tiếp theo đoạn văn, nhưng giữ tiêu đề
        while len(section) > max_chars:
            cut = section.rfind("\n\n", 0, max_chars)
            cut = cut if cut > 0 else max_chars
            chunks.append({"title": title, "text": section[:cut].strip()})
            section = title + "\n" + section[cut:].strip()
        chunks.append({"title": title, "text": section})
    return chunks
Điểm quan trọng là mỗi đoạn con vẫn mang tiêu đề gốc. Khi người dùng hỏi về "Điều 5", hệ thống tìm được đúng đoạn dù nội dung đã bị chia nhỏ.
Đánh giá bằng một bộ câu hỏi thật
Đừng đánh giá RAG bằng cảm giác. Mình luôn chuẩn bị 30 đến 50 câu hỏi thật từ nhân viên, kèm đoạn văn bản chứa câu trả lời đúng. Sau đó đo xem bước tìm kiếm có lấy được đúng đoạn đó trong top kết quả hay không.
def hit_rate(questions: list[dict], search, k: int = 3) -> float:
    hits = 0
    for q in questions:
        results = search(q["question"], top_k=k)
        if any(q["expected_title"] in r["title"] for r in results):
            hits += 1
    return hits / len(questions)

# Mỗi phần tử: {"question": "...", "expected_title": "Điều 5"}
Hàm search là bước truy vấn của bạn (vector database, BM25 hoặc kết hợp). Chỉ số này đơn giản nhưng rất hữu ích: nếu hit rate thấp, sửa chunking và tìm kiếm trước, chưa cần đụng đến prompt.
Phần chọn vector database và cách lưu trữ cho RAG mình không đi sâu ở đây. Nếu bạn đang cân nhắc giữa các lựa chọn, có một bài tổng hợp khá đầy đủ về vector database cho RAG.
Vài lưu ý riêng với tiếng Việt
- Chuẩn hóa Unicode. Văn bản copy từ nhiều nguồn có thể lẫn dạng dựng sẵn và tổ hợp. Hãy chuẩn hóa về NFC trước khi cắt và tạo embedding.
- Kết hợp tìm kiếm từ khóa. Mã văn bản, số hiệu, tên phòng ban thường tìm bằng từ khóa tốt hơn bằng embedding.
- Giữ bảng nguyên khối. Bảng bị cắt đôi gần như vô dụng. Nếu bảng quá dài, chuyển từng dòng thành một câu mô tả.
Khi nào cần đánh giá lại
Bộ câu hỏi đánh giá không phải làm một lần là xong. Mình chạy lại mỗi khi có một trong ba thay đổi: tài liệu nguồn được cập nhật lớn, cách cắt đoạn thay đổi, hoặc đổi mô hình embedding. Chỉ cần hit rate giảm vài điểm là đáng để xem lại ngay, vì người dùng thường nhận ra câu trả lời sai trước khi đội kỹ thuật kịp phát hiện.
Thứ tự mình hay làm
Mình đi theo thứ tự: chuẩn hóa văn bản, cắt theo cấu trúc, đo hit rate, rồi mới tối ưu prompt và mô hình. Phần lớn cải thiện đến từ hai bước đầu, chứ không phải từ việc đổi mô hình.
Các bạn đang cắt tài liệu tiếng Việt theo cách nào, và lỗi nào làm bạn mất nhiều thời gian nhất?
Mình là Darius Tran, làm về triển khai AI agent cho doanh nghiệp tại AI Hive.
All rights reserved
