

RAG - Cho AI mang tài liệu vào phòng thi
Hãy tưởng tượng công ty mình vừa làm một con chatbot HR để nhân viên đỡ phải nhắn tin hỏi phòng Nhân sự suốt ngày.
Bạn hỏi chatbot:
“Ngày phép chưa dùng hết có được chuyển sang năm sau không?”
Chatbot trả lời rất nhanh. Được chứ, mỗi nhân viên có thể chuyển tối đa 5 ngày phép sang năm tiếp theo. Câu trả lời rõ ràng, giọng văn tự tin, còn biết dặn bạn liên hệ HR trước ngày 20/12 để được hỗ trợ.
Nghe uy tín phết.
Cơ mà chính sách thật của công ty là ngày phép sẽ hết hạn vào cuối năm. Phòng HR cũng chưa từng đặt ra cái deadline 20/12 nào cả. Không rõ chatbot nhặt hai con số đó từ đâu, nhưng chắc chắn không phải từ nội quy công ty.
Đây là một vấn đề khá quen thuộc khi dùng Large Language Model (LLM) cho các sản phẩm hỏi đáp. Model có thể biết rất nhiều thứ sau quá trình training, nhưng nó không tự nhiên biết bộ chính sách nằm trong Google Drive của công ty mình. Chính sách vừa sửa tuần trước thì lại càng chịu.
Vậy chúng mình cho toàn bộ tài liệu vào prompt là xong nhỉ?
Nếu công ty chỉ có một file vài trang thì được. Nhưng một công ty hoạt động đủ lâu thường có cả đống tài liệu: quy định nghỉ phép, bảo hiểm, lương thưởng, onboarding, mua sắm, công tác phí, biểu mẫu, rồi mỗi tài liệu lại có vài phiên bản. Nhét hết vào một prompt vừa tốn token, vừa chậm, chưa kể model chưa chắc tìm đúng đoạn cần đọc.
Mở bài đủ rồi. Cách làm này có tên là RAG.
RAG là gì?
RAG là viết tắt của Retrieval-Augmented Generation, có thể hiểu nôm na là tìm kiếm thông tin rồi mới tạo ra câu trả lời.
Khái niệm này được giới thiệu trong một nghiên cứu năm 2020 của Patrick Lewis và cộng sự. Trong mô hình của họ, một phần có nhiệm vụ tìm các đoạn thông tin liên quan từ kho dữ liệu bên ngoài, phần còn lại dùng những thông tin đó để tạo câu trả lời. Kết quả thử nghiệm trên các bài toán cần nhiều kiến thức cho thấy RAG tạo ra nội dung cụ thể và có tính factual tốt hơn mô hình chỉ dựa vào kiến thức nằm sẵn trong parameters.
Nguồn: Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks
Mình hay hình dung thế này.
Một LLM thông thường giống như đi thi đóng sách. Nó đọc đề rồi cố nhớ lại những gì đã học để trả lời. Học rộng đến đâu thì vẫn có lúc quên, mà chính sách nội bộ công ty lại chưa từng có trong đề cương ôn tập của nó.
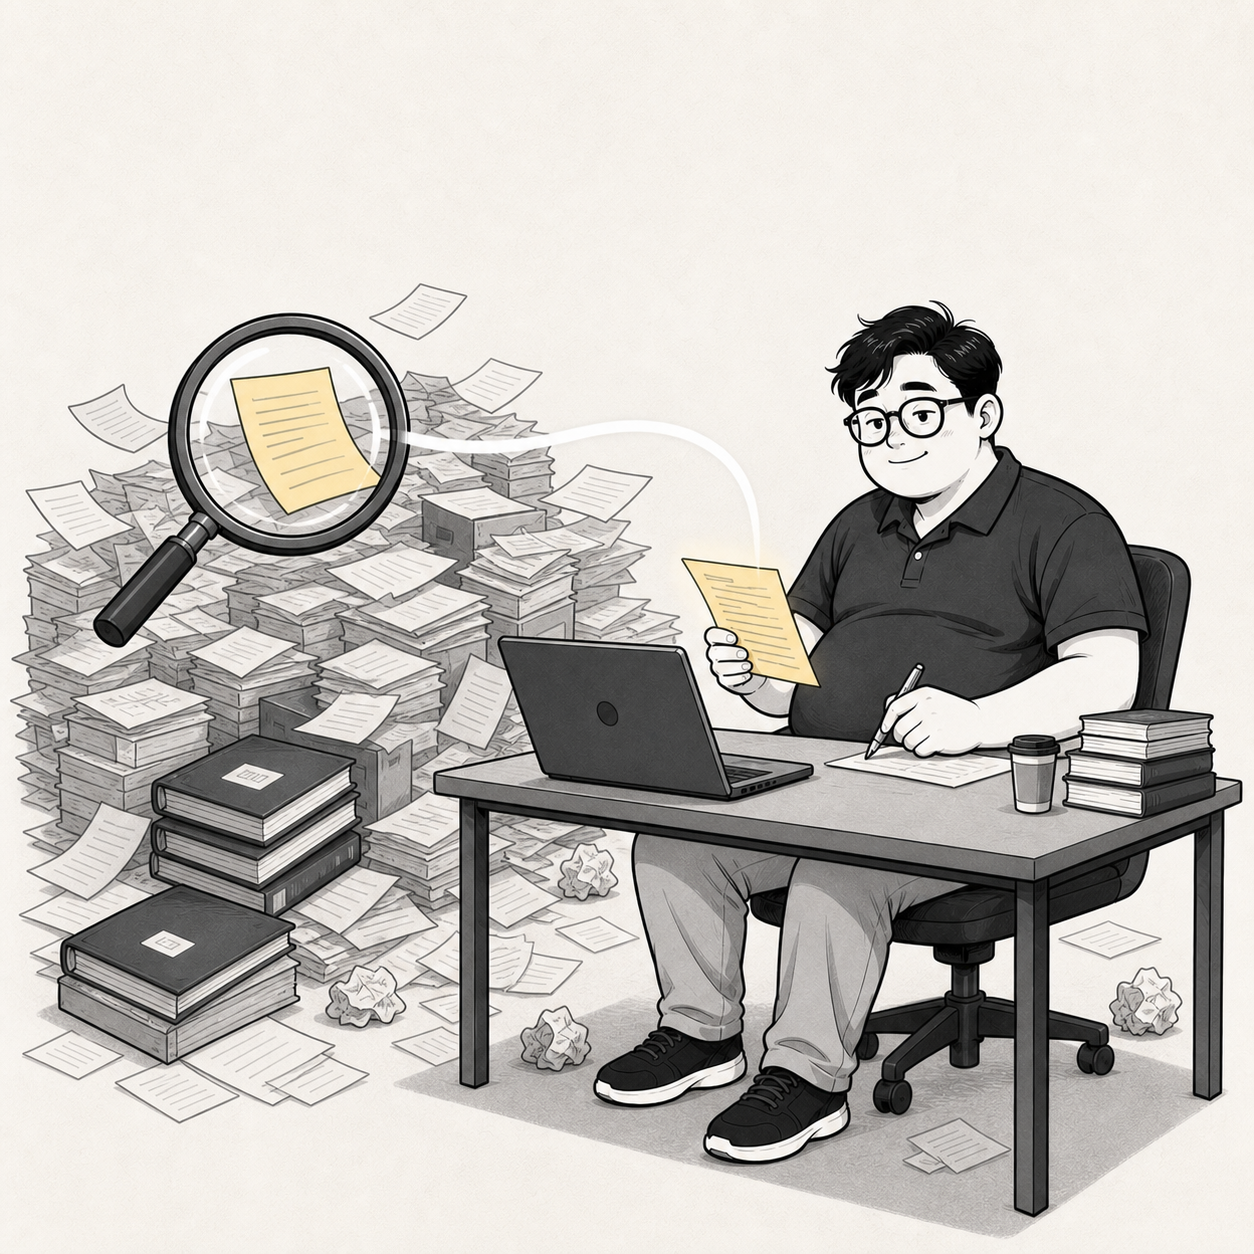
RAG cho model mang tài liệu vào phòng thi. Có điều trước khi trả lời, nó phải tìm được đúng trang để mở.
Quay lại câu hỏi về ngày phép, một hệ thống RAG cơ bản sẽ làm mấy việc sau:
Đầu tiên, các tài liệu HR được chia thành những đoạn nhỏ, hay còn gọi là chunks. Chúng mình không muốn mỗi lần có người hỏi lại bê nguyên cuốn sổ nhân sự vài trăm trang vào prompt.
Sau đó, từng chunk được chuyển thành một dãy số gọi là embedding và lưu vào nơi có thể tìm kiếm. Hiểu đơn giản thì các đoạn có ý nghĩa gần nhau sẽ được đặt gần nhau hơn trong không gian số. Câu “ngày phép có được giữ lại không?” vì thế vẫn có thể tìm ra đoạn ghi “annual leave expires on December 31”, dù hai bên không dùng đúng một bộ từ.
Khi user đặt câu hỏi, hệ thống sẽ tìm vài chunks liên quan nhất, ghép chúng cùng câu hỏi vào prompt rồi gửi cho LLM. LLM đọc chừng đó tài liệu và viết lại thành một câu trả lời dễ hiểu hơn.
Nếu mọi thứ chạy đúng, chatbot HR lúc nãy sẽ lấy được đoạn chính sách mới nhất và trả lời rằng ngày phép hết hạn vào cuối năm. Tốt hơn nữa thì nó dẫn luôn link tới tài liệu gốc để user tự kiểm tra.
Đến đây nghe khá ngon. Có tài liệu rồi thì AI còn bịa kiểu gì được nữa?
Vẫn bịa được.
RAG có hai chỗ để sai
Theo mình, khi làm sản phẩm RAG, dễ hiểu nhất là tách nó thành hai bài toán dính liền với nhau: tìm đúng tài liệu và trả lời đúng theo tài liệu.
Chatbot có thể sai ngay từ bước tìm kiếm. User hỏi về ngày phép, nhưng retriever lại lôi về chính sách công tác phí vì cả hai cùng có những từ như “nhân viên”, “quy định” và “cuối năm”. LLM lúc này có thông minh mấy cũng đang phải làm bài bằng nhầm sách.
Trường hợp khác, retriever đã lấy đúng đoạn rồi nhưng LLM bỏ qua một điều kiện quan trọng, hiểu sai ngoại lệ hoặc trộn thêm kiến thức riêng của nó. Tài liệu có câu “ngày phép hết hạn vào 31/12, ngoại trừ nhân viên đang nghỉ thai sản”, chatbot đọc xong rồi trả lời tất cả mọi người đều mất ngày phép. Vẫn sai như thường.
Đó cũng là lý do việc đánh giá một hệ thống RAG khá lằng nhằng. Nghiên cứu RAGAS chia việc đánh giá thành nhiều phần, trong đó có chất lượng của context được tìm về, mức độ câu trả lời bám vào context và chất lượng của chính câu trả lời. Nếu team chỉ gom tất cả thành một metric “chatbot trả lời đúng bao nhiêu phần trăm”, đến lúc số thấp sẽ không biết nên sửa search hay sửa prompt.
Nguồn: RAGAS: Automated Evaluation of Retrieval Augmented Generation
Còn một giải pháp nghe rất hợp lý là tăng context window rồi nhét thật nhiều tài liệu vào. Đỡ phải chọn, model tự tìm lấy đoạn nó cần.
Tiếc là nhiều chưa chắc đã dễ đọc. Nghiên cứu Lost in the Middle cho thấy hiệu suất của các language models có thể giảm đáng kể khi thông tin cần thiết nằm giữa một context dài; model thường dùng tốt hơn những thông tin nằm ở đầu hoặc cuối. Khả năng của các model mới chắc chắn sẽ còn thay đổi, nhưng hiện tại việc nhét cả kho tài liệu vào prompt vẫn cần được test chứ chưa thể coi là phương án miễn suy nghĩ.
Nguồn: Lost in the Middle: How Language Models Use Long Contexts
PM cần đo cái gì?
Nếu là PM của con chatbot HR ở trên, mình sẽ chưa vội đặt một mục tiêu kiểu “đạt 90% accuracy”. Con số đó trông đẹp, nhưng chưa nói rõ team phải kiểm tra cái gì.
Trước hết cần một bộ câu hỏi thật mà nhân viên hay hỏi. Không cần khổng lồ ngay từ đầu, nhưng nên có câu dễ, câu viết thiếu thông tin, câu dùng từ lóng trong công ty, câu hỏi về ngoại lệ và cả câu mà tài liệu hiện tại chưa có đáp án.
Với mỗi câu, team cần biết tài liệu nào đáng lẽ phải được tìm thấy. Sau khi chạy thử, hãy mở kết quả retrieval ra xem. Đúng tài liệu đã được lấy về chưa? Đúng phiên bản chưa? Đoạn chứa câu trả lời đứng thứ mấy?
Nếu retrieval đã đúng, lúc đó mới nhìn sang câu trả lời: nội dung có bám vào tài liệu không, có bỏ mất điều kiện nào không, nguồn trích dẫn có thực sự chứa câu trả lời không và khi không có đủ thông tin thì chatbot có chịu nói “mình chưa biết” không.
Đo kiểu này hơi mất công hơn việc chấm một điểm cuối cùng. Bù lại, khi chatbot trả lời sai, team biết phải mở phần nào ra sửa.
Ngoài accuracy còn có vài chuyện rất đời thường. Tài liệu mới mất bao lâu mới vào được hệ thống? User có phải chờ quá lâu không? Một nhân viên bình thường có tìm ra được tài liệu chỉ dành cho BOD không?
Cái cuối khá nguy hiểm. RAG tìm được tài liệu tốt đến mấy mà quên kiểm tra quyền truy cập thì con chatbot HR có thể tiện tay kể luôn lương của cả công ty. Lúc đó accuracy chắc cao lắm, nhưng team sản phẩm thì hơi khó sống.
Microsoft cũng tách một hệ thống RAG production thành nhiều công đoạn như chuẩn bị dữ liệu, chunking, indexing, retrieval và evaluation. Việc chọn cách cắt tài liệu ảnh hưởng trực tiếp đến thứ được tìm thấy, nên chunking không chỉ là một việc kỹ thuật làm một lần rồi thôi.
Nguồn: Microsoft - Build advanced retrieval-augmented generation systems
Có nhất thiết phải làm RAG không?
Nếu sản phẩm có vài chục câu FAQ cố định, một hệ thống search bình thường hoặc những câu trả lời được viết sẵn có khi còn dễ làm, dễ kiểm soát và rẻ hơn. Dùng RAG chỉ để chatbot trả lời câu “Văn phòng mở cửa lúc mấy giờ?” thì hơi lấy đại bác bắn muỗi.
RAG phù hợp hơn khi kiến thức nằm trong nhiều tài liệu, thường xuyên thay đổi, user đặt câu hỏi bằng nhiều cách khác nhau và câu trả lời cần đi kèm nguồn để kiểm tra. Những sản phẩm hỗ trợ nhân viên, tra cứu tài liệu kỹ thuật, chăm sóc khách hàng hay tìm kiếm kiến thức nội bộ thường rơi vào nhóm này.
RAG cũng giúp cập nhật kiến thức mà không cần training lại toàn bộ model. Team sửa tài liệu, đưa phiên bản mới vào index rồi để hệ thống tìm từ đó. Cơ mà việc xóa bản cũ, đồng bộ quyền và biết tài liệu nào đang có hiệu lực vẫn là việc của team. RAG không tự dọn kho tài liệu hộ mình.
Lời nhắn
Quay lại con chatbot HR ở đầu bài, câu trả lời tốt chưa chắc phải là một đoạn văn dài và tự tin.
Nếu tìm thấy đúng chính sách, nó nên trả lời ngắn gọn và dẫn nguồn. Nếu hai tài liệu đang mâu thuẫn, nó nên nói rõ là đang có mâu thuẫn. Nếu không tìm thấy gì, câu “Mình chưa có đủ thông tin, bạn hỏi HR giúp nhé” còn có ích hơn việc bịa ra 5 ngày phép và một cái deadline 20/12.
Cho AI mang tài liệu vào phòng thi giúp nó làm bài tốt hơn. Nhưng ít nhất cũng phải kiểm tra xem nó đã mang đúng sách chưa đã.
Bài gốc trên Substack: https://henrypham.substack.com/p/rag-cho-ai-mang-tai-lieu-vao-phong
All rights reserved
