

Phát hiện bất thường trong dữ liệu chuỗi thời gian telemetry
Ở bài viết trước, chúng ta đã dùng K-Medoids và khoảng cách Gower để phân khúc khách hàng trên dữ liệu hỗn hợp. Trong bài viết này, chúng ta áp dụng K-Medoids cho bài toán phát hiện bất thường không giám sát trên chuỗi thời gian telemetry (dữ liệu đo lường từ cảm biến IoT, dây chuyền sản xuất hoặc máy chủ).
Trong các hệ thống giám sát công nghiệp, dữ liệu cảm biến thường được ghi nhận liên tục theo từng chu kỳ ngắn. Phần lớn thời gian thiết bị vận hành bình thường và dữ liệu thu thập được không có sẵn nhãn sự cố (unlabeled). Khi xảy ra trục trặc, thiết bị thường xuất hiện hiện tượng trôi dạt dần về nhiệt độ, áp suất hoặc độ rung trước khi ngừng hoạt động. Để phát hiện sớm các dấu hiệu này mà không cần dữ liệu gán nhãn từ trước, một hướng tiếp cận phổ biến là mô hình hóa các trạng thái vận hành chuẩn (Normal Operating Profiles) bằng phân cụm, sau đó dùng khoảng cách từ mỗi quan sát mới tới cụm chuẩn gần nhất để tính điểm bất thường (Anomaly Score).
Với bài toán này, K-Means bộc lộ hai hạn chế rõ rệt trên chuỗi thời gian: hiện tượng ô nhiễm tâm cụm (centroid contamination) do các đợt sự cố kéo lệch vị trí trung bình, và sự triệt tiêu dạng sóng khi lấy trung bình cộng các chu kỳ dao động lệch pha. K-Medoids (FastCLARANS) khắc phục các vấn đề này bằng cách chọn trực tiếp các quan sát thực tế làm tâm cụm và tối thiểu hóa khoảng cách bậc một.
1. Hạn chế của K-Means trên chuỗi thời gian telemetry
1.1. Ô nhiễm tâm cụm khi xuất hiện sự cố kéo dài
Khác với các phép kiểm tra ngưỡng cố định (chẳng hạn nhiệt độ vượt 120°C là ngắt máy), bất thường trong telemetry phần lớn mang tính ngữ cảnh (contextual anomaly). Mức nhiệt 85°C vào ban ngày khi máy chạy hết công suất là bình thường, nhưng chính mức nhiệt đó xuất hiện vào nửa đêm khi thiết bị ở chế độ nghỉ lại là dấu hiệu quạt tản nhiệt gặp trục trặc.
Khi phân cụm không giám sát trên chuỗi dữ liệu lịch sử chứa cả giai đoạn bình thường lẫn sự cố, K-Means tính tọa độ tâm cụm bằng trung bình số học:
Vì hàm mục tiêu của K-Means sử dụng bình phương khoảng cách Euclid (), mức phạt cho các điểm xa tâm tăng theo bậc hai. Khi thiết bị gặp sự cố quá nhiệt kéo dài nhiều giờ, các điểm dữ liệu nhiệt độ cao đóng góp một lượng sai số lớn vào hàm mục tiêu. Để giảm tổng bình phương sai số, K-Means buộc phải dịch chuyển tâm cụm về phía các điểm lỗi đó.
Hiện tượng này gọi là ô nhiễm tâm cụm (centroid contamination). Khi tâm bị kéo lệch về phía bất thường, khoảng cách từ các điểm sự cố tiếp theo tới tâm cụm bị thu hẹp. Điểm bất thường bị hạ thấp, khiến hệ thống xem trạng thái quá nhiệt đó như một chế độ vận hành bình thường và bỏ sót cảnh báo.
1.2. Hiện tượng triệt tiêu pha dao động khi lấy trung bình
Dữ liệu telemetry thường có tính chu kỳ theo ca làm việc hoặc chu kỳ tải. Hai chuỗi đo lường có cùng biên độ dao động nhưng lệch nhau một khoảng thời gian (lệch pha), khi lấy trung bình cộng tọa độ, sẽ triệt tiêu các đỉnh và đáy của nhau.
Tọa độ centroid do K-Means tạo ra trong trường hợp này thường bị làm phẳng hoặc trở thành một vector trung gian không phản ánh chu kỳ dao động thực tế nào.
K-Medoids giải quyết vấn đề này bằng cách chọn chính một quan sát có thật trong tập dữ liệu làm tâm đại diện (medoid):
Nhờ tối thiểu hóa trực tiếp tổng khoảng cách bậc một (), medoid giữ vai trò một trung vị không gian (spatial median). Dù dữ liệu xuất hiện các điểm nhiệt độ tăng vọt, medoid vẫn định vị tại vùng dữ liệu bình thường có mật độ cao. Mỗi medoid tìm được tương ứng với một mốc thời gian cụ thể trong lịch sử đo đạc, đại diện cho một hình thái vận hành thực tế của thiết bị để đối chiếu trực tiếp.
1.3. Khoảng cách đàn hồi DTW và bài toán tính toán trong telemetry
Trong phân tích chuỗi thời gian, độ đo Dynamic Time Warping (DTW) giải quyết hiện tượng lệch pha và co giãn thời gian (temporal warping). Các độ đo cố định từng bước (lockstep metrics như Euclid hoặc Manhattan) so sánh điểm thứ của chuỗi này với đúng điểm thứ của chuỗi kia. Nếu chu kỳ khởi động thiết bị hôm nay kéo dài 45 phút còn hôm sau mất 60 phút do nhiệt độ môi trường thấp, khoảng cách lockstep sẽ tăng cao và báo động nhầm dù hình thái biến thiên nhiệt độ bình thường. DTW uốn cong trục thời gian phi tuyến để so khớp các đỉnh và thung lũng tương ứng, loại bỏ ảnh hưởng của tốc độ biến thiên.
Tuy nhiên, việc đưa DTW vào K-Means gặp trở ngại khi cập nhật tâm cụm. Sau mỗi lượt gán, K-Means cần tính lại tọa độ trung bình. Dưới độ đo DTW, chuỗi trung bình không có nghiệm giải tích dạng trung bình cộng thông thường mà cần giải bằng các thuật toán xấp xỉ lặp như DTW Barycenter Averaging (DBA), làm tăng chi phí tính toán và dễ rơi vào cực tiểu cục bộ.
K-Medoids tương thích trực tiếp với DTW vì thuật toán chỉ cần ma trận khoảng cách giữa các chuỗi con mà không cần tính chuỗi trung bình. Tâm cụm luôn là một đoạn chuỗi đo có thật trong lịch sử.
Trong triển khai giám sát công nghiệp, việc lựa chọn giữa DTW và trích xuất đặc trưng trượt phụ thuộc vào yêu cầu hệ thống:
- Phương pháp chuỗi con kết hợp DTW (Subsequence + DTW): Phù hợp khi hình thái dạng sóng quyết định bất thường và chu kỳ có độ co giãn thời gian không đều. Tuy vậy, độ phức tạp tính toán cho mỗi cặp chuỗi độ dài làm tăng đáng kể chi phí xử lý khi dữ liệu lớn.
- Phương pháp đặc trưng thống kê trượt (Feature Engineering + Manhattan): Chuyển chuỗi thời gian thành vector thống kê động học (tốc độ biến thiên, giá trị trung bình trượt, độ biến động trượt). Phương pháp này đạt độ phức tạp cho mỗi điểm đo mới, phù hợp với các hệ thống giám sát trực tuyến (real-time streaming).
Trong bài viết này, chúng ta xây dựng giải pháp dựa trên không gian đặc trưng động học kết hợp khoảng cách Manhattan để đảm bảo tốc độ phản hồi tức thời, đồng thời so sánh mở rộng với DTW trên các chuỗi con mẫu.
2. Quy trình chấm điểm bất thường không giám sát
Quy trình phát hiện bất thường với K-Medoids gồm bốn bước: trích xuất đặc trưng cửa sổ trượt, chuẩn hóa thang đo, phân cụm xác định hồ sơ chuẩn và tính điểm khoảng cách.
2.1. Trích xuất đặc trưng cửa sổ trượt (Rolling Features)
Nếu chỉ dùng giá trị nhiệt độ tức thời , mô hình không thể phân biệt một xung nhiễu ngắn hạn với một xu hướng tăng nhiệt kéo dài. Chúng ta chuyển đổi chuỗi đo thời gian thành vector đặc trưng đa chiều qua các thống kê trượt:
- Tốc độ biến thiên tức thời (sai phân bậc một):
Đặc trưng này nhận diện các biến động nhiệt độ đột ngột giữa hai lần lấy mẫu liên tiếp.
- Xu hướng ngắn hạn qua cửa sổ trượt 1 giờ ( bước lấy mẫu với chu kỳ 5 phút):
Giá trị trung bình và độ lệch chuẩn ngắn hạn phản ánh mức tải và độ ổn định nhiệt tức thời.
- Xu hướng trung hạn qua cửa sổ trượt 6 giờ ( bước lấy mẫu):
Cửa sổ rộng hơn giúp nhận diện sự trôi dạt đường cơ sở (baseline drift), tức hiện tượng nhiệt độ nền tăng dần theo thời gian dù tốc độ tăng từng phút không lớn.
2.2. Chuẩn hóa bằng RobustScaler
Các phương pháp chuẩn hóa dựa trên trung bình và độ lệch chuẩn như StandardScaler dễ bị sai lệch khi gặp các giá trị cực trị trong đợt máy hỏng. Khi nhiệt độ tăng vọt, độ lệch chuẩn bị kéo dãn, làm nén các dao động bình thường lại gần nhau.
Chúng ta sử dụng RobustScaler, dựa trên trung vị và khoảng tứ phân vị ():
Cách tính này cân bằng thang đo giữa các đặc trưng mà không làm biến dạng phân phối do các giá trị ngoại lai.
Đoạn mã dưới đây trích xuất đặc trưng động học và chuẩn hóa dữ liệu:
import numpy as np
import pandas as pd
from sklearn.preprocessing import RobustScaler

# 1. Sai phân bậc một phát hiện cú nhảy nhiệt độ tức thời
df['diff_1'] = df['value'].diff().fillna(0)

# 2. Thống kê trượt ngắn hạn 1 giờ (12 bước, mỗi bước 5 phút)
df['rolling_mean_12'] = df['value'].rolling(window=12, min_periods=1).mean()
df['rolling_std_12'] = df['value'].rolling(window=12, min_periods=1).std().fillna(0)

# 3. Thống kê trượt trung hạn 6 giờ (72 bước)
df['rolling_mean_72'] = df['value'].rolling(window=72, min_periods=1).mean()
df['rolling_std_72'] = df['value'].rolling(window=72, min_periods=1).std().fillna(0)

# 4. Chuẩn hóa không gian đặc trưng bằng RobustScaler
feature_cols = ['value', 'diff_1', 'rolling_mean_12', 'rolling_std_12', 'rolling_mean_72', 'rolling_std_72']
scaler = RobustScaler()
X_scaled = scaler.fit_transform(df[feature_cols].values)
2.3. Khoảng cách Manhattan và điểm bất thường không giám sát
Trên không gian đặc trưng đa chiều, khoảng cách Manhattan () cộng dồn độ lệch tuyệt đối trên từng chiều:
So với khoảng cách Euclid, chuẩn Manhattan không bình phương sai số, tránh trường hợp một đặc trưng biến động lớn chi phối toàn bộ khoảng cách.
Sau khi FastCLARANS xác định medoid đại diện cho các chế độ vận hành , điểm bất thường thô của một quan sát là khoảng cách từ điểm đó tới medoid gần nhất:
Quan sát nào tương đồng với một trong các chế độ vận hành chuẩn đã học sẽ có điểm thấp. Khi thiết bị vận hành bất thường, vector đặc trưng lệch khỏi các medoid chuẩn, khiến điểm số tăng cao.
Đoạn mã khởi tạo FastCLARANS, tìm medoid và tính điểm khoảng cách:
from clarans import FastCLARANS

# Huấn luyện mô hình hồ sơ vận hành chuẩn với khoảng cách Manhattan (k=5)
clf_fc = FastCLARANS(n_clusters=5, metric='manhattan', random_state=42)
clf_fc.fit(X_scaled)

# Tọa độ không gian chuẩn hóa của 5 medoid
medoid_vectors = X_scaled[clf_fc.medoid_indices_]

# Tính khoảng cách Manhattan tới medoid gần nhất cho từng quan sát
dists_medoid = np.min(np.abs(X_scaled[:, None, :] - medoid_vectors[None, :, :]).sum(axis=2), axis=1)
df['score_raw'] = dists_medoid
2.4. Lọc nhiễu điểm số và thiết lập ngưỡng cảnh báo
Trong vận hành thực tế, cảm biến thỉnh thoảng ghi nhận các xung nhiễu ngẫu nhiên kéo dài vài phút. Nếu kích hoạt cảnh báo ngay khi một điểm đơn lẻ vượt ngưỡng, hệ thống sẽ gặp nhiều báo động giả (False Alarm).
Để tập trung vào các bất thường kéo dài, chúng ta làm mượt chuỗi điểm số bằng trung bình trượt 1 giờ:
Hệ thống phát tín hiệu cảnh báo khi điểm số làm mượt vượt ngưỡng :
Ngưỡng có thể xác định theo phân vị thống kê ( hoặc trên chuỗi điểm số lịch sử), hoặc dựa trên độ lệch tuyệt đối trung vị (Median Absolute Deviation, MAD):
trong đó .
Đoạn mã dưới đây làm mượt điểm số và thiết lập cảnh báo theo ngưỡng MAD:
# Làm mượt chuỗi điểm số bằng trung bình trượt 1 giờ (12 bước)
df['score_smooth'] = pd.Series(dists_medoid).rolling(window=12, min_periods=1).mean().values

# Tính ngưỡng cảnh báo động bằng MAD
med_val = np.median(df['score_smooth'])
mad_val = np.median(np.abs(df['score_smooth'] - med_val))
tau_mad = med_val + 3.0 * (1.4826 * mad_val)

# Kích hoạt cảnh báo nhị phân
df['is_alert'] = (df['score_smooth'] >= tau_mad).astype(int)
print(f"Ngưỡng cảnh báo Median + 3*MAD: {tau_mad:.2f}")
3. Thiết kế thực nghiệm trên bộ dữ liệu Numenta NAB
Chúng ta kiểm chứng phương pháp trên tập dữ liệu cảm biến công nghiệp machine_temperature_system_failure.csv thuộc bộ chuẩn Numenta Anomaly Benchmark (NAB).
3.1. Dữ liệu cảm biến và các khoảng thời gian sự cố
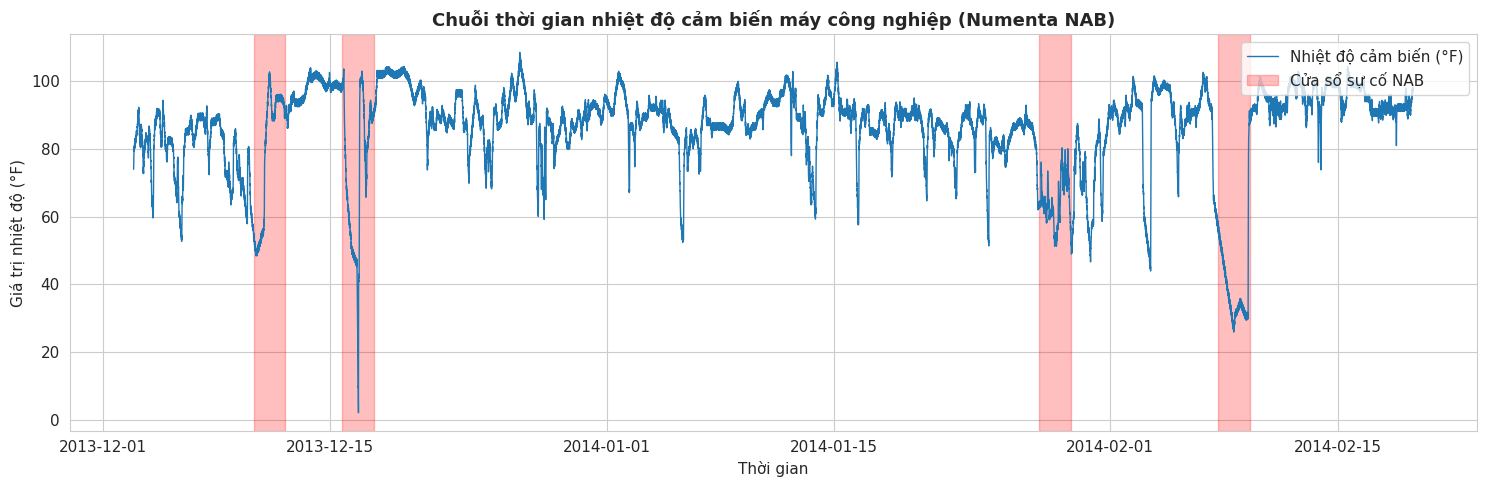
Tập dữ liệu ghi lại nhiệt độ của một máy công nghiệp với chu kỳ lấy mẫu 5 phút một lần, từ tháng 12/2013 đến tháng 02/2014, gồm 22,695 điểm đo. NAB cung cấp 4 khoảng thời gian sự cố hệ thống đã được ghi nhận:
- Cửa sổ 1: Từ 10/12/2013 06:25 đến 12/12/2013 05:35.
- Cửa sổ 2: Từ 15/12/2013 17:50 đến 17/12/2013 17:00.
- Cửa sổ 3: Từ 27/01/2014 14:20 đến 29/01/2014 13:30.
- Cửa sổ 4: Từ 07/02/2014 14:55 đến 09/02/2014 14:05 (đợt máy hỏng hoàn toàn).
Tổng cộng có 2,268 điểm đo nằm trong các cửa sổ sự cố, chiếm 9.99% tổng số bản ghi. Đây là tỷ lệ mất cân bằng mẫu điển hình trong các bài toán phát hiện bất thường thực tế.
3.2. Sổ tay thực hành qua Jupyter Notebook
Toàn bộ các bước tiền xử lý, huấn luyện FastCLARANS đối chiếu K-Means, tính điểm bất thường, vẽ đồ thị và phân tích DTW được lưu trữ trong sổ tay bai_5_anomaly_detection_telemetry.ipynb.
Biểu đồ dưới đây thể hiện toàn bộ chuỗi nhiệt độ cùng 4 cửa sổ sự cố do NAB đánh dấu:
4. Phân tích kết quả thực nghiệm và đối chiếu mô hình
Thực nghiệm được thực hiện trên môi trường Python 3.13 với thư viện scikit-clarans phiên bản 0.3.4. Dưới đây là phân tích kết quả thu được.
4.1. Hồ sơ 5 trạng thái vận hành chuẩn (Medoids)
Khi thiết lập , FastCLARANS hội tụ tại 5 quan sát cụ thể trong lịch sử đo đạc:
| Cluster | Mốc thời gian (Timestamp) | Nhiệt độ (°F) | Tốc độ biến thiên (diff_1) |
Trung bình 1h (mean_12) |
Độ lệch chuẩn 1h (std_12) |
Trạng thái vật lý |
|---|---|---|---|---|---|---|
| 0 | 2013-12-05 00:15:00 | 81.80 | -0.056 | 81.98 | 0.94 | Tải ổn định mức vừa, nhiệt độ dao động hẹp |
| 1 | 2014-01-20 14:05:00 | 72.63 | +0.299 | 74.58 | 2.69 | Giai đoạn tăng nhiệt, tải thay đổi (std cao) |
| 2 | 2014-01-28 17:20:00 | 54.11 | -0.070 | 52.62 | 0.89 | Chế độ nghỉ dài hoặc môi trường nhiệt độ thấp |
| 3 | 2014-02-04 06:50:00 | 99.73 | -0.064 | 99.06 | 0.76 | Chế độ tải đỉnh (Peak Load), nhiệt độ cao ổn định |
| 4 | 2014-02-06 01:25:00 | 90.85 | +0.264 | 90.82 | 0.74 | Chế độ tải nặng liên tục trong ca đêm |
Năm medoid này bao quát các dải nhiệt độ vận hành thông thường của máy, từ mức nghỉ 54°F đến mức tải đỉnh 99.7°F, và không medoid nào rơi vào các đợt sự cố quá nhiệt cực đoan (khi nhiệt độ vượt 105°F hoặc tụt về 0°F). Do tối thiểu hóa khoảng cách bậc một (), các điểm dữ liệu sự cố không kéo lệch medoid ra khỏi vùng mật độ tập trung của trạng thái bình thường.
4.2. So sánh định lượng FastCLARANS và K-Means
Bảng dưới đây đối chiếu khả năng phân tách sự cố giữa FastCLARANS (khoảng cách Manhattan) và K-Means (khoảng cách Euclid) trên cùng tập đặc trưng chuẩn hóa:
| Mô hình | ROC-AUC (Điểm thô) | ROC-AUC (Điểm mượt 1h) | PR-AUC (Điểm mượt 1h) | Đặc trưng thuật toán |
|---|---|---|---|---|
| FastCLARANS (Manhattan, k=5) | 0.7701 | 0.7819 | 0.3122 | Medoid thực tế, hàm mục tiêu L1 kháng ngoại lai |
| K-Means (Euclid, k=5) | 0.6841 | 0.6948 | 0.2570 | Centroid trung bình, bị kéo lệch bởi sai số L2^2 |
Từ số liệu định lượng, có hai điểm đáng chú ý:
- FastCLARANS đạt ROC-AUC 0.7819, cao hơn 8.71% so với K-Means (0.6948), và PR-AUC đạt 0.3122, cao hơn 5.52% so với K-Means (0.2570). Do K-Means cập nhật tâm bằng trung bình cộng bình phương sai số, các đợt máy nóng kéo dài đã kéo lệch centroid về phía vùng sự cố. Khoảng cách từ các điểm lỗi tới centroid bị thu hẹp lại, làm giảm độ nhạy phát hiện. FastCLARANS giữ medoid tại các vùng vận hành bình thường, nên khi xảy ra sự cố, khoảng cách tới medoid lập tức tăng mạnh.
- Bước làm mượt điểm số bằng trung bình trượt 1 giờ cải thiện ROC-AUC của FastCLARANS từ 0.7701 lên 0.7819. Bộ lọc này triệt tiêu các xung nhiễu ngắn hạn từ cảm biến mà không làm trễ các bất thường mang tính xu hướng.
Đồ thị dưới đây so sánh đường cong ROC và đường cong Precision-Recall giữa hai mô hình:
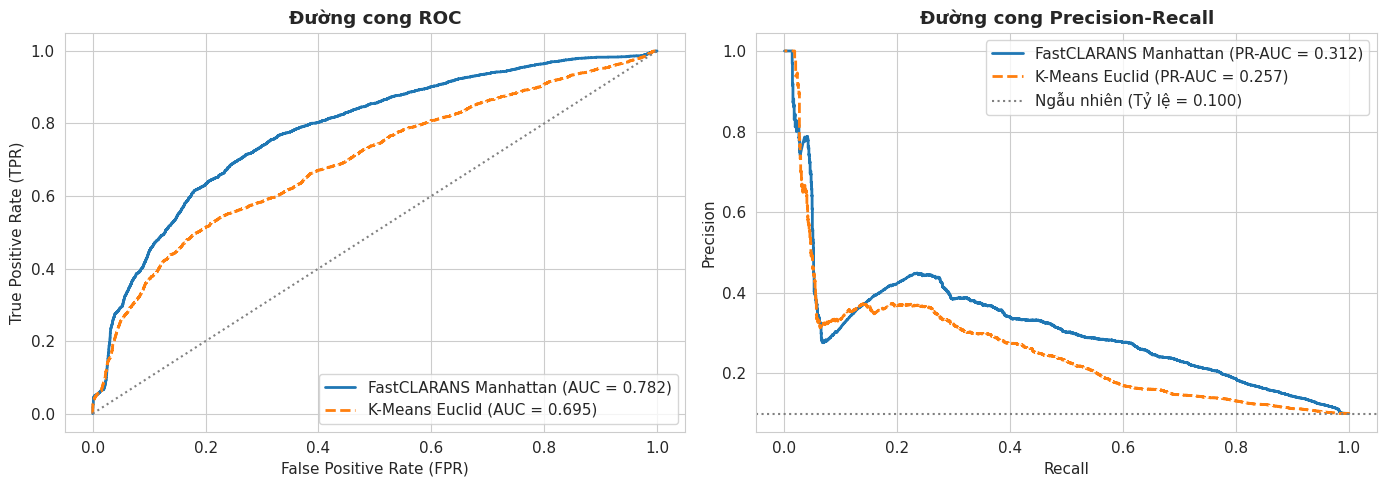
Trên cả hai đồ thị, đường cong của FastCLARANS (màu xanh) nằm phía trên đường cong của K-Means (nét đứt màu cam). Ở các mức Recall từ 0.2 đến 0.6 trên đồ thị Precision-Recall, FastCLARANS duy trì Precision cao hơn K-Means từ 8% đến 12%.
4.3. Đánh giá độ nhạy theo các ngưỡng cảnh báo
Trong vận hành, hệ thống cần một ngưỡng để kích hoạt cảnh báo tự động. Bảng dưới đây đối chiếu Precision, Recall và F1-Score tại các ngưỡng khác nhau:
| Phương pháp | Ngưỡng cảnh báo | Giá trị ngưỡng | Precision | Recall | F1-Score |
|---|---|---|---|---|---|
| FastCLARANS | Phân vị 90% () | 5.45 | 0.3670 | 0.3673 | 0.3671 |
| FastCLARANS | Phân vị 95% () | 7.48 | 0.4414 | 0.2209 | 0.2944 |
| FastCLARANS | Phân vị 98% () | 9.66 | 0.3216 | 0.0644 | 0.1073 |
| FastCLARANS | Phân vị 99% () | 13.74 | 0.5110 | 0.0511 | 0.0930 |
| FastCLARANS | Median + 3*MAD | 5.30 | 0.3569 | 0.3832 | 0.3696 |
| K-Means | Phân vị 95% () | 3.47 | 0.3665 | 0.1834 | 0.2445 |
Từ bảng kết quả:
- Ngưỡng độ lệch tuyệt đối trung vị (Median + 3*MAD = 5.30) cho F1-Score cao nhất (0.3696), cân bằng giữa Precision (35.69%) và Recall (38.32%). Do không giả định phân phối chuẩn, ngưỡng MAD thích ứng tốt với phân phối lệch phải của chuỗi khoảng cách.
- Nếu ưu tiên giảm cảnh báo giả gửi đến ca trực, ngưỡng (7.48) nâng Precision lên 44.14%.
- Cùng tại ngưỡng phân vị , FastCLARANS đạt Precision 44.14% và F1-Score 0.2944, so với K-Means đạt Precision 36.65% và F1-Score 0.2445.
Biểu đồ dưới đây đối chiếu chuỗi nhiệt độ với đường điểm bất thường theo thời gian:
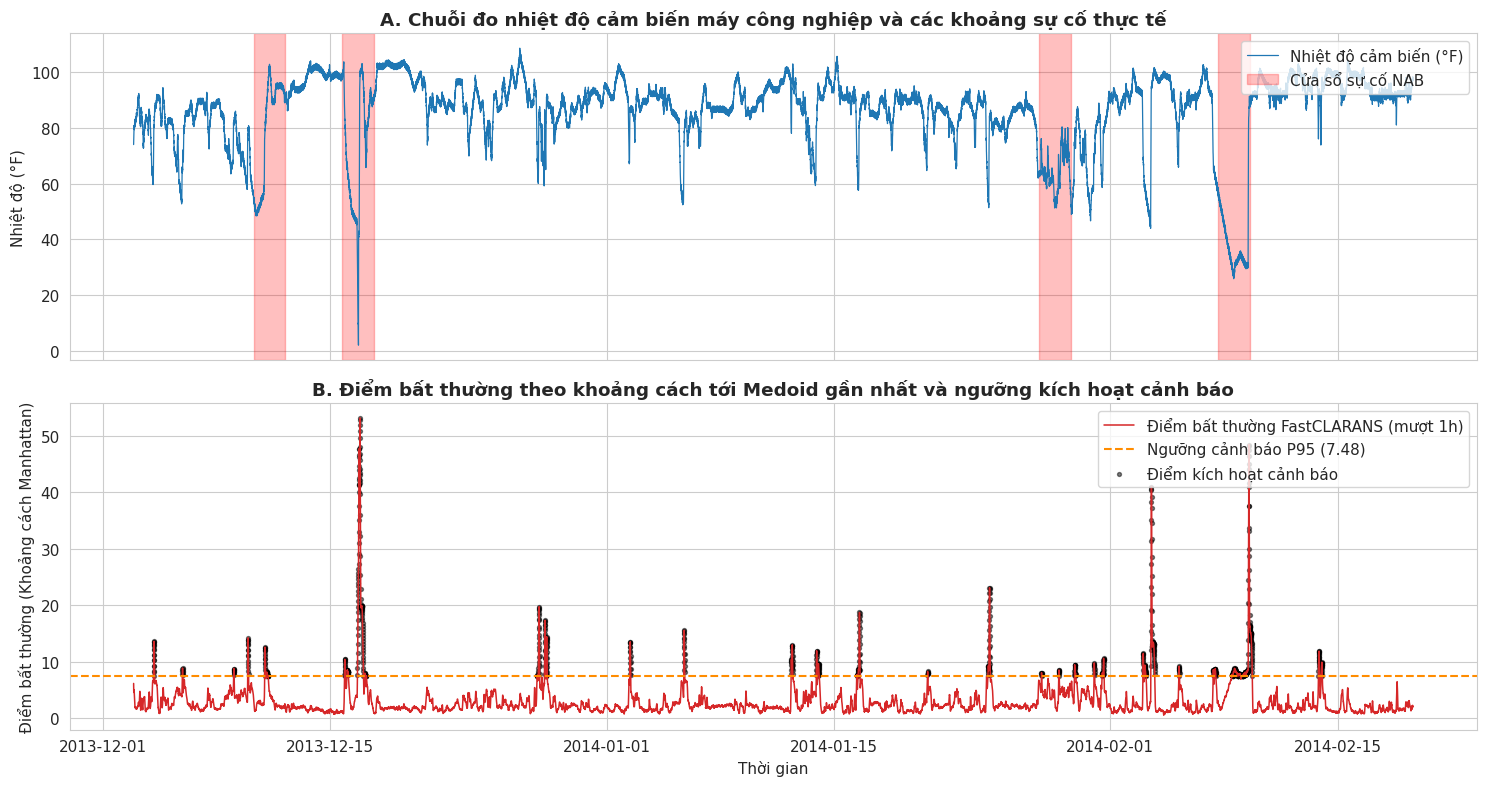
Các điểm đánh dấu cảnh báo tại ngưỡng (màu đen) tập trung vào 4 khoảng thời gian sự cố (vùng màu đỏ), trong khi các giai đoạn bình thường hầu như không ghi nhận điểm cảnh báo nào.
4.4. Diễn biến cảnh báo sớm trong sự cố tháng 02/2014
Đợt sự cố thứ tư (từ ngày 07/02/2014 đến 09/02/2014) là sự cố nặng nhất trong tập dữ liệu: máy bị quá nhiệt kéo dài và ngắt hoạt động hoàn toàn. Biểu đồ phóng to dưới đây ghi lại chi tiết diễn biến:
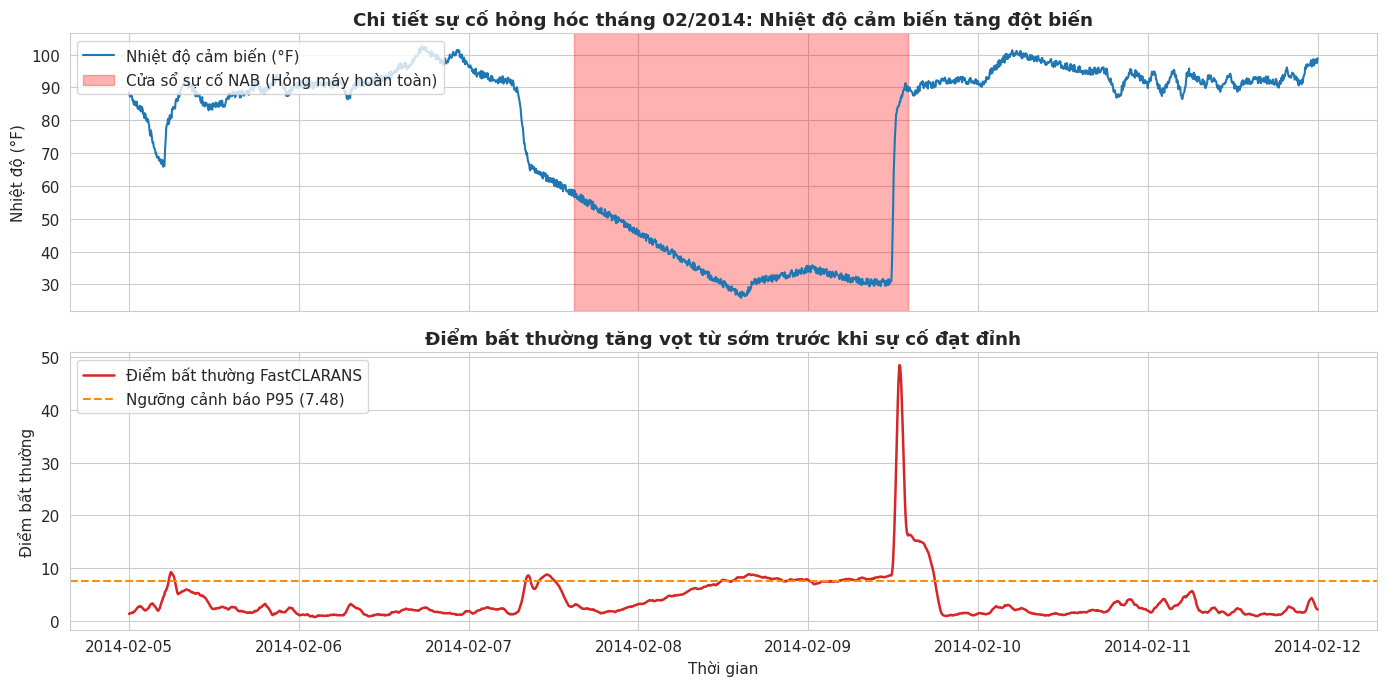
Diễn biến trên đồ thị thể hiện:
- Đỉnh điểm sự cố xảy ra vào trưa ngày 08/02/2014 khi nhiệt độ vượt 105°F rồi tụt về 0 do hệ thống bị ngắt cưỡng bức.
- Đường điểm bất thường của FastCLARANS (đồ thị phía dưới) bắt đầu tăng từ ngày 06/02 và vượt ngưỡng cảnh báo (đường nét đứt cam) vào đầu ngày 07/02/2014, sớm hơn thời điểm máy hỏng hơn 24 giờ.
- Mô hình phát hiện sớm nhờ các đặc trưng trượt trung hạn (
rolling_mean_72vàrolling_std_12) phản ánh sự trôi dạt đường cơ sở của nhiệt độ nền. Dù giá trị nhiệt độ tức thời chưa chạm ngưỡng quá nhiệt vật lý, vector trạng thái đã lệch khỏi tất cả các medoid vận hành bình thường.
5. Phân tích mở rộng: Phân cụm chuỗi con với Dynamic Time Warping (DTW)
Để kiểm chứng vai trò của độ đo đàn hồi trong phân tích hình thái sóng, chúng ta trích xuất 227 chuỗi con (mỗi chuỗi dài 24 bước, tương đương 2 giờ vận hành) và phân cụm bằng DTW kết hợp FastCLARANS(metric='precomputed').
5.1. Cơ chế uốn trục thời gian của DTW
Khi so sánh hai chuỗi dao động có cùng hình thái sóng nhưng chuỗi thứ hai bị trễ 4 bước thời gian:
- Khoảng cách Euclid lockstep cho kết quả 8.536 do phạt sai số giữa từng cặp điểm tại cùng thời điểm .
- Khoảng cách DTW với dải ràng buộc Sakoe-Chiba uốn trục thời gian để ghép các đỉnh tương ứng, phản ánh đúng độ tương đồng về hình dạng sóng.
5.2. Các Medoid hình thái sóng chuẩn trích xuất từ ma trận DTW
Khi chạy FastCLARANS trên ma trận khoảng cách DTW tính trước () với , thuật toán xác định 3 chuỗi con thực tế làm tâm hình thái:
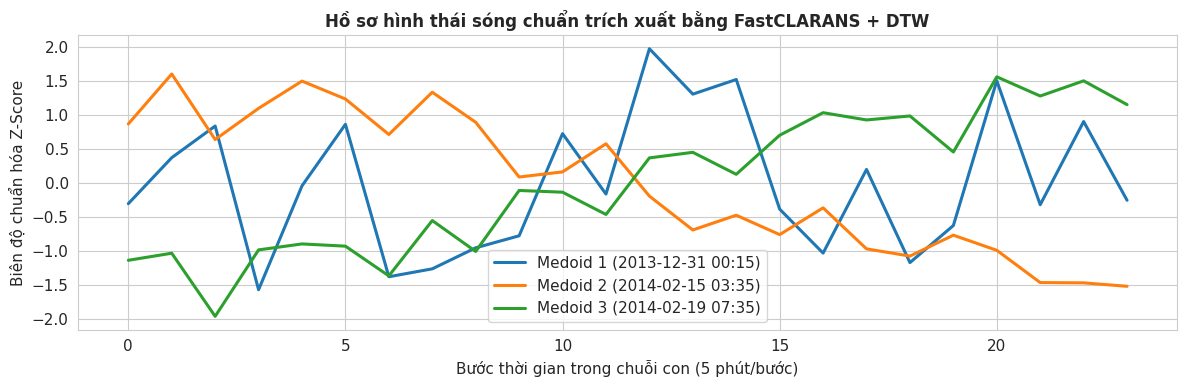
Ba medoid chuỗi con đại diện cho ba hình thái biến động tiêu biểu:
- Medoid 1 (bắt đầu lúc 2013-12-31 00:15): Dao động nhỏ ổn định quanh đường trung bình trong ca đêm.
- Medoid 2 (bắt đầu lúc 2014-02-15 03:35): Dốc tăng nhiệt nhanh khi máy chuyển từ trạng thái nghỉ sang tải nặng.
- Medoid 3 (bắt đầu lúc 2014-02-19 07:35): Hạ nhiệt và hồi phục đều đặn sau ca làm việc.
Đoạn mã dưới đây tính khoảng cách DTW và gọi FastCLARANS trên ma trận tính trước:
# 1. Cài đặt giải thuật Fast DTW với dải ràng buộc Sakoe-Chiba
def fast_dtw_distance(s1, s2, w=4):
    n, m = len(s1), len(s2)
    dtw = np.full((n + 1, m + 1), np.inf)
    dtw[0, 0] = 0.0
    for i in range(1, n + 1):
        for j in range(max(1, i - w), min(m + 1, i + w + 1)):
            cost = abs(s1[i - 1] - s2[j - 1])
            dtw[i, j] = cost + min(dtw[i - 1, j], dtw[i, j - 1], dtw[i - 1, j - 1])
    return dtw[n, m]

# 2. Phân cụm ma trận khoảng cách DTW tính trước bằng FastCLARANS
clf_dtw = FastCLARANS(n_clusters=3, metric='precomputed', random_state=42)
clf_dtw.fit(dtw_matrix)

# Trích xuất 3 chuỗi con thực tế làm medoid đại diện
print("Chỉ số các medoid chuỗi con:", clf_dtw.medoid_indices_)
Thực nghiệm này cho thấy K-Medoids có thể làm việc trực tiếp với các độ đo phi Euclid tùy biến. Thay vì cần một thuật toán tạo chuỗi trung bình xấp xỉ như DBA trong K-Means, FastCLARANS nhận trực tiếp ma trận DTW tính trước và trả về các đoạn chuỗi con có thật trong tập dữ liệu làm tâm đại diện.
5.3. So sánh hai phương pháp triển khai
| Tiêu chí | Phương pháp 1: Feature Engineering + Manhattan | Phương pháp 2: Subsequence Windowing + DTW |
|---|---|---|
| Độ phức tạp tính toán | cho mỗi điểm dữ liệu mới đến | cho mỗi chuỗi con độ dài |
| Độ trễ phản hồi | Phản ứng tức thời theo từng chu kỳ lấy mẫu (5 phút) | Cần tích lũy đủ cửa sổ chuỗi con (2 giờ) |
| Khả năng xử lý lệch pha | Nắm bắt qua các thống kê trượt (mean, std, diff) | Căn chỉnh trực tiếp bằng phép uốn phi tuyến |
| Môi trường phù hợp | Giám sát trực tuyến tốc độ cao (Edge IoT, Streaming) | Phân tích hồi cứu (Batch analytics, Root Cause) |
6. Tổng kết
Qua các thực nghiệm trên tập dữ liệu cảm biến công nghiệp Numenta NAB, chúng ta có thể rút ra một số kết luận kỹ thuật:
- Khả năng kháng ô nhiễm tâm cụm: Nhờ tối thiểu hóa hàm mục tiêu khoảng cách bậc một (), các medoid định vị tại các trạng thái vận hành chuẩn của máy, không bị kéo lệch bởi các đợt quá nhiệt kéo dài. Chỉ số ROC-AUC của FastCLARANS đạt 0.7819 so với 0.6948 của K-Means.
- Tâm cụm có thể giải thích trực tiếp: Mỗi medoid là một quan sát thực tế trong lịch sử kèm mốc thời gian cụ thể, giúp đối chiếu trực tiếp với chế độ tải và trạng thái vật lý của thiết bị.
- Phát hiện sớm sự cố: Việc kết hợp các đặc trưng động học trượt giúp mô hình nhận diện xu hướng trôi dạt nhiệt độ nền trước thời điểm máy hỏng hơn 24 giờ.
- Tương thích với nhiều độ đo: Thuật toán có thể kết hợp với khoảng cách Manhattan để giám sát trực tuyến với chi phí tính toán thấp, hoặc nhận ma trận khoảng cách DTW tính trước khi cần so khớp hình thái sóng chuỗi con.
Toàn bộ mã nguồn thực nghiệm được lưu trữ trong sổ tay bai_5_anomaly_detection_telemetry.ipynb. Ở bài viết tiếp theo, chúng ta sẽ chuyển sang không gian dữ liệu văn bản nhiều chiều, khảo sát cách FastCLARANS kết hợp với khoảng cách Cosine trên ma trận thưa TF-IDF.
All rights reserved
