

Phân khúc khách hàng trên dữ liệu hỗn hợp với khoảng cách phi Euclid
Ở ba bài viết trước, chúng ta đã tìm hiểu cơ chế tìm kiếm trên đồ thị hoán đổi của CLARANS và FastCLARANS cũng như cách đóng gói thuật toán vào Pipeline của Scikit-Learn. Các thực nghiệm đó chủ yếu vận hành trên không gian vector liên tục với khoảng cách Euclid. Tuy nhiên, dữ liệu khách hàng trong thực tế hiếm khi chỉ gồm các biến định lượng thuần túy. Một bảng dữ liệu quản trị quan hệ khách hàng (CRM) thường kết hợp cả biến định lượng (tuổi, thu nhập, tổng chi tiêu, số lượt mua) lẫn biến phân loại (trình độ học vấn, tình trạng hôn nhân, cấu trúc gia đình).
Khi phân cụm dữ liệu hỗn hợp (mixed-type data), thuật toán K-Means gặp hạn chế về mặt toán học: các biến phân loại sau khi mã hóa One-Hot sẽ tạo ra những tâm cụm mang giá trị thập phân không gắn với cá nhân cụ thể nào, đồng thời khoảng cách Euclid không phản ánh đúng quan hệ giữa các danh mục. Trong bài viết này, chúng ta sẽ thực nghiệm trên toàn bộ tập dữ liệu Customer Personality Analysis với các độ đo khoảng cách phi Euclid gồm Manhattan, Chebyshev và Gower, sau đó trích xuất trực tiếp các medoid tìm được làm hồ sơ khách hàng đại diện (Customer Persona) cho từng phân khúc.
1. Dữ liệu hỗn hợp và giới hạn của K-Means trong phân khúc khách hàng
1.1. Hệ quả khi đưa biến phân loại sang không gian Euclid
Để chạy K-Means trên tập dữ liệu có biến phân loại, cách làm phổ biến là áp dụng One-Hot Encoding nhằm chuyển các cột danh mục thành những vector nhị phân 0 và 1, rồi tính tâm cụm bằng trung bình cộng tọa độ. Cách tiếp cận này dẫn đến hai vấn đề về mặt toán học và nghiệp vụ:
- Tâm cụm không phải là một hồ sơ có thật: Vì centroid là trung bình số học của các giá trị 0 và 1, tọa độ tâm cụm thường nhận các giá trị lẻ như
Education_PhD = 0.23hoặcMarital_Status_Married = 0.37. Các con số này chỉ phản ánh tỷ lệ mẫu mang thuộc tính đó trong cụm, không thể đại diện cho một khách hàng cụ thể ngoài đời thực. - Sai lệch cấu trúc khoảng cách và thang đo: Khoảng cách Euclid giữa hai vector One-Hot khác nhãn luôn cố định bằng , làm mất tính thứ bậc tự nhiên giữa các mức học vấn như
Basic,Graduation,MastervàPhD. Hơn nữa, nếu ghép trực tiếp các cột nhị phân này với các biến định lượng có biên độ hàng chục nghìn đơn vị như thu nhập mà không cân chỉnh trọng số, bình phương độ lệch của biến thu nhập sẽ chi phối toàn bộ hàm mục tiêu của K-Means.
1.2. Nhu cầu về hồ sơ khách hàng đại diện và tiền xử lý dữ liệu
Khi thiết kế chiến dịch tiếp thị và chăm sóc khách hàng, đội ngũ nghiệp vụ cần những hồ sơ mẫu cụ thể (Customer Persona) với đầy đủ độ tuổi, thu nhập, học vấn, hoàn cảnh gia đình và hành vi mua sắm. K-Medoids đáp ứng trực tiếp yêu cầu này vì thuật toán luôn chọn một bản ghi có thật trong tập dữ liệu làm tâm cụm (medoid), giữ nguyên vẹn các nhãn danh mục gốc mà không làm biến dạng dữ liệu qua phép tính trung bình.
Tập dữ liệu gốc marketing_campaign.csv gồm 2,240 dòng và 29 cột thuộc nhiều nhóm thông tin khác nhau. Để bài toán phân khúc tập trung vào hành vi tiêu dùng và nhân khẩu học, chúng ta thực hiện tiền xử lý và rút gọn đặc trưng theo các bước sau:
- Loại bỏ 24 dòng khuyết dữ liệu thu nhập (
Income). - Loại bỏ 1 dòng ngoại lai thu nhập vượt mức 200,000 USD (bản ghi có thu nhập 666,666 USD).
- Loại bỏ 7 dòng có nhãn tình trạng hôn nhân không hợp lệ (
YOLO,Absurd,Alone), chỉ giữ lại 5 nhóm chuẩn (Married,Together,Single,Divorced,Widow). Toàn bộ tập dữ liệu sạch sau làm sạch gồm chính xác 2,208 khách hàng. - Loại bỏ các cột hằng số
Z_CostContact(luôn bằng 3) vàZ_Revenue(luôn bằng 11) do có phương sai bằng 0. - Bỏ qua các cột lịch sử phản hồi chiến dịch (
AcceptedCmp1đếnAcceptedCmp5,Response,Complain) vì các biến đích này phù hợp với bài toán phân loại có giám sát hơn là phân cụm hành vi nền tảng. - Quy đổi năm sinh sang độ tuổi tại thời điểm chốt khảo sát năm 2014:
Age = 2014 - Year_Birth(ngày đăng kýDt_Customermới nhất trong tập dữ liệu là tháng 06/2014). - Cộng gộp 6 cột chi tiêu theo nhóm hàng (
MntWines,MntFruits,MntMeatProducts,MntFishProducts,MntSweetProducts,MntGoldProds) thành biến tổng chi tiêuTotal_Spentđại diện cho giá trị tiền tệ (Monetary). - Tổng hợp số lượt mua qua ba kênh chính:
Total_Purchases = NumWebPurchases + NumCatalogPurchases + NumStorePurchases, đại diện cho tần suất mua sắm (Frequency). - Tạo biến nhị phân phản ánh cấu trúc con cái trong hộ gia đình:
Has_Children = (Kidhome + Teenhome > 0).
Sau bước làm sạch, các đặc trưng được chia thành hai nhóm phục vụ thực nghiệm:
- Nhóm biến hành vi và gia đình cốt lõi (
Income,Total_Spent,Total_Purchases,Has_Children): dùng trực tiếp để tính ma trận khoảng cách Gower và phân tách cụm. - Nhóm biến nhân khẩu học đi kèm (
Age,Education,Marital_Status): dùng để kiểm chứng hạn chế của K-Means và trích xuất thông tin hồ sơ chi tiết từ các medoid tìm được.
Đoạn mã dưới đây tải dữ liệu, thực hiện tiền xử lý và giữ nguyên toàn bộ 2,208 khách hàng để thực nghiệm:
import pandas as pd
import numpy as np

# Tải tập dữ liệu khách hàng thực tế từ URL
url = 'https://raw.githubusercontent.com/amankharwal/Website-data/master/marketing_campaign.csv'
df_raw = pd.read_csv(url, sep=';')

# 1. Bỏ các dòng khuyết dữ liệu thu nhập
df_clean = df_raw.dropna(subset=['Income']).copy()

# 2. Loại bỏ ngoại lai thu nhập bất thường (> 200,000 USD)
df_clean = df_clean[df_clean['Income'] < 200000].copy()

# 3. Tính độ tuổi tại thời điểm khảo sát (năm 2014) và tổng chi tiêu qua các nhóm sản phẩm
df_clean['Age'] = 2014 - df_clean['Year_Birth']
df_clean['Total_Spent'] = df_clean[['MntWines', 'MntFruits', 'MntMeatProducts', 'MntFishProducts', 'MntSweetProducts', 'MntGoldProds']].sum(axis=1)

# 4. Tính tổng số lượt mua sắm (Total_Purchases)
df_clean['Total_Purchases'] = df_clean['NumWebPurchases'] + df_clean['NumCatalogPurchases'] + df_clean['NumStorePurchases']

# 5. Trích xuất yếu tố nhân khẩu học gia đình (Has_Children)
df_clean['Has_Children'] = (df_clean['Kidhome'] + df_clean['Teenhome'] > 0).astype(int)

# 6. Giữ các nhóm tình trạng hôn nhân tiêu biểu
valid_marital = ['Married', 'Together', 'Single', 'Divorced', 'Widow']
df_clean = df_clean[df_clean['Marital_Status'].isin(valid_marital)].copy()

# Sử dụng toàn bộ dữ liệu sạch để thực nghiệm phân cụm
df_customers = df_clean.reset_index(drop=True)

display_cols = ['ID', 'Age', 'Education', 'Marital_Status', 'Has_Children', 'Income', 'Total_Spent', 'Total_Purchases']
print(f"Kích thước tập dữ liệu thực nghiệm: {len(df_customers)} dòng, {df_customers.shape[1]} cột tổng thể")
print("\n5 dòng đầu tiên:")
print(df_customers[display_cols].head(5).to_string())
Kết quả in ra từ thực nghiệm:
Kích thước tập dữ liệu thực nghiệm: 2208 dòng, 33 cột tổng thể

5 dòng đầu tiên:
     ID  Age   Education Marital_Status  Has_Children   Income  Total_Spent  Total_Purchases
0  5524   57  Graduation         Single             0  58138.0         1617               22
1  2174   60  Graduation         Single             1  46344.0           27                4
2  4141   49  Graduation       Together             0  71613.0          776               20
3  6182   30  Graduation       Together             1  26646.0           53                6
4  5324   33         PhD        Married             1  58293.0          422               14
Để quan sát hạn chế của K-Means trên tập dữ liệu này, ta mã hóa One-Hot cho hai cột Education và Marital_Status rồi chạy K-Means với :
from sklearn.cluster import KMeans

# Mã hóa One-Hot Encoding cho các biến danh mục
num_cols_init = ['Age', 'Income', 'Total_Spent', 'Total_Purchases']
cat_cols_init = ['Education', 'Marital_Status']
df_ohe = pd.get_dummies(df_customers[num_cols_init + cat_cols_init])

km = KMeans(n_clusters=4, random_state=42)
km.fit(df_ohe)

print("Tọa độ centroid từ K-Means (làm tròn 2 chữ số thập phân):")
print(pd.DataFrame(km.cluster_centers_, columns=df_ohe.columns).round(2).T)
Kết quả in ra từ thực nghiệm:
Tọa độ centroid từ K-Means (làm tròn 2 chữ số thập phân):
                                0         1         2         3
Age                         39.59     48.07     45.53     46.33
Income                   23484.13  63001.56  42347.00  82875.29
Total_Spent                 75.77    870.14    230.07   1423.37
Total_Purchases              5.35     17.33      8.64     19.56
Education_2n Cycle           0.14      0.07      0.08      0.08
Education_Basic              0.11     -0.00      0.00      0.00
Education_Graduation         0.51      0.51      0.48      0.51
Education_Master             0.12      0.16      0.20      0.17
Education_PhD                0.12      0.26      0.24      0.23
Marital_Status_Divorced      0.09      0.12      0.11      0.10
Marital_Status_Married       0.39      0.41      0.37      0.37
Marital_Status_Single        0.24      0.17      0.23      0.23
Marital_Status_Together      0.26      0.26      0.26      0.27
Marital_Status_Widow         0.02      0.04      0.04      0.04
Bảng kết quả cho thấy hai điểm hạn chế rõ rệt. Thứ nhất, do biến Income có biên độ hàng chục nghìn đơn vị, K-Means gần như chỉ cắt dữ liệu theo 4 bậc thu nhập (khoảng 23.5k, 42.3k, 63.0k và 82.9k USD), khiến phân bố học vấn và tình trạng hôn nhân ở cả 4 cụm gần như tương đương nhau (tỷ lệ Education_Graduation luôn dao động quanh mức 0.48 đến 0.51). Thứ hai, tại cụm 1, tọa độ centroid trả về Education_PhD = 0.26, Education_Graduation = 0.51, Marital_Status_Married = 0.41 và Marital_Status_Together = 0.26. Những con số thập phân này chỉ cho biết cơ cấu phần trăm trong cụm, không chỉ ra được một hồ sơ khách hàng cụ thể để làm mẫu đại diện.
2. Các độ đo khoảng cách phi Euclid cho biến định lượng
Trước khi kết hợp dữ liệu hỗn hợp, ta khảo sát cách các độ đo phi Euclid định hình cấu trúc cụm trên 5 biến định lượng: Age, Income, Total_Spent, NumWebPurchases và NumStorePurchases.
2.1. Khoảng cách Manhattan (chuẩn L1)
Khoảng cách Manhattan giữa hai vector và bằng tổng độ lệch tuyệt đối trên từng chiều:
Trong khi khoảng cách Euclid bình phương độ lệch trên từng thuộc tính (), khoảng cách Manhattan chỉ tăng tuyến tính theo mức chênh lệch. Khi tập dữ liệu có những cá nhân thu nhập rất cao hoặc chi tiêu đột biến, chuẩn không phóng đại sai số lên bậc hai, giúp vị trí các medoid ổn định hơn.
2.2. Khoảng cách Chebyshev (chuẩn L-vô cùng)
Khoảng cách Chebyshev xác định độ xa giữa hai quan sát bằng độ lệch tuyệt đối lớn nhất trên tất cả các chiều:
Trong không gian đa chiều, mặt cầu đơn vị của chuẩn Chebyshev có dạng một siêu hình hộp (hypercube). Độ đo này phù hợp khi bài toán phân khúc cần kiểm soát ngưỡng chênh lệch tối đa: hai khách hàng chỉ được xếp gần nhau nếu họ tương đồng trên mọi tiêu chí, và chỉ cần một thuộc tính lệch quá xa thì khoảng cách tổng thể sẽ lập tức bị đẩy lên theo thuộc tính đó.
2.3. So sánh thực nghiệm giữa Euclid, Manhattan và Chebyshev
Đoạn mã sau chuẩn hóa 5 biến định lượng bằng RobustScaler và chạy FastCLARANS với ba độ đo trên toàn bộ 2,208 khách hàng:
from sklearn.preprocessing import RobustScaler
from sklearn.metrics import silhouette_score
from clarans import FastCLARANS

num_cols = ['Age', 'Income', 'Total_Spent', 'NumWebPurchases', 'NumStorePurchases']
scaler = RobustScaler()
X_num_scaled = scaler.fit_transform(df_customers[num_cols])

metrics_to_test = ['euclidean', 'manhattan', 'chebyshev']

for m in metrics_to_test:
    model_m = FastCLARANS(n_clusters=4, metric=m, random_state=42)
    model_m.fit(X_num_scaled)
    sil = silhouette_score(X_num_scaled, model_m.labels_, metric=m)
    print(f"Độ đo: {m:10s} | Inertia: {model_m.inertia_:8.2f} | Silhouette Score: {sil:.4f} | Medoid IDs: {model_m.medoid_indices_}")
Kết quả in ra từ thực nghiệm:
Độ đo: euclidean  | Inertia:  1870.65 | Silhouette Score: 0.2413 | Medoid IDs: [ 617  925  966 1426]
Độ đo: manhattan  | Inertia:  3342.78 | Silhouette Score: 0.2906 | Medoid IDs: [ 874  875 1454 1586]
Độ đo: chebyshev  | Inertia:  1411.06 | Silhouette Score: 0.2155 | Medoid IDs: [ 173  174 1030 1217]
Khi đọc bảng kết quả trên, cần lưu ý rằng với mọi vector độ lệch , các chuẩn toán học luôn thỏa mãn bất đẳng thức . Vì vậy, giá trị Inertia của Manhattan luôn lớn hơn Euclid và Chebyshev về mặt trị số tuyệt đối, và ta không so sánh trực tiếp Inertia giữa các độ đo khác nhau. Dựa trên hệ số Silhouette tính theo từng độ đo tương ứng:
- Khoảng cách Manhattan đạt Silhouette Score cao nhất (0.2906), thể hiện sự phù hợp với các biến kinh tế có phân phối trải rộng.
- Việc thay đổi độ đo dẫn tới các tập tâm đại diện hoàn toàn khác nhau: Euclid chọn
[617, 925, 966, 1426], Manhattan chọn[874, 875, 1454, 1586], trong khi Chebyshev chọn[173, 174, 1030, 1217]nhằm hạn chế tối đa sai số cực đại trên từng chiều đơn lẻ.
3. Khoảng cách Gower cho tập dữ liệu hỗn hợp
3.1. Cơ sở toán học của độ đo Gower và xử lý phân phối lệch
Để tính độ bất tương đồng giữa các bản ghi chứa cả biến định lượng lẫn biến phân loại, nhà thống kê J. C. Gower đã giới thiệu hệ số tương đồng tổng quát vào năm 1971. Khi dữ liệu không bị khuyết thiếu, khoảng cách Gower giữa hai quan sát và được xác định bằng trung bình có trọng số của các khoảng cách thành phần trên từng thuộc tính:
Trong đó là tổng số thuộc tính đưa vào mô hình, là trọng số của thuộc tính thứ , và khoảng cách thành phần được tính theo kiểu dữ liệu của cột :
- Với biến định lượng liên tục (Continuous): Khoảng cách giữa hai giá trị được chuẩn hóa theo khoảng biến thiên (range) của thuộc tính đó trên toàn tập mẫu:
Trong dữ liệu tiêu dùng, các biến Income, Total_Spent và Total_Purchases thường có phân phối lệch phải (right-skewed). Nếu chia trực tiếp cho trên thang đo gốc, một vài khách hàng có thu nhập hoặc chi tiêu rất lớn sẽ kéo giãn mẫu số , nén phần lớn khách hàng thông thường vào một khoảng hẹp và làm mờ ranh giới giữa các cụm. Để khắc phục, ta áp dụng phép biến đổi logarit tự nhiên trước khi tính khoảng biến thiên, giúp phân phối dữ liệu trải đều hơn trên đoạn .
- Với biến phân loại định danh và nhị phân đối xứng (Nominal / Symmetric Binary): Hai quan sát có khoảng cách bằng 0 nếu mang cùng giá trị và bằng 1 nếu khác giá trị:
- Thiết lập trọng số thuộc tính :
Để phân khúc khách hàng phản ánh sát hành vi mua sắm và cấu trúc hộ gia đình, ta đưa 4 biến chủ đạo vào ma trận khoảng cách Gower gồm
Total_Spent,Total_Purchases,IncomevàHas_Children. Trong thực tế tiếp thị, số tiền thực chi (Total_Spent) và tần suất mua (Total_Purchases) phản ánh giá trị khách hàng trực tiếp hơn mức thu nhập khai báo, còn tình trạng con cái (Has_Children) quyết định cơ cấu giỏ hàng gia đình. Do đó, ta gán bộ trọng số: , , và .
3.2. Cài đặt hàm tính ma trận khoảng cách Gower bằng NumPy
Đoạn mã dưới đây tính ma trận khoảng cách Gower kích thước bằng cơ chế broadcasting của NumPy:
weights = {'Income': 0.5, 'Total_Spent': 2.5, 'Total_Purchases': 2.0, 'Has_Children': 2.0}
log_features = ['Income', 'Total_Spent', 'Total_Purchases']
cat_features = ['Has_Children']

def compute_gower_optimized(df, num_cols, cat_cols, log_cols, weights):
    n = len(df)
    D = np.zeros((n, n), dtype=np.float64)
    sw = sum(weights.values())

    # 1. Biến định lượng (biến đổi log1p để triệt tiêu độ lệch phải)
    for col in num_cols:
        v = df[col].to_numpy(dtype=np.float64)
        if col in log_cols:
            v = np.log1p(v)
        rng = v.max() - v.min()
        if rng > 0:
            diff = np.abs(v[:, None] - v[None, :]) / rng
        else:
            diff = np.zeros((n, n), dtype=np.float64)
        D += weights[col] * diff

    # 2. Biến phân loại (so khớp nhị phân)
    for col in cat_cols:
        v = df[col].to_numpy()
        diff = (v[:, None] != v[None, :]).astype(np.float64)
        D += weights[col] * diff

    D /= sw
    return D

D_gower = compute_gower_optimized(df_customers, num_cols=log_features, cat_cols=cat_features, log_cols=log_features, weights=weights)

print("Hình dáng ma trận khoảng cách Gower:", D_gower.shape)
print(f"Khoảng giá trị: min = {D_gower.min():.4f}, max = {D_gower.max():.4f}, mean = {D_gower.mean():.4f}")
print("Giá trị đường chéo (khoảng cách từ một điểm đến chính nó):", np.diag(D_gower)[:5])
Kết quả in ra từ thực nghiệm:
Hình dáng ma trận khoảng cách Gower: (2208, 2208)
Khoảng giá trị: min = 0.0000, max = 0.9686, mean = 0.2807
Giá trị đường chéo (khoảng cách từ một điểm đến chính nó): [0. 0. 0. 0. 0.]
Ma trận D_gower thu được đối xứng kích thước (chiếm khoảng 37.2 MB RAM), có đường chéo chính bằng 0 và khoảng cách trung bình giữa các cặp khách hàng là 0.2807.
3.3. Tích hợp vào FastCLARANS: So sánh Custom Metric Callable và Precomputed Matrix
Trong scikit-clarans, người dùng có thể đưa khoảng cách Gower vào lớp FastCLARANS hoặc CLARANS theo hai cách: truyền trực tiếp hàm Python qua tham số metric=callable hoặc truyền ma trận khoảng cách đã tính trước với metric='precomputed'.
1. Sử dụng hàm khoảng cách tùy biến (Custom Metric Callable)
Khi dùng metric=callable, dữ liệu đầu vào cần được gom thành mảng số 2 chiều X_feat (gồm 3 biến định lượng đã lấy log1p và biến nhị phân Has_Children). Hàm custom_gower_metric(u, v) nhận hai vector hàng và trả về khoảng cách Gower giữa chúng dựa trên mảng khoảng biến thiên ranges đã tính sẵn:
import time

# Chuẩn bị mảng số X_feat: 3 biến số (log1p) và 1 biến nhị phân Has_Children
X_feat = np.column_stack([
    np.log1p(df_customers['Income'].to_numpy()),
    np.log1p(df_customers['Total_Spent'].to_numpy()),
    np.log1p(df_customers['Total_Purchases'].to_numpy()),
    df_customers['Has_Children'].to_numpy().astype(float)
])

# Khoảng biến thiên R trên toàn tập dữ liệu
ranges = np.ptp(X_feat[:, :3], axis=0)
w_vec = np.array([0.5, 2.5, 2.0, 2.0])
sw_vec = np.sum(w_vec)

def custom_gower_metric(u, v):
    d_num = np.abs(u[:3] - v[:3]) / ranges
    d_cat = 1.0 if u[3] != v[3] else 0.0
    diff = np.append(d_num, d_cat)
    return np.dot(w_vec, diff) / sw_vec

# Huấn luyện FastCLARANS trực tiếp bằng hàm khoảng cách tùy biến
t_call_start = time.perf_counter()
model_callable = FastCLARANS(n_clusters=4, metric=custom_gower_metric, random_state=42)
model_callable.fit(X_feat)
t_call_elapsed = time.perf_counter() - t_call_start

print("Chỉ số các medoid từ Custom Metric Callable:", model_callable.medoid_indices_)
print(f"Giá trị Inertia L1: {round(model_callable.inertia_, 2)} (thời gian chạy: {t_call_elapsed:.2f}s)")
Kết quả in ra từ thực nghiệm:
Chỉ số các medoid từ Custom Metric Callable: [ 173  510  690 2115]
Giá trị Inertia L1: 111.35 (thời gian chạy: 29.46s)
2. Sử dụng ma trận tính trước (Precomputed Matrix)
Mặc dù truyền hàm callable cho phép gọi trực tiếp trên ma trận đặc trưng, cách dùng metric='precomputed' mang lại ưu thế rõ rệt trong thực tế vì ba lý do kỹ thuật:
- Giảm chi phí gọi hàm Python: Với 2,208 mẫu, việc tính khoảng cách từng cặp qua một hàm Python
callableđòi hỏi hơn lượt gọi hàm ở tầng thông dịch, làm bướcfitmất tới 29.46 giây. Ngược lại, tính ma trậnD_gowerbằng phép toán vector hóa của NumPy chỉ mất khoảng 0.51 giây, và bướcfit(D_gower)trong Cython chỉ mất thêm 0.1258 giây. - Sự phụ thuộc vào thống kê toàn cục của độ đo Gower: Công thức Gower cần biết khoảng biến thiên của toàn bộ tập dữ liệu. Một hàm khoảng cách hai điểm độc lập không thể tự suy ra nếu không tham chiếu biến
rangesbên ngoài hàm. - Tái sử dụng ma trận khi khảo sát siêu tham số: Khi quét nhiều giá trị khác nhau hoặc tính hệ số Silhouette ở bước sau, ma trận
D_gowerchỉ cần tính một lần duy nhất và truyền lại cho mọi mô hình.
Đoạn mã sau huấn luyện FastCLARANS trực tiếp trên ma trận D_gower:
# Huấn luyện FastCLARANS tối ưu trên ma trận khoảng cách đã tính trước
t_pre_start = time.perf_counter()
model_precomputed = FastCLARANS(n_clusters=4, metric='precomputed', random_state=42)
model_precomputed.fit(D_gower)
t_pre_elapsed = time.perf_counter() - t_pre_start

print("Chỉ số các medoid tìm được trên ma trận Gower:", model_precomputed.medoid_indices_)
print(f"Giá trị Inertia L1: {round(model_precomputed.inertia_, 2)} (thời gian chạy: {t_pre_elapsed:.4f}s)")
Kết quả in ra từ thực nghiệm:
Chỉ số các medoid tìm được trên ma trận Gower: [ 173  510  690 2115]
Giá trị Inertia L1: 111.35 (thời gian chạy: 0.1258s)
Đối chiếu hai kết quả, cả hai phương pháp đều hội tụ về đúng một tập medoid [173, 510, 690, 2115] với tổng khoảng cách Gower (Inertia) bằng 111.35, nhưng chế độ metric='precomputed' rút ngắn thời gian huấn luyện từ 29.46 giây xuống còn 0.1258 giây (nhanh hơn ~234 lần). Lưu ý rằng khi dùng metric='precomputed', thuộc tính cluster_centers_ sẽ mang giá trị None vì mô hình không nhận đầu vào là tọa độ điểm; vị trí các tâm đại diện được lấy qua thuộc tính medoid_indices_.
4. Xác định số phân khúc k
4.1. Tiêu chí đánh giá trên ma trận Gower
Tương tự quy trình ở Bài 3, ta khảo sát các giá trị khác nhau dựa trên hai chỉ số:
- Inertia (
inertia_): Tổng khoảng cách Gower bậc một từ mỗi khách hàng tới medoid gần nhất của họ. - Hệ số Silhouette (
silhouette_score): Đánh giá độ gắn kết nội cụm so với khoảng cách tới cụm láng giềng gần nhất, được tính trực tiếp từ ma trận khoảng cách qua cú phápsilhouette_score(D_gower, labels, metric='precomputed').
4.2. Khảo sát thực nghiệm theo số cụm k
Đoạn mã dưới đây quét từ 2 đến 7 trên ma trận D_gower và vẽ biểu đồ đối chiếu:
import matplotlib.pyplot as plt

k_range = list(range(2, 8))
gower_inertias = []
gower_silhouettes = []

for k in k_range:
    clf_gower = FastCLARANS(n_clusters=k, metric='precomputed', random_state=42)
    clf_gower.fit(D_gower)
    sil_g = silhouette_score(D_gower, clf_gower.labels_, metric='precomputed')
    gower_inertias.append(clf_gower.inertia_)
    gower_silhouettes.append(sil_g)
    print(f"k = {k}: Inertia L1 = {clf_gower.inertia_:6.2f} | Silhouette Score = {sil_g:.4f} | Medoids = {clf_gower.medoid_indices_}")

# Vẽ đồ thị đánh giá số cụm
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.2))

ax1.plot(k_range, gower_inertias, marker='o', color='#2b5c8f', linewidth=2, markersize=6)
ax1.set_xlabel('Số lượng phân khúc (k)')
ax1.set_ylabel('Inertia (Tổng khoảng cách Gower)')
ax1.set_title('(a) Phương pháp Elbow trên ma trận Gower')
ax1.grid(True, linestyle='--', alpha=0.5)
ax1.axvline(x=4, color='#e41a1c', linestyle=':', label='Điểm uốn k=4')
ax1.legend()

ax2.plot(k_range, gower_silhouettes, marker='s', color='#d95f02', linewidth=2, markersize=6)
ax2.set_xlabel('Số lượng phân khúc (k)')
ax2.set_ylabel('Silhouette Score')
ax2.set_title('(b) Hệ số Silhouette theo số cụm k')
ax2.grid(True, linestyle='--', alpha=0.5)
ax2.axvline(x=4, color='#e41a1c', linestyle=':', label='Đỉnh tối ưu k=4 (0.6931)')
ax2.legend()

plt.tight_layout()
plt.show()
Kết quả in ra từ thực nghiệm:
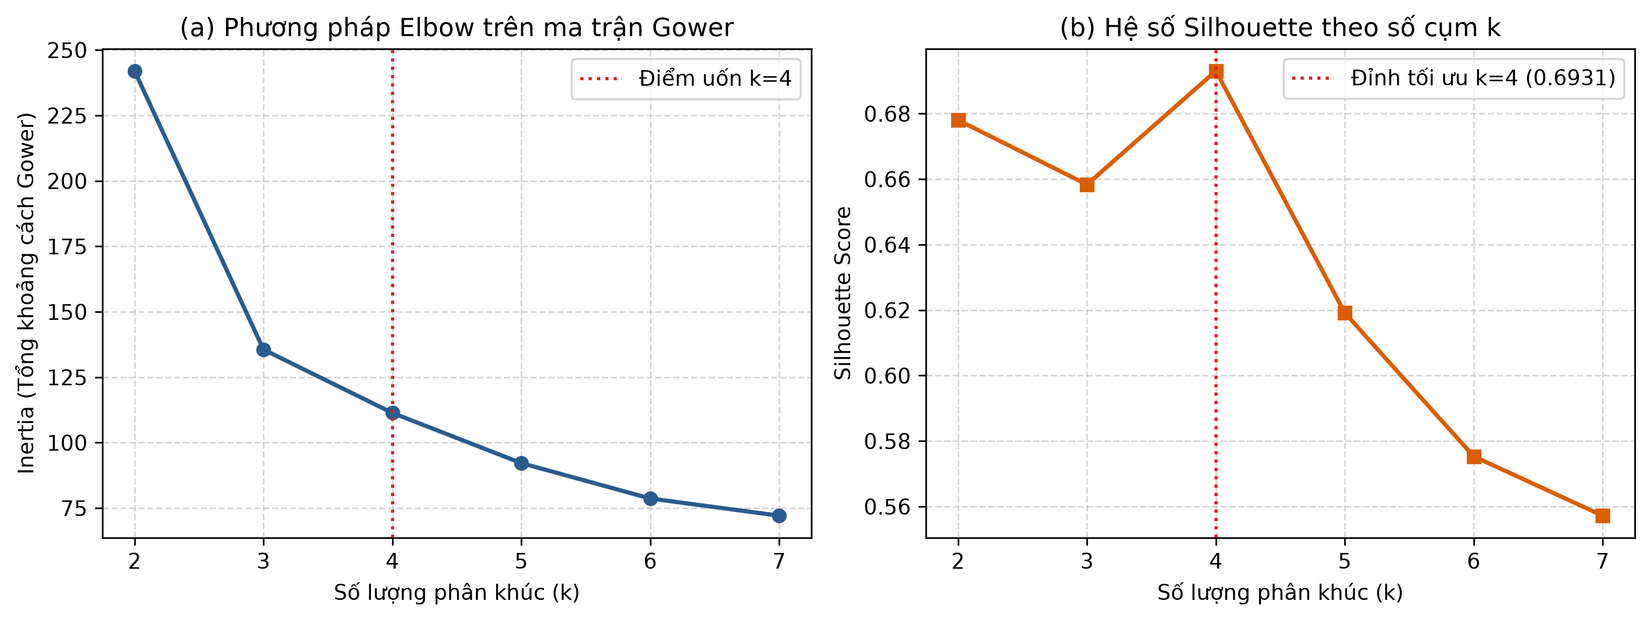
k = 2: Inertia L1 = 242.01 | Silhouette Score = 0.6780 | Medoids = [ 764 1430]
k = 3: Inertia L1 = 135.55 | Silhouette Score = 0.6583 | Medoids = [ 764 1486 2186]
k = 4: Inertia L1 = 111.35 | Silhouette Score = 0.6931 | Medoids = [ 173  510  690 2115]
k = 5: Inertia L1 =  92.17 | Silhouette Score = 0.6191 | Medoids = [  57  248  895 1644 2089]
k = 6: Inertia L1 =  78.65 | Silhouette Score = 0.5753 | Medoids = [ 241  243  315 1901 2000 2117]
k = 7: Inertia L1 =  72.09 | Silhouette Score = 0.5572 | Medoids = [ 765  897 1018 1290 1644 1803 2127]
Số liệu thực nghiệm cho thấy:
- Tổng khoảng cách Gower giảm nhanh từ (242.01) xuống (111.35), sau đó độ dốc giảm dần ở các mốc .
- Hệ số Silhouette đạt mức cao nhất tại với 0.6931, vượt qua các cấu hình (0.6780), (0.6583) và (0.6191).
- Việc biến đổi logarit cho các biến lệch phải kết hợp với bộ trọng số hành vi giúp ma trận Gower tách tập khách hàng thành 4 phân khúc rõ ràng. Ta chọn để trích xuất hồ sơ khách hàng đại diện ở bước tiếp theo.
5. Trích xuất Customer Persona và phân tích đặc trưng phân khúc
5.1. Bảng chân dung khách hàng đại diện từ các medoid
Với , ta dùng mảng chỉ số medoid_indices_ để lấy trực tiếp 4 bản ghi khách hàng gốc từ df_customers:
# Huấn luyện FastCLARANS với k=4 trên ma trận Gower
final_model = FastCLARANS(n_clusters=4, metric='precomputed', random_state=42)
final_model.fit(D_gower)
df_customers['Cluster'] = final_model.labels_

# Trích xuất các dòng dữ liệu medoid
med_indices = final_model.medoid_indices_
print("Chỉ số dòng của 4 medoid:", med_indices)

persona_df = df_customers.iloc[med_indices].copy()
persona_df['Assigned_Cluster'] = [final_model.labels_[idx] for idx in med_indices]
persona_df = persona_df.sort_values('Assigned_Cluster').reset_index(drop=True)

display_cols = ['Assigned_Cluster', 'ID', 'Age', 'Education', 'Marital_Status', 'Has_Children', 'Income', 'Total_Spent', 'Total_Purchases']
print("\nBảng chân dung khách hàng đại diện (Customer Personas):")
print(persona_df[display_cols].to_string(index=False))

# Kiểm tra quy mô từng phân khúc
cluster_counts = df_customers['Cluster'].value_counts().sort_index()
print("\nPhân bố số lượng khách hàng theo từng cụm:")
for c, cnt in cluster_counts.items():
    print(f"  Cụm {c}: {cnt} khách hàng ({cnt/len(df_customers)*100:.1f}%)")
Kết quả in ra từ thực nghiệm:
Chỉ số dòng của 4 medoid: [ 173  510  690 2115]

Bảng chân dung khách hàng đại diện (Customer Personas):
 Assigned_Cluster   ID  Age  Education Marital_Status  Has_Children  Income  Total_Spent  Total_Purchases
                0 3934   48 Graduation        Married             1 61286.0          608               16
                1 4322   56        PhD       Together             0 77863.0         1291               19
                2 4472   44        PhD       Divorced             1 35682.0           57                5
                3 9727   57 Graduation        Married             0 23539.0           81                6

Phân bố số lượng khách hàng theo từng cụm:
  Cụm 0: 790 khách hàng (35.8%)
  Cụm 1: 508 khách hàng (23.0%)
  Cụm 2: 787 khách hàng (35.6%)
  Cụm 3: 123 khách hàng (5.6%)
Mỗi medoid tìm được là một hồ sơ khách hàng có thật trong cơ sở dữ liệu với đầy đủ thuộc tính gốc:
- Cụm 0 (790 khách hàng, chiếm 35.8%): Medoid đại diện là khách hàng
ID 3934(48 tuổi, trình độGraduation, đã kết hônMarried, có con, thu nhập 61,286 USD, chi tiêu 608 USD qua 16 lượt mua). Phân khúc này tập trung các hộ gia đình trung lưu có con, mua sắm đều đặn với mức chi tiêu khá. - Cụm 1 (508 khách hàng, chiếm 23.0%): Hồ sơ tâm cụm là khách hàng
ID 4322(56 tuổi, trình độPhD, sống chungTogether, chưa có con, thu nhập 77,863 USD, chi tiêu 1,291 USD qua 19 lượt mua). Nhóm khách hàng VIP này có thu nhập cao, không vướng bận chi phí nuôi con và chi tiêu rất mạnh cho các sản phẩm giá trị lớn. - Cụm 2 (787 khách hàng, chiếm 35.6%): Tâm đại diện là khách hàng
ID 4472(44 tuổi, trình độPhD, ly hônDivorced, có con, thu nhập 35,682 USD, chi tiêu 57 USD trong 5 lượt mua). Đây là phân khúc các gia đình có con nhỏ hoặc con ở tuổi đi học, thu nhập trung bình thấp nên thắt chặt ngân sách mua sắm. - Cụm 3 (123 khách hàng, chiếm 5.6%): Medoid đại diện là khách hàng
ID 9727(57 tuổi, trình độGraduation, đã kết hônMarried, chưa có con, thu nhập 23,539 USD, chi tiêu 81 USD với 6 lượt mua). Đây là nhóm khách hàng chưa có con tại hộ gia đình, thu nhập thấp và mức chi tiêu nhỏ giọt.
5.2. Đối chiếu medoid thực tế với thống kê toàn cụm
Để kiểm tra mức độ đại diện của 4 hồ sơ medoid so với toàn bộ khách hàng trong từng phân khúc, ta tính trung bình các biến định lượng và tỷ lệ phần trăm các biến phân loại theo cụm:
print("Giá trị trung bình định lượng theo từng cụm:")
print(df_customers.groupby('Cluster')[['Age', 'Income', 'Total_Spent', 'Total_Purchases', 'Has_Children']].mean().round(1))

print("\nTỷ lệ trình độ học vấn theo từng cụm (%):")
print((pd.crosstab(df_customers['Cluster'], df_customers['Education'], normalize='index') * 100).round(1))

print("\nTỷ lệ tình trạng hôn nhân theo từng cụm (%):")
print((pd.crosstab(df_customers['Cluster'], df_customers['Marital_Status'], normalize='index') * 100).round(1))
Kết quả in ra từ thực nghiệm:
Giá trị trung bình định lượng theo từng cụm:
          Age   Income  Total_Spent  Total_Purchases  Has_Children
Cluster
0        47.8  58879.6        747.3             16.8           1.0
1        46.0  74556.7       1345.8             19.0           0.0
2        42.4  34026.0         68.1              5.2           1.0
3        43.3  29041.6        110.2              5.8           0.0

Tỷ lệ trình độ học vấn theo từng cụm (%):
Education  2n Cycle  Basic  Graduation  Master   PhD
Cluster
0               7.0    0.0        52.9    16.6  23.5
1               8.7    0.4        50.8    16.3  23.8
2              10.4    4.7        47.8    16.9  20.2
3              15.4   12.2        49.6    13.0   9.8

Tỷ lệ tình trạng hôn nhân theo từng cụm (%):
Marital_Status  Divorced  Married  Single  Together  Widow
Cluster
0                   11.9     41.1    16.2      26.7    4.1
1                    9.1     34.8    26.6      25.4    4.1
2                   10.2     38.5    22.5      26.6    2.3
3                    9.8     42.3    25.2      18.7    4.1
Bảng thống kê làm rõ cơ chế phân tách của ma trận khoảng cách Gower:
- Trong hàm Gower ở Mục 3.2, biến nhị phân
Has_Childrencó trọng số trên tổng trọng số . Khi hai khách hàng khác nhau về trạng thái con cái, khoảng cách Gower giữa họ lập tức tăng thêm một lượng cố định bằng (lớn hơn mức trung bình của toàn ma trận). Bước nhảy rời rạc này chia tập dữ liệu thành hai nửa tách biệt hoàn toàn theoHas_Children, sau đó tiếp tục phân tầng theo sức mua để tạo thành cấu trúc ma trận :- Nhóm hộ gia đình có con (
Has_Children = 1.0, tổng 1,577 khách hàng, chiếm 71.4%): tách thành Cụm 0 (khá giả, 790 khách, chi tiêu trung bình 747.3 USD, 16.8 lượt mua) và Cụm 2 (tiết kiệm, 787 khách, chi tiêu trung bình 68.1 USD, 5.2 lượt mua). - Nhóm hộ gia đình chưa có con (
Has_Children = 0.0, tổng 631 khách hàng, chiếm 28.6%): tách thành Cụm 1 (thu nhập cao VIP, 508 khách, chi tiêu trung bình 1,345.8 USD, 19.0 lượt mua) và Cụm 3 (thu nhập thấp, 123 khách, chi tiêu trung bình 110.2 USD, 5.8 lượt mua).
- Nhóm hộ gia đình có con (
- Các thông số định lượng của 4 medoid ở Mục 5.1 đều nằm sát mức trung bình của từng cụm tương ứng (chẳng hạn medoid Cụm 1 có tổng chi tiêu 1,291 USD và 19 lượt mua, rất gần với mức trung bình 1,345.8 USD và 19.0 lượt mua của toàn Cụm 1).
5.3. Trực quan hóa các phân khúc khách hàng
Đoạn mã sau vẽ biểu đồ phân tán của 4 cụm khách hàng trên hai mặt phẳng: Thu nhập theo Tổng chi tiêu, và Tổng số lượt mua theo Tổng chi tiêu, với vị trí các medoid được đánh dấu bằng ngôi sao màu đỏ:
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5.0))

colors = ['#2b5c8f', '#d95f02', '#2ca02c', '#7570b3']
cluster_labels = [
    'Cụm 0: Gia đình khá giả (Có con, chi tiêu khá)',
    'Cụm 1: Khách hàng VIP (Chưa con, chi tiêu rất cao)',
    'Cụm 2: Gia đình tiết kiệm (Có con, chi tiêu thấp)',
    'Cụm 3: Nhóm chưa con thu nhập thấp (Chưa con, chi tiêu thấp)'
]

# Đồ thị (a): Thu nhập vs Tổng chi tiêu
for c in range(4):
    sub = df_customers[df_customers['Cluster'] == c]
    ax1.scatter(sub['Income'], sub['Total_Spent'], c=colors[c], label=cluster_labels[c], alpha=0.45, edgecolors='none', s=30)

med_data = df_customers.iloc[med_indices]
ax1.scatter(med_data['Income'], med_data['Total_Spent'], c='#e41a1c', marker='*', s=250, edgecolors='black', linewidth=1.5, label='Medoids đại diện', zorder=5)
ax1.set_xlabel('Thu nhập hàng năm (Income, USD)')
ax1.set_ylabel('Tổng chi tiêu (Total Spent, USD)')
ax1.set_title('(a) Thu nhập vs Tổng chi tiêu')
ax1.legend(loc='upper left', fontsize=8)
ax1.grid(True, linestyle='--', alpha=0.3)

# Đồ thị (b): Tần suất mua sắm vs Tổng chi tiêu
for c in range(4):
    sub = df_customers[df_customers['Cluster'] == c]
    ax2.scatter(sub['Total_Purchases'], sub['Total_Spent'], c=colors[c], label=cluster_labels[c], alpha=0.45, edgecolors='none', s=30)

ax2.scatter(med_data['Total_Purchases'], med_data['Total_Spent'], c='#e41a1c', marker='*', s=250, edgecolors='black', linewidth=1.5, label='Medoids đại diện', zorder=5)
ax2.set_xlabel('Tổng số lượt mua sắm (Total Purchases)')
ax2.set_ylabel('Tổng chi tiêu (Total Spent, USD)')
ax2.set_title('(b) Tần suất mua sắm vs Tổng chi tiêu')
ax2.legend(loc='upper left', fontsize=8)
ax2.grid(True, linestyle='--', alpha=0.3)

plt.tight_layout()
plt.show()
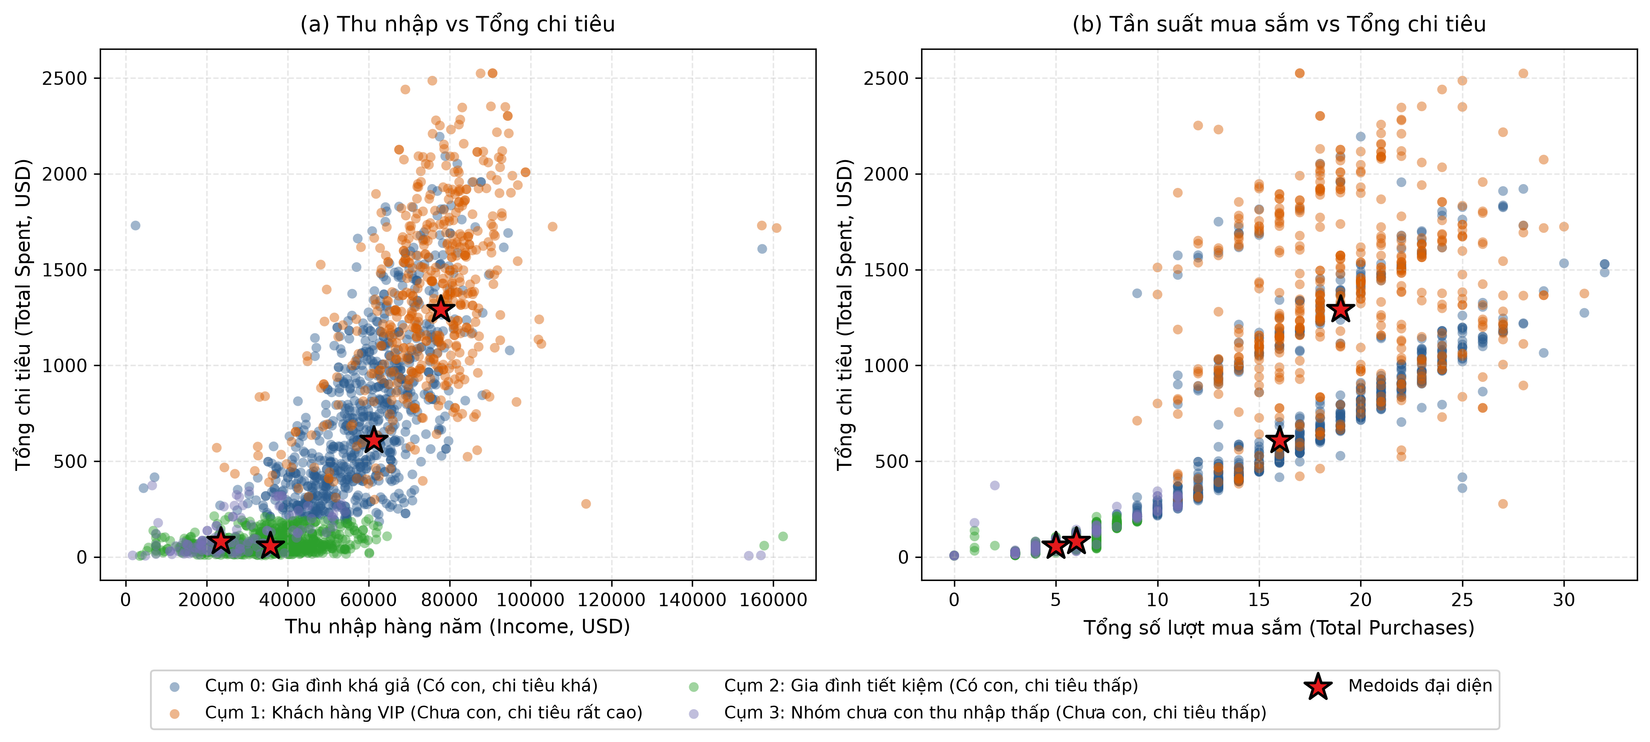
Trên đồ thị (a), Cụm 1 (màu cam) tập trung ở góc trên bên phải với mức thu nhập trên 65,000 USD và chi tiêu vượt 1,000 USD. Cụm 0 (màu xanh dương) phủ vùng trung lưu với mức chi tiêu từ 400 đến 1,000 USD, trong khi hai nhóm chi tiêu thấp (Cụm 2 và Cụm 3) nằm ở dải dưới 200 USD. Trên đồ thị (b), tổng chi tiêu tăng thuận chiều với số lượt mua sắm, và cả 4 ngôi sao medoid đều nằm ngay tại vùng tập trung mật độ cao của từng phân khúc.
6. Tổng kết và lưu ý triển khai
| Độ đo khoảng cách | Ký hiệu / Dạng hàm | Kiểu dữ liệu phù hợp | Đặc tính thực tế |
|---|---|---|---|
| Euclid | Chuẩn | Biến định lượng chuẩn hóa | Phạt nặng độ lệch lớn do bình phương, nhạy cảm với ngoại lai |
| Manhattan | Chuẩn | Biến định lượng | Cộng trực tiếp độ lệch tuyệt đối, giảm ảnh hưởng của ngoại lai |
| Chebyshev | Chuẩn | Biến định lượng | Định hình cụm theo độ lệch lớn nhất trên một thuộc tính đơn lẻ |
| Gower | Dữ liệu hỗn hợp (Số + Danh mục) | Chuẩn hóa theo khoảng biến thiên, hỗ trợ biến đổi log và gán trọng số thuộc tính |
Lưu ý về chi phí bộ nhớ khi mở rộng quy mô
Khi dùng độ đo Gower với chế độ metric='precomputed', người triển khai cần cân nhắc hai yếu tố:
- Dung lượng RAM cho ma trận khoảng cách: Một ma trận lưu kiểu
float64(8 bytes mỗi phần tử) tiêu tốn bytes bộ nhớ. Với , ma trận chiếm khoảng 37.2 MB RAM (rất nhẹ nhàng cho mọi máy tính cá nhân). Tuy nhiên, khi dữ liệu tăng lên khách hàng, ma trận đầy đủ sẽ cần tới 20 GB RAM. Với các bảng dữ liệu hàng trăm nghìn dòng, ta có thể lấy mẫu phân tầng để tìm medoid trên tập mẫu đại diện rồi gán nhãn cho phần dữ liệu còn lại, hoặc chia dữ liệu thành các nhánh lớn theo biến danh mục trước khi phân cụm chi tiết. - Tinh chỉnh trọng số theo mục tiêu nghiệp vụ: Công thức Gower cho phép điều chỉnh trọng số của từng thuộc tính. Tùy vào mục tiêu chiến dịch (chẳng hạn ưu tiên tần suất tương tác hoặc ưu tiên quy mô hộ gia đình), người phân tích có thể thay đổi vector trọng số để định hướng cấu trúc phân khúc mà không cần thay đổi thuật toán lõi.
Nhờ tốc độ thực thi nhanh và khả năng tái sử dụng ma trận khi quét siêu tham số, cơ chế metric='precomputed' sẽ tiếp tục được sử dụng trong các bài viết sau của chuỗi bài khi làm việc với những độ đo đặc thù.
Trong bài viết tiếp theo, chúng ta sẽ chuyển sang bài toán giám sát hệ thống và phát hiện bất thường không giám sát trên dữ liệu chuỗi thời gian telemetry từ cảm biến IoT, sử dụng khoảng cách tới các medoid chuẩn để chấm điểm rủi ro vận hành.
All Rights Reserved
