

Phân Biệt Supervised, Unsupervised Và Reinforcement Learning: Ba Trụ Cột Định Hình Trí Tuệ Nhân Tạo
Khi bắt đầu bước chân vào thế giới Trí tuệ Nhân tạo (AI) và Học máy (Machine Learning), câu hỏi nền tảng mà mọi kỹ sư dữ liệu đều phải trả lời là: "Mô hình học tri thức từ dữ liệu theo cơ chế nào?"
Mặc dù ngày nay chúng ta nghe rất nhiều về GenAI, LLM hay Agentic AI, nhưng cốt lõi của Machine Learning vẫn xoay quanh ba trụ cột kinh điển: Supervised Learning (Học có giám sát), Unsupervised Learning (Học không giám sát) và Reinforcement Learning (Học tăng cường).
Bài viết này mình sẽ giúp bạn bóc tách bản chất của từng phương pháp, đi kèm bài toán thực tế chuyên sâu và bảng so sánh trực quan, dễ dàng ứng dụng vào dự án thực tế. Và nếu như bạn quan tâm đến học AI Engineer thì có thể tìm hiểu thêm.
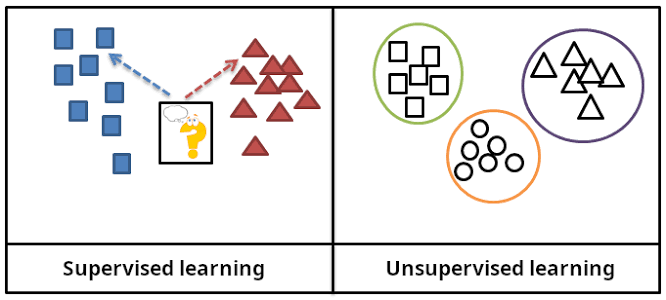
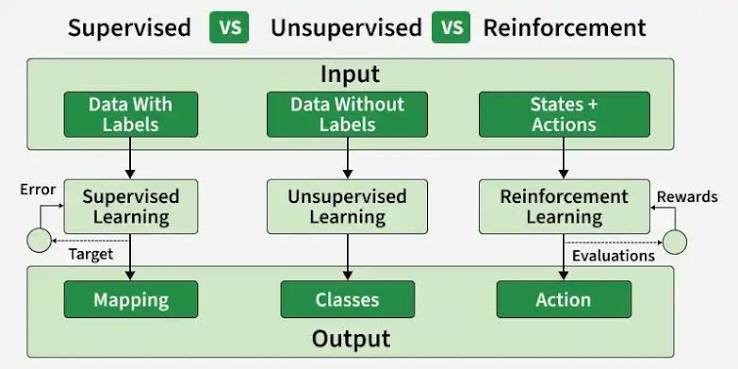
- Supervised Learning (Học có giám sát): Học từ dữ liệu đã được gán nhãn sẵn
(Input X -> Label Y). Mục tiêu là tìm hàm ánh xạ để dự đoán hoặc phân loại chính xác trên dữ liệu chưa từng thấy. - Unsupervised Learning (Học không giám sát): Khám phá cấu trúc ẩn từ dữ liệu hoàn toàn không có nhãn
(Chỉ có Input X). Mục tiêu là tự động gom nhóm (clustering), nén số chiều dữ liệu hoặc phát hiện dị biệt. - Reinforcement Learning (Học tăng cường): Không dựa vào tập dữ liệu tĩnh có sẵn. Mô hình đóng vai trò một tác tử (Agent) học thông qua cơ chế thử và sai khi tương tác liên tục với môi trường nhằm tối đa hóa tổng điểm thưởng tích lũy (Cumulative Reward).
1. Supervised Learning (Học có giám sát)
1.1. Bản chất cơ chế
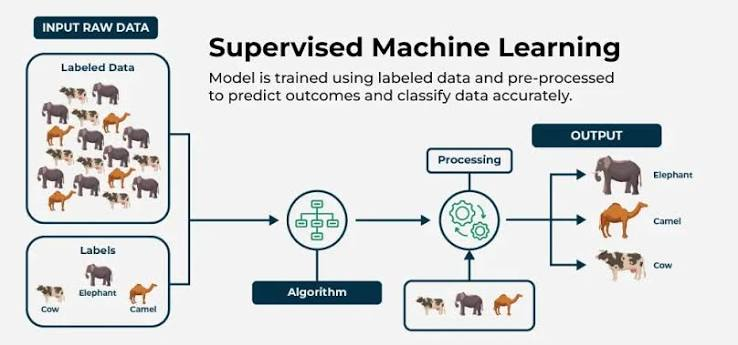
Học có giám sát là phương pháp phổ biến nhất trong các bài toán thương mại hiện nay. Bản chất của phương pháp này là cung cấp cho mô hình một tập dữ liệu huấn luyện gồm các cặp giá trị:
D = {(x1, y1), (x2, y2), ..., (xn, yn)}
Trong đó:
xilà các đặc trưng đầu vào (Features) như tuổi, thu nhập, điểm ảnh.yilà nhãn thực tế mong muốn (Ground Truth / Label) do con người gán sẵn.
Hình ảnh ẩn dụ trực quan: Giống như một học sinh giải đề cương ôn thi có sẵn đáp án ở trang cuối. Học sinh làm bài, đối chiếu với đáp án, tính toán mức độ sai lệch (Loss function), sau đó điều chỉnh lại phương pháp suy luận qua từng vòng cho đến khi đạt điểm số cao.
1.2. Hai nhánh bài toán chính
- Phân loại (Classification): Biến mục tiêu
ylà nhãn rời rạc (Categorical). Mô hình cần phân loại mẫu dữ liệu vào một trong các nhóm cụ thể.- Ví dụ: Email này là Spam hay Hợp lệ? Giao dịch thẻ tín dụng này là Bình thường hay Gian lận?
- Hồi quy (Regression): Biến mục tiêu
ylà một giá trị số liên tục (Continuous Value).- Ví dụ: Dự đoán giá nhà dựa trên diện tích và vị trí; Dự báo doanh thu quý tới của chuỗi bán lẻ.
1.3. Các thuật toán đại diện
- Linear Regression, Logistic Regression
- Support Vector Machines (SVM)
- Random Forest, Gradient Boosting (XGBoost, LightGBM, CatBoost)
- Mạng nơ-ron sâu (CNN cho hình ảnh, RNN / Transformer cho chuỗi)
1.4. Bài toán thực tế: Hệ thống chẩn đoán tổn thương phổi qua ảnh X-quang
- Bối cảnh: Bệnh viện cần hỗ trợ bác sĩ sàng lọc nhanh hàng chục nghìn ca chụp X-quang lồng ngực mỗi tháng để phát hiện sớm dấu hiệu viêm phổi hoặc lao phổi.
- Quy trình triển khai:
- Dữ liệu đầu vào (X): 100,000 bức ảnh X-quang phổi kỹ thuật số.
- Nhãn giám sát (Y): Đội ngũ bác sĩ chuyên khoa chẩn đoán hình ảnh tiến hành khoanh vùng và dán nhãn từng bức ảnh: "0 - Phổi bình thường" hoặc "1 - Tổn thương viêm phổi".
- Huấn luyện: Mô hình mạng nơ-ron tích chập (CNN như ResNet50) đọc qua các bức ảnh, so sánh dự đoán với kết luận của bác sĩ, tự động tinh chỉnh hàng triệu trọng số (weights) thông qua thuật toán lan truyền ngược (Backpropagation) để hạ thấp sai số.
- Kết quả thực tế: Khi bệnh nhân mới chụp X-quang, mô hình quét ảnh trong 0.3 giây và đưa ra cảnh báo nguy cơ với độ chính xác đạt 96%, giúp ưu tiên xử lý các ca bệnh khẩn cấp.
- Điểm nghẽn lớn nhất: Chi phí gán nhãn dữ liệu (Data Labeling) cực kỳ đắt đỏ và bắt buộc phải có chuyên gia đầu ngành thẩm định.
2. Unsupervised Learning (Học không giám sát) – Tự khám phá quy luật ngầm
2.1. Bản chất cơ chế
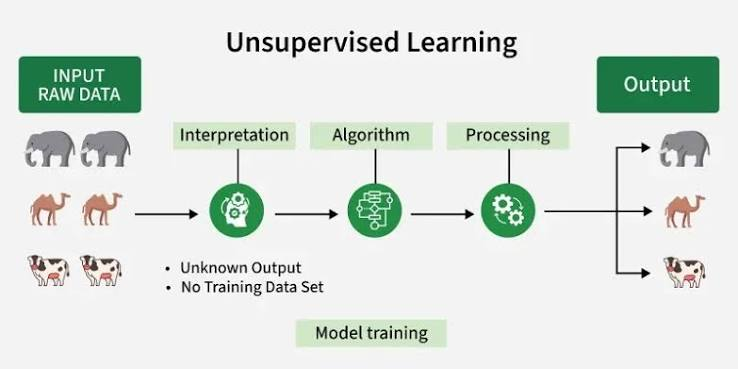
Học không giám sát xử lý bài toán khi dữ liệu thô hoàn toàn không có nhãn:
D = {x1, x2, ..., xn}
Mô hình không có "đáp án đúng" để đối chiếu và không có người thầy nào chỉ bảo. Thay vào đó, thuật toán đo lường khoảng cách toán học, mật độ phân bố và tính tương đồng giữa các điểm dữ liệu để tự động tìm ra cấu trúc ẩn giấu bên trong.
Hình ảnh ẩn dụ trực quan: Cho một đứa trẻ một rổ chứa hàng trăm loại đồ chơi khác nhau nhưng không nói món nào tên là gì. Đứa trẻ sẽ tự động gom các khối lego màu đỏ về một góc, thú bông về một góc và ô tô mô hình về một góc dựa trên sự tương đồng về hình khối và chất liệu.
2.2. Ba nhánh bài toán chính
- Phân cụm (Clustering): Gom các điểm dữ liệu tương đồng vào từng nhóm sao cho khoảng cách giữa các phần tử trong cùng một cụm là nhỏ nhất, và khoảng cách giữa các cụm là lớn nhất.
- Giảm số chiều dữ liệu (Dimensionality Reduction): Nén dữ liệu từ hàng trăm cột đặc trưng xuống còn vài cột cốt lõi mà vẫn giữ lại phần lớn thông tin quan trọng, phục vụ trực quan hóa (data visualization) hoặc giảm tải tính toán.
- Phát hiện dị biệt (Anomaly Detection): Nhận diện những điểm dữ liệu nằm tách biệt hoàn toàn khỏi phân phối chuẩn của số đông.
2.3. Các thuật toán đại diện
- K-Means Clustering, Hierarchical Clustering, DBSCAN
- Principal Component Analysis (PCA), t-SNE, UMAP
- Isolation Forest, Autoencoders (Deep Learning)
2.4. Bài toán thực tế: Phân khúc khách hàng tự động cho sàn E-commerce
- Bối cảnh: Sàn thương mại điện tử có 5 triệu tài khoản hoạt động. Đội ngũ Marketing muốn cá nhân hóa chiến dịch ưu đãi nhưng không thể phân nhóm thủ công từng người.
- Quy trình triển khai:
- Dữ liệu đầu vào (X): Lịch sử giao dịch 12 tháng, giá trị đơn trung bình, tần suất mở app, thời gian mua hàng trong tuần, tỷ lệ trả hàng (hoàn toàn không có nhãn ai là VIP, ai là khách bình dân).
- Huấn luyện: Kỹ sư chuẩn hóa dữ liệu, dùng PCA giảm số chiều rồi áp dụng thuật toán K-Means để gom người dùng thành 4 cụm riêng biệt:
- Cụm 1: Nhóm mua sắm giá trị cao, ít quan tâm khuyến mại, thích mua đồ công nghệ vào cuối tuần.
- Cụm 2: Nhóm mẹ bỉm sữa, mua tã sữa định kỳ vào đầu tháng.
- Cụm 3: Nhóm học sinh - sinh viên, chỉ mở app khi có mã freeship hoặc đợt flash sale ngày đôi.
- Cụm 4: Tài khoản ảo hoặc người dùng ngủ đông hơn 6 tháng.
- Kết quả thực tế: Tự động gửi voucher đồ gia dụng cao cấp cho Cụm 1 và voucher freeship 0 đồng cho Cụm 3, giúp tăng tỷ lệ chuyển đổi đơn hàng lên gấp ba lần.
- Điểm nghẽn lớn nhất: Khó đánh giá độ chính xác tuyệt đối; kết quả phân cụm phụ thuộc nhiều vào cảm quan nghiệp vụ của con người khi diễn giải nhãn cho từng cụm.
3. Reinforcement Learning (Học tăng cường) – "Học qua thử và sai"
3.1. Bản chất cơ chế
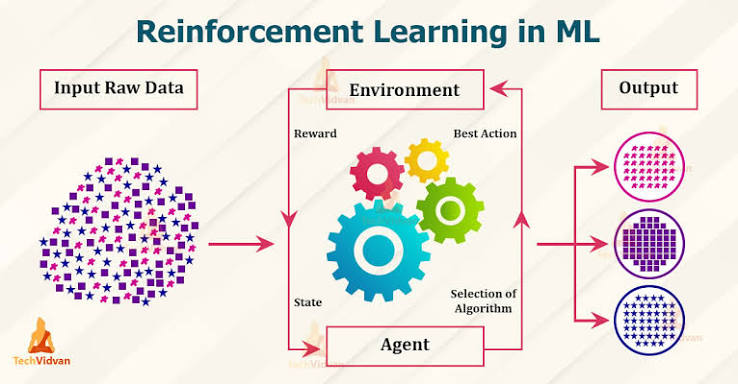
Học tăng cường không sử dụng một tập dữ liệu tĩnh thu thập từ trước. Thay vào đó, nó là một quy trình ra quyết định theo chuỗi thời gian (Markov Decision Process - MDP) bao gồm hai thực thể:
- Tác tử (Agent): Bộ não AI ra quyết định (robot, phần mềm bot).
- Môi trường (Environment): Thế giới xung quanh mà tác tử đang tương tác.
Vòng lặp vận hành như sau:
- Agent quan sát Trạng thái (State - St) của môi trường.
- Agent thực hiện một Hành động (Action - At).
- Môi trường phản hồi bằng một Trạng thái mới (St+1) và gửi kèm tín hiệu Phần thưởng hoặc Hình phạt (Reward / Penalty - Rt).
Mục tiêu tối thượng của Agent là học một chiến lược hành động (Policy) nhằm tối đa hóa tổng điểm thưởng tích lũy trong dài hạn.
Hình ảnh ẩn dụ trực quan: Quá trình huấn luyện một chú chó con. Bạn ra lệnh "Ngồi xuống", nếu chú chó ngồi, bạn thưởng cho nó một miếng snack (+1 điểm). Nếu nó cắn giày của bạn, bạn phạt bằng cách không cho ăn (-1 điểm). Sau hàng trăm lần lặp lại, chú chó tự hiểu ra chuỗi hành vi nào mang lại nhiều phần thưởng nhất.
3.2. Khái niệm then chốt: Đánh đổi giữa Thăm dò và Khai thác (Exploration vs. Exploitation)
- Khai thác (Exploitation): Tiếp tục chọn những hành động mà Agent đã biết chắc chắn sẽ đem lại điểm số cao.
- Thăm dò (Exploration): Chấp nhận thử các hành động mới mẻ chưa từng làm trước đây, chịu rủi ro bị phạt để tìm kiếm cơ hội nhận phần thưởng lớn hơn nữa trong tương lai.
3.3. Các thuật toán đại diện
- Q-Learning, SARSA (Tabular)
- Deep Q-Networks (DQN)
- Policy Gradient, PPO (Proximal Policy Optimization), Actor-Critic (A2C/A3C)
3.4. Bài toán thực tế: Hệ thống kiểm soát làm mát Data Center của Google DeepMind
- Bối cảnh: Hàng trăm nghìn máy chủ tại các trung tâm dữ liệu của Google sinh nhiệt khổng lồ, tiêu tốn hàng triệu USD tiền điện làm mát mỗi năm. Hệ thống van, máy bơm, quạt gió phụ thuộc vào thời tiết bên ngoài và tải máy chủ liên tục thay đổi, con người không thể chỉnh tay tối ưu 24/7.
- Quy trình triển khai:
- Agent: Thuật toán AI của DeepMind.
- Môi trường: Toàn bộ hệ thống làm mát trung tâm dữ liệu.
- Trạng thái (State): Nhiệt độ phòng máy hiện tại, độ ẩm không khí, công suất máy chủ, dự báo thời tiết bên ngoài.
- Hành động (Action): Tăng/giảm tốc độ bơm nước, góc mở của cánh quạt gió, điều chỉnh áp suất luồng khí lạnh.
- Phần thưởng (Reward):
- Điểm dương (+) khi lượng điện năng tiêu thụ giảm xuống mà nhiệt độ máy chủ vẫn duy trì dưới ngưỡng an toàn 25 độ C.
- Điểm phạt nặng (-) nếu bất kỳ cụm máy chủ nào tăng nhiệt vượt ngưỡng báo động đỏ.
- Kết quả thực tế: Sau hàng triệu chu kỳ tự học trong môi trường giả lập và áp dụng thực tế, AI đã giúp Google cắt giảm tới 40% tổng năng lượng điện dùng cho làm mát trung tâm dữ liệu.
- Điểm nghẽn lớn nhất: Rất nguy hiểm nếu thử nghiệm trực tiếp trên môi trường sản xuất thực tế khi mô hình chưa hoàn thiện; đòi hỏi môi trường giả lập (Simulation) cực kỳ chuẩn xác và tốn kém tài nguyên tính toán.
4. Ma trận so sánh toàn diện giữa ba phương pháp
| Tiêu chuẩn so sánh | Supervised Learning (Có giám sát) | Unsupervised Learning (Không giám sát) | Reinforcement Learning (Tăng cường) |
|---|---|---|---|
| Dữ liệu đầu vào | Dữ liệu tĩnh, đầy đủ cặp (Input X, Label Y) | Dữ liệu tĩnh, chỉ có Input X, không có nhãn | Không có dataset tĩnh; dữ liệu sinh ra tuần tự từ tương tác |
| Cơ chế phản hồi | Phản hồi trực tiếp, lập tức từ nhãn đúng/sai | Hoàn toàn không có phản hồi từ bên ngoài | Phản hồi trễ dưới dạng tín hiệu Phần thưởng / Hình phạt (Reward) |
| Mục tiêu chính | Tìm hàm ánh xạ dự đoán nhãn hoặc giá trị mới | Khám phá cấu trúc ẩn, gom nhóm hoặc giảm số chiều | Tìm chiến lược hành động tối ưu để đạt tổng thưởng tối đa |
| Môi trường hoạt động | Dữ liệu đóng, ngoại tuyến (Offline Dataset) | Dữ liệu đóng, ngoại tuyến (Offline Dataset) | Môi trường tương tác động (Game, Simulator, Robot) |
| Thách thức lớn nhất | Chi phí gán nhãn rất đắt, dễ bị Overfitting | Khó đo lường độ chính xác, phụ thuộc cảm quan | Không gian trạng thái quá lớn, bài toán cân bằng Exploration vs Exploitation |
| Ứng dụng điển hình | Lọc email spam, phân loại ảnh bệnh lý, chấm điểm tín dụng | Phân khúc khách hàng, gợi ý mặt hàng mua kèm, nén dữ liệu | Xe tự hành, AI chơi game (AlphaGo), điều khiển cánh tay robot |
5. Xu hướng kết hợp hiện đại: Khi ba phương pháp giao thoa
Trong kỷ nguyên GenAI hiện nay, các mô hình tiên tiến hiếm khi đứng độc lập mà là sự hòa trộn của cả ba phương pháp:
1. Semi-Supervised Learning (Học bán giám sát)
Khi bạn sở hữu 1 triệu bức ảnh sản phẩm nhưng chỉ đủ ngân sách thuê người gán nhãn cho 10,000 ảnh. Ta dùng Unsupervised để học biểu diễn cấu trúc của toàn bộ 1 triệu ảnh, sau đó dùng 10,000 ảnh có nhãn của Supervised để tinh chỉnh phân loại cuối cùng.
2. Quy trình huấn luyện các mô hình LLM (như ChatGPT, Claude)
- Giai đoạn 1 - Self-Supervised Pre-training: Mô hình đọc hàng nghìn tỷ từ trên Internet để tự đoán từ tiếp theo (bản chất mở rộng của học không giám sát trên quy mô lớn).
- Giai đoạn 2 - Supervised Fine-Tuning (SFT): Huấn luyện có giám sát với hàng chục nghìn cặp câu hỏi - trả lời mẫu do các chuyên gia biên soạn cẩn thận.
- Giai đoạn 3 - RLHF (Reinforcement Learning from Human Feedback): Con người chấm điểm câu trả lời của AI. Thuật toán Học tăng cường (như PPO) lấy điểm số đó làm tín hiệu Reward để uốn nắn mô hình luôn trả lời an toàn, trung thực và hữu ích.
6. Checklist: Khi nào nên sử dụng phương pháp nào?
Trước khi bắt tay vào một bài toán Machine Learning thực tế, hãy đi theo cây quyết định sau:
-
Bạn đã có nhãn mục tiêu rõ ràng và đủ ngân sách/thời gian gán nhãn chưa?
- Có: Chọn ngay Supervised Learning (đây luôn là lựa chọn ổn định nhất, dễ đo lường nhất).
- Chưa/Không có: Đi tiếp sang câu 2.
-
Mục tiêu của bạn là thấu hiểu cấu trúc dữ liệu hay muốn hệ thống tự động đưa ra chuỗi hành động?
- Muốn hiểu dữ liệu: Dùng Unsupervised Learning (để gom cụm khách hàng, lọc dữ liệu nhiễu hoặc trực quan hóa dữ liệu lớn).
- Muốn hệ thống tự ra quyết định liên tục: Đi tiếp sang câu 3.
-
Bài toán có thể xây dựng được môi trường giả lập (Simulator) cho phép thử và sai hàng triệu lần an toàn không?
- Có: Hãy đầu tư vào Reinforcement Learning (phù hợp cho giao dịch tài chính thuật toán, tối ưu tuyến đường logistics, điều khiển tự động).
- Không: Hãy tìm cách chuyển đổi bài toán về dạng Supervised hoặc dùng các hệ luật nghiệp vụ (Rule-based) kết hợp để đảm bảo an toàn vận hành.
Lời kết
Supervised, Unsupervised và Reinforcement Learning không loại trừ nhau mà bổ trợ cho nhau trong bức tranh tổng thể của Khoa học Dữ liệu. Hiểu sâu bản chất dữ liệu đầu vào và mục tiêu nghiệp vụ sẽ giúp bạn chọn đúng công cụ, tiết kiệm tối đa tài nguyên phần cứng và chi phí triển khai cho doanh nghiệp.
Nếu bạn có góc nhìn hay trường hợp ứng dụng thực tế nào thú vị, hãy để lại bình luận phía dưới để cùng thảo luận nhé!
All rights reserved
