PaddleOCR-VL-1.5 Architecture
PaddleOCR-VL-1.5 là một mô hình VLM nhỏ gọn 0.9B tham số, được thiết kế cho bài toán phân tích tài liệu thực tế, đặc biệt trong các trường hợp ảnh bị nghiêng, cong vênh, nhiễu hoặc có bố cục phức tạp.
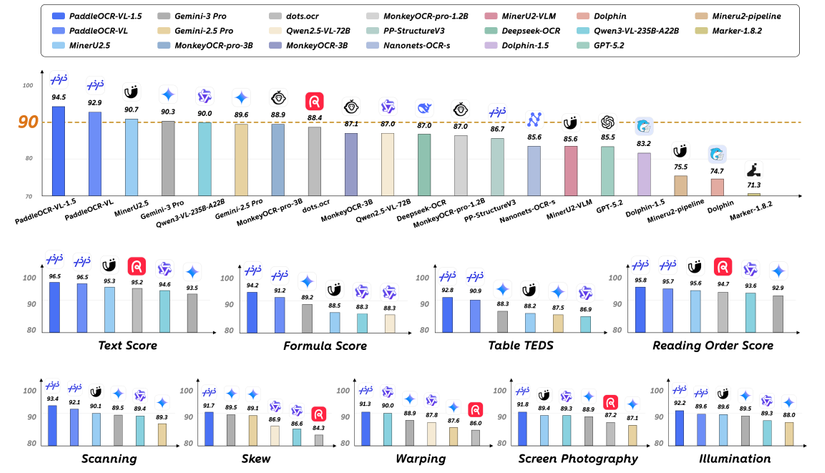
- PaddleOCR-VL-1.5 là một bước tiến quan trọng trong lĩnh vực phân tích tài liệu, mô hình thiết lập tiêu chuẩn mới (SOTA) với độ chính xác 94,5% trên benchmark OmniDocBench v1.5. Điểm đột phá cốt lõi của phiên bản này nằm ở khả năng xử lý các biến dạng vật lý trong thế giới thực—như độ nghiêng cực hạn, cong vênh trang giấy, nhiễu ảnh chụp màn hình và ánh sáng không đều—thông qua công cụ layout PP-DocLayoutV3 và bộ dữ liệu đánh giá Real5-OmniDocBench.
- Ngoài việc cải thiện độ chính xác phân tích, mô hình còn mở rộng năng lực sang các tác vụ mới như nhận diện con dấu (seal recognition) và định vị văn bản (text spotting), tạo nền tảng dữ liệu trung thực cao cho các hệ thống Retrieval-Augmented Generation (RAG) và các ứng dụng Mô hình Ngôn ngữ Lớn (LLM).
I. Kiến trúc tổng quan
Mô hình PaddleOCR-VL-1.5-0.9B đi theo cấu trúc điển hình của các mô hình đa phương thức hiện đại:
- Native Resolution Visual Encoder: Bộ mã hóa hình ảnh giữ nguyên độ phân giải gốc. Điều này giúp model không làm mất chi tiết của các chữ cái nhỏ hoặc ký hiệu phức tạp.
💡 Cải tiến cốt lõi của NaViT (Native Resolution ViT) là khả năng xử lý hình ảnh ở độ phân giải và tỷ lệ khung hình gốc, thay vì phải thay đổi kích thước (resize) hoặc cắt xén (crop) về khung hình vuông cố định như các mô hình Vision Transformer (ViT) truyền thống.
Dưới đây là các cải tiến kỹ thuật chính (mọi người có thể tham khảo paper gốc tại đây):
- Patch n' Pack: Đóng gói mảnh ảnh từ nhiều hình khác nhau vào một chuỗi duy nhất, tăng hiệu suất xử lý gấp 5 lần.
- Mã hóa vị trí phân số (Fractional Embeddings): Sử dụng tọa độ tương đối (x,y từ 0-1) để hiểu mọi kích thước và tỷ lệ khung hình.
- Masked Attention: Cơ chế mặt nạ giúp xử lý nhiều ảnh cùng lúc nhưng vẫn đảm bảo thông tin không bị nhiễu lẫn nhau.
- Token Dropping động: Linh hoạt loại bỏ các phần dữ liệu thừa để tăng tốc độ mà vẫn giữ được chi tiết quan trọng.
- Hiệu quả: Tiết kiệm gấp 4 lần tài nguyên tính toán; cho phép tùy chỉnh cân bằng giữa tốc độ và độ chính xác khi sử dụng.
-
Adaptive MLP Connector: Chuyển đổi các đặc trưng do Vision Encoder trích xuất thành chuỗi visual tokens có cùng không gian biểu diễn với LLM, giúp thông tin hình ảnh có thể được đưa trực tiếp vào decoder cùng với instruction của từng tác vụ.
-
Lightweight ERNIE-4.5-0.3B: Đây là một phiên bản siêu nhẹ của mô hình ngôn ngữ ERNIE 4.5 (chỉ có 0.3 tỷ tham số), mô hình sẽ tiếp nhận visual tokens từ Connector cùng với instruction của từng tác vụ, sau đó sinh đầu ra tương ứng như văn bản OCR, bảng, công thức, Markdown hoặc thông tin vị trí.
II. Luồng tổng quát cách hoạt động
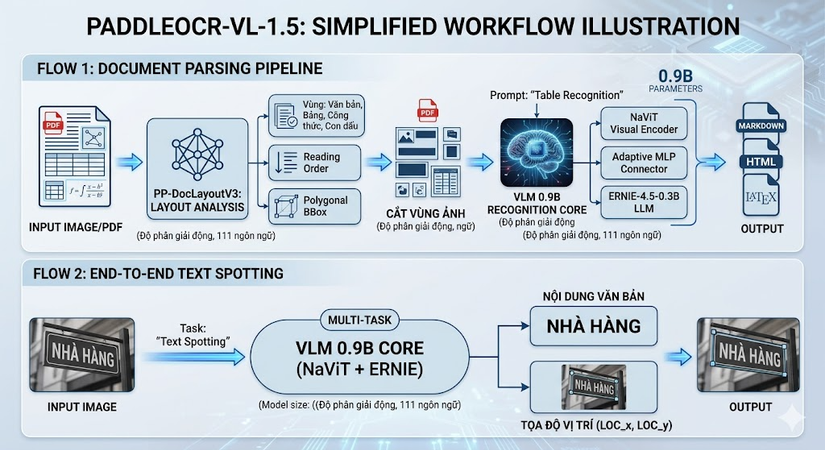
- Đầu vào: Hệ thống có thể tiếp nhận nhiều dạng tài liệu như ảnh scan, ảnh chụp từ điện thoại hoặc các trang được chuyển đổi từ PDF. Trong thực tế, đầu vào có thể gặp nhiều vấn đề như ảnh bị nghiêng, mờ, cong vênh, ánh sáng không đều hoặc nhiễu do chụp màn hình.
- PP-DocLayoutV3: Đầu tiên, tài liệu được phân tích để xác định các thành phần bố cục như text, title, table, formula, image,.... Ngoài bounding box thông thường, model còn hỗ trợ biểu diễn vùng bằng nhiều điểm để bám sát tốt hơn các nội dung bị nghiêng hoặc biến dạng. Đồng thời, PP-DocLayoutV3 xác định reading order, giúp sắp xếp các vùng theo đúng thứ tự đọc trước khi chuyển sang bước nhận dạng nội dung.
- Điều phối Prompt (Prompt Routing): Dựa trên loại của từng vùng mà PP-DocLayoutV3 đã phát hiện, hệ thống lựa chọn instruction phù hợp để gửi cùng vùng ảnh vào PaddleOCR-VL-1.5. Ví dụ, vùng Table sử dụng
"Table Recognition:", vùng Formula sử dụng"Formula Recognition:", trong khi các vùng văn bản, biểu đồ hoặc con dấu sẽ sử dụng instruction tương ứng. Nhờ đó, cùng một VLM có thể thực hiện nhiều tác vụ nhận dạng khác nhau mà không cần sử dụng một model riêng cho từng loại nội dung.
💡 Đột phá kỹ thuật trong Text Spotting
- Đại diện tứ giác 4 điểm (TL, TR, BR, BL): Thay thế khung hình chữ nhật 2 điểm truyền thống để ôm sát các dòng chữ nghiêng, xoay hoặc có hình dạng bất thường.
- Hệ thống Token tọa độ: Sử dụng bộ từ vựng đặc biệt từ <LOC_0> đến <LOC_1000> để mã hóa tọa độ chuẩn hóa.
- Định dạng đầu ra: Văn bản kết hợp trực tiếp với 8 token vị trí (Ví dụ: DREAM <LOC_253>...<LOC_330>), giúp AI tự "vẽ" lại vị trí ngay trong câu trả lời.
📌 Model decoder ERNIE-4.5-0.3B (Transformer Decoder-only).
- Cơ chế thông minh: Chưng cất tri thức từ ERNIE 4.5 Huge; Tối ưu hóa bằng GRPO; Tích hợp Knowledge Graph.
- Đặc điểm luồng: Xử lý đa phương thức (Multi-modal), nhận Visual Tokens qua lớp Bridge, sinh dữ liệu văn bản kèm tọa độ không gian (LOC tokens) trong một lần quét (End-to-end).
- Ưu thế: Cực nhẹ nhưng xử lý cấu trúc tài liệu (Markdown, JSON) cực kỳ ổn định nhờ học chuyên sâu về Instruction Fine-tuning.
💡Điểm đặc biệt: Luồng suy luận không đồng bộ
- Mô hình này không chạy tuần tự từng trang một mà sử dụng Pipeline đa luồng. Trong khi VLM đang nhận dạng trang 1, thì bộ phận phân tích bố cục đã bắt đầu xử lý trang 2, giúp tốc độ xử lý thực tế nhanh hơn nhiều so với các mô hình truyền thống.
III. Luồng chi tiết
Bước 1: Input
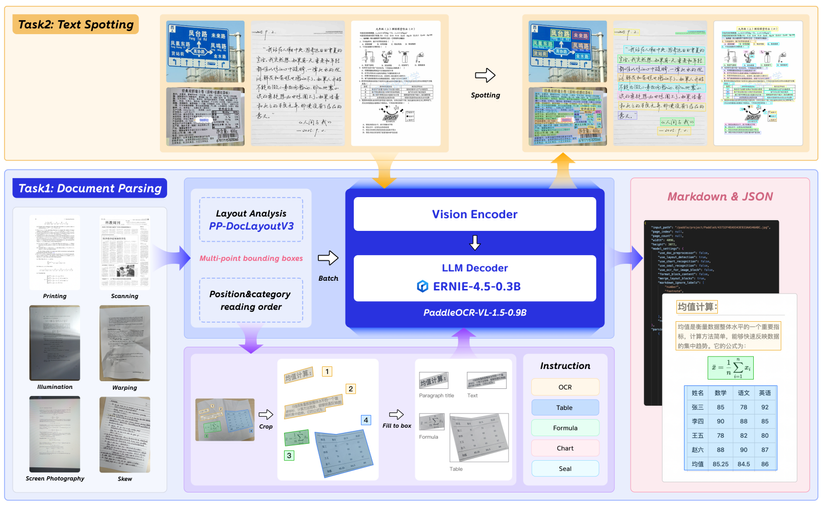
PaddleOCR-VL-1.5 được thiết kế để xử lý nhiều dạng tài liệu trong điều kiện thực tế, từ ảnh scan, ảnh chụp bằng điện thoại cho tới các trang được chuyển đổi từ PDF. Đầu vào có thể chứa nhiều dạng suy giảm chất lượng khác nhau:
- Printing / Scanning: Tài liệu in hoặc scan thông thường.
- Illumination: Ảnh bị lóa sáng, bóng đổ hoặc ánh sáng không đồng đều.
- Warping / Skew: Trang giấy bị cong, biến dạng phối cảnh hoặc nghiêng.
- Screen Photography: Ảnh chụp từ màn hình, có thể xuất hiện nhiễu Moiré hoặc suy giảm độ nét.
Bước 2: Phân tích bố cục với PP-DocLayoutV3
Ảnh tài liệu trước tiên được đưa qua PP-DocLayoutV3 để xác định cấu trúc tổng thể của trang. Khối này thực hiện ba nhiệm vụ chính:
- Layout Analysis: Phát hiện và phân loại các thành phần như text, title, table, formula, image,...
- Multi-point Bounding Box: Biểu diễn vùng nội dung bằng nhiều điểm hoặc polygon, giúp mô tả chính xác hơn các vùng bị nghiêng, cong hoặc biến dạng so với bounding box hình chữ nhật thông thường.
- Reading Order: Xác định thứ tự đọc giữa các vùng trên trang, từ đó tái tạo lại luồng nội dung theo đúng cấu trúc tự nhiên của tài liệu.
Kết quả của bước này cung cấp cả vị trí, loại phần tử và thứ tự đọc để phục vụ cho các bước nhận dạng phía sau.
Bước 3: Crop và chuẩn hóa từng vùng
Dựa trên kết quả layout, từng vùng nội dung được tách riêng khỏi trang gốc.
Ví dụ:
- Vùng văn bản được crop thành một ảnh riêng.
- Vùng bảng được tách để thực hiện nhận dạng cấu trúc bảng.
- Vùng công thức được đưa sang tác vụ nhận dạng công thức.
Các vùng sau đó được chuẩn hóa về dạng đầu vào phù hợp trước khi chuyển sang PaddleOCR-VL-1.5. Việc xử lý theo từng region giúp VLM tập trung vào nội dung cần nhận dạng thay vì phải xử lý toàn bộ trang cùng lúc.
Bước 4: Nhận dạng bằng PaddleOCR-VL-1.5-0.9B
Mỗi vùng ảnh được đưa vào VLM cùng với instruction tương ứng với loại nội dung đã được PP-DocLayoutV3 xác định.
Bên trong model:
- Vision Encoder trích xuất đặc trưng thị giác từ vùng ảnh.
- Adaptive MLP Connector chuyển các đặc trưng này thành visual tokens phù hợp với không gian biểu diễn của LLM.
- ERNIE-4.5-0.3B tiếp nhận visual tokens cùng instruction và thực hiện quá trình autoregressive decoding để sinh kết quả.
Prompt được lựa chọn theo từng loại tác vụ, ví dụ:
- Table → Table Recognition
- Formula → Formula Recognition
- Text → OCR / Text Recognition
- Chart → Chart Recognition
- Seal → Seal Recognition
Nhờ cơ chế này, cùng một VLM có thể đảm nhiệm nhiều loại nhận dạng khác nhau mà không cần xây dựng một model riêng cho từng thành phần tài liệu.
Bước 5: Tổng hợp kết quả theo từng nhiệm vụ
PaddleOCR-VL-1.5 hỗ trợ hai hướng xử lý chính:
Task 1: Document Parsing
Ở chế độ Document Parsing, hệ thống kết hợp:
- PP-DocLayoutV3: cung cấp vị trí, loại phần tử và reading order.
- PaddleOCR-VL-1.5: nhận dạng nội dung bên trong từng vùng.
Các kết quả sau đó được ghép lại theo cấu trúc của trang để tái tạo tài liệu dưới dạng có cấu trúc như Markdown hoặc JSON. Văn bản được giữ đúng thứ tự đọc, bảng được khôi phục cấu trúc và công thức có thể được biểu diễn dưới dạng LaTeX.
Task 2: Text Spotting
Text Spotting tập trung vào việc đồng thời phát hiện vị trí và nhận dạng nội dung văn bản trong ảnh.
Thay vì chỉ trả về chuỗi ký tự, model có thể sinh cả nội dung văn bản và thông tin tọa độ tương ứng. Nhờ đó, hệ thống có thể xử lý các trường hợp ngoài tài liệu truyền thống như biển báo, nhãn sản phẩm, ảnh chụp thực tế hoặc các vùng chữ có hướng và hình dạng phức tạp.
💡 Có thể hiểu ngắn gọn toàn bộ pipeline như sau:
- Input → PP-DocLayoutV3 → Region Detection & Reading Order → Crop → Task-specific Prompt → PaddleOCR-VL-1.5 → Structured Output
IV. Kết luận
PaddleOCR-VL-1.5 cho thấy một hướng tiếp cận hiệu quả cho Document AI khi kết hợp PP-DocLayoutV3 với một VLM 0.9B nhỏ gọn, từ đó vừa xử lý tốt bố cục, vừa nhận dạng nội dung trong nhiều điều kiện tài liệu thực tế. Nhờ khả năng hỗ trợ nhiều tác vụ như OCR, bảng, công thức, con dấu và text spotting, mô hình phù hợp để xây dựng pipeline Document Parsing và làm đầu vào có cấu trúc cho các hệ thống RAG hoặc LLM phía sau.
Tài liệu tham khảo:
- https://huggingface.co/PaddlePaddle/PP-DocLayoutV3
- https://huggingface.co/PaddlePaddle/PaddleOCR-VL-1.5
- https://github.com/PaddlePaddle/PaddleOCR/tree/main/configs/kie/layoutlm_series
- https://docs.vllm.ai/projects/recipes/en/latest/PaddlePaddle/PaddleOCR-VL.html#offline-inference-using-vllm-combined-with-pp-doclayoutv2
All rights reserved