0

Neural Network Fundamental 5: Back Propagation Proof

Bài trước tôi đã trình bày các công thức của back propagation trong bài này tôi sẽ chứng minh các công thức đó

I. Proof d\mathbf{z}^{[L]} = \hat \mathbf{y} - \mathbf{y}

Trước hết ta chứng minh cho trường hợp chỉ 1 training example. Ta sẽ tính đạo hàm riêng đối với zc[L]z^{[L]}_c (phần từ thứ c của output z, sau khi áp dụng hàm softmax) của hàm loss là −logf(x)y-logf(x)_y (đọc thêm ở bài 3, phân biệt y viết thường và y\mathbf{y} viết đậm: y là số thứ tự của phần tử mà vector y\mathbf{y} có giá trị là 1). Trông các bước có vẻ phức tạp nhưng nếu theo dõi từng bước một bạn sẽ thấy cũng khá dễ hiểu và đẹp.

∂−logf(x)y∂zc[L]=∂−log(softmax(z[L])y)∂zc[L]\dfrac{\partial-logf(x)_y}{\partial z^{[L]}_c} = \dfrac{\partial -log(softmax(z^{[L]})_y)}{\partial z^{[L]}_c}

=∂−log(ezy[L]∑iezi[L])∂zc[L]\qquad\qquad \qquad=\dfrac{\partial -log(\dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}}})}{\partial z^{[L]}_c}

=−∑iezi[L]ezy[L]∂ezy[L]∑iezi[L]∂zc[L]\qquad\qquad \qquad= -\dfrac{\sum_i{e^{z^{[L]}_i}}}{e^{z^{[L]}_y}} \dfrac{\partial \dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}}}}{\partial z^{[L]}_c}

Đến đây để tính đạo hàm riêng của ∂ezy[L]∑iezi[L]∂zc[L]\dfrac{\partial \dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}}}}{\partial z^{[L]}_c} ta áp dụng quy tắc tìm đạo hàm riêng của g(x)h(x)\dfrac{g(x)}{h(x)}

∂g(x)h(x)∂x=∂g(x)∂x1h(x)−g(x)h2(x)∂h(x)∂x\qquad\qquad\qquad\qquad\dfrac{\partial\dfrac{g(x)}{h(x)}}{\partial x}=\dfrac{\partial g(x)}{\partial x} \dfrac{1}{h(x)} - \dfrac{g(x)}{h^2(x)}\dfrac{\partial h(x)}{\partial x}

Nên ta có

∂−logf(x)y∂zc[L]=−∑iezi[L]ezy[L](∂ezy[L]∂zc[L]1∑iezi[L]−ezy[L]∑iezi[L]∑iezi[L]∂∑iezi[L]∂zc[L])\dfrac{\partial-logf(x)_y}{\partial z^{[L]}_c} = -\dfrac{\sum_i{e^{z^{[L]}_i}}}{e^{z^{[L]}_y}} (\dfrac{\partial e^{z^{[L]}_y}}{\partial z^{[L]}_c }\dfrac{1}{\sum_i{e^{z^{[L]}_i}}} - \dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}} \sum_i{e^{z^{[L]}_i}}} \dfrac{\partial \sum_i{e^{z^{[L]}_i}}}{\partial z^{[L]}_c})

=−∑iezi[L]ezy[L](1(c=y)ezc[L]1∑iezi[L]−ezy[L]∑iezi[L]∑iezi[L]ezc[L]\qquad\qquad \qquad=-\dfrac{\sum_i{e^{z^{[L]}_i}}}{e^{z^{[L]}_y}} (1_{(c = y)}e^{z^{[L]}_c}\dfrac{1}{\sum_i{e^{z^{[L]}_i}}} - \dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}} \sum_i{e^{z^{[L]}_i}}} e^{z^{[L]}_c} 1(c=y)\qquad\mathbb1_{(c = y)} là hàm indicator trả về 1 nếu c == y và trả về 0 nếu y ≠\ne c

=−∑iezi[L]ezy[L](1(c=y)ezc[L]∑iezi[L]−ezy[L]∑iezi[L]ezc[L]∑iezi[L]\qquad\qquad \qquad=-\dfrac{\sum_i{e^{z^{[L]}_i}}}{e^{z^{[L]}_y}} (1_{(c = y)}\dfrac{e^{z^{[L]}_c}}{\sum_i{e^{z^{[L]}_i}}} - \dfrac{e^{z^{[L]}_y}}{\sum_i{e^{z^{[L]}_i}}} \dfrac{e^{z^{[L]}_c}}{\sum_i{e^{z^{[L]}_i}}}

=−1softmax(z[L])y(1(c=y)softmax(z[L])c−softmax(z[L])ysoftmax(z[L])c)\qquad\qquad \qquad=-\dfrac{1}{softmax(z^{[L]})_y} (1_{(c = y)}softmax(z^{[L]})_c - softmax(z^{[L]})_ysoftmax(z^{[L]})_c)

=−(1(c=y)−softmax(z[L])c)\qquad\qquad \qquad= -(1_{(c = y)} - softmax(z^{[L]})_c)

=−(1(c=y)−y^c)\qquad\qquad \qquad= -(1_{(c = y)} - \hat y_c)

=y^c−1(c=y)\qquad\qquad \qquad= \hat y_c - 1_{(c = y)}

Do đó nếu đạo hàm riêng cả vector z[L]z^{[L]} thì

∂−logf(x)y∂z[L]=y^−y\dfrac{\partial-logf(x)_y}{\partial \mathbf{z^{[L]}}} = \mathbf{\hat y} - \mathbf{y} \qquad hay \qquad d\mathbf{z}^{[L]} = \hat \mathbf{y} - \mathbf{y}


II. Proof da[l−1]=W[l]Tdz[l]d\mathbf a^{[l-1]} = W^{[l]T} d\mathbf z^{[l]}

Giả sử ta đã tính được đạo hàm riêng của z\mathbf z ở lớp thứ ll làm sao ta có thể tính tiếp đạo hàm riêng a\mathbf a ở lớp l−1l - 1? Ta nhắc lại phần tử thứ i của z[l]\mathbf z^{[l]} được tính từ a[l−1]\mathbf a^{[l - 1]} như sau

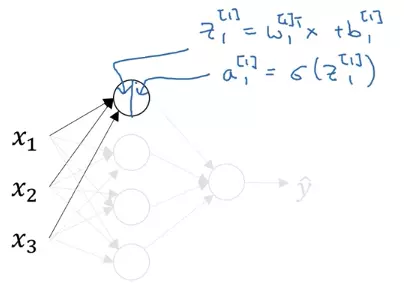
zi[l]=∑jWi,j[l]aj[l−1]+bi[l]\mathbf z^{[l]}_i = \sum_j{W^{[l]}_{i,j}} \mathbf a^{[l - 1]}_j + \mathbf b^{[l]}_i \qquad (Tích vector của row thứ i của matrix W[l]W^{[l]} và vector a[l−1]+\mathbf a^{[l - 1]} + phần tử thứ i của vector bias b[l]b^{[l]})

\qquad\qquad\qquad\qquad\qquad\qquad\qquad\qquad(Trong ảnh thay x bằng a)

Ta thấy mỗi phần từ aj[l−1]\mathbf a^{[l - 1]}_j đều đóng vai trò vào việc tính toán từng phần tử zi[l]\mathbf z^{[l]}_i mà ta biết hàm loss function là hàm số của z[l]\mathbf z^{[l]}, đã biết được đạo hàm riêng của z[l]\mathbf z^{[l]}, điều đó gợi ý ta sử dụng chain rule

Chain rule Nếu hàm số f(a)f(a) là hàm số của các hàm số gi(a)g_i(a) thì ∂f(a)∂a=∑i∂f(a)∂gi(a)∂gi(a)∂a\dfrac{\partial f(a)}{\partial a} = \sum_i{\dfrac{\partial f(a)}{\partial g_i(a)}\dfrac{\partial g_i(a)}{\partial a}}

Dùng chain rule ta set f(a)f(a) là loss function −logf(x)y-logf(x)_y, gi(a)g_i(a) là zi[l]\mathbf z^{[l]}_i còn a là ac[l−1]\mathbf a^{[l - 1]}_c, ta tính đạo hàm riêng đối với phần tử thứ c của a[l−1]\mathbf a^{[l - 1]}

∂−logf(x)y∂ac[l−1]=∑i∂−logf(x)y∂zi[l]∂zi[l]∂ac[l−1](1)\dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l - 1]}_c} = \sum_i{\dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} \dfrac{\partial \mathbf z^{[l]}_i}{\partial \mathbf a^{[l - 1]}_c}} \qquad (1)

Do zi[l]=∑jWi,j[l]aj[l−1]+bi[l]\mathbf z^{[l]}_i = \sum_j{W^{[l]}_{i,j}} \mathbf a^{[l - 1]}_j + b^{[l]}_i nên ∂zi[l]∂ac[l−1]=Wi,c[l]\dfrac{\partial \mathbf z^{[l]}_i}{\partial \mathbf a^{[l - 1]}_c} = W^{[l]}_{i, c} thay vào (1)(1)

∂−logf(x)y∂ac[l−1]=∑i∂−logf(x)y∂zi[l]Wi,c[l]\dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l - 1]}_c} = \sum_i{\dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} W^{[l]}_{i, c}} =\qquad\qquad\qquad= Tích của vector dz[l]d\mathbf z^{[l]} và cột thứ i của matrix W[l]W^{[l]}

Do đó nếu đạo hàm riêng cả vector a[l−1]\mathbf a^{[l - 1]} thì

∂−logf(x)y∂a[l−1]=W[l]T∂−logf(x)y∂z[l]\dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l - 1]}} = W^{[l]T} \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}}\qquad hay da[l−1]=W[l]Tdz[l]\qquad d\mathbf a^{[l-1]} = W^{[l]T} d\mathbf z^{[l]}


III. Proof $dW^{[l]} = d\mathbf z^{[l]} \mathbf a^{[l - 1]T} $

Như đã nói ở phần trên, công thức liên hệ giữa lớp l−1l - 1 và lớp ll là

zi[l]=∑jWi,j[l]aj[l−1]+bi[l]\mathbf z^{[l]}_i = \sum_j{W^{[l]}_{i,j}} \mathbf a^{[l - 1]}_j + \mathbf b^{[l]}_i \qquad

Để ý thấy Wi,j[l]W^{[l]}_{i,j} chỉ đóng góp cho biểu thức của zi[l]\mathbf z^{[l]}_i mà không xuất hiện trong các phẩn tử khác của z[l]\mathbf z^{[l]}, ta áp dụng chain rule để tính đạo hàm riêng của cost function đối với Wi,j[l]W^{[l]}_{i,j}

$\dfrac{\partial-logf(x)y}{\partial W^{[l]}{i,j}} = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} \dfrac{\partial \mathbf z^{[l]}i}{\partial W^{[l]}{i,j}} $

=∂−logf(x)y∂zi[l]aj[l−1]\qquad\qquad\qquad = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} \mathbf a^{[l - 1]}_j

Do đó nếu đạo hàm riêng cả matrix W[l]W^{[l]} thì

∂−logf(x)y∂W[l]=∂−logf(x)y∂z[l]a[l−1]T\dfrac{\partial-logf(x)_y}{\partial W^{[l]}} = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}}\mathbf a^{[l - 1]T}\qquad hay dW[l]=dz[l]a[l−1]T\qquad dW^{[l]} = d\mathbf z^{[l]} \mathbf a^{[l - 1]T} \qquad (Phần tử thứ i, j của W[l]W^{[l]} là Wi,j[l]W^{[l]}_{i,j} bằng phần tử thứ i của dz[l]d\mathbf z^{[l]} nhân với phần tử thứ j của a[l−1]\mathbf a^{[l - 1]})


IV. Proof db[l]=dz[l]d\mathbf b^{[l]} = d\mathbf z^{[l]}

Nhắc lại công thức liên hệ giữa lớp l−1l - 1 và lớp ll

zi[l]=∑jWi,j[l]aj[l−1]+bi[l]\mathbf z^{[l]}_i = \sum_j{W^{[l]}_{i,j}} \mathbf a^{[l - 1]}_j + \mathbf b^{[l]}_i \qquad

bi[l]b^{[l]}_i chỉ đóng góp cho biểu thức của zi[l]z^{[l]}_i mà không xuất hiện trong các phẩn tử khác của z[l]\mathbf z^{[l]}, ta áp dụng chain rule để tính đạo hàm riêng của cost function đối với phần tử thứ i của b[l]\mathbf b^{[l]}

$\dfrac{\partial-logf(x)_y}{\partial \mathbf b^{[l]}_i} = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} \dfrac{\partial \mathbf z^{[l]}_i}{\partial\mathbf b^{[l]}_i} $

=∂−logf(x)y∂zi[l]×1\qquad\qquad\qquad = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} \times 1

Do đó nếu đạo hàm riêng cả vector b[l]\mathbf b^{[l]} thì

∂−logf(x)y∂b[l]=∂−logf(x)y∂z[l]\dfrac{\partial-logf(x)_y}{\partial\mathbf b^{[l]}} = \dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}}\qquad hay db[l]=dz[l]d\mathbf b^{[l]} = d\mathbf z^{[l]}


V Proof dz[l]=da[l]∗g[l]′(z[l])d\mathbf z^{[l]} = d\mathbf a^{[l]} * g^{[l]'}(\mathbf z^{[l]})

Trong lớp ll công thức liên hệ giữa zi[l]\mathbf z^{[l]}_i và ai[l]\mathbf a^{[l]}_i là

ai[l]=g[l](zi[l])\mathbf a^{[l]}_i = g^{[l]}(\mathbf z^{[l]}_i)\qquad trong đó g[l]()g^{[l]}() là hàm activation của lớp ll

Áp dụng chain rule ta có

∂−logf(x)y∂zi[l]=∂−logf(x)y∂ai[l]∂ai[l]∂zi[l]\dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}_i} = \dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l]}_i} \dfrac{\partial \mathbf a^{[l]}_i}{\partial \mathbf z^{[l]}_i}

=∂−logf(x)y∂ai[l]∂g[l](zi[l])∂zi[l]\qquad\qquad\qquad = \dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l]}_i}\dfrac{\partial g^{[l]}(\mathbf z^{[l]}_i)}{\partial \mathbf z^{[l]}_i} Tức là đạo hàm riêng đối với phần tử thứ i của z[l]\mathbf z^{[l]} bằng đạo hàm riêng đối với phần tử thứ i của a[l]\mathbf a^{[l]} nhân với đạo hàm riêng của hàm activation đối với phần tử thứ i của z[l]\mathbf z^{[l]}

Do đó nếu đạo hàm riêng cả vector z[l]\mathbf z^{[l]} thì

∂−logf(x)y∂z[l]=∂−logf(x)y∂a[l]∗(elementwise)∂g[l](z[l])∂z[l]\dfrac{\partial-logf(x)_y}{\partial \mathbf z^{[l]}} = \dfrac{\partial-logf(x)_y}{\partial \mathbf a^{[l]}} * (elementwise)\dfrac{\partial g^{[l]}(\mathbf z^{[l]})}{\partial \mathbf z^{[l]}}\qquad hay dz[l]=da[l]∗g[l]′(z[l])\qquad d\mathbf z^{[l]} = d\mathbf a^{[l]} * g^{[l]'}(\mathbf z^{[l]}) (nhân 2 phần từ tương ứng của 2 vector da[l]d\mathbf a^{[l]} và g[l]′(z[l])g^{[l]'}(\mathbf z^{[l]}) với nhau để ra vector dz[l]d\mathbf z^{[l]})


Tham khảo

  • Coursera deep learning
  • Hugo Larochelle Neural Network

All rights reserved

Viblo
Hãy đăng ký một tài khoản Viblo để nhận được nhiều bài viết thú vị hơn.
Đăng kí