Kubernetes overview - Phần 2/2 - Networking, self-healing, rollout và autoscaling
Bài 4/6 trong series CI/CD và Kubernetes. Tiếp nối Kubernetes overview (Phần 1/2) — nếu chưa đọc phần object model và kiến trúc cluster, nên đọc trước.
Mục tiêu
Phần này tập trung tìm hiểu các nội dung sau:
- hiểu networking và service discovery trong Kubernetes, và đường đi thật của MQTT traffic trong lab;
- mô tả self-healing, probe, rolling update, rollback và các lớp autoscaling qua ví dụ MQTT broker;
- dùng một số lệnh kubectl chỉ đọc để quan sát hệ thống một cách an toàn.
Networking và service discovery
Mỗi Pod có địa chỉ IP riêng trong cluster network. CNI plugin cung cấp connectivity Pod-to-Pod; Service tạo virtual endpoint ổn định phía trước nhóm Pod thay đổi.
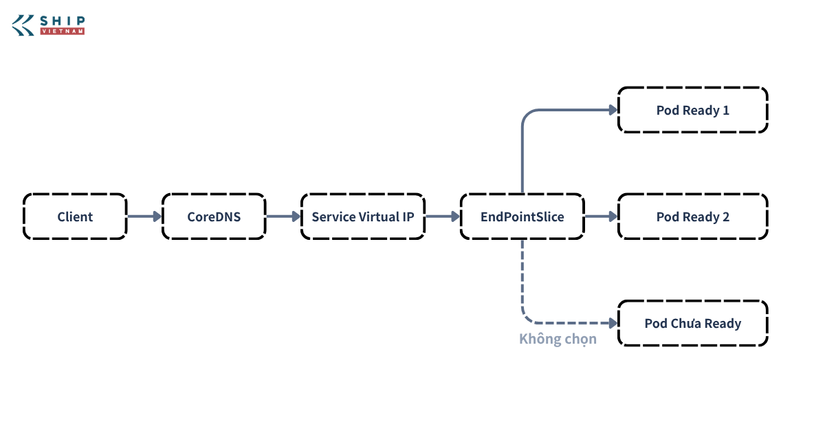
Service selector tìm Pod phù hợp; control plane phản ánh backend vào EndpointSlice. Readiness ảnh hưởng Pod có được dùng làm endpoint nhận traffic hay không. Tùy implementation, kube-proxy hoặc dataplane của CNI chuyển traffic từ Service virtual IP đến một endpoint.
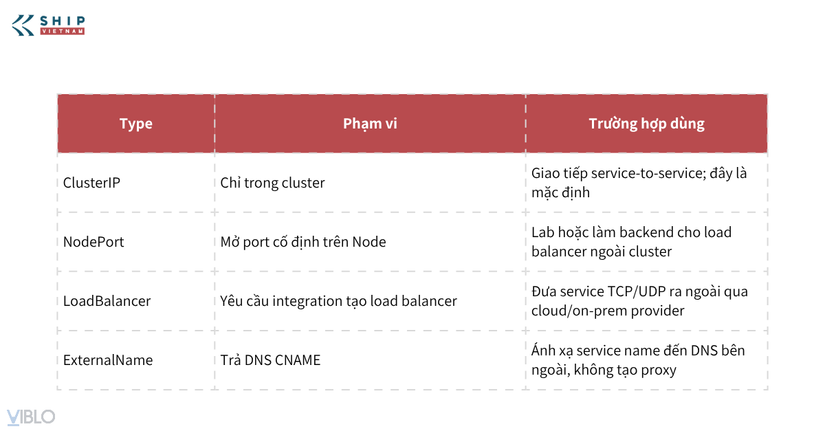
Headless Service không phải một type riêng; nó dùng clusterIP: None để DNS trả trực tiếp địa chỉ backend, thường đi cùng StatefulSet khi client cần nhận diện từng Pod. Ingress định tuyến HTTP/HTTPS dựa trên host/path và cần Ingress Controller. Nó không phải lựa chọn mặc định cho giao thức TCP như MQTT. Lab đưa MQTT qua Network Load Balancer đến NodePort 31883/31884; các web UI như Grafana dùng ingress-nginx. NetworkPolicy mô tả Pod nào được giao tiếp với nhau ở layer 3/4, nhưng chỉ có hiệu lực khi network plugin hỗ trợ enforcement. Tạo policy trong cluster không hỗ trợ không tự tạo firewall mong muốn.
Đường đi của MQTT traffic
Luồng chính trong lab:
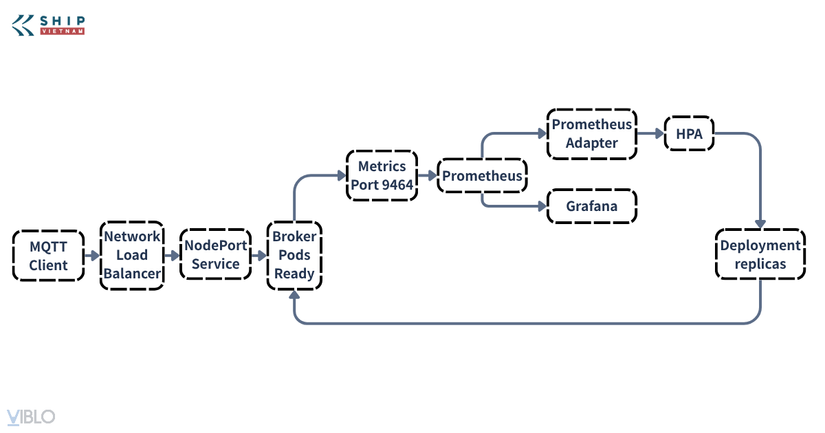
- MQTT client tạo connection qua endpoint của load balancer.
- Load balancer chuyển traffic tới NodePort của Service.
- Service phân phối connection tới các broker Pod phù hợp và Ready.
- Mỗi broker xuất số connection hiện tại qua endpoint metric.
- Prometheus thu thập metric; Prometheus Adapter cung cấp custom metric cho Kubernetes API.
- HPA đọc average connections trên mỗi Pod và điều chỉnh replica.
- Grafana hiển thị cùng dữ liệu để người vận hành quan sát. Service giải quyết endpoint ổn định, Deployment giải quyết vòng đời Pod và HPA thay đổi desired scale. Không resource nào một mình làm tất cả.
Self-healing và probe
Giả sử Deployment đang có ba Pod Ready và một Pod bị xóa. ReplicaSet quan sát chỉ còn hai Pod, nên tạo Pod thứ ba. Scheduler chọn Node, kubelet tải image nếu cần và khởi động container. Pod mới chỉ được đưa vào endpoint của Service sau khi readiness probe thành công.
Ba loại probe trả lời ba câu hỏi khác nhau:
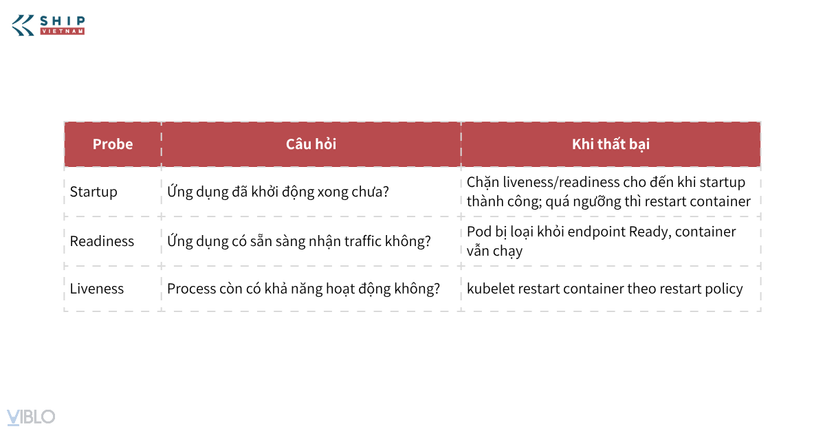
Probe có thể dùng HTTP, TCP, gRPC hoặc exec tùy loại và phiên bản hỗ trợ. Chọn probe dựa trên hành vi thật của ứng dụng. Một liveness probe phụ thuộc database bên ngoài có thể restart hàng loạt Pod khi database lỗi, làm sự cố nặng hơn.
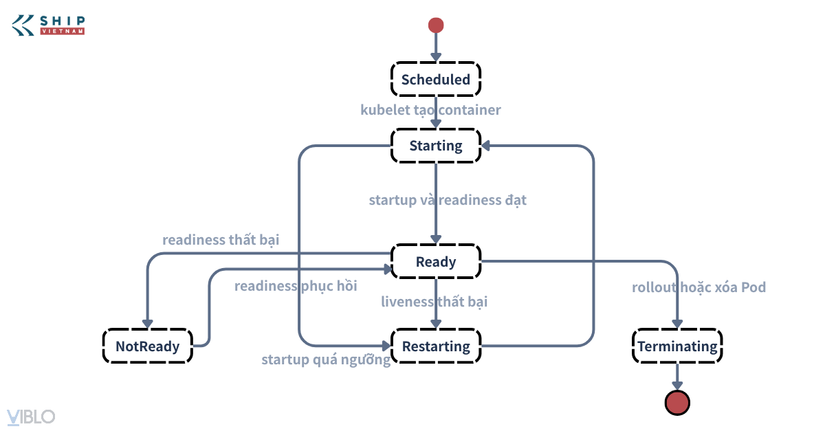
Self-healing diễn ra ở nhiều lớp:
- container process lỗi: kubelet có thể restart container trong cùng Pod;
- Pod bị xóa hoặc Node mất: workload controller tạo Pod thay thế;
- Pod không Ready: Service ngừng chuyển traffic đến Pod, nhưng controller không nhất thiết thay Pod ngay;
- Deployment rollout kẹt: pipeline hoặc người vận hành phát hiện timeout và quyết định rollback.
Self-healing ở đây không có nghĩa ứng dụng không bao giờ gián đoạn. Nếu workload có đúng một replica, thời gian tạo Pod mới vẫn có thể gây downtime. Nếu ứng dụng giữ state cục bộ, Pod thay thế cũng không tự khôi phục dữ liệu. Kubernetes cung cấp cơ chế hội tụ; kiến trúc ứng dụng vẫn phải được thiết kế cho failure. Trong seminar, job simulate_pod_failure chọn một broker Pod đang chạy, xóa nó và chờ đến khi số Pod Ready trở lại số replica mong muốn. Đây là fault injection có phạm vi, đồng thời chứng minh controller đang hoạt động.
Rolling update và rollback
Khi CI chạy:
kubectl -n mqtt set image deployment/mqtt-broker broker=<registry>/<image>:v1.1.0
template Pod thay đổi. Deployment tạo ReplicaSet mới, tăng Pod mới và giảm Pod cũ theo chiến lược rollout. Readiness probe ngăn Pod mới nhận traffic quá sớm.
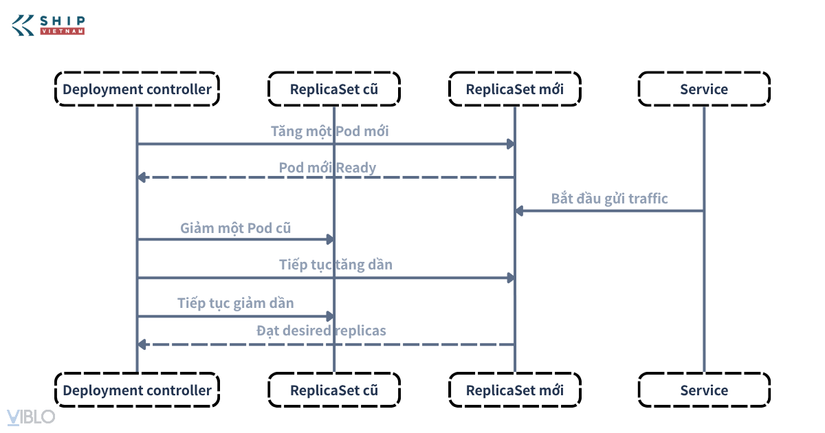
Hai tham số quan trọng của rolling update:
- maxSurge giới hạn số Pod có thể vượt desired replicas trong rollout;
- maxUnavailable giới hạn số Pod có thể unavailable so với desired replicas.
Giá trị càng thận trọng càng bảo vệ availability nhưng rollout có thể chậm và cần thêm capacity. Strategy Recreate dừng Pod cũ trước khi tạo Pod mới, phù hợp với một số workload không cho hai revision chạy đồng thời nhưng có thể gây downtime. Khi Pod bị terminate, kubelet gửi tín hiệu dừng và chờ terminationGracePeriodSeconds trước khi kill. Ứng dụng cần ngừng nhận việc mới, đóng connection và flush state trong khoảng này. Readiness, graceful shutdown và rollout strategy phải được thiết kế cùng nhau.
Có thể kiểm tra rollout bằng:
kubectl -n mqtt rollout status deployment/mqtt-broker
kubectl -n mqtt rollout history deployment/mqtt-broker
Nếu revision mới có vấn đề, rollback nhanh:
kubectl -n mqtt rollout undo deployment/mqtt-broker
kubectl -n mqtt rollout status deployment/mqtt-broker
rollout undo đưa template về ReplicaSet trước. Nó không xóa nhu cầu theo dõi metric sau rollback, và cũng không tạo release mới trong Git. Vì vậy release process dài hạn nên tạo một tag mới từ source revision tốt đã biết. Một thay đổi environment variable trong Pod template cũng tạo rollout. Trong demo, đổi MAX_CONNECTIONS từ 100 xuống 80 tạo revision mới dù image không đổi.
Các lớp autoscaling
Kubernetes có thể mở rộng ở nhiều lớp. Các lớp giải quyết những thiếu hụt khác nhau và không thay thế lẫn nhau:
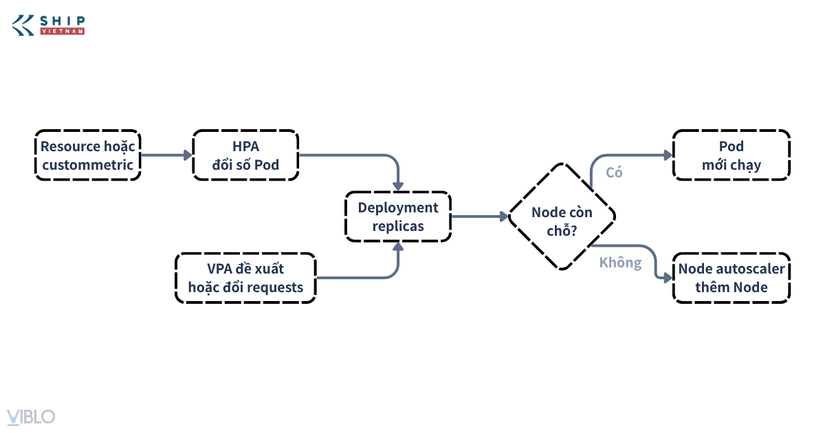
- HPA tăng/giảm số Pod của Deployment hoặc StatefulSet dựa trên metric.
- Vertical Pod Autoscaler (VPA) đề xuất hoặc điều chỉnh resource requests; tùy mode, thay đổi có thể cần recreate Pod.
- Node autoscaler thêm/bớt Node khi Pod không schedule được hoặc Node dư thừa. HPA không thể tự tạo Node.
Lab chỉ demo HPA; số Node giữ cố định.
HPA theo custom metric
Broker giới hạn tối đa 100 connections đồng thời trên mỗi Pod. HPA giữ từ 3 đến 10 Pod và đặt target trung bình 80 connections trên mỗi Pod:
minReplicas: 3
maxReplicas: 10
metrics:
  - type: Pods
    pods:
      metric:
        name: mqtt_broker_connections
      target:
        type: AverageValue
        averageValue: "80"
Với 800 connections, ba Pod ban đầu không đủ capacity. Khi average metric vượt target, HPA tăng desired replicas. Mức tối đa 10 Pod cho capacity lý thuyết 1.000 connections khi mỗi Pod có limit 100.
Ở mức khái niệm, HPA ước lượng:
desired replicas ≈ current replicas × current metric / target metric
Controller còn áp tolerance, min/max, stabilization window và scaling policy, nên kết quả thực tế không nhất thiết bằng phép chia tức thời. Target 80 thấp hơn hard limit 100 để tạo khoảng đệm. Nếu chỉ scale khi Pod chạm đúng hard limit, connection mới có thể bị từ chối trong thời gian Pod bổ sung đang được schedule và trở thành Ready. Khi tải kết thúc, HPA không giảm ngay lập tức. Lab dùng stabilization window 60 giây và giảm dần để tránh dao động liên tục. Scale-up nhanh và scale-down thận trọng là lựa chọn thường gặp khi mất capacity gây tác động lớn hơn giữ thừa capacity trong thời gian ngắn.
HPA và thay đổi replica thủ công
HPA và lệnh kubectl scale đều ghi vào spec.replicas. Nếu HPA đang active, số replica đặt tay có thể sớm bị HPA ghi lại. Vì vậy demo static xóa HPA trước khi đặt số Pod cố định; khi kết thúc phải apply lại HPA.
Metric đi vào HPA bằng cách nào?
Metrics Server thường cung cấp CPU và memory qua Resource Metrics API. Custom metric của broker đi theo đường khác: Prometheus scrape mqtt_broker_connections, Prometheus Adapter ánh xạ nó vào Custom Metrics API, rồi HPA đọc giá trị theo Pod. Grafana đọc Prometheus để hiển thị nhưng không điều khiển HPA.
Quan sát an toàn bằng kubectl
kubectl là API client: nó đọc kubeconfig để chọn cluster, user và context, sau đó gửi request tới API Server. Nó không SSH vào Node để chạy lệnh. Khám phá schema và resource mà cluster hỗ trợ:
kubectl api-resources
kubectl api-versions
kubectl explain deployment
kubectl explain deployment.spec.strategy
kubectl explain statefulset.spec.volumeClaimTemplates
Quan sát workload và quan hệ label/endpoint bằng các lệnh chỉ đọc:
kubectl get nodes
kubectl -n mqtt get deployment,pods,service,hpa
kubectl -n mqtt get replicasets
kubectl -n mqtt get pods --show-labels
kubectl -n mqtt get endpointslices
kubectl -n mqtt rollout status deployment/mqtt-broker
kubectl -n mqtt rollout history deployment/mqtt-broker
kubectl -n mqtt describe hpa mqtt-broker
kubectl -n mqtt get events --sort-by=.lastTimestamp
Đọc custom metric mà HPA sử dụng:
kubectl get --raw \
  '/apis/custom.metrics.k8s.io/v1beta1/namespaces/mqtt/pods/*/mqtt_broker_connections'
Kiểm tra image và cấu hình giới hạn mà không in Secret:
kubectl -n mqtt get deployment mqtt-broker \
  -o jsonpath='image={.spec.template.spec.containers[?(@.name=="broker")].image}{"\n"}'

kubectl -n mqtt get deployment mqtt-broker \
  -o jsonpath='max_connections={.spec.template.spec.containers[?(@.name=="broker")].env[?(@.name=="MAX_CONNECTIONS")].value}{"\n"}'
Tránh dùng kubectl get secret -o yaml trong terminal đang trình chiếu hoặc log được lưu. Tên Secret thường đủ để chẩn đoán việc mount; nội dung Secret hiếm khi cần xuất ra màn hình.
Tổng kết
Kubernetes là một hệ thống API và controller vận hành bằng desired state. API Server là entry point, etcd lưu state, Scheduler chọn Node, controller thực hiện reconciliation cho object và kubelet hiện thực hóa Pod thông qua container runtime, CNI cùng volume plugin. Pod là building block; Deployment/ReplicaSet quản lý dịch vụ stateless, StatefulSet cung cấp identity ổn định, DaemonSet chạy agent theo Node, Job/CronJob quản lý tác vụ hữu hạn. Service/CoreDNS tạo service discovery; ConfigMap/Secret cung cấp cấu hình; ServiceAccount/RBAC kiểm soát identity; PV/PVC/StorageClass biểu diễn storage bền vững. Trong lab, ba Pod MQTT ban đầu có giới hạn 100 connections mỗi Pod. HPA dùng custom metric mqtt_broker_connections, target trung bình 80 và phạm vi 3–10 Pod. Prometheus cung cấp dữ liệu cho autoscaling và Grafana giúp người vận hành xác nhận hành vi thực tế. **Bài cuối sẽ ghép pipeline và các resource này thành một bài thực hành hoàn chỉnh: release image, chạy load test, quan sát scale, mô phỏng failure và rollback. **
All rights reserved