

KHI MÔ HÌNH HỌC MÁY "CHẾT DẦN" TRÊN PRODUCTION: CHIẾN LƯỢC GIÁM SÁT DATA DRIFT, CONCEPT DRIFT VÀ TỰ ĐỘNG HÓA ADAPTIVE RETRAINING PIPELINE
Trong kỹ nghệ phần mềm truyền thống, sự cố hệ thống thường biểu hiện rất rõ ràng: máy chủ sập nguồn, cơ sở dữ liệu bị nghẽn kết nối, hoặc giao diện lập trình ứng dụng trả về mã lỗi HTTP 500. Đội ngũ trực vận hành có thể thiết lập cảnh báo tức thời để can thiệp trong vòng vài phút.
Tuy nhiên, trong các hệ thống Trí tuệ Nhân tạo và Học máy cấp độ doanh nghiệp, hiểm họa lớn nhất lại không xuất phát từ lỗi cú pháp hay sự cố hạ tầng. Đó là hiện tượng Suy thoái âm thầm (Silent Degradation):
Cổng API suy luận vẫn phản hồi kết quả đều đặn với thời gian xử lý dưới 50 mili-giây và mã trạng thái HTTP 200 OK.
Hạ tầng máy chủ GPU và CPU duy trì tải trọng lý tưởng, không ghi nhận bất kỳ ngoại lệ phần mềm nào.
Thế nhưng, các quyết định kinh doanh sinh ra từ mô hình — như chấm điểm phê duyệt tín dụng, đề xuất mức giá phòng khách sạn hay phân loại giao dịch gian lận — bắt đầu sai lệch nghiêm trọng, âm thầm gây thiệt hại hàng triệu USD cho doanh nghiệp.
Nguyên nhân cốt lõi là do thế giới thực luôn biến động không ngừng, trong khi mô hình học máy lại bị đóng băng tri thức tại thời điểm kết thúc pha huấn luyện.
Đợi đến khi có nhãn kết quả thực tế (Ground-Truth Labels) để tính toán lại các chỉ số như Accuracy, Precision hay F1-Score thì độ trễ thường mất từ vài tuần đến vài tháng (Feedback Delay).
Bài viết này sẽ phẫu thuật chi tiết bản chất của hai cơ chế suy thoái dữ liệu độc lập, các thuật toán kiểm định thống kê không giám sát được lập trình trực tiếp bằng Python ngay tại thời điểm suy luận, cùng kiến trúc thiết lập đường ống tái huấn luyện thích ứng (Adaptive Retraining Pipeline) chuẩn công nghiệp.
1. Bóc Tách Bản Chất Hệ Thống: Phân Tách Data Drift Và Concept Drift Bằng Mã Nguồn
Để thiết kế hệ thống giám sát chuẩn xác, kỹ sư dữ liệu phải phân biệt rạch ròi hai cơ chế suy thoái dựa trên phân phối xác suất đồng thời giữa không gian biến đặc trưng đầu vào X và biến mục tiêu đầu ra Y.
Quy tắc phân rã xác suất cơ bản:
# Xác suất đồng thời P(X, Y) được phân rã thành:
# P(X, Y) = P(X) * P(Y|X)
# Trong đó:
# - P(X): Phân phối biên duyên của dữ liệu đầu vào (Input Distribution)
# - P(Y|X): Phân phối xác suất có điều kiện của nhãn mục tiêu khi biết đầu vào (Decision Boundary)
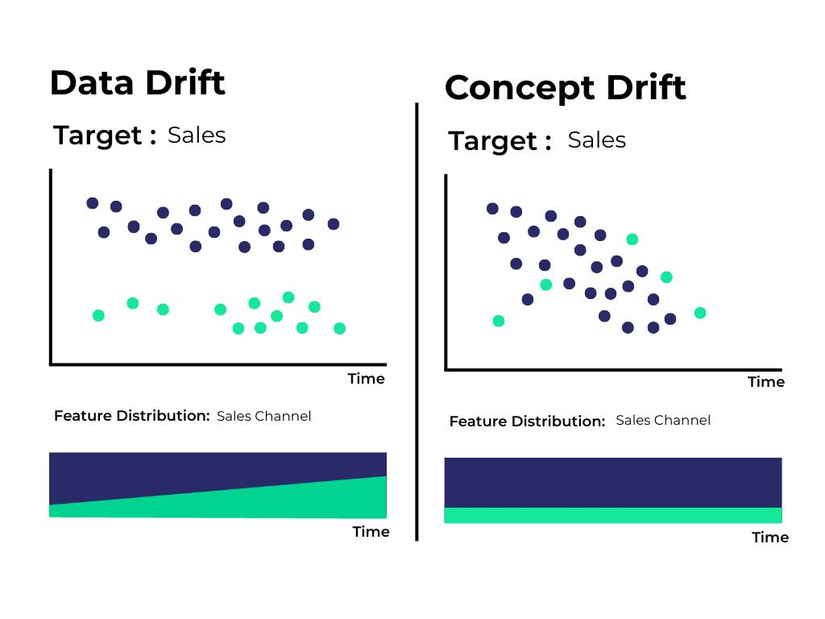 Sự đứt gãy của một trong hai thành phần này dẫn đến hai bài toán hoàn toàn khác biệt:
Hiện Tượng Dịch Chuyển Dữ Liệu Đầu Vào (Data Drift / Covariate Shift)
Xảy ra khi phân phối của dữ liệu đầu vào P(X) thay đổi theo thời gian, nhưng mối quan hệ ánh xạ có điều kiện P(Y|X) vẫn giữ nguyên:
Bản chất logic: Dữ liệu thực tế tại thời điểm hiện tại khác biệt so với dữ liệu tham chiếu trong quá khứ, nhưng quy luật gán nhãn không đổi.
Nguyên nhân thực tế: Do sự thay đổi tự nhiên trong đặc điểm người dùng mới (ví dụ một chiến dịch tiếp thị thu hút tệp khách hàng trẻ tuổi hơn), hoặc do sự cố kỹ thuật từ hệ thống thu thập dữ liệu (cảm biến bị lệch thang đo, ứng dụng di động đổi định dạng gửi dữ liệu).
Đặc tính: Mô hình bị buộc phải suy luận trên những vùng không gian dữ liệu mà nó chưa từng được học kỹ trong tập dữ liệu huấn luyện mốc ban đầu.
Hiện Tượng Dịch Chuyển Khái Niệm Nghiệp Vụ (Concept Drift)
Đây là dạng suy thoái nguy hiểm nhất, xảy ra khi phân phối của các biến đầu vào P(X) hoàn toàn ổn định nhưng mối quan hệ toán học P(Y|X) đã bị thay đổi căn bản bởi các yếu tố ngoại cảnh:
Bản chất logic: Khách hàng vẫn có các đặc điểm đầu vào y hệt như cũ, nhưng xác suất xảy ra hành vi mục tiêu đã bị đảo lộn.
Nguyên nhân thực tế: Sự thay đổi của bối cảnh kinh tế vĩ mô, biến động lãi suất điều hành, khủng hoảng dịch bệnh, hoặc đối thủ cạnh tranh tung ra chính sách mới. Ví dụ: Khách hàng vẫn có mức thu nhập 30 triệu đồng và lịch sử tín dụng tốt, nhưng áp lực lạm phát cao khiến hành vi trả nợ vay tiêu dùng thay đổi đột ngột so với 2 năm trước.
Đặc tính: Không thể phát hiện nếu chỉ nhìn vào dữ liệu đầu vào đơn thuần, đòi hỏi các cơ chế đối chuẩn nhãn thực tế hoặc giám sát phân phối xác suất dự đoán đầu ra.
2. Giám Sát Không Giám Sát Tại Inference Time: Các Hàm Python Đo Lường Suy Thoái
Trong đa số bài toán thực tế, nhãn thực tế Y không bao giờ xuất hiện tức thời cùng lúc với thời điểm dự đoán. Vì vậy, hệ thống MLOps bắt buộc phải triển khai tầng kiểm định thống kê không giám sát (Unsupervised Drift Detection) trên không gian đầu vào X và phân phối xác suất đầu ra.
Dưới đây là các hàm Python chuẩn hóa để bạn có thể copy và tích hợp trực tiếp vào pipeline:
Kiểm Định Kolmogorov-Smirnov (KS-Test) Cho Biến Liên Tục
Kiểm định 2 mẫu Kolmogorov-Smirnov so sánh hàm phân phối tích lũy thực nghiệm (ECDF) của một thuộc tính liên tục giữa tập dữ liệu tham chiếu chuẩn và cửa sổ dữ liệu thực tế:
from scipy import stats
import numpy as np

def calculate_ks_test(reference: np.ndarray, current: np.ndarray) -> dict:
    """
    Kiểm định 2 mẫu KS-Test đo lường sự khác biệt phân phối.
    Nếu p-value < 0.05: Ghi nhận có sự dịch chuyển có ý nghĩa thống kê.
    """
    ref_clean = reference[~np.isnan(reference)]
    curr_clean = current[~np.isnan(current)]

    statistic, p_value = stats.ks_2samp(ref_clean, curr_clean)

    return {
        "statistic": float(statistic),
        "p_value": float(p_value),
        "is_drifted": p_value < 0.05
    }
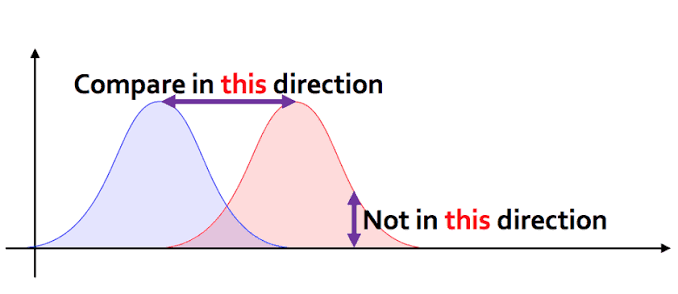
Khoảng Cách Wasserstein (Earth Mover's Distance)
Khác với các phép kiểm định giả thuyết nhạy cảm với kích thước mẫu lớn, khoảng cách Wasserstein lượng hóa khối lượng công việc tối thiểu cần thiết để biến đổi hình dạng phân phối này thành hình dạng phân phối kia:
from scipy.stats import wasserstein_distance
import numpy as np

def calculate_wasserstein(reference: np.ndarray, current: np.ndarray) -> float:
    """
    Tính khoảng cách Wasserstein đo độ biến dạng vật lý giữa 2 phân phối liên tục.
    """
    ref_clean = reference[~np.isnan(reference)]
    curr_clean = current[~np.isnan(current)]
    return float(wasserstein_distance(ref_clean, curr_clean))
Chỉ Số Ổn Định Quần Thể (Population Stability Index - PSI)
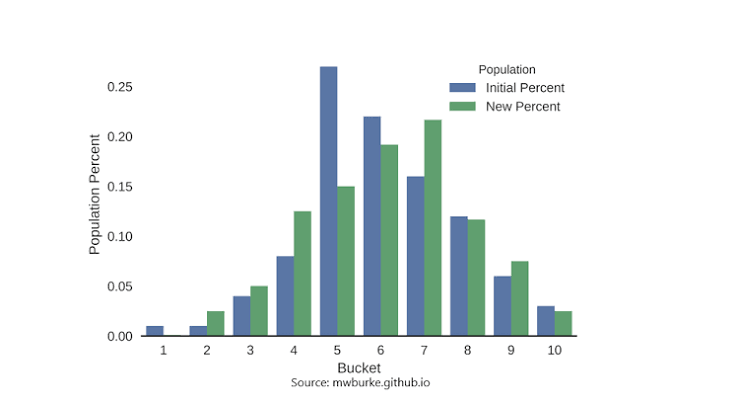
Thước đo tiêu chuẩn công nghiệp trong ngành tài chính và ngân hàng để đo lường mức độ biến động của phân phối dữ liệu và điểm số dự báo:
import numpy as np

def calculate_psi(reference: np.ndarray, current: np.ndarray, num_bins: int = 10, epsilon: float = 1e-4) -> float:
    """
    Tính toán Population Stability Index (PSI).
    Quy chuẩn ngưỡng:
      - PSI < 0.1: Phân phối ổn định (No drift)
      - 0.1 <= PSI <= 0.25: Dịch chuyển nhẹ (Moderate drift)
      - PSI > 0.25: Trôi dạt nghiêm trọng (Significant drift)
    """
    ref_clean = reference[~np.isnan(reference)]
    curr_clean = current[~np.isnan(current)]

    # Xác định các mốc phân vị cố định dựa trên tập Reference
    quantiles = np.linspace(0, 100, num_bins + 1)
    bins = np.percentile(ref_clean, quantiles)
    bins[0] = -np.inf
    bins[-1] = np.inf
    bins = np.unique(bins)

    # Đếm số lượng mẫu trong từng bin
    ref_counts, _ = np.histogram(ref_clean, bins=bins)
    curr_counts, _ = np.histogram(curr_clean, bins=bins)

    # Quy đổi sang tỷ lệ phần trăm
    ref_pct = ref_counts / len(ref_clean)
    curr_pct = curr_counts / len(curr_clean)

    # Tránh chia cho 0 hoặc log(0) bằng epsilon
    ref_pct = np.where(ref_pct == 0, epsilon, ref_pct)
    curr_pct = np.where(curr_pct == 0, epsilon, curr_pct)

    # Công thức: PSI = sum((Current - Reference) * ln(Current / Reference))
    psi_value = np.sum((curr_pct - ref_pct) * np.log(curr_pct / ref_pct))
    return float(psi_value)
 Độ Phân Kỳ Jensen-Shannon (JS Divergence) Cho Phân Phối Dự Báo
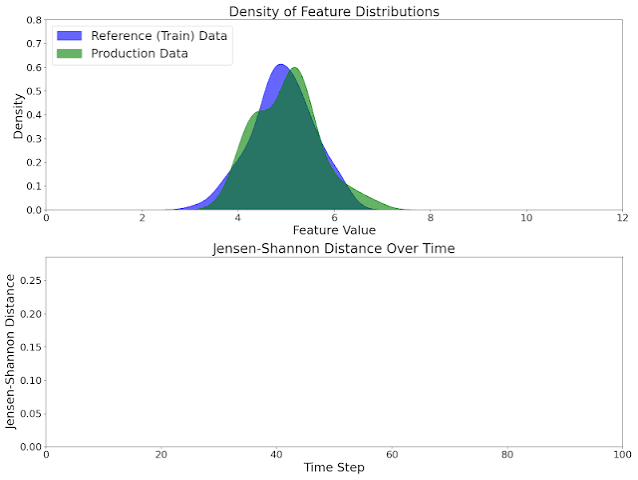
Được sử dụng để giám sát sự thay đổi trong phân phối xác suất dự đoán đầu ra của mô hình mà không gặp lỗi chia cho 0:
import numpy as np

def calculate_js_divergence(p: np.ndarray, q: np.ndarray, num_bins: int = 10, epsilon: float = 1e-4) -> float:
    """
    Tính Jensen-Shannon Divergence giữa phân phối xác suất dự đoán.
    Giá trị chuẩn hóa nằm trong khoảng từ 0.0 đến 1.0.
    """
    bins = np.linspace(0.0, 1.0, num_bins + 1)
    p_counts, _ = np.histogram(p, bins=bins)
    q_counts, _ = np.histogram(q, bins=bins)

    p_prob = (p_counts + epsilon) / np.sum(p_counts + epsilon)
    q_prob = (q_counts + epsilon) / np.sum(q_counts + epsilon)

    m = 0.5 * (p_prob + q_prob)
    kl_pm = np.sum(p_prob * np.log(p_prob / m))
    kl_qm = np.sum(q_prob * np.log(q_prob / m))

    js_score = 0.5 * kl_pm + 0.5 * kl_qm
    return float(np.sqrt(np.clip(js_score, 0.0, 1.0)))
3. Kiến Trúc Luồng Giám Sát Phân Tán Chuẩn Doanh Nghiệp
Để vận hành các bài kiểm định thống kê mà không làm chậm tốc độ phản hồi của API suy luận, kiến trúc giám sát phải được tách rời hoàn toàn khỏi luồng xử lý chính.
Chuỗi luân chuyển dữ liệu giám sát gồm 4 mắt xích cốt lõi:
Tầng thu thập dữ liệu suy luận (Payload Logging): Mọi yêu cầu đầu vào dạng JSON và kết quả dự đoán trả về được ghi nhận bất đồng bộ qua hàng đợi thông điệp Apache Kafka hoặc AWS Kinesis. Quá trình này không làm tăng thêm độ trễ của API phục vụ người dùng.
 Tầng lọc rửa và xác thực cấu trúc (Schema & Integrity Gate): Trước khi tính toán phân phối thống kê, hệ thống phải chạy các bài kiểm tra tính toàn vẹn cơ bản: tỷ lệ giá trị khuyết thiếu (Null Rate), vi phạm kiểu dữ liệu (Type Mismatch), hoặc xuất hiện các giá trị nằm ngoài miền giá trị cho phép (Out-of-range Anomalies). Điều này ngăn chặn việc nhầm lẫn giữa lỗi kỹ thuật phần mềm và sự dịch chuyển dữ liệu tự nhiên.
Tầng tính toán phân kỳ theo cửa sổ trượt (Sliding Window Profiler): Dữ liệu được gom nhóm theo cửa sổ thời gian (ví dụ: 1 giờ hoặc 24 giờ gần nhất) và so sánh trực tiếp với Bộ dữ liệu chuẩn mực (Golden Baseline Dataset) được trích xuất từ tập kiểm định của phiên bản mô hình hiện hành.
Tầng định tuyến cảnh báo thông minh: Tránh việc gửi cảnh báo tràn lan gây tê liệt đội ngũ kỹ sư (Alert Fatigue). Chỉ kích hoạt cảnh báo mức độ cao khi có đồng thời từ 3 biến đặc trưng quan trọng vượt ngưỡng PSI > 0.25 hoặc phân phối điểm số mục tiêu bị biến dạng liên tục trong 3 cửa sổ trượt liên tiếp.
4. Thiết Lập Đường Ống Tái Huấn Luyện Thích Ứng (Adaptive Retraining Pipeline)
Phát hiện ra sự suy thoái dữ liệu mới chỉ giải quyết được một nửa bài toán. Doanh nghiệp cần một cơ chế tự phục hồi để đưa hiệu năng mô hình trở lại quỹ đạo tối ưu mà không làm gián đoạn dòng vận hành.
Phá Bỏ Cái Bẫy "Lên Lịch Tái Huấn Luyện Định Kỳ Mù Quáng"
Nhiều đội ngũ kỹ thuật áp dụng giải pháp đơn giản là thiết lập một cronjob chạy ngầm vào đêm Chủ nhật hàng tuần để huấn luyện lại mô hình trên toàn bộ dữ liệu mới. Cách tiếp cận này bộc lộ ba rủi ro chí mạng:
Lãng phí tài nguyên điện toán khổng lồ khi dữ liệu thực tế chưa hề có sự thay đổi đáng kể.
Mô hình mới có nguy cơ bị "học vẹt" (Overfitting) vào các biến động giả tạo ngắn hạn do thị trường bị nhiễu cục bộ trong vài ngày trước đó.
Nguy cơ đưa một mô hình kém chất lượng hơn lên môi trường thật nếu dữ liệu tuần mới phát sinh lỗi nhãn mà không qua khâu kiểm soát chất lượng nghiêm ngặt.
Kiến Trúc Kích Hoạt Theo Sự Kiện (Event-Driven Adaptive Pipeline)
Hệ thống tái huấn luyện thích ứng chuẩn mực chỉ được kích hoạt khi hội tụ đầy đủ hai điều kiện tiên quyết:
Điều kiện 1 - Tín hiệu dịch chuyển: Chỉ số thống kê độ trôi dạt (PSI > 0.25 hoặc p-value của KS-Test < 0.05) trên các đặc trưng cốt lõi vượt ngưỡng cho phép trong nhiều chu kỳ kiểm tra liên tiếp.
Điều kiện 2 - Tích lũy đủ nhãn mới: Hệ thống đã thu thập đủ một khối lượng nhãn thực tế mới tối thiểu để đảm bảo kích thước mẫu có ý nghĩa thống kê cho việc huấn luyện lại.
Thuật Toán Trọng Số Suy Giảm (Decay-Weighted Retraining) Chống Quên Tri Thức Cũ
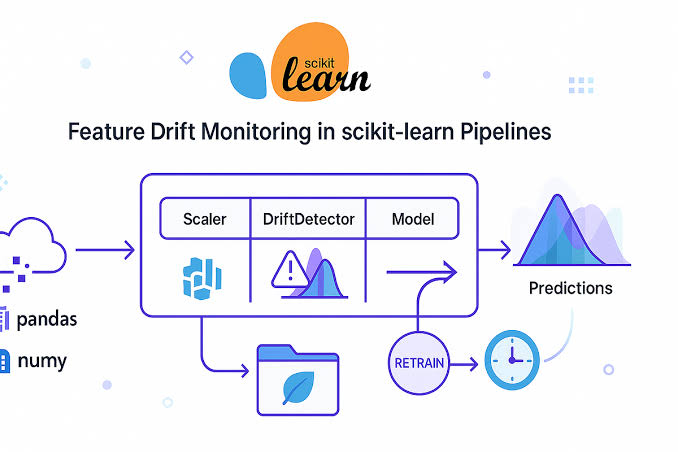
Khi huấn luyện lại mô hình trên dữ liệu mới kết hợp dữ liệu cũ, kỹ sư MLOps áp dụng hàm suy giảm theo hàm mũ để ưu tiên tín hiệu mới mà không làm mất tri thức nền tảng:
import numpy as np
import pandas as pd
from sklearn.ensemble import RandomForestClassifier

def train_adaptive_model(historical_df: pd.DataFrame, new_df: pd.DataFrame, feature_cols: list, target_col: str, decay_factor: float = 2.0):
    """
    Huấn luyện mô hình thích ứng với trọng số mẫu giảm dần theo thời gian.
    Mẫu mới nhất có trọng số = 1.0, các mẫu cũ suy giảm dần theo hàm mũ.
    """
    combined_df = pd.concat([historical_df, new_df], ignore_index=True)
    n_samples = len(combined_df)

    # Gán trọng số mẫu theo hàm mũ suy giảm theo trục thời gian
    time_steps = np.linspace(0, 1, n_samples)
    sample_weights = np.exp(decay_factor * (time_steps - 1.0))
    sample_weights = sample_weights / np.max(sample_weights)

    X_train = combined_df[feature_cols].values
    y_train = combined_df[target_col].values

    model = RandomForestClassifier(n_estimators=100, max_depth=6, random_state=42)
    model.fit(X_train, y_train, sample_weight=sample_weights)

    return model
Đấu Kiểm Champion - Challenger Tự Động Và Triển Khai Canary
Mô hình mới được tạo ra (Challenger) không được phép ghi đè ngay lên mô hình đang chạy (Champion). Hệ thống điều phối sẽ tự động thực thi bài kiểm thử hồi quy độc lập trên tập dữ liệu kiểm toán chuẩn (Golden Test Set).
Chỉ khi mô hình Challenger chứng minh được sự vượt trội về các chỉ số nghiệp vụ và độ an toàn rủi ro, lệnh chuyển đổi mới được phê duyệt. Sau đó, mô hình mới ban đầu chỉ tiếp nhận từ 5 đến 10 phần trăm lưu lượng truy cập thực tế qua cơ chế Canary Deployment. Sau 48 giờ vận hành ổn định không phát sinh lỗi độ trễ hay bất thường phân phối, lưu lượng mới được nâng dần lên 100 phần trăm, hoàn tất chu kỳ thích ứng khép kín.
Làm chủ tư duy toán học xác suất để phát hiện sớm các hiện tượng suy thoái dữ liệu và tự tay thiết kế hạ tầng MLOps tự động hóa bền bỉ chính là đỉnh cao năng lực của một Chuyên gia Khoa học Dữ liệu cấp độ sản xuất. Để tiếp cận các bài toán kiến trúc dữ liệu quy mô lớn, chuẩn hóa năng lực thiết kế Feature Store, Drift Detection và tự tin vận hành các hệ thống học máy phục vụ hàng triệu người dùng, việc đồng hành cùng chương trình Data Science thực chiến tại Cole sẽ mang lại cho bạn bệ phóng sự nghiệp vững chắc nhất, khẳng định vị thế chuyên gia tiên phong trong kỷ nguyên công nghệ số.
Hãy dừng ngay việc để các mô hình học máy vận hành "mù" trên môi trường sản xuất mà không có thước đo giám sát. Hãy bắt tay vào rà soát phân phối biến đầu vào, tích hợp các hàm đo lường PSI, Wasserstein và xây dựng đường ống tự phục hồi thích ứng cho hệ thống của doanh nghiệp ngay hôm nay!
Lộ trình cho người mới!
All rights reserved
