

K-Medoids và giới hạn của tâm cụm trung bình trong K-Means
K-Means được ưa chuộng trong các bài toán phân cụm không giám sát vì ý tưởng trực quan và tốc độ tính toán nhanh trên tập dữ liệu lớn. Tuy nhiên, chính hàm mục tiêu và cách tính tâm cụm của K-Means chuẩn lại bộc lộ điểm yếu khi dữ liệu có ngoại lai, chứa thuộc tính danh mục hoặc cần đến những độ đo khoảng cách phi Euclid.
K-Medoids giải quyết vấn đề theo hướng khác: chọn một quan sát thực tế trong tập dữ liệu làm tâm đại diện (medoid) và tối thiểu hóa tổng khoảng cách bậc một. Cách làm này giúp thuật toán ít bị chi phối bởi giá trị ngoại lai và hoạt động trực tiếp với nhiều độ đo bất tương đồng tùy ý.
1. Giới hạn của tâm cụm trung bình trong K-Means
K-Means chia tập dữ liệu thành cụm sao cho tổng bình phương khoảng cách từ mỗi điểm dữ liệu đến centroid của cụm tương ứng là nhỏ nhất. Hàm mục tiêu này thường gọi là Within-Cluster Sum of Squares (WCSS):
Trong đó là số cụm cần phân chia, là tập hợp các điểm thuộc cụm thứ , là centroid của cụm thứ và là chuẩn khoảng cách Euclid.
Khi cố định nhãn cụm, đạo hàm riêng của theo từng tọa độ centroid triệt tiêu tại:
Từ đó suy ra nghiệm giải tích tối ưu cho bước cập nhật centroid:
1.1. Độ nhạy trước dữ liệu ngoại lai
Do K-Means chuẩn dùng bình phương khoảng cách Euclid, mức phạt cho một điểm nằm xa centroid tăng theo hàm bậc hai:
Khoảng cách tăng gấp đôi thì sai số đóng góp vào hàm mục tiêu tăng gấp bốn lần. Khi dữ liệu xuất hiện vài điểm ngoại lai nằm tách biệt do sai số đo đạc hoặc dị biệt phân phối, chúng sẽ chiếm tỷ trọng lớn trong tổng WCSS. Để kéo tổng bình phương sai số xuống, thuật toán buộc phải dịch chuyển centroid về phía nhóm ngoại lai, làm tâm cụm trôi khỏi vùng có mật độ dữ liệu cao. Mức độ lệch tâm cụ thể còn tùy thuộc vào số lượng ngoại lai, khoảng cách của chúng, số cụm và vị trí khởi tạo ban đầu.
1.2. Centroid không nhất thiết là một đối tượng thực tế
Vì là điểm trung bình số học trong không gian vector, tọa độ centroid có thể không trùng với bất kỳ quan sát nào trong tập mẫu. Chẳng hạn trên dữ liệu khách hàng, phép tính trung bình có thể cho ra một người 28,6 tuổi với 1,4 người con, còn biến nhị phân mã hóa 0 và 1 lại nhận giá trị 0,6 (vốn chỉ phản ánh tỷ lệ mẫu trong cụm). Với dữ liệu hình ảnh, trung bình cộng pixel của hàng loạt bức chân dung thường tạo ra một khuôn mặt mờ nhòe; còn trong xử lý văn bản, vector TF-IDF trung bình chỉ là một tọa độ tổng hợp không gắn với bài viết cụ thể nào.
Trong không gian vector thuần túy, centroid vẫn là đại diện toán học thuận tiện. Trở ngại chỉ phát sinh khi bài toán nghiệp vụ đòi hỏi tâm cụm phải là một thực thể có thật để diễn giải.
2. Cách tiếp cận của K-Medoids: Chọn mẫu dữ liệu thật làm tâm
K-Medoids chọn một điểm dữ liệu có thật trong tập mẫu làm đại diện cho mỗi cụm, gọi là medoid. Với tập dữ liệu gồm quan sát, mỗi medoid phải thuộc tập dữ liệu ban đầu:
Medoid của một cụm được chọn sao cho tổng khoảng cách từ nó tới các điểm còn lại trong cùng cụm là nhỏ nhất. Gọi là độ đo khoảng cách hoặc độ bất tương đồng giữa hai quan sát, hàm mục tiêu của K-Medoids có dạng:
Khi mỗi điểm được gán về medoid gần nhất trong tập , hàm mục tiêu viết gọn thành:
Khác biệt cốt lõi giữa hai phương pháp:
K-Means:
Tâm cụm       = Trung bình cộng (Centroid)
Hàm mục tiêu  = Tổng bình phương khoảng cách Euclid (bình phương chuẩn L2)

K-Medoids:
Tâm cụm       = Mẫu dữ liệu thực tế (Medoid)
Hàm mục tiêu  = Tổng khoảng cách bậc một hoặc độ bất tương đồng (Euclid L2, Manhattan L1, Cosine...)
2.1. Vì sao K-Medoids ít nhạy cảm hơn với ngoại lai?
K-Medoids chuẩn tối thiểu hóa trực tiếp tổng khoảng cách bậc một. Khi dùng khoảng cách Euclid bậc một hoặc khoảng cách Manhattan, mức phạt chỉ tăng tuyến tính theo khoảng cách nên sai số của các điểm ở xa không bị bình phương khuếch đại, làm giảm lực kéo lệch tâm cụm.
Ngoài ra, centroid của K-Means có thể trôi ra bất kỳ vị trí trống nào trong không gian khi bị ngoại lai kéo, còn medoid chỉ có thể dịch chuyển giữa các điểm dữ liệu thực tế. Nếu khoảng không giữa cụm chính và nhóm ngoại lai không có dữ liệu, medoid không thể nằm lơ lửng ở khoảng trống đó.
Dù vậy, nếu nhóm ngoại lai đủ đông hoặc tụ thành một cụm riêng, K-Medoids vẫn có thể dời medoid về phía chúng hoặc tách nhóm này thành một cụm độc lập. Mặt khác, nếu người dùng chủ động chọn hàm khoảng cách là bình phương Euclid, hàm mục tiêu vẫn chịu mức phạt bậc hai như K-Means.
2.2. Khả năng diễn giải thông qua mẫu đại diện có thật
Việc medoid luôn là một mẫu dữ liệu gốc giúp kết quả phân cụm dễ giải thích hơn đối với chuyên gia nghiệp vụ. Trong phân khúc khách hàng, hệ thống chỉ ra đúng một hồ sơ khách hàng có thật làm đại diện cho nhóm. Với bài toán phân cụm văn bản, người đọc có thể xem ngay bài viết medoid hoàn chỉnh để nắm chủ đề chung mà không phải đọc lướt hàng nghìn tài liệu. Trên dữ liệu chuỗi thời gian, chuỗi trung bình thường làm phẳng biên độ, trong khi medoid là một chuỗi quan sát thực tế nên giữ nguyên các chu kỳ dao động tự nhiên. Tương tự, medoid của cụm hình ảnh là một bức ảnh sắc nét có sẵn trong tập mẫu để hiển thị trực tiếp lên giao diện người dùng.
3. Hoạt động trên các không gian phi Euclid
K-Means chuẩn gắn liền với không gian vector số học và chuẩn Euclid, bởi trung bình cộng chỉ là nghiệm giải tích tối ưu cho tổng bình phương khoảng cách Euclid. Nếu đổi sang khoảng cách Manhattan hoặc độ tương đồng Cosine mà vẫn giữ bước cập nhật tâm bằng trung bình cộng, thuật toán sẽ không còn tối ưu hàm mục tiêu mới.
Để làm việc với các độ đo khác, bước tìm tâm phải thay đổi tương ứng: K-Medians lấy trung vị theo từng chiều nhằm tối thiểu hóa tổng khoảng cách Manhattan khi các thuộc tính độc lập với nhau; Spherical K-Means chuẩn hóa vector tâm về độ dài đơn vị để tối ưu độ tương đồng Cosine trên không gian vector hướng; còn K-Medoids chọn mẫu thực tế làm tâm để tối thiểu hóa tổng bất tương đồng mà không cần tính trung bình tọa độ.
3.1. Các dạng độ đo tương thích với K-Medoids
Nhờ bỏ qua phép tính trung bình tọa độ, K-Medoids vận hành được trên bất kỳ hàm khoảng cách hoặc ma trận bất tương đồng nào.
Khoảng cách Manhattan (L1)
Khoảng cách Manhattan đo tổng sai lệch tuyệt đối trên từng chiều độc lập, phù hợp khi tính quãng đường di chuyển trên mạng lưới đường phố dạng bàn cờ hoặc so sánh các chỉ số tài chính độc lập.
Khoảng cách Cosine
Trong xử lý ngôn ngữ tự nhiên với vector TF-IDF hoặc vector nhúng (embedding), hướng của vector quan trọng hơn độ lớn. Khi dùng khoảng cách Cosine, K-Medoids sẽ chọn tài liệu có góc lệch nhỏ nhất so với các tài liệu còn lại trong cụm làm medoid.
Khoảng cách đồ thị và chuỗi ký tự
Trên dữ liệu mạng xã hội hoặc mạng lưới giao thông, khoảng cách giữa hai nút có thể tính bằng độ dài đường đi ngắn nhất. Với chuỗi ký tự như chuỗi gene hay tên riêng, ta dùng khoảng cách Levenshtein; còn với chuỗi thời gian bị lệch pha, Dynamic Time Warping (DTW) là độ đo thông dụng. Trong mọi trường hợp này, K-Medoids đều chọn ra được một đỉnh đồ thị hoặc một chuỗi thực tế làm tâm đại diện.
Dữ liệu hỗn hợp (Gower distance)
Khi bảng dữ liệu gồm cả thuộc tính số liên tục, biến nhị phân và biến danh mục (categorical), khoảng cách Gower cho phép tính độ bất tương đồng tổng hợp giữa hai hàng dữ liệu. K-Medoids có thể phân cụm dữ liệu hỗn hợp trực tiếp qua ma trận khoảng cách Gower do không cần cộng trung bình các nhãn danh mục.
Xử lý dữ liệu khuyết thiếu
Một số hàm như nan_euclidean_distances trong scikit-learn tính khoảng cách dựa trên những thuộc tính mà cả hai điểm cùng quan sát được. Tuy nhiên, nếu hai mẫu không có chung thuộc tính nào, khoảng cách sẽ trả về NaN. Vì vậy, dữ liệu khuyết thiếu vẫn cần được kiểm tra và tiền xử lý trước khi đưa vào ma trận khoảng cách.
3.2. Phân cụm khi chỉ có ma trận khoảng cách tính trước
Nhiều bài toán thực tế chỉ cung cấp ma trận khoảng cách hoặc độ bất tương đồng giữa các cặp điểm mà không lưu trữ tọa độ đặc trưng:
Khi thư viện hỗ trợ tham số metric='precomputed', K-Medoids tìm tập medoid trực tiếp từ ma trận mà không cần biết dữ liệu gốc nằm trong không gian nào. K-Means chuẩn không hỗ trợ chế độ này vì bắt buộc phải truy cập tọa độ số học để tính trung bình cộng.
4. Thực nghiệm so sánh vị trí tâm cụm khi xuất hiện ngoại lai
Để kiểm chứng ảnh hưởng của ngoại lai tới centroid và medoid, ta tạo tập dữ liệu gồm hai cụm Gaussian chuẩn tại tọa độ và cùng 12 điểm ngoại lai nằm lệch về góc trên bên phải, sau đó chạy thử nghiệm với KMeans của scikit-learn và CLARANS từ thư viện scikit-clarans.
4.1. Tạo dữ liệu và huấn luyện mô hình
import numpy as np
import matplotlib.pyplot as plt

from sklearn.cluster import KMeans
from clarans import CLARANS

# Cố định seed để tái lập kết quả
rng = np.random.RandomState(42)

# Tạo hai cụm Gaussian chuẩn (150 điểm mỗi cụm)
c1 = rng.normal(loc=[-3, 0], scale=0.6, size=(150, 2))
c2 = rng.normal(loc=[3, 0], scale=0.6, size=(150, 2))

# Tạo 12 điểm ngoại lai ở góc trên bên phải
outliers = rng.uniform(low=[8, 6], high=[14, 10], size=(12, 2))

# Gộp toàn bộ dữ liệu (tổng cộng 312 mẫu)
X = np.vstack([c1, c2, outliers])

# Huấn luyện K-Means
kmeans = KMeans(n_clusters=2, random_state=42, n_init=10).fit(X)

# Huấn luyện CLARANS (K-Medoids)
clarans = CLARANS(n_clusters=2, num_local=5, random_state=42).fit(X)

# In tọa độ tâm cụm để kiểm tra
np.set_printoptions(precision=3, suppress=True)

print("K-Means centroids:")
print(kmeans.cluster_centers_)

print("\nCLARANS medoids:")
print(clarans.cluster_centers_)

print("\nCLARANS medoid indices:")
print(clarans.medoid_indices_)
Kết quả in ra từ thực nghiệm:
K-Means centroids:
 [[ 3.578  0.613]
 [-3.02   0.014]]

CLARANS medoids:
 [[-2.997 -0.141]
 [ 3.134  0.008]]

CLARANS medoid indices:
 [ 49 183]
4.2. Trực quan hóa vị trí các tâm
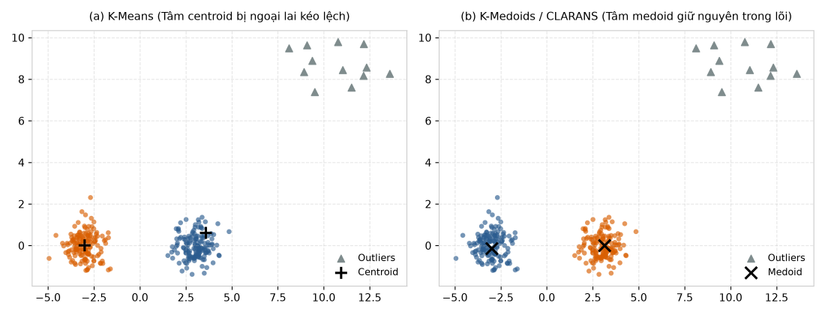
Để tránh nhầm lẫn khi hai thuật toán đánh số thứ tự cụm khác nhau, ta giữ nguyên màu sắc các điểm theo cụm sinh dữ liệu ban đầu. Các điểm ngoại lai được vẽ bằng hình tam giác xám, còn vị trí centroid và medoid được đánh dấu bằng ký hiệu đen kích thước lớn.
fig, axes = plt.subplots(1, 2, figsize=(12, 4.5), dpi=300)

colors = ["#2b5c8f", "#d95f02"]
models = [
    (kmeans, "K-Means: Centroid", "+"),
    (clarans, "K-Medoids / CLARANS: Medoid", "X"),
]

for ax, (model, title, marker) in zip(axes, models):
    # Cụm Gaussian thứ nhất
    ax.scatter(
        c1[:, 0], c1[:, 1],
        c=colors[0], s=20, alpha=0.65,
        label="Gaussian cluster 1"
    )

    # Cụm Gaussian thứ hai
    ax.scatter(
        c2[:, 0], c2[:, 1],
        c=colors[1], s=20, alpha=0.65,
        label="Gaussian cluster 2"
    )

    # Các điểm ngoại lai
    ax.scatter(
        outliers[:, 0], outliers[:, 1],
        c="#7f8c8d", marker="^", s=45,
        label="Outliers"
    )

    # Vị trí centroid hoặc medoid ước lượng
    centers = model.cluster_centers_
    ax.scatter(
        centers[:, 0], centers[:, 1],
        marker=marker, s=150, c="black",
        linewidths=2.2, label="Estimated centers",
        zorder=5
    )

    ax.set_title(title, fontsize=11, fontweight="bold")
    ax.set_xlabel("Feature 1")
    ax.set_ylabel("Feature 2")
    ax.legend(loc="best", frameon=False, fontsize=8)
    ax.grid(True, linestyle="--", alpha=0.3)

plt.tight_layout()
plt.savefig("outlier_robustness_comparison.png", dpi=300)
plt.show()
4.3. Diễn giải kết quả thực nghiệm
Ở K-Means, cụm bên trái không có ngoại lai nên centroid hội tụ sát tâm tại (-3.020, 0.014). Ngược lại, cụm bên phải chịu lực hút từ 12 điểm ngoại lai nằm trong khoảng [8, 6] đến [14, 10]. Do bình phương khoảng cách Euclid khuếch đại mức phạt của các điểm xa, centroid bị kéo lệch lên tọa độ (3.578, 0.613), trôi khỏi vùng mật độ cao nhất của cụm.
Trong khi đó, CLARANS tối thiểu hóa tổng khoảng cách bậc một và neo medoid vào mẫu dữ liệu có thật. Thuật toán chọn quan sát thứ 49 tại (-2.997, -0.141) cho cụm 1 và quan sát thứ 183 tại (3.134, 0.008) cho cụm 2, giữ tâm cụm 2 nằm gọn bên trong vùng mật độ cao.
5. So sánh K-Means và K-Medoids
| Tiêu chí | K-Means chuẩn | K-Medoids |
|---|---|---|
| Bản chất tâm cụm | Trung bình cộng các điểm trong cụm | Quan sát thực tế trong tập dữ liệu |
| Hàm mục tiêu | Tổng bình phương khoảng cách Euclid | Tổng khoảng cách hoặc độ bất tương đồng |
| Độ nhạy ngoại lai | Cao do cơ chế bình phương sai số | Thấp hơn với độ đo bậc một; medoid bị neo vào mẫu thật |
| Độ đo khoảng cách | Tối ưu giải tích cho chuẩn Euclid | Tương thích với Manhattan, Cosine, DTW, Gower... |
| Tính diễn giải | Tâm có thể là giá trị hư cấu không tồn tại | Tâm luôn là đối tượng quan sát có thật |
| Chi phí tính toán | Thấp, khoảng mỗi vòng lặp | Cao hơn; phụ thuộc thuật toán tìm kiếm (PAM, CLARA, CLARANS) |
| Khả năng mở rộng | Rất tốt trên dữ liệu lớn | Cần các thuật toán xấp xỉ như FastCLARANS khi dữ liệu lớn |
Nhìn chung, K-Means phù hợp với dữ liệu thuần số quy mô lớn khi khoảng cách Euclid phản ánh đúng bản chất bài toán. Khi tập dữ liệu có nhiều ngoại lai, đòi hỏi độ đo phi Euclid hoặc cần trích xuất mẫu thực tế làm đại diện cho nghiệp vụ, K-Medoids là lựa chọn đáng cân nhắc hơn dù tốn nhiều tài nguyên phần cứng hơn.
6. Thách thức hiệu năng: Từ PAM đến FastCLARANS
Chi phí tính toán chính là rào cản khiến K-Medoids ít được áp dụng trên các tập dữ liệu lớn trong một thời gian dài. Việc tìm tập medoid tối ưu trên không gian rời rạc là một bài toán tổ hợp NP-hard. Qua hơn ba thập kỷ, nhiều thuật toán tìm kiếm cục bộ và xấp xỉ đã lần lượt ra đời để giải bài toán này trên thực tế:
- Thuật toán PAM (1990) duyệt vét cạn mọi cặp hoán đổi medoid với độ phức tạp mỗi vòng lặp, chỉ chạy tốt trên tập dữ liệu nhỏ dưới vài nghìn mẫu.
- Cùng năm 1990, CLARA cắt giảm chi phí xuống bằng cách chạy PAM trên các tập mẫu con ngẫu nhiên kích thước , đổi lại phải chấp nhận rủi ro bỏ sót các cụm nhỏ.
- Đến năm 2002, CLARANS chuyển bài toán sang tìm kiếm cục bộ ngẫu nhiên trên đồ thị hoán đổi, đạt sự cân bằng tốt hơn giữa tốc độ thực thi và chất lượng phân cụm trên toàn bộ dữ liệu.
- Gần đây hơn, FastCLARANS (2021) áp dụng kỹ thuật đánh giá đồng thời của Schubert & Rousseeuw (2021) để giảm lần số phép tính khoảng cách, đưa K-Medoids lên các tập dữ liệu lớn.
Trong bài viết tiếp theo, chúng ta sẽ đi sâu vào cơ chế toán học của PAM, CLARA, CLARANS và FastCLARANS, đồng thời thực nghiệm đo lường tốc độ hội tụ của bốn thuật toán này.
All rights reserved
