

Gợi ý du lịch Việt Nam bằng TF-IDF và underthesea - Viblo
Xây hệ gợi ý du lịch Việt Nam bằng TF-IDF: cập nhật 34 tỉnh mới, và vì sao tách từ thôi là chưa đủ
Mã nguồn: https://github.com/HongTin2104/VietNam-Travel-Recommendation-System Dùng thử: https://vietnam-travel-recsys.streamlit.app/
Bài toán
Khi lên kế hoạch đi chơi, mình thường nghĩ theo kiểu "muốn tìm một bãi biển hoang sơ, nước trong để lặn ngắm san hô", chứ ít khi nghĩ "đi Khánh Hòa". Vì vậy mình làm một app nhỏ: bạn mô tả chuyến đi bằng tiếng Việt (hoặc tiếng Anh), app trả về 3 địa điểm phù hợp nhất trong số 315 địa điểm trên cả nước.
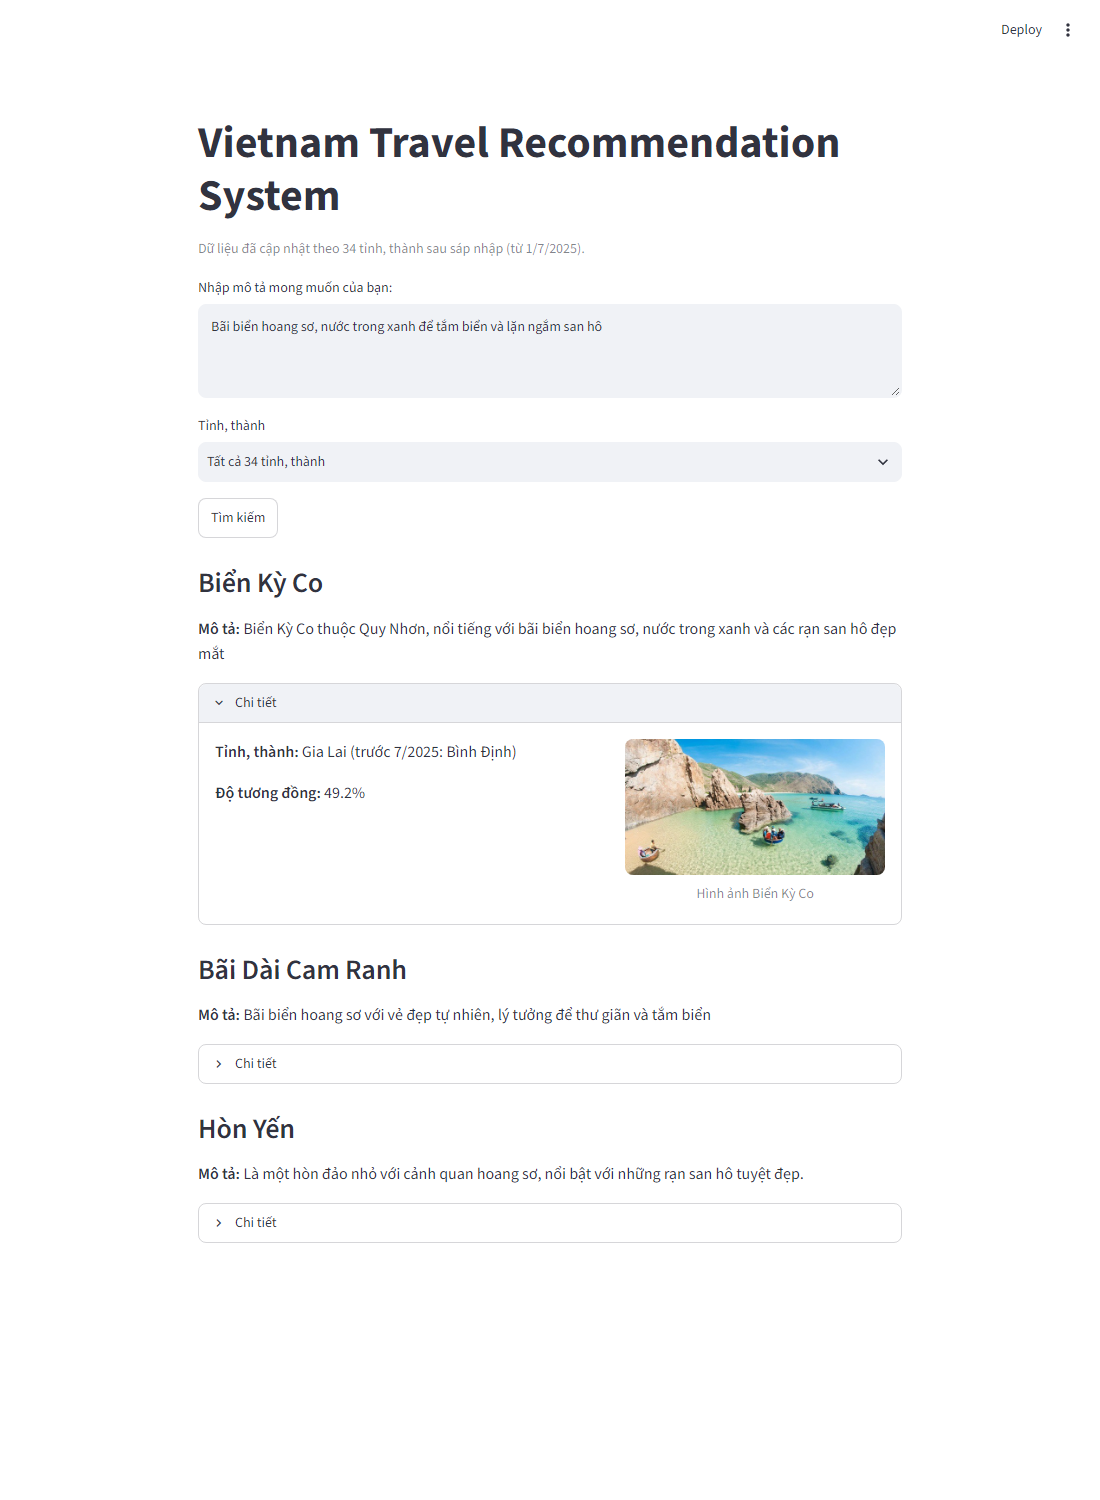
Dữ liệu: 315 địa điểm, cập nhật theo 34 tỉnh mới
Mình tự tổng hợp 5 địa điểm cho mỗi tỉnh trong 63 tỉnh cũ, gồm tên, mô tả, đánh giá, từ khóa và ảnh. Từ 1/7/2025, cả nước còn 34 tỉnh, thành theo Nghị quyết 202/2025/QH15, nên mình thêm một bảng ánh xạ 63 → 34. Mỗi địa điểm giờ có cả tỉnh mới lẫn tỉnh cũ, ví dụ "Gia Lai (trước 7/2025: Bình Định)". Bảng ánh xạ nằm trong một file Python riêng (scripts/province_mapping.py), bạn nào cần cho dự án khác thì cứ lấy dùng.
Trong lúc làm sạch dữ liệu, mình gặp vài lỗi thực tế đáng kể:
- 65 link ảnh dạng
surl.likhông bao giờ hiển thị được, vì trang rút gọn trả về một trang HTML trung gian chứ không chuyển hướng tới ảnh. Mình viết script lấy link ảnh gốc từ trang đó, sửa được 60/65 link. - Một điểm đánh giá ghi "47/5" (thiếu dấu chấm), tỉnh "Nam Đinh" và "Quang Ninh" bị gõ thiếu dấu.
- Hai dòng có vẻ nhầm tên địa điểm. Mình không tự đoán để sửa mà ghi lại trong data card.
Mô hình: TF-IDF + cosine similarity
Pipeline khá đơn giản: chữ thường → bỏ dấu câu và số → tách từ bằng underthesea → TF-IDF → cosine similarity với câu truy vấn.
Mình chọn TF-IDF thay vì embedding vì mô tả rất ngắn (trung vị 148 ký tự), mô hình nằm gọn trong bộ nhớ, không phải tải gì thêm, và sinh viên đọc hiểu được ngay.
Phần thú vị: tách từ làm kết quả tệ đi
Bộ dữ liệu không có nhãn "câu hỏi → địa điểm đúng", nên mình dùng chính các tag từ khóa làm nhãn. Mỗi tag xuất hiện ở 3–30 địa điểm được dùng làm một câu truy vấn, tổng cộng 46 câu. Kết quả:
| Mô hình | P@3 | R@10 | MRR |
|---|---|---|---|
| Ngẫu nhiên | 0.036 | 0.049 | 0.123 |
| Xếp theo đánh giá cao nhất | 0.022 | 0.043 | 0.089 |
| TF-IDF theo âm tiết (không tách từ) | 0.196 | 0.349 | 0.342 |
| TF-IDF theo từ (underthesea) | 0.181 | 0.292 | 0.348 |
| TF-IDF từ + âm tiết, 1-2 gram | 0.217 | 0.350 | 0.373 |
Tách từ bằng underthesea cho recall thấp hơn cách tách theo âm tiết. Lý do: underthesea gộp "bãi biển" thành một token bãi_biển, nên câu truy vấn "biển" không còn khớp. Cách sửa rất đơn giản: giữ token từ ghép, đồng thời thêm các âm tiết của nó.
def build_features(text):
    words = preprocess_text(text)  # "bãi_biển hoang_sơ ..."
    syllables = [s for word in words.split() if "_" in word for s in word.split("_")]
    return " ".join([words, *syllables])
Cách này cho điểm cao nhất ở cả 3 chỉ số. Phải nói rõ là với 46 câu truy vấn, chênh lệch giữa các biến thể TF-IDF còn nhỏ, nên con số chỉ mang tính tham khảo. Bài học rút ra: với tiếng Việt, tách từ không phải lúc nào cũng giúp ích cho việc tìm kiếm, nên đo trước rồi hãy quyết định.
Chạy thử
git clone https://github.com/HongTin2104/VietNam-Travel-Recommendation-System.git
cd VietNam-Travel-Recommendation-System
pip install -r requirements.txt
streamlit run main.py
Giới hạn và hướng mở rộng
- 315 địa điểm mới chỉ là một mẫu nhỏ, chưa đầy đủ.
- Nhãn đánh giá lấy từ tag nên thiên về trùng từ. Gắn nhãn bằng tay sẽ cho con số công bằng hơn.
- Hướng tiếp theo: thêm địa điểm, thử PhoBERT hoặc multilingual-e5 rồi so trên cùng bảng đánh giá, gợi ý theo mùa và vùng miền.
Nếu bạn đang làm đồ án về NLP hoặc hệ gợi ý, mời bạn tham khảo repo. Góp ý, issue và PR (nhất là bổ sung địa điểm) đều rất được hoan nghênh. Thấy hữu ích thì cho repo một star nhé.
All rights reserved
