

GLM-5 vs Gemini 3.8 Flash: 19 bài test, hai lỗi không có mã lỗi
GLM-5 vs Gemini 3.8 Flash: 19 bài test, hai lỗi không có mã lỗi
Ảnh bìa do AI tạo.
Vấn đề: 17/19 nghe như một kết luận, nhưng nó chỉ là một con số
Chạy hai model trên cùng một bộ 19 bài test, kết quả là 19/19 và 17/19. Con số này đúng. Nó cũng là chỗ gần như mọi bài so sánh dừng lại.
Vấn đề nằm ở chỗ tỷ lệ đạt cho bạn biết bao nhiêu bài hỏng, chứ không cho bạn biết hỏng theo cách nào. Với hai bài mà Gemini 3.8 Flash làm hỏng trong lần chạy này, cách hỏng quan trọng hơn con số: cả hai lần gọi đều trả về HTTP 200, và cả hai đều không sinh ra một lỗi nào.
Nghĩa là nếu trong hệ thống của bạn chỉ có một bảng theo dõi lỗi, bạn sẽ không thấy gì cả.
Bối cảnh: đo cái gì, đo thế nào
19 bài được chia thành sáu nhóm: sửa code hỏng, viết code từ đầu, gọi công cụ, hỏi đáp về repository, tuân thủ định dạng đầu ra, và tìm một giá trị trong file dài.
Hai model gọi qua cùng một endpoint, cùng tham số, mỗi bài một lần cho mỗi model. Cả 38 lần gọi đều được ghi lại.
| GLM-5 | Gemini 3.8 Flash | |
|---|---|---|
| Số bài đạt | 19/19 | 17/19 |
| Số lượt, trung bình mỗi bài | 2,9 | 3,3 |
| Token đầu vào | 55.258 | 27.713 |
| Token đầu ra | 11.049 | 13.034 |
| Token suy luận | 6.444 | 9.105 |
| Thời gian chạy | 444,5 giây | 510,3 giây |
| Chi phí theo giá niêm yết | $0,0906 | $0,0697 |
Một lần chạy cho mỗi model và mỗi bài. Những số liệu này mô tả bộ bài test này, không mô tả hai model nói chung.
Cả hai bài hỏng đều rơi vào hai bài đọc file dài — cũng là hai bài duy nhất yêu cầu đọc một file vài trăm dòng.
Thực hành 1: khi stop_reason là tín hiệu duy nhất
Bài đầu tiên yêu cầu tìm một khóa triển khai giấu trong file log 402 dòng, và giới hạn ở sáu lượt.
GLM-5 tìm ra ở lượt thứ tư rồi dừng bình thường. Gemini 3.8 Flash dùng hết cả sáu lượt và vẫn đang gọi công cụ khi hết giới hạn. Trường stop_reason ghi lại là tool_calls, còn nội dung trả về thì trống.
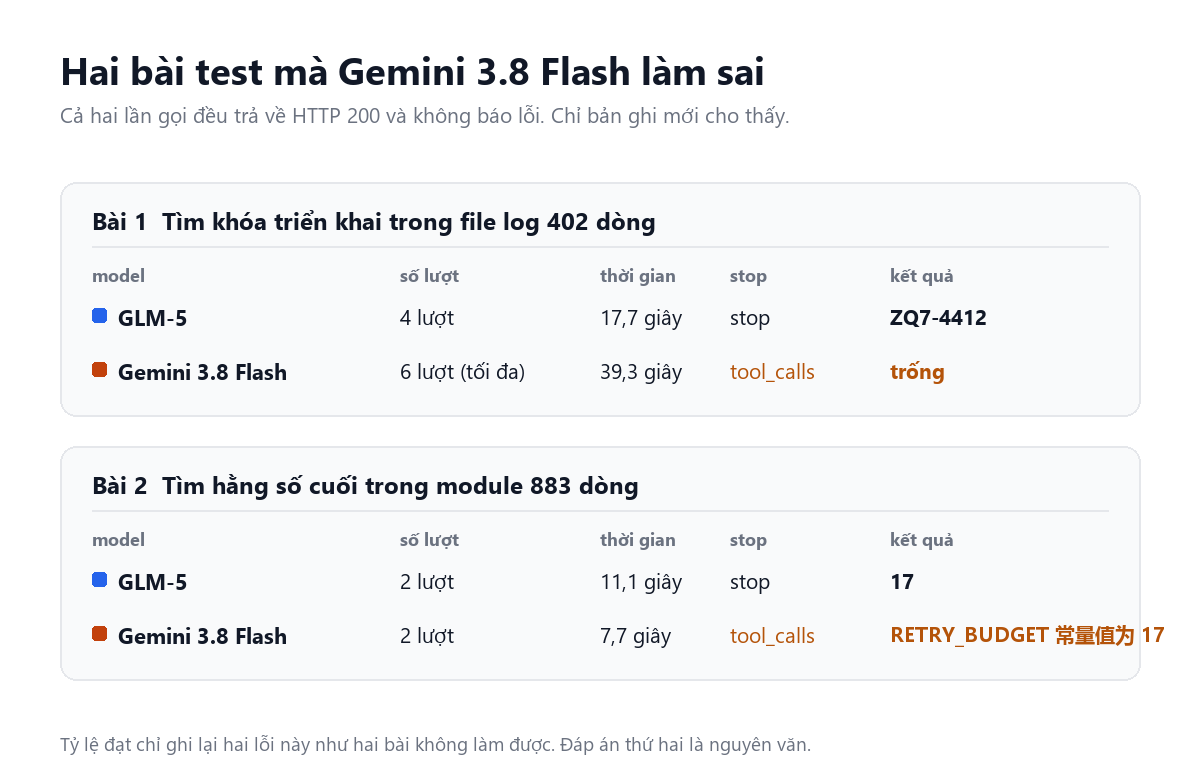
Hình: hai bài Gemini 3.8 Flash làm sai, kèm stop_reason và kết quả ghi được của mỗi model.
Đây không phải một câu trả lời sai. Đây là không có câu trả lời. Nhìn từ bên ngoài thì nó giống như model không làm được bài, trong khi thực tế nó hết chỗ trong lúc vẫn đang làm.
Điểm cần nhớ nằm ở một chỗ rất dễ bỏ qua: HTTP 200 chỉ có nghĩa là yêu cầu đã được chấp nhận, không có nghĩa là model đã trả lời xong. Hai chuyện khác nhau, và stop_reason là chỗ duy nhất phân biệt được chúng.
Sự phân biệt này đổi hẳn việc bạn làm tiếp theo. Một câu trả lời sai thì cần một model khác. Một câu trả lời bị cắt thì cần nâng giới hạn lượt, hoặc cần một lớp gọi biết nhận ra tình huống và thử lại.
Việc cần làm: đọc stop_reason trên mọi lần gọi, không chỉ đọc mã trạng thái. Đây là tín hiệu rẻ nhất tách được "đã trả lời" khỏi "bị cắt", và là tín hiệu duy nhất báo trước khi người dùng kịp nhận ra.
Thực hành 2: giá trị đúng, định dạng sai
Bài thứ hai yêu cầu tìm giá trị của một hằng số trong module 883 dòng, và ghi rõ chỉ trả về con số.
Cả hai model đều dùng hai lượt. GLM-5 trả về 17. Gemini 3.8 Flash trả về RETRY_BUDGET 常量值为 17 — đúng giá trị, nhưng viết thành cả một câu.
Con số thì đúng. Định dạng thì không. Một đoạn code parse câu trả lời đó thành số nguyên sẽ hỏng, còn một người đọc thì rất có thể sẽ đánh dấu là đạt. Đây chính là kiểu lỗi mà tỷ lệ đạt che mất hoàn toàn.
Có một chi tiết đáng nói. Đề bài được viết bằng tiếng Trung, vì đó là ngôn ngữ làm việc của harness chạy bài test, và câu trả lời cũng bằng tiếng Trung. Liệu cùng model đó có viết thành câu khi đề bài bằng tiếng Việt hay tiếng Anh hay không thì lần chạy này không trả lời được. Hãy tự kiểm tra bằng chính ngôn ngữ mà bạn gửi.
Việc cần làm: nếu có bất kỳ thứ gì phía sau parse kết quả trả về, hãy coi định dạng là một phần của hợp đồng. Kiểm tra nó, và để cho một lần parse hỏng được tính là hỏng. Dọn dẹp output sai định dạng sau khi nhận về sẽ che mất đúng cái tín hiệu bạn cần, và cách đó không mở rộng được qua lần bất ngờ đầu tiên.
Kết quả: hóa đơn rẻ hơn 23% là một con số dễ đọc sai
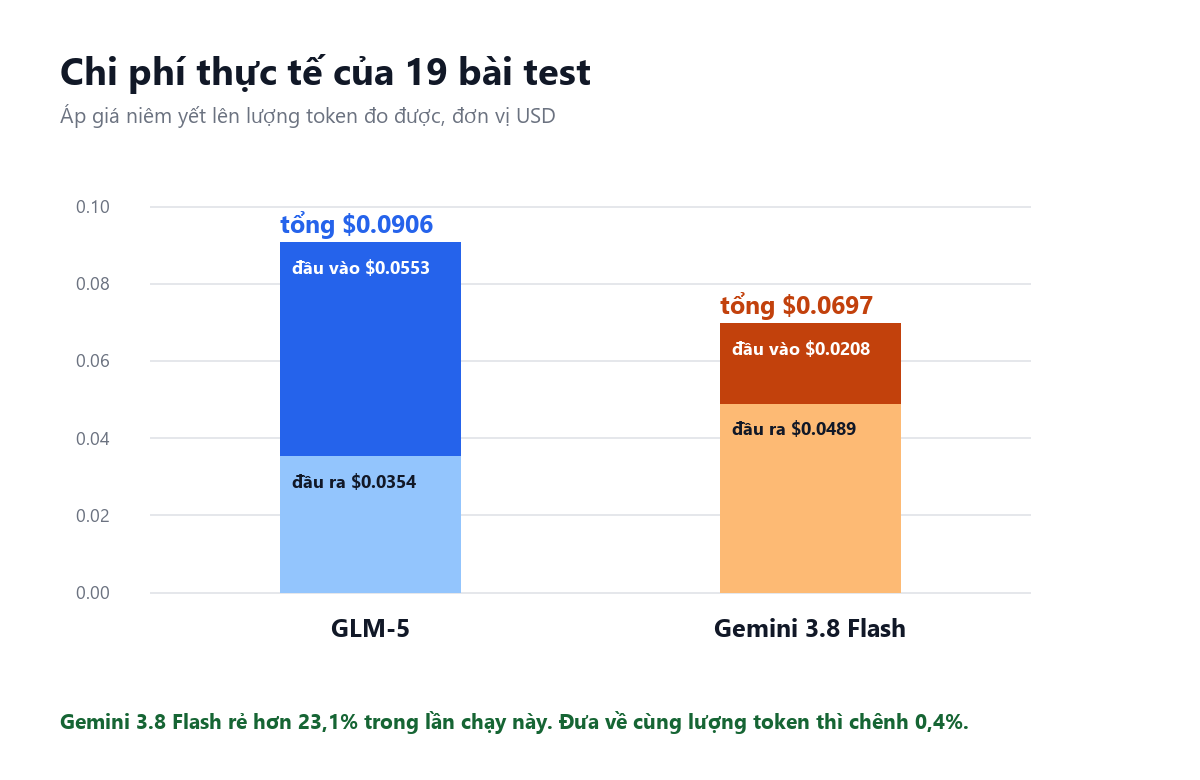
Hình: giá niêm yết áp lên lượng token đo được.
Trên tổng thô, Gemini 3.8 Flash rẻ hơn 23,1% cho lần chạy này. Con số đó chính xác, và nó cũng gây hiểu sai, vì hai model không tiêu thụ cùng một lượng đầu vào.
Chuẩn hóa về cùng một lượng token thì hai bên về $0,0694 và $0,0697 — chênh 0,4%, tức là hòa.
Chỗ đáng chú ý hơn nằm ở lượng token trên mỗi lượt. GLM-5 dùng ít lượt hơn (55 so với 63) nhưng tiêu thụ gần gấp đôi lượng token đầu vào. Chia ra thì GLM-5 khoảng 1.005 token đầu vào mỗi lượt, Gemini 3.8 Flash khoảng 440. Ít lượt hơn, nhưng mỗi lượt mang theo nhiều hơn hẳn.
Điều này quan trọng khi lập kế hoạch dung lượng. Nếu bạn suy ra số lượt từ con số trung bình, bạn sẽ tính sai cho model mang nhiều nội dung hơn mỗi lượt — và một giới hạn lượt đặt theo con số trung bình sẽ cắt đúng những bài cần đọc nhiều nhất. Đó chính là chuyện xảy ra ở bài hỏng đầu tiên.
Giá niêm yết thì tách nhau rõ hơn hóa đơn. GLM-5 là 1,00 USD mỗi triệu token đầu vào và 3,20 USD mỗi triệu token đầu ra, cache 0,20 USD, không có bậc xử lý theo lô. Gemini 3.8 Flash là 0,75 USD và 3,75 USD, cache 0,075 USD, và có bậc xử lý theo lô ở mức 0,375 USD vào và 1,88 USD ra cho các tác vụ bất đồng bộ.
Hai khác biệt trong đó đáng giá hơn mức giá đầu bảng. Cache đầu vào rẻ hơn 2,7 lần trên Gemini 3.8 Flash, và khoản này sẽ chi phối phép so sánh với bất kỳ workload nào có tiền tố lặp lại dài. Bậc xử lý theo lô chỉ có ý nghĩa nếu công việc chờ được, nhưng nếu chờ được thì mức giảm còn lớn hơn mọi thứ mà giá token gợi ra.
Thêm một chỗ nữa: token suy luận cũng tính theo giá đầu ra, và Gemini 3.8 Flash có giá đầu ra cao hơn. Trên toàn bộ lần chạy, token suy luận chiếm 6.444 ở GLM-5 và 9.105 ở Gemini 3.8 Flash, tức nhiều hơn 41%. Một lần chạy thì chưa đủ để coi tỷ lệ đó là cố định.
Việc cần làm: đo tỷ lệ đầu vào trên đầu ra của chính bạn trước khi so giá. Không model nào rẻ hơn một cách trừu tượng; một trong hai rẻ hơn cho đúng dạng traffic mà bạn gửi.
Tổng kết: ba việc nên đưa vào bài kiểm tra của chính bạn
Cả hai lỗi ở trên có chung một đặc điểm khiến chúng đáng để ý: không lỗi nào phát ra tín hiệu báo động, và cả hai đều nằm trong những trường mà bên gọi vốn đã nhận được.
Đọc stop_reason, không chỉ đọc kết quả. Kiểm tra hình dạng của câu trả lời trước khi kiểm tra nội dung. Và đo tỷ lệ token vào/ra của chính bạn trước khi so giá.
Cần nói rõ giới hạn của lần đo. Bộ bài test chỉ có 19 bài, nên một bài đạt hay hỏng làm thay đổi tỷ lệ hơn năm điểm phần trăm — hãy coi hai lỗi này là hướng để tự kiểm tra, không phải kết quả để trích dẫn. Lần chạy cũng chưa bao giờ tới gần giới hạn context của cả hai model: file dài nhất khoảng 14.000 token, so với giới hạn công bố là 200.000 và 1.000.000. Tìm một giá trị trong file dài là phép thử khác với việc lấp đầy cửa sổ context. Và toàn bộ phép đo chỉ dùng đầu vào văn bản.
Nếu bạn đang cân nhắc giữa hai model này cho một tác vụ cụ thể, danh sách model theo tác vụ là chỗ để đối chiếu trước khi tự chạy bài kiểm tra của mình. Giá trong bài là giá niêm yết, kiểm tra ngày 22 tháng 10 năm 2026, chưa tính giảm giá cache và giảm giá theo lô.
All Rights Reserved
