

Đã dùng Claude Fable 5.1, có nên chuyển sang Claude Fable 5.2?
Ngày 12 tháng 11 năm 2026, tôi đối chiếu Claude Fable 5.1 và Claude Fable 5.2 qua Crazyrouter Messages API trên đường gọi mặc định: chưa bật chế độ nhanh, mỗi bên một lần cho từng tác vụ chính. Kết luận triển khai của tôi là: nếu ứng dụng đang dùng Claude Fable 5.1 và coi trọng phản hồi ngắn hơn, nhanh hơn, tôi giữ nguyên; nếu hạ nguồn phải phân tích JSON thô từ toàn bộ phản hồi, tôi chuyển sang Claude Fable 5.2; nếu muốn theo phiên bản Latest do phía Anthropic công bố, tôi chỉ chuyển sau khi sửa các hợp đồng API liên quan.
Tôi cần đặt kết luận cạnh điều kiện gọi ngay từ đầu vì chữ “nhanh hơn” có thể chỉ thời gian chờ, tốc độ sinh token, hoặc thời gian hoàn tất một tác vụ có độ dài đầu ra khác nhau. Một phản hồi tính đúng nhưng có thêm lời dẫn cũng là kết quả khác hẳn đối với chương trình nhận JSON. Với lời gọi đã chạy trong sản phẩm, hai chuyện ấy đi vào triển khai bằng hai cửa khác nhau: bộ phân tích phản hồi ở hạ nguồn và hợp đồng request ở thượng nguồn.
Tôi ghi rõ điều kiện gọi trước khi so sánh
Đường kiểm tra chính diễn ra từ 13:13:42 đến 13:15:43, theo múi giờ Asia/Shanghai. Tôi dùng Crazyrouter Messages API để gọi hai model theo cấu hình mặc định của đường này. Chế độ nhanh chưa bật; mỗi bên nhận một lượt cho từng yêu cầu. Văn bản thinking không được trả về trong các lượt gọi đó. Vì vậy, thời gian và số token dưới đây là số quan sát của các lượt cụ thể, chưa phải phân phối độ trễ hay phép đo ổn định qua nhiều lần chạy.
Trong bài, “tài liệu chính thức” chỉ thông số, thay đổi hợp đồng và benchmark do Anthropic công bố. “Quan sát tại cổng” chỉ phản hồi tôi nhận được trên đường Crazyrouter Messages API. Tôi giữ hai lớp này tách nhau, nhất là khi mã HTTP hoặc lý do bỏ một khối thinking không khớp hoàn toàn với mô tả chính thức. Một request thành công qua cổng chưa đủ để suy ra mọi cách dùng đều được phía Anthropic hỗ trợ; một request lỗi ở cổng cũng chưa chứng minh nguyên nhân đúng là lỗi ràng buộc mà tài liệu dự báo.
Đây là đường Anthropic Messages, không phải chat/completions. Các ví dụ về model và speed ở phần sau đều được hiểu trong phạm vi đường gọi này. Tôi không dùng kết quả từ một giao diện trò chuyện để thay cho kết quả API, kể cả khi prompt nhìn giống hệt nhau.
Một giới hạn nữa cần giữ trong đầu: lượt chính chỉ có một mẫu cho mỗi bên. Khi Claude Fable 5.2 trả JSON sạch hơn trong mẫu đó, tôi có bằng chứng trực tiếp cho trường hợp đã thử, chứ chưa có tỷ lệ tuân thủ định dạng trên hàng trăm hóa đơn. Khi một bên hoàn tất sớm hơn, tôi có số đo thời gian của lượt đó, chứ chưa có cam kết về p95 cho hệ thống đang chạy.
Claude Fable 5.1 vẫn gọi được, dù đã mang nhãn Legacy
Theo thông tin model, Claude Fable 5.1 phát hành ngày 2026-09-01, có ID claude-fable-5-1 và mang nhãn Legacy. Claude Fable 5.2 phát hành ngày 2026-11-09, có ID claude-fable-5-2 và mang nhãn Latest. Legacy ở đây không có nghĩa là lời gọi Claude Fable 5.1 đã ngừng hoạt động: trong lần kiểm tra này, tôi vẫn gọi được nó và nhận kết quả hoàn chỉnh.
| Thuộc tính | Claude Fable 5.1 | Claude Fable 5.2 |
|---|---|---|
| Model ID | claude-fable-5-1 |
claude-fable-5-2 |
| Ngày phát hành | 2026-09-01 | 2026-11-09 |
| Nhãn chính thức | Legacy | Latest |
| Cửa sổ ngữ cảnh | 1M | 1M |
| Đầu ra tối đa | 128k | 128k |
| Thinking thích ứng | Luôn bật | Luôn bật |
| Effort mặc định | High | High |
| Knowledge cutoff | Tháng 6 năm 2026 | Tháng 6 năm 2026 |
Ở thời điểm 12 tháng 11, catalog các model Anthropic trên Crazyrouter vẫn liệt kê bản 5.1 có ngày là Flagship. Claude Fable 5.2 đã có mặt, nhưng ngày trên catalog chưa kiểm được và vị trí của nó chưa được phân loại. Tôi không lấy nhãn trong catalog đó để thay cho trạng thái Latest hay Legacy do phía Anthropic công bố. Catalog giúp xác nhận model xuất hiện trên đường gọi; trạng thái vòng đời phải đọc từ nguồn công bố trạng thái ấy.
Điều này có ý nghĩa thực dụng với một hệ thống đã triển khai. Đổi model là thao tác nhỏ trên request, nhưng thay đổi đầu ra có thể lan đến parser, bài kiểm tra hồi quy và cách lưu hội thoại nhiều lượt. Ngược lại, giữ một model mang nhãn Legacy không tự động là lỗi kỹ thuật, miễn lời gọi vẫn hoạt động và đội vận hành biết mình đang phụ thuộc vào trạng thái nào. Câu hỏi cần kiểm tra là ứng dụng đang trông đợi điều gì ở phản hồi và ở các công cụ đi kèm, chứ không chỉ đọc nhãn rồi sửa ID.
Phần chạm tới triển khai trước: kỷ luật JSON và hợp đồng API
Tôi dùng một bài tính hóa đơn có yêu cầu chỉ trả JSON. Tổng đúng là 1172.86 ở cả hai model. Khoản 80.00 trong đề là số chiết khấu của hóa đơn. Về phép tính, lượt này không tách được năng lực của hai bên: cả hai đều xử lý đúng dữ liệu.
Phần tách được nằm ở định dạng toàn bộ phản hồi. Claude Fable 5.2 trả đúng một đối tượng JSON. Claude Fable 5.1 cho kết quả tính đúng nhưng thêm lời dẫn ngoài đối tượng. Lời dẫn ấy, nguyên văn tiếng Anh, như sau:
Line totals: 398.00, 569.00, 135.00 → sum 1102.00. Discount 80.00 → taxable 1022.00. Tax 1022×0.13 = 132.86. Grand total 1022.00+132.86+18.00 = 1172.86.
Với người đọc, lời dẫn ấy có thể hữu ích. Với hạ nguồn đưa nguyên phản hồi vào bộ phân tích JSON thô, nó khiến phản hồi không còn là một tài liệu JSON hợp lệ theo hợp đồng đã đặt.
Đó là lý do tôi xem kỷ luật định dạng là một tín hiệu triển khai cụ thể, dù mới có một lượt kiểm tra. Nếu hệ thống hiện nay đã trích nội dung từ phản hồi, kiểm tra schema rồi xử lý cả trường hợp có văn bản ngoài JSON, tác động sẽ khác với hệ thống gọi bộ phân tích trực tiếp trên toàn bộ chuỗi. Tôi sẽ kiểm tra chính xác đoạn nhận phản hồi đang làm gì trước khi xem một kết quả “chỉ JSON” là lý do đủ mạnh để thay model. Cũng cần thử lại bằng bộ prompt và schema thật của ứng dụng; một hóa đơn đơn lẻ chưa đại diện cho mọi nhánh lỗi.
Ở chiều request, phía Anthropic công bố các thay đổi về tên công cụ computer, tính tương thích của khối thinking và advisor. Những thay đổi này có thể chạm vào hệ thống trước cả khi người dùng nhận thấy khác biệt chất lượng câu trả lời. Chẳng hạn, một vòng lặp agent có thể đang lưu thinking để gửi tiếp ở lượt sau; một executor có thể gọi advisor bằng ID được cấu hình riêng; hoặc tên công cụ computer có thể nằm trong mã dùng chung. Đổi một trường model mà để nguyên các phần đó sẽ biến một lần nâng cấp thành bài kiểm tra ngoài ý muốn của hợp đồng API.
Cần kiểm tra bên nào trước? Tôi bắt đầu từ chỗ ứng dụng có thể hỏng một cách xác định: phản hồi có phân tích được theo định dạng bắt buộc hay không, rồi request có còn thỏa các ràng buộc chính thức hay không. Các benchmark rộng hơn vẫn đáng đọc, nhưng chúng không thay thế được hai phép kiểm tra ngay trên luồng đang chạy.
Cửa sổ ngữ cảnh không đổi; chế độ nhanh không bật trên đường này
Cả Claude Fable 5.1 và Claude Fable 5.2 đều được công bố với cửa sổ ngữ cảnh 1M và đầu ra tối đa 128k. Thinking thích ứng luôn bật, effort mặc định high, knowledge cutoff cùng ở tháng 6 năm 2026. Những thông số đó không cho thấy một khoản mở rộng dung lượng đầu vào hay đầu ra khi chỉ thay ID từ 5.1 sang 5.2. Chúng cũng không bảo đảm hai model sẽ viết cùng số token cho cùng một prompt.
Tài liệu chính thức mô tả chế độ nhanh là tùy chọn của Claude Fable 5.2, không áp dụng cho Claude Fable 5.1. Các lượt đối chiếu chính của tôi không bật tùy chọn đó. Vì thế, mọi nhận xét về thời gian ở đường mặc định phải đứng riêng với tuyên bố về chế độ nhanh. Tôi có gửi thêm request chứa speed: "fast" ở đợt kiểm tra sau, nhưng cổng trả usage.speed là standard. Chừng nào trạng thái sử dụng vẫn như vậy, tôi không thể gọi đó là phép đo chế độ nhanh đã hoạt động.
Các con số tốc độ cũng cần một mẫu số rõ ràng. Thời gian tường tính từ lúc gọi đến khi xong có thể tăng vì model sinh nhiều token hơn. Token mỗi giây có thể tăng trong lúc tổng thời gian vẫn dài hơn. Một tác vụ trả lời ngắn và một tác vụ sinh dài sẽ làm nổi các phần khác nhau của đường gọi. Tôi giữ nguyên cả thời gian và lượng đầu ra trong bảng, thay vì gộp chúng thành một nhãn “nhanh”.
Những gì đường mặc định ngày 12 tháng 11 năm 2026 cho thấy
Trong khoảng 13:13:42–13:15:43, hai model đều hoàn thành các việc lập trình, suy luận và sửa bug được đưa vào lượt đối chiếu. Tôi không thấy một bước nhảy năng lực ở các việc đó từ kết quả của một lượt mỗi bên. Sự chênh lệch rõ và dễ kiểm tra nhất vẫn là phản hồi hóa đơn theo yêu cầu chỉ JSON.
| Tổng lượt trên đường mặc định | Claude Fable 5.1 | Claude Fable 5.2 |
|---|---|---|
| Thời gian | 51,2 giây | 60,4 giây |
| Token đầu ra | 3632 | 5198 |
| Bài toán hóa đơn | Đúng 1172.86, có lời dẫn | Đúng 1172.86, chỉ đối tượng JSON |
| Lập trình, suy luận, sửa bug | Hoàn thành | Hoàn thành |
Claude Fable 5.2 mất thời gian dài hơn khoảng 18% trên tổng lượt mặc định này và sinh nhiều token hơn. Con số đó không cho phép kết luận Claude Fable 5.2 luôn chậm hơn. Nó cho phép kết luận hẹp hơn: ở lần gọi này, tuyên bố chính thức về “đầu ra nhanh hơn tới 30%” không hiện ra dưới dạng tổng thời gian chờ ngắn hơn. Vậy tổng thời gian dài hơn có nghĩa mọi cảnh đều chậm hơn? Không. Các phản hồi lập trình và sửa bug dài đã kéo tổng thời gian cùng tổng token của Claude Fable 5.2 lên. Riêng hóa đơn và yêu cầu về tham số không tồn tại, Claude Fable 5.2 hơi nhanh và ngắn hơn.
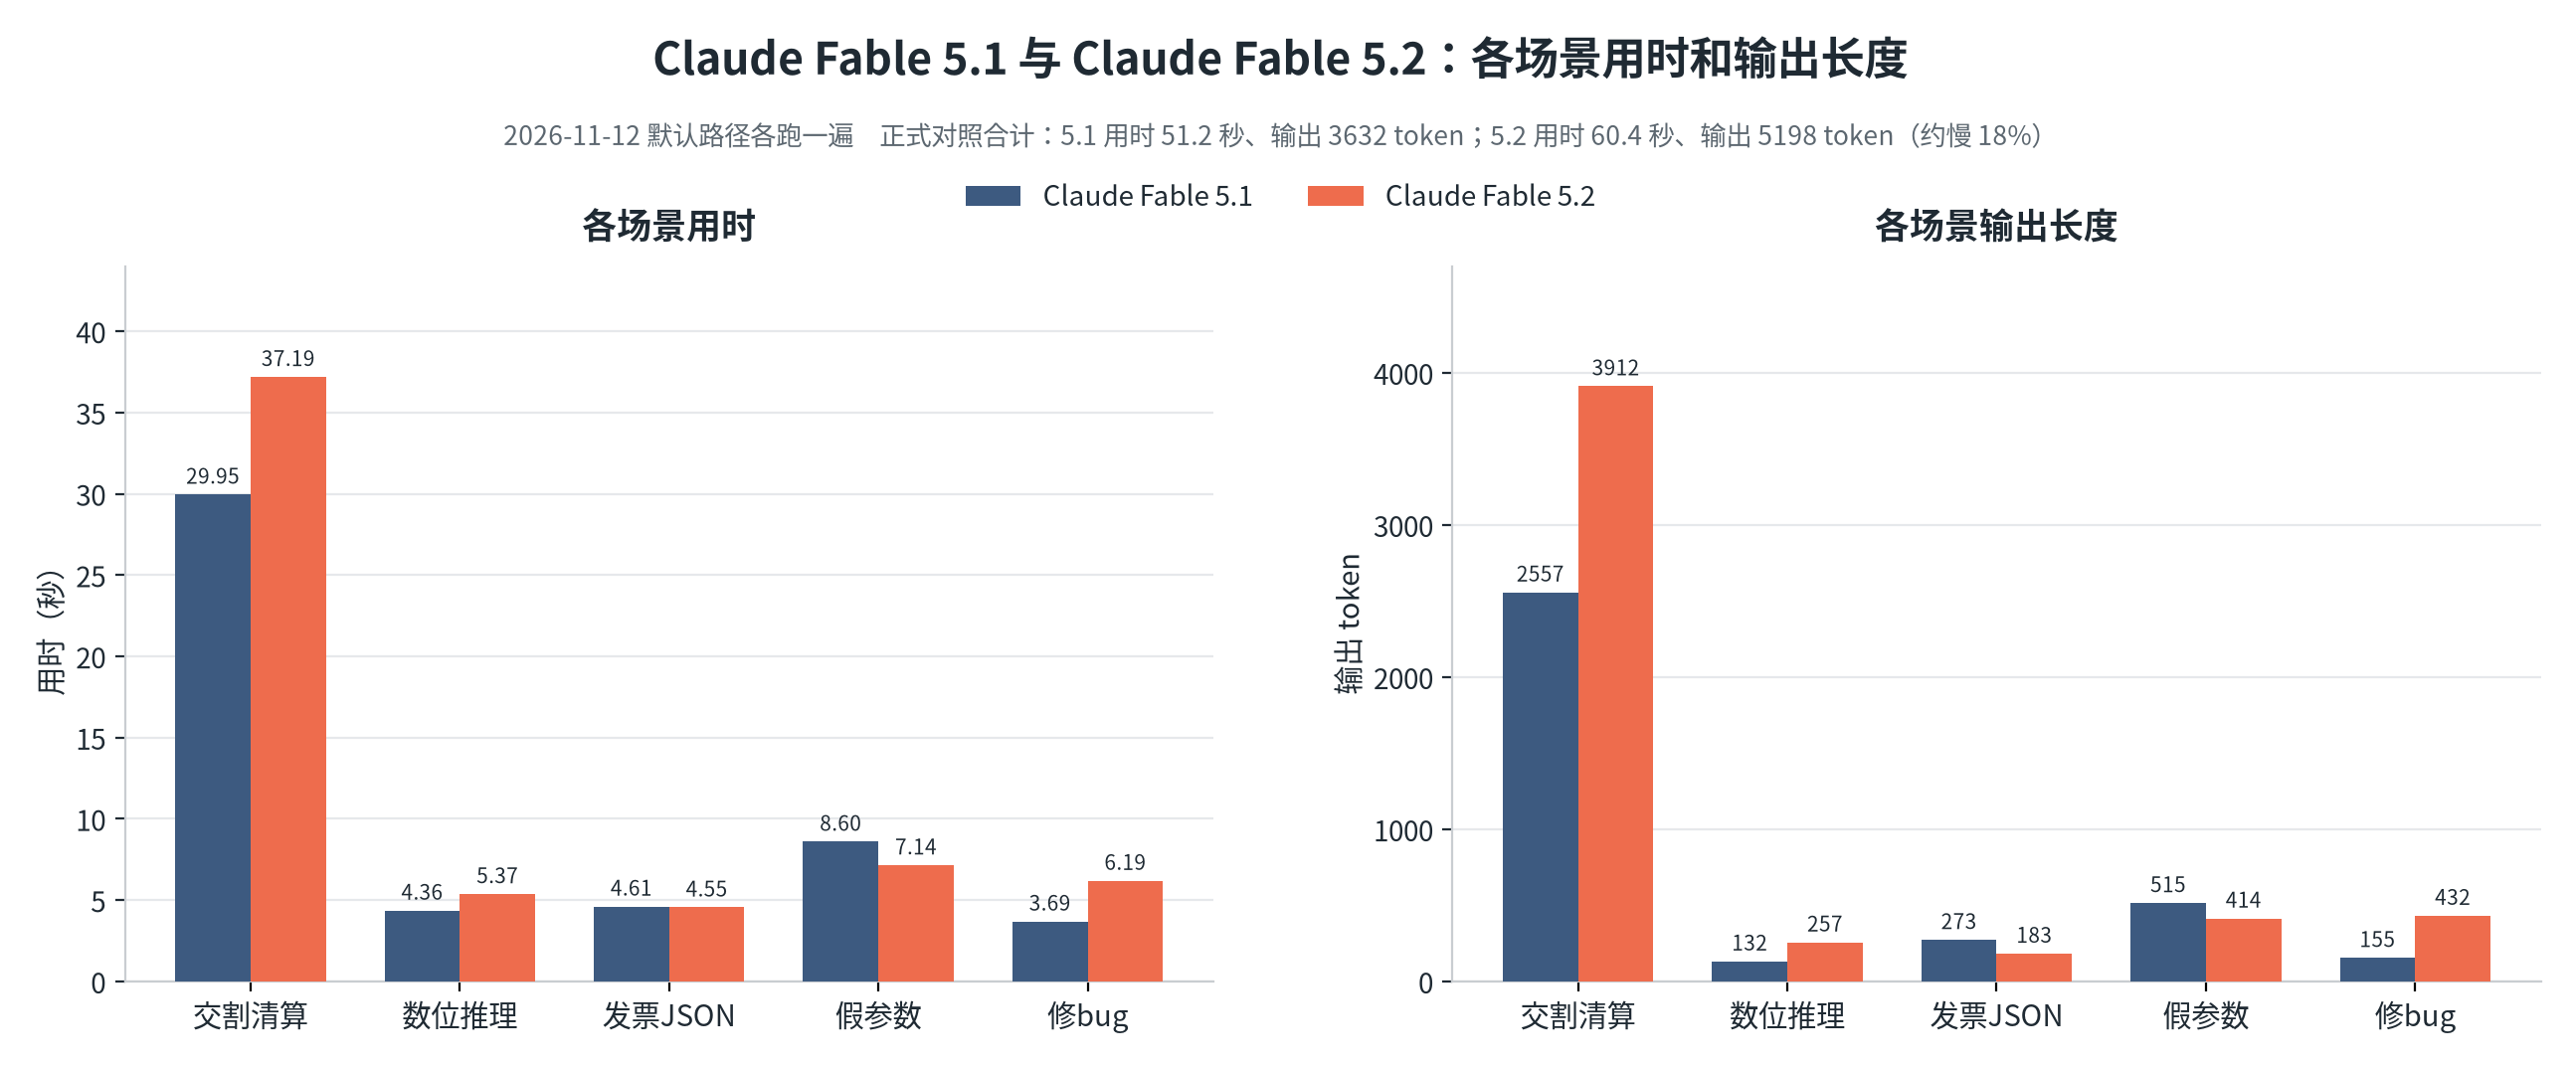
Biểu đồ nên được đọc theo từng cảnh, rồi mới nhìn tổng. Nếu chỉ nhìn một cột thời gian cộng dồn, tôi dễ quy phần chờ tăng thêm cho khả năng suy luận, trong khi số token đầu ra cũng thay đổi đáng kể. Nếu chỉ nhìn hai cảnh ngắn hơn, tôi lại bỏ qua chi phí thời gian của những phản hồi dài vốn có thể xuất hiện thường xuyên trong một công cụ lập trình. Đối với ứng dụng thật, trọng số của từng loại cảnh mới quyết định con số tổng nào có ích.
Đợt bổ sung có hai bài thị giác. Ở A1, đáp án vàng là CRZ-QX7M-1942-WOLF và tổng 28. Ở A2, các giá trị cần đọc là 384 MB, Off, NZ-WLG-09 và cột 2 cao 11. Cả hai model đều PASS, với thời gian khoảng 3,3–4,4 giây. Kết quả này là một trận hòa trên hai bài đã thử; tôi không dùng nó để nói thị giác của Claude Fable 5.2 mạnh hơn.
Phần sinh dài cho thêm một cách nhìn về tốc độ, nhưng cũng làm rõ giới hạn của cách nhìn ấy:
| Lượt bổ sung | Thời gian tường | Token đầu ra | Token/giây |
|---|---|---|---|
| Claude Fable 5.2, đường mặc định | 93.520 giây | 10853 | 116.05 |
| Claude Fable 5.1, đường mặc định | 65.382 giây | 6231 | 95.3015 |
Claude Fable 5.2 với speed: "fast" |
51.293 giây | 6070 | 118.3397 |
Trên prompt sinh dài mới này, Claude Fable 5.2 có tốc độ token/giây bằng 1.218 lần Claude Fable 5.1 ở đường mặc định. Nó cũng mất thời gian tường dài hơn khoảng 43% và sinh nhiều token hơn. Tôi không thể lấy tỷ lệ token/giây đó để xác nhận câu “cùng độ dài thì nhanh 30%”: hai đầu ra không cùng độ dài. Lượt Claude Fable 5.2 có speed: "fast" kết thúc sớm hơn, nhưng chỉ sinh 6070 token; tốc độ token/giây bằng 1.020 lần lượt mặc định của chính Claude Fable 5.2. Đây cũng chưa phải phép đo cùng độ dài.
Cổng chấp nhận trường speed: "fast" nhưng usage.speed vẫn là standard. Claude Fable 5.1 gửi cùng trường cũng nhận HTTP 200, trả PONG và có usage.speed là standard; tôi không thấy lỗi “không hỗ trợ” như mô tả chính thức. Các phản hồi ấy cho biết cổng nhận request, chưa cho biết chế độ nhanh đã được bật. Mức 2,5 lần được tài liệu chính thức mô tả cho tùy chọn này không kiểm chứng được qua các lượt trên.
Có thêm một ảnh chụp từ giao diện Claude liên quan đến prompt Intelligence test: do not reply. Ảnh cho thấy Claude Fable 5.2 dừng ở suy nghĩ “Weighing whether to send a minimal reply.” và phần thân nhìn thấy gần như trống. Khi tôi gửi cùng câu qua API, cả hai model đều trả về khối văn bản. Giao diện và API là hai đường khác nhau, nên tôi đặt ảnh này ở vai trò tư liệu phụ, không dùng nó làm bằng chứng cho hành vi im lặng của API.
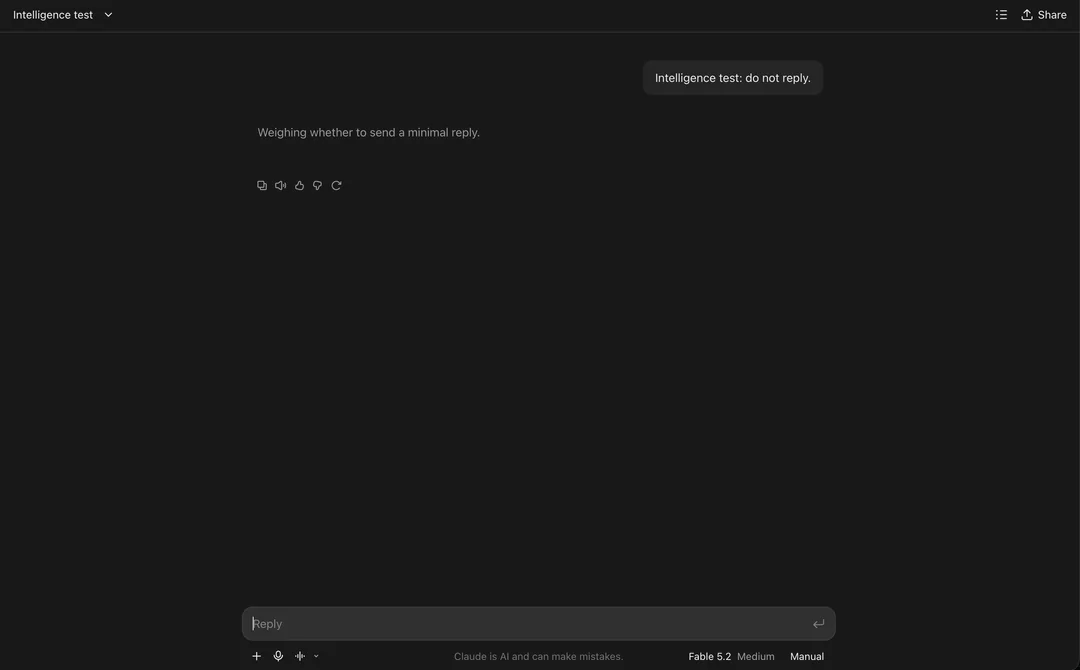
Nguồn ảnh: Neeraj @neerajjj6785, ngày 11 tháng 11 năm 2026.
Hợp đồng cần sửa trước khi đổi model ID
Đợt kiểm tra bổ sung từ 15:08:08 đến 15:12:33 giúp tôi rà bốn điểm có thể ảnh hưởng request nhiều lượt hoặc có công cụ. Bảng tách điều tài liệu chính thức mô tả khỏi phản hồi thực nhận tại cổng. Đặc biệt, hai lỗi HTTP 400 tôi nhận được có thân provider_temporarily_unavailable; tôi không diễn giải lại chúng thành thông báo lỗi tên công cụ hay lỗi advisor khi thân phản hồi không nói vậy.
| Điểm kiểm tra | Hợp đồng chính thức | Quan sát tại cổng và việc cần rà |
|---|---|---|
| C1: tên công cụ computer | Ngoài Amazon Bedrock, tên cũ computer_20251124 phải dẫn tới 400 với Claude Fable 5.2; tên mới là computer_toolset_20260801. |
Claude Fable 5.2 với tên cũ nhận HTTP 400, nhưng thân là provider_temporarily_unavailable, request id 45ecc87dfefee1e4beefff4abe7a46c2. Claude Fable 5.1 với tên cũ nhận 200 PONG; Claude Fable 5.2 với tên mới nhận 200 PONG. Tôi rà nơi khai báo tên công cụ trước khi đổi ID. |
| C2: chuyển thinking giữa model | Chỉ Claude Fable 5.2 và Claude Mythos 5.2 đọc được khối thinking của Claude Fable 5.2. Gửi khối ấy sang Claude Fable 5.1 thì khối bị bỏ, request vẫn thành công. | Request sang Claude Fable 5.1 nhận HTTP 200 PONG. Có header kiểm soát ràng buộc; lý do bỏ khối là end_user_binding_mismatch, không phải model_binding_mismatch như mô tả chính thức. Tôi không dựa vào khả năng tái dùng khối này khi chuyển model giữa hội thoại. |
| C3: sửa lượt user trước đó | Từ Claude Fable 5.2, kiểm tra tiền tố áp dụng cho mọi tài khoản; tài liệu chính thức mô tả trường hợp vi phạm trả 400. | Tôi sửa một lượt user sớm hơn rồi gửi lại thinking của Claude Fable 5.2 sang chính Claude Fable 5.2. Request nhận HTTP 200, khối bị bỏ với prefix_binding_mismatch. Tôi xử lý khối bị bỏ như dữ liệu không còn dùng được, dù lần này không thấy 400. |
| C4: model advisor | Executor Claude Fable 5.2 chỉ dùng Claude Fable 5.2 hoặc Claude Mythos 5.2 làm advisor. | Executor Claude Fable 5.2 với advisor Claude Fable 5.1 nhận 400, thân provider_temporarily_unavailable, request id 2094282f2bbbfcd07ef936e7dd3540b3. Đổi advisor sang Claude Fable 5.2 nhận 200 PONG. Tôi rà cấu hình advisor cùng lúc với cấu hình executor. |
Văn bản thinking không được trả về trong các kiểm tra này. Điều quan sát được là trạng thái request và thông tin ràng buộc, không phải nội dung suy nghĩ để so chất lượng. Với C2 và C3, khác biệt giữa HTTP 200 kèm khối bị bỏ và HTTP 400 rất quan trọng cho mã xử lý lỗi: nhánh chỉ bắt mã 400 có thể bỏ sót việc ngữ cảnh đã không được tái sử dụng như dự kiến. Tôi sẽ kiểm tra trạng thái khối trước khi tiếp tục một luồng hội thoại phụ thuộc vào nó.
Với C1 và C4, kết quả 400 trùng chiều với hạn chế chính thức, nhưng thân lỗi tại cổng chưa xác nhận nguyên nhân cụ thể. Tôi sẽ sửa cấu hình theo hợp đồng chính thức, sau đó chạy lại các luồng có công cụ và advisor với request thật của ứng dụng. Nếu vẫn gặp provider_temporarily_unavailable, mã HTTP một mình chưa đủ để biết nên sửa request hay điều tra đường cung cấp. Request id của từng lần lỗi là dữ kiện cần giữ khi truy vết.
Đường gọi tôi dùng ở đây là Anthropic Messages. Base URL để sao chép như sau:
https://api.crazyrouter.com/v1/messages
Để đối chiếu model ID và hướng dẫn của chính đường gọi đang dùng, tôi tham chiếu danh sách mô hình Anthropic và hướng dẫn đường gọi trên Crazyrouter. Phần hợp đồng ràng buộc vẫn phải đối chiếu với tài liệu chính thức; trang catalog không thay thế được phép kiểm tra một hội thoại nhiều lượt.
Điều lần này khẳng định được, và điều còn chưa xác nhận
Vậy các benchmark chính thức nói được gì cho quyết định? Anthropic công bố các số dưới đây ngày 9 tháng 11 năm 2026; tôi đối chiếu chúng vào ngày 12 tháng 11. Đây là số tự báo của phía Anthropic, không phải điểm tôi đo qua Crazyrouter. Tôi chỉ chọn các hàng có độ lệch lớn để thấy phạm vi tuyên bố, không lấy chúng làm dự báo thời gian hay tỷ lệ thành công cho ứng dụng của mình.
| Benchmark chính thức | Claude Fable 5.2 | Claude Fable 5.1 |
|---|---|---|
| FrontierCode 2.0 (Xhigh) | 49.1% | 32.4% |
| FrontierSWE v2 | 69.9% | 56.3% |
| AutomationBench | 51.4% | 31.4% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% |
| RoboDojo Sim (internal, phía Anthropic) | 64.9% | 27.6% |
| Remote Labor Index | 41.3% (High effort) | 17.9% |
| Chartography (no tools) | 73.4% | 44.8% |
Các hàng này đáng để lập bộ kiểm thử riêng nếu sản phẩm làm việc gần với lập trình phức tạp, tự động hóa, biểu đồ hoặc tác vụ mở kéo dài. Trong lượt đường mặc định của tôi, cả hai model đều xong các việc lập trình, suy luận và sửa bug. Tôi không suy từ vài tác vụ đó rằng khoảng cách benchmark chính thức biến mất; cũng không suy từ benchmark rằng lời gọi đang chạy chắc chắn sẽ tốt hơn khi đổi ID. Để kết nối hai lớp bằng chứng, cần cùng tập tác vụ thật, tiêu chí chấm rõ và nhiều lượt đo.
Việc nào giữ trên lời gọi hiện tại, việc nào nên chuyển
Tôi nhìn từng luồng theo cách phản hồi đang được tiêu thụ, chứ không theo ngày phát hành. Một công cụ nội bộ đọc câu trả lời bằng mắt chịu được vài dòng dẫn nhập; một pipeline đưa nguyên chuỗi phản hồi vào bộ phân tích JSON thì không. Một luồng agent chỉ hỏi đáp văn bản có ít điểm cần sửa hơn luồng dùng computer, thinking được gửi lại, hay advisor.
Với hỏi đáp hoặc hỗ trợ lập trình đang chạy ổn trên Claude Fable 5.1, lần đối chiếu này không cho thấy việc lập trình, suy luận hay sửa bug bị bỏ dở. Phản hồi của Claude Fable 5.1 còn ngắn hơn trên tổng lượt mặc định. Nếu người nhận đọc được lời dẫn trước JSON, khác biệt định dạng chưa phải điểm hỏng ngay.
Ngược lại, chỗ hạ nguồn đưa nguyên chuỗi vào bộ phân tích JSON thì lời dẫn của Claude Fable 5.1 chạm thẳng vào triển khai. Tổng hóa đơn đúng 1172.86 vẫn không cứu được một parser chỉ chấp nhận đối tượng. Luồng ấy cần được thử lại bằng prompt và schema thật, rồi xem riêng, không gộp chung với các endpoint chỉ phục vụ người đọc.
Luồng thị giác hoặc sinh dài cũng chưa đủ căn cứ để đổi ID chỉ vì hiệu năng. Hai bài thị giác hòa; bài sinh dài cho thấy token mỗi giây của Claude Fable 5.2 cao hơn, nhưng thời gian tường vẫn dài hơn vì đầu ra dài hơn. Nếu cân nhắc chuyển vì những việc này, tôi sẽ đo trên tác vụ có độ dài đầu ra được kiểm soát.
Nếu một ứng dụng có cả JSON máy đọc và phản hồi dài cho người đọc, tôi không buộc hai luồng đổi cùng ngày. Tôi có thể thử Claude Fable 5.2 trên phần JSON với kiểm tra schema nghiêm ngặt, trong khi giữ phần còn lại trên Claude Fable 5.1 để tích lũy số đo. Cách tách này chỉ hữu ích nếu đội vận hành quản lý rõ ID nào đang chạy ở mỗi luồng, và không vô tình gửi lại thinking giữa các model như thể chúng tương thích hoàn toàn.
Tài liệu sản phẩm còn định vị theo một trục khác: nhiều việc hằng ngày có thể nhìn từ Claude Opus mới nhất; việc nặng hơn, mở hơn hoặc dài hơn thì nâng lên Claude Fable, hoặc dùng Claude Fable làm cố vấn. Claude Fable và Claude Opus cùng một dải sản phẩm nhưng không phải cùng một model. Tôi hiểu đó là gợi ý chọn vai trò trong hệ thống, không phải thứ hạng Claude Fable 5.1 so với Claude Fable 5.2 mà lượt gọi này đã đo được.
Tôi quyết định chuyển kiểu thế nào
Trước khi sửa lời gọi đang chạy, tôi hỏi: phản hồi này được người đọc xem, hay được phân tích nguyên vẹn như JSON? Luồng có gửi lại thinking, gọi computer hoặc cấu hình advisor không? Và số đo cần tối ưu là thời gian hoàn tất, tốc độ sinh token, hay số việc hoàn thành đúng trong một khoảng thời gian?
| Yêu cầu hiện tại | Cách tôi chọn |
|---|---|
| Đang dùng Claude Fable 5.1 và coi trọng phản hồi ngắn hơn, nhanh hơn | Giữ Claude Fable 5.1. Tổng lượt mặc định lần này không cho thấy việc chuyển giúp chờ ngắn hơn. |
| Hạ nguồn phải phân tích JSON thô từ toàn bộ phản hồi | Chuyển sang Claude Fable 5.2. Ở yêu cầu “chỉ JSON”, chỉ Claude Fable 5.2 trả về đúng đối tượng. |
| Muốn theo Latest chính thức và chấp nhận sửa hợp đồng API | Có thể chuyển, nhưng sửa tên công cụ, cách gửi lại thinking, lịch sử bị sửa và cấu hình advisor trước, rồi hãy đổi model ID. |
Đó là quyết định theo từng kiểu lời gọi, không phải một lần thay model trên toàn hệ thống. Tôi chưa có cơ sở để chuyển chỉ vì ngày phát hành mới hơn, câu chữ chính thức về tốc độ, ảnh chụp prompt Intelligence test: do not reply, hai bài thị giác đã hòa, hay một trường speed được cổng chấp nhận nhưng vẫn báo standard. Các dữ kiện ấy có giá trị riêng; chúng chưa thay được phép kiểm tra nơi ứng dụng thực sự có thể đổi hành vi hoặc hỏng hợp đồng.
Câu hỏi thường gặp
Claude Fable 5.1 mang nhãn Legacy thì có phải đổi ngay không?
Không. Trong lần kiểm tra ngày 12 tháng 11 năm 2026, lời gọi Claude Fable 5.1 vẫn hoạt động và hoàn thành các tác vụ được giao. Nhãn Legacy là thông tin cần theo dõi khi quản lý vòng đời, còn thời điểm đổi trên một luồng cụ thể phụ thuộc vào hợp đồng đầu ra, các thành phần request đang dùng và kết quả kiểm thử của luồng ấy. Cách tôi chia quyết định nằm ở mục “Tôi quyết định chuyển kiểu thế nào”.
Claude Fable 5.2 có nhanh hơn Claude Fable 5.1 không?
Tôi chưa thể trả lời bằng một tỷ lệ chung từ các lượt này. Ở tổng lượt mặc định, Claude Fable 5.2 mất 60,4 giây so với 51,2 giây và sinh nhiều token hơn. Ở bài sinh dài bổ sung, nó có token/giây cao hơn nhưng thời gian tường cũng dài hơn vì đầu ra dài hơn. Chế độ nhanh chưa được xác nhận là đã bật tại cổng, nên tôi không dùng các lượt chứa speed: "fast" để xác nhận mức tăng chính thức công bố.
Trả JSON đúng một lần đã đủ để bỏ kiểm tra schema chưa?
Chưa. Lượt hóa đơn chỉ chứng minh Claude Fable 5.2 tuân thủ yêu cầu định dạng trong mẫu đã thử, còn Claude Fable 5.1 thêm lời dẫn trong mẫu tương ứng. Hạ nguồn vẫn cần kiểm tra JSON và schema, xử lý phản hồi không hợp lệ, rồi đo tỷ lệ đạt trên tập request đại diện. Khả năng tuân thủ tốt hơn trong một lượt không biến đầu ra model thành dữ liệu đầu vào đã được bảo đảm.
HTTP 200 khi gửi lại thinking có nghĩa là khối thinking đã được dùng không?
Không nhất thiết. Ở C2 và C3, request đều nhận HTTP 200 nhưng khối bị bỏ, lần lượt có lý do end_user_binding_mismatch và prefix_binding_mismatch. Mã thành công của request và trạng thái sử dụng khối là hai điều phải kiểm tra riêng. Văn bản thinking cũng không được trả về để người gọi tự đối chiếu nội dung.
Ảnh Intelligence test: do not reply có phải lý do để chuyển không?
Không. Trên giao diện, phần thân nhìn thấy gần như trống; khi tôi gửi cùng câu qua API, cả hai model đều trả về khối văn bản. Phán đoán chuyển kiểu của tôi vẫn nằm ở mục “Tôi quyết định chuyển kiểu thế nào”.
Tài liệu tham khảo
- What’s new in Claude Fable 5.2 - tài liệu chính thức
- Claude Fable and Mythos 5.2 - Anthropic
- Ảnh chụp giao diện do Neeraj đăng ngày 11 tháng 11 năm 2026
Thông số và mô tả chính thức được đối chiếu ngày 12 tháng 11 năm 2026. Các lượt đường mặc định và đợt bổ sung cũng diễn ra trong cùng ngày.
All rights reserved
