

Các thuật toán K-Medoids: Từ PAM, CLARA, CLARANS đến FastCLARANS
Ở bài viết trước, chúng ta đã thấy K-Medoids giảm ảnh hưởng của các điểm ngoại lai cực đoan bằng cách chọn quan sát thực tế làm tâm cụm (medoid) và tối thiểu hóa trực tiếp tổng khoảng cách bậc một thay cho tổng bình phương khoảng cách. Thuật toán này cũng làm việc được với nhiều độ đo bất tương đồng khác nhau, bao gồm cả ma trận khoảng cách tính trước tùy theo hỗ trợ của từng thư viện.
Tuy nhiên, K-Medoids truyền thống ít khi xuất hiện trên các tập dữ liệu lớn vì chi phí tính toán cao: bài toán tìm tập medoid tối ưu trên không gian rời rạc là bài toán NP-hard, tương đương với bài toán -median trong lý thuyết đồ thị. Qua hơn ba thập kỷ, bài toán mở rộng quy mô cho K-Medoids lần lượt được giải quyết bằng bốn thuật toán: PAM (1990), CLARA (1990), CLARANS (1994, 2002) và FastCLARANS (2021).
1. PAM và chi phí tính toán bậc hai
Thuật toán PAM (Partitioning Around Medoids), do Leonard Kaufman và Peter J. Rousseeuw giới thiệu năm 1990, tìm tập medoid qua hai giai đoạn: khởi tạo (BUILD) và hoán đổi (SWAP).
Giai đoạn khởi tạo (BUILD)
PAM chọn medoid ban đầu theo chiến lược tham lam. Điểm dữ liệu có tổng khoảng cách đến tất cả các điểm còn lại nhỏ nhất được chọn làm tâm đầu tiên. Ở các bước tiếp theo, PAM lần lượt thêm vào tập medoid điểm dữ liệu giúp giảm nhiều nhất tổng khoảng cách từ mỗi điểm đến medoid gần nhất, lặp lại cho đến khi đủ medoid.
Giai đoạn hoán đổi (SWAP)
Từ medoid ban đầu, PAM thực hiện tìm kiếm cục bộ để giảm chi phí phân cụm. Ở mỗi vòng lặp, thuật toán xét mọi cặp hoán đổi giữa một medoid hiện tại và một điểm không phải medoid , rồi tính lượng biến thiên của tổng chi phí phân cụm nếu thay bằng . Sau khi duyệt hết các cặp, nếu cặp tốt nhất có mức biến thiên âm (tổng chi phí giảm), PAM thực hiện phép hoán đổi đó và chuyển sang vòng lặp mới. Thuật toán dừng khi không còn cặp hoán đổi nào làm giảm chi phí.
Điểm nghẽn tính toán của PAM
Xét tập dữ liệu có mẫu và cụm. Với medoid và ứng viên không phải medoid, mỗi vòng lặp SWAP có cặp hoán đổi cần kiểm tra. Để tính biến thiên chi phí cho từng cặp trong cài đặt PAM cổ điển, thuật toán phải duyệt qua điểm còn lại nhằm so sánh khoảng cách tới medoid mới và medoid cũ. Độ phức tạp của một vòng lặp SWAP vì thế lên tới , chưa tính chi phí khởi tạo BUILD và tổng số vòng lặp SWAP cho đến khi hội tụ.
Khi và , riêng một vòng lặp SWAP đã cần xấp xỉ bước đánh giá chi phí. Nếu tính khoảng cách trực tiếp trong lúc chạy (on-the-fly) để tiết kiệm bộ nhớ, CPU sẽ tốn nhiều thời gian tính lại khoảng cách giữa các điểm. Ngược lại, nếu lưu trước ma trận khoảng cách trong bộ nhớ để tra cứu thì mỗi vòng lặp vẫn mất phép cộng và so sánh; tại , ma trận kiểu float64 này chiếm tới 20 GB RAM (khoảng 18,6 GiB). Trên thực tế, giới hạn xử lý của PAM còn tùy thuộc vào cấu hình phần cứng, độ đo khoảng cách hoặc việc áp dụng các biến thể tăng tốc như FastPAM.
2. CLARA: Phân cụm trên các tập mẫu con
Cùng năm 1990, Kaufman và Rousseeuw giới thiệu thêm thuật toán CLARA (Clustering Large Applications) để cải thiện tốc độ của PAM trên dữ liệu lớn.
Ý tưởng lấy mẫu
CLARA giảm khối lượng tính toán bằng cách chạy PAM trên các tập mẫu con ngẫu nhiên qua vòng lặp (thường mặc định ):
- Rút ngẫu nhiên một tập mẫu con kích thước nhỏ từ điểm (tài liệu gốc và
scikit-learn-extrathường dùng quy tắc mặc định ). - Chạy PAM trên tập con để tìm medoid.
- Gán toàn bộ điểm của tập dữ liệu gốc về medoid gần nhất trong medoid vừa tìm được và tính tổng chi phí phân cụm trên toàn tập dữ liệu.
- Lặp lại quy trình trên lần với các tập mẫu ngẫu nhiên khác nhau, sau đó giữ lại tập medoid có tổng chi phí trên toàn tập dữ liệu nhỏ nhất.
Đánh đổi của CLARA
Do chỉ chạy PAM trên tập con có kích thước cố định , tổng thời gian chạy của CLARA qua lần lấy mẫu là:
Trong đó là tổng chi phí chạy PAM (gồm cả bước BUILD và các vòng lặp SWAP với chi phí mỗi vòng) trên mẫu con kích thước , còn là chi phí tính khoảng cách để gán toàn bộ điểm vào medoid ở bước đánh giá (hoặc nếu tính khoảng cách trực tiếp trên vector chiều).
Đổi lại, chất lượng phân cụm của CLARA phụ thuộc vào tính đại diện của các mẫu con được rút ra. Trong mỗi vòng lấy mẫu, các medoid ứng viên chỉ được chọn từ bên trong tập con . Dù việc lặp lại lần giúp mở rộng cơ hội cho các điểm khác nhau và kết quả cuối cùng vẫn được chấm điểm trên toàn bộ điểm, một điểm đại diện tốt nhưng vô tình không lọt vào mẫu con nào trong cả lần rút mẫu sẽ không thể trở thành medoid. Hạn chế này bộc lộ rõ khi tập dữ liệu có các cụm kích thước nhỏ hoặc phân bố mật độ không đồng đều.
3. CLARANS: Mô hình hóa đồ thị hoán đổi (Swap Graph)
Được Raymond T. Ng và Jiawei Han đề xuất tại hội nghị VLDB năm 1994 và hoàn thiện trên tạp chí IEEE TKDE năm 2002, thuật toán CLARANS (Clustering Large Applications based on RANdomized Search) giữ nguyên toàn bộ tập dữ liệu và lấy mẫu trực tiếp trên không gian tìm kiếm thông qua mô hình đồ thị.
Không gian tìm kiếm dạng đồ thị
CLARANS biểu diễn bài toán K-Medoids thành một đồ thị vô hướng có đỉnh, trong đó mỗi đỉnh ứng với một tập hợp gồm medoid. Hai đỉnh nối với nhau bằng một cạnh nếu hai tập medoid chỉ khác nhau đúng một phần tử, tức có thể chuyển qua lại bằng một phép hoán đổi medoid. Mỗi đỉnh có bậc tương ứng với số láng giềng có thể hoán đổi. Mục tiêu của bài toán là tìm đỉnh có tổng chi phí phân cụm thấp trên đồ thị.
Tìm kiếm cục bộ ngẫu nhiên (Randomized Local Search)
Thay vì duyệt toàn bộ láng giềng như PAM, CLARANS lấy mẫu ngẫu nhiên trên đồ thị theo các bước:
- Bắt đầu tại một đỉnh ngẫu nhiên (tập medoid ban đầu).
- Từ đỉnh hiện tại, chọn ngẫu nhiên một đỉnh láng giềng bằng cách lấy ngẫu nhiên một medoid và một ứng viên .
- Nếu phép hoán đổi làm giảm tổng chi phí, chuyển ngay sang đỉnh láng giềng đó và đặt lại bộ đếm số lần thử thất bại về 0 (cơ chế hoán đổi tức thì, hay eager swap).
- Nếu chi phí không giảm, tăng bộ đếm thất bại thêm 1 và chọn ngẫu nhiên một láng giềng khác để thử tiếp.
- Khi đã thử liên tiếp
max_neighborsláng giềng mà không tìm được bước đi nào giảm chi phí, dừng nhánh tìm kiếm hiện tại và xem đỉnh đang đứng là một cực tiểu cục bộ xấp xỉ. - Lặp lại quy trình trên
num_locallần từ các đỉnh khởi tạo khác nhau để chọn ra tập medoid có tổng chi phí thấp nhất.
Vì chỉ lấy mẫu một phần láng giềng, CLARANS mang tính xấp xỉ: thuật toán không đảm bảo tìm được nghiệm tối ưu toàn cục và cũng không duyệt hết cạnh để xác nhận cực tiểu cục bộ tuyệt đối như PAM. Bài báo gốc của Ng và Han khuyến nghị đặt num_local = 2 cùng ngân sách max_neighbors khoảng 1.25% tổng số láng giềng, tức . Khi triển khai thực tế trong các thư viện như scikit-clarans, chế độ mặc định max_neighbors='auto' kết hợp tỷ lệ 1.25% này với mức sàn tối thiểu 250 phép thử: .
4. FastCLARANS: Đánh giá delta đồng thời k medoid
Ở mỗi phép thử, CLARANS cổ điển chỉ đánh giá một cạnh hoán đổi đơn lẻ được chọn ngẫu nhiên. Khi số cụm tăng, việc tính khoảng cách từ ứng viên đến toàn bộ điểm chỉ để kiểm tra một phương án thay thế duy nhất gây lãng phí, vì nhiều cặp ngẫu nhiên không làm giảm chi phí. Kỹ thuật FastPAM1 của Erich Schubert và Peter J. Rousseeuw (2021) tận dụng một lượt tính khoảng cách để đánh giá đồng thời cả medoid, hình thành biến thể FastCLARANS.
Cơ chế FastPAM1 delta
Ở mỗi bước thử, FastCLARANS chọn ngẫu nhiên một ứng viên không phải medoid . Trong một lượt duyệt qua điểm dữ liệu, thuật toán tính đồng thời biến thiên chi phí cho cả phương án thay thế từng medoid () bằng ứng viên . Nếu phương án tốt nhất trong medoid có mức biến thiên âm (), thuật toán thực hiện hoán đổi ngay và đặt lại bộ đếm; ngược lại, ứng viên được tính là một lần thử không cải thiện.
Để đánh giá trong một lượt duyệt dữ liệu, thuật toán duy trì ba mảng một chiều cho mỗi điểm dữ liệu : chỉ số của medoid gần nhất hiện tại, khoảng cách đến medoid gần nhất và khoảng cách đến medoid gần thứ nhì . Cách tổ chức này giữ bộ nhớ phụ của pha tìm kiếm ở mức mà không cần cấp phát ma trận khoảng cách . Khi xét ứng viên mới , với mỗi điểm , ta tính khoảng cách và xác định lượng biến thiên chi phí khi thay medoid bằng theo hai trường hợp:
Một lượt duyệt của FastCLARANS chỉ cần phép tính khoảng cách và cập nhật (tương đương phép toán số học nếu tính trực tiếp trên vector chiều) nhờ hai tính chất:
- Khoảng cách chỉ tính một lần cho mỗi điểm rồi dùng lại cho cả medoid, giảm lần số phép tính khoảng cách trên mỗi cạnh được khảo sát so với CLARANS cổ điển.
- Khi , do nên . Khi ứng viên nằm gần hơn medoid hiện tại, mức giảm chi phí áp dụng đồng nhất cho cả medoid (kể cả medoid mà đang thuộc về), nên thuật toán chỉ cần cộng giá trị này vào một biến tích lũy chung. Ngược lại, khi , các medoid khác không đổi chi phí (), chỉ riêng medoid gần nhất của chịu mức tăng và được cộng trực tiếp vào vị trí của medoid đó trong mảng tích lũy thông qua chỉ số cụm đã lưu với chi phí .
Vì mỗi ứng viên cho phép kiểm tra cùng lúc cạnh trên đồ thị hoán đổi, nếu quy đổi tương đương với ngân sách cạnh của CLARANS lý thuyết, số ứng viên cần lấy mẫu vào khoảng . Trong thư viện scikit-clarans, tham số max_neighbors của FastCLARANS là số ứng viên tối đa được lấy mẫu liên tiếp khi chưa có cải thiện, với chế độ mặc định 'auto' tính theo công thức .
5. So sánh thực nghiệm CLARANS và FastCLARANS
Để quan sát sự khác biệt về thời gian chạy và chất lượng phân cụm với cấu hình mặc định, ta chạy thử nghiệm so sánh CLARANS và FastCLARANS trong scikit-clarans trên dữ liệu Gaussian tổng hợp với số mẫu tăng từ 500 đến 3.500 điểm và số cụm cố định .
import time
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from clarans import CLARANS, FastCLARANS

Ns = [500, 1000, 2000, 3500]
k = 6
clarans_times, fast_times = [], []
clarans_inertias, fast_inertias = [], []

for N in Ns:
    X, _ = make_blobs(n_samples=N, centers=k, cluster_std=0.7, random_state=42)

    # Đo thời gian CLARANS cổ điển (cấu hình mặc định max_neighbors='auto')
    t0 = time.perf_counter()
    m_c = CLARANS(n_clusters=k, num_local=2, random_state=42).fit(X)
    clarans_times.append(time.perf_counter() - t0)
    clarans_inertias.append(m_c.inertia_)

    # Đo thời gian FastCLARANS (cấu hình mặc định max_neighbors='auto')
    t0 = time.perf_counter()
    m_f = FastCLARANS(n_clusters=k, num_local=2, random_state=42).fit(X)
    fast_times.append(time.perf_counter() - t0)
    fast_inertias.append(m_f.inertia_)

# Vẽ đồ thị so sánh thời gian và chất lượng phân cụm
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(11, 4.2))

ax1.plot(Ns, clarans_times, marker='o', color='#2b5c8f', label='CLARANS (Classic)')
ax1.plot(Ns, fast_times, marker='s', color='#1b9e77', label='FastCLARANS (FastPAM1)')
ax1.set_xlabel('Số lượng mẫu (N)')
ax1.set_ylabel('Thời gian chạy (giây)')
ax1.set_title('(a) Thời gian thực thi theo kích thước dữ liệu (k=6)')
ax1.legend()
ax1.grid(True, linestyle='--', alpha=0.4)

ax2.plot(Ns, clarans_inertias, marker='o', color='#2b5c8f', label='CLARANS')
ax2.plot(Ns, fast_inertias, marker='s', color='#1b9e77', linestyle='--', label='FastCLARANS')
ax2.set_xlabel('Số lượng mẫu (N)')
ax2.set_ylabel('Tổng chi phí phân cụm (Inertia)')
ax2.set_title('(b) Chất lượng phân cụm (Inertia tương đương)')
ax2.legend()
ax2.grid(True, linestyle='--', alpha=0.4)

plt.tight_layout()
plt.show()
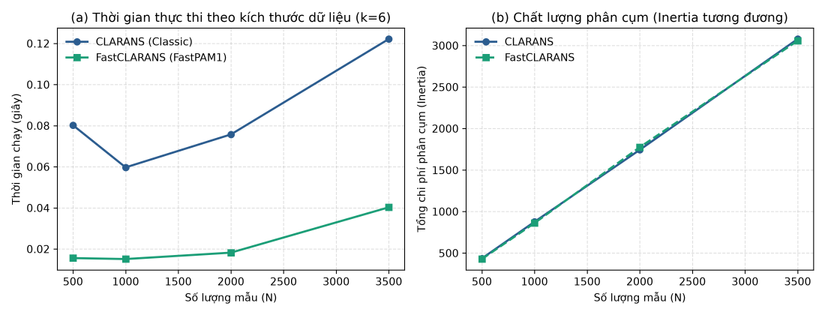
Trên tập dữ liệu từ đến mẫu với cấu hình mặc định (num_local=2, max_neighbors='auto'), ở Hình a, dù chế độ 'auto' của FastCLARANS đặt tỷ lệ lấy mẫu ứng viên ở mức 2.5% của (tương ứng số cạnh được đánh giá gấp đôi so với tỷ lệ 1.25% của CLARANS), FastCLARANS vẫn hoàn thành nhanh hơn từ 3 đến 4 lần nhờ gộp phép đánh giá medoid vào chung một lượt tính khoảng cách.
Ở Hình b, thuộc tính inertia_ trong scikit-clarans biểu thị tổng khoảng cách bậc một từ toàn bộ điểm đến medoid gần nhất (khác với tổng bình phương khoảng cách trong KMeans của scikit-learn). Do cộng dồn trên toàn tập mẫu nên inertia_ tăng tuyến tính theo , và đường biểu diễn của hai thuật toán gần như trùng nhau tại mọi mốc kích thước dữ liệu.
Thời gian chạy thực tế sẽ dao động tùy theo phần cứng, hạt giống ngẫu nhiên (random_state), số bước hoán đổi thành công và ngân sách max_neighbors. Khi đánh giá trên các bài toán lớn, bạn có thể lấy trung vị qua nhiều hạt giống ngẫu nhiên và theo dõi chi phí trung bình trên mỗi điểm ().
6. Bảng so sánh bốn biến thể K-Medoids
| Thuật toán | Năm | Không gian tìm kiếm | Chiến lược hoán đổi | Chi phí tính toán đặc trưng | Bộ nhớ phụ (pha tìm kiếm) |
|---|---|---|---|---|---|
| PAM | 1990 | Toàn bộ dữ liệu | Duyệt vét cạn cặp | mỗi vòng lặp SWAP | nếu lưu ma trận, hoặc nếu tính lại khoảng cách |
| CLARA | 1990 | mẫu con ngẫu nhiên kích thước | Chạy PAM trên từng mẫu con | trên mẫu con | |
| CLARANS | 1994, 2002 | Đồ thị hoán đổi | Lấy mẫu ngẫu nhiên từng cặp | phép tính khoảng cách mỗi lượt thử; dừng sau max_neighbors lần thất bại liên tiếp |
(chưa tính chi phí khởi tạo) |
| FastCLARANS | 2021 | Đồ thị hoán đổi | Đánh giá đồng thời cả medoid cho mỗi ứng viên qua | phép tính khoảng cách mỗi ứng viên; dừng sau max_neighbors ứng viên thất bại liên tiếp |
(chưa tính chi phí khởi tạo) |
Trong bài viết tiếp theo, chúng ta sẽ đi vào phần thực hành: cài đặt thư viện scikit-clarans trong Python, tích hợp mô hình vào Pipeline của Scikit-Learn và thiết lập hàm chấm điểm (scoring) tùy chỉnh với GridSearchCV để tìm kiếm siêu tham số cho bài toán phân cụm không giám sát.
All rights reserved
