

Bốn model AI tôi dùng song song một tháng: cái nào nhanh, cái nào đáng tiền
Bốn model này là gì
Cả bốn đều là model ngôn ngữ lớn: bạn gửi văn bản vào, nó trả văn bản ra. Cách dùng giống hệt nhau — mở một trang chat hoặc gọi qua API, dán nội dung, đặt câu hỏi. Khác nhau ở nhà sản xuất, mức giá và tính cách.
- DeepSeek V4-Pro — của DeepSeek. 0,67 USD mỗi triệu token đầu vào, 2,00 USD đầu ra.
- Qwen3.8 Max — của Alibaba. 2,00 / 6,00.
- GLM-5 — của Zhipu. 1,00 / 3,20.
- Gemini 3.8 Flash — của Google. 0,75 / 3,75, và đọc được tài liệu rất dài trong một lần.
"Token" chỉ là đơn vị chữ mà model xử lý — hiểu đơn giản là một mẩu chữ, dài cỡ ba bốn ký tự. Giá tính theo triệu token, nên bạn không cần nhớ con số tuyệt đối, chỉ cần biết model nào đắt gấp mấy lần model nào.
Trong một tháng, tôi giao cùng một loại việc cho cả bốn, mỗi việc làm vài lần. Dưới đây là những gì tôi thấy.
Tôi giao cho chúng việc gì
Năm loại việc, đều là việc văn phòng bình thường:
- Đọc tài liệu dài rồi trả lời câu hỏi. Đưa vào một tệp 30-40 trang (hợp đồng, hướng dẫn sử dụng) rồi hỏi "điều khoản về hoàn tiền nằm ở đâu, nói gì".
- Rút dữ liệu ra khỏi văn bản lộn xộn. Đưa một đoạn email hoặc log, yêu cầu trả về đúng vài trường: ngày, số tiền, tên.
- Viết và sửa code. Nhờ viết một đoạn script nhỏ, hoặc nhờ tìm lỗi trong đoạn code có sẵn.
- Tóm tắt và viết lại. Biên bản họp, email dài, ghi chú lộn xộn thành văn bản gọn.
- Dịch và trau câu. Chủ yếu Việt - Anh, và đôi khi kiểm tra lại câu chữ.
Cảm nhận sau một tháng
Nói trước điều quan trọng nhất: về chất lượng, không model nào vượt trội rõ rệt. Cả bốn đều làm được năm việc trên. Cái tôi nhận ra là chúng khác nhau ở cách trả lời, và chính cái đó mới ảnh hưởng đến bạn hằng ngày.
Về tốc độ. Gemini 3.8 Flash trả lời nhanh nhất, gần như hiện chữ ngay. Qwen3.8 Max và DeepSeek V4-Pro chậm hơn khi chờ câu trả lời đầu tiên — cảm giác vài giây, đủ để bạn rời mắt khỏi màn hình.
Nhưng tốc độ đó gây hiểu nhầm. Model nhanh hay trả lời ngắn rồi bạn phải hỏi thêm "ý là sao", "còn trường hợp kia thì sao". Cộng ba lần hỏi lại thì tổng thời gian dài hơn một lần trả lời chậm nhưng đầy đủ. Nên đo bằng "xong việc mất bao lâu", không phải "hiện chữ nhanh bao nhiêu".
Về độ dài câu trả lời. Đây là khác biệt tôi thấy rõ nhất. Có model trả lời đúng cái được hỏi rồi dừng. Có model trả lời xong còn kèm một đoạn giải thích, một đoạn "lưu ý rằng", một đoạn tóm tắt lại những gì vừa nói.
Với người đọc thì đoạn thêm đó có khi hữu ích. Với người đưa kết quả vào code thì nó là rác — và vì giá đầu ra đắt gấp ba bốn lần giá đầu vào, nó cũng là tiền.
Về đọc tài liệu dài. Gemini 3.8 Flash có lợi thế thật ở đây vì nhận được rất nhiều trang trong một lần, không phải cắt nhỏ tài liệu ra rồi ghép lại. Cắt nhỏ là chỗ sinh lỗi: đoạn bị chặt giữa câu, thông tin nằm ở hai mảnh khác nhau.
Về code. DeepSeek V4-Pro là cái tôi quay lại nhiều nhất khi cần sửa code, đơn giản vì nó trả lời gọn và ít khi phải hỏi lại. Nhưng đây là cảm nhận từ công việc của tôi, không phải kết quả đo.
Về tiếng Việt. Cả bốn đều viết được tiếng Việt dễ đọc. Không cái nào sai ngữ pháp đến mức phải sửa lại từ đầu, nhưng câu chữ đều hơi "dịch" — đúng nghĩa, hơi cứng. Nếu bạn cần văn bản đăng cho khách đọc, vẫn phải tự đọc lại.
Ba cách hỏi giúp ít phải hỏi lại
Cả bốn model đều trả lời tốt hơn hẳn khi yêu cầu rõ ràng. Ba điều dưới đây là thứ tôi học được sau khi đã hỏi lại quá nhiều lần.
Đưa một ví dụ về thứ bạn muốn nhận. Thay vì nói "rút ra ngày, số tiền và tên", hãy đưa một dòng mẫu đúng định dạng bạn cần. Model bắt chước mẫu giỏi hơn nhiều so với đoán ý từ lời mô tả. Đây là thay đổi giúp tôi giảm số lần hỏi lại nhiều nhất — trước đó tôi cứ cố mô tả kỹ hơn, và việc đó hầu như không giúp gì.
Nói rõ khi bạn không cần lời giải thích. Nếu kết quả sẽ được đưa vào một chương trình, hãy nói thẳng: chỉ trả về dữ liệu, không thêm lời dẫn. Không nói thì phần lớn model sẽ thêm một đoạn giải thích — vừa tốn tiền, vừa làm hỏng bước xử lý phía sau.
Với tài liệu dài, hỏi từng câu một. Gộp ba câu hỏi vào một lần gửi nghe có vẻ tiết kiệm, nhưng model dễ bỏ sót câu thứ ba mà bạn không hề biết. Hỏi lần lượt tốn thêm một lượt, nhưng bạn kiểm soát được câu nào đã được trả lời và câu nào chưa.
Còn khi câu trả lời đã sai, đừng gửi lại y nguyên câu hỏi cũ. Hãy chỉ đúng chỗ sai: "chỗ thứ hai sai, ngày phải là ngày ký hợp đồng". Gửi lại y nguyên thường chỉ nhận về y nguyên câu trả lời.
Còn giá thì sao
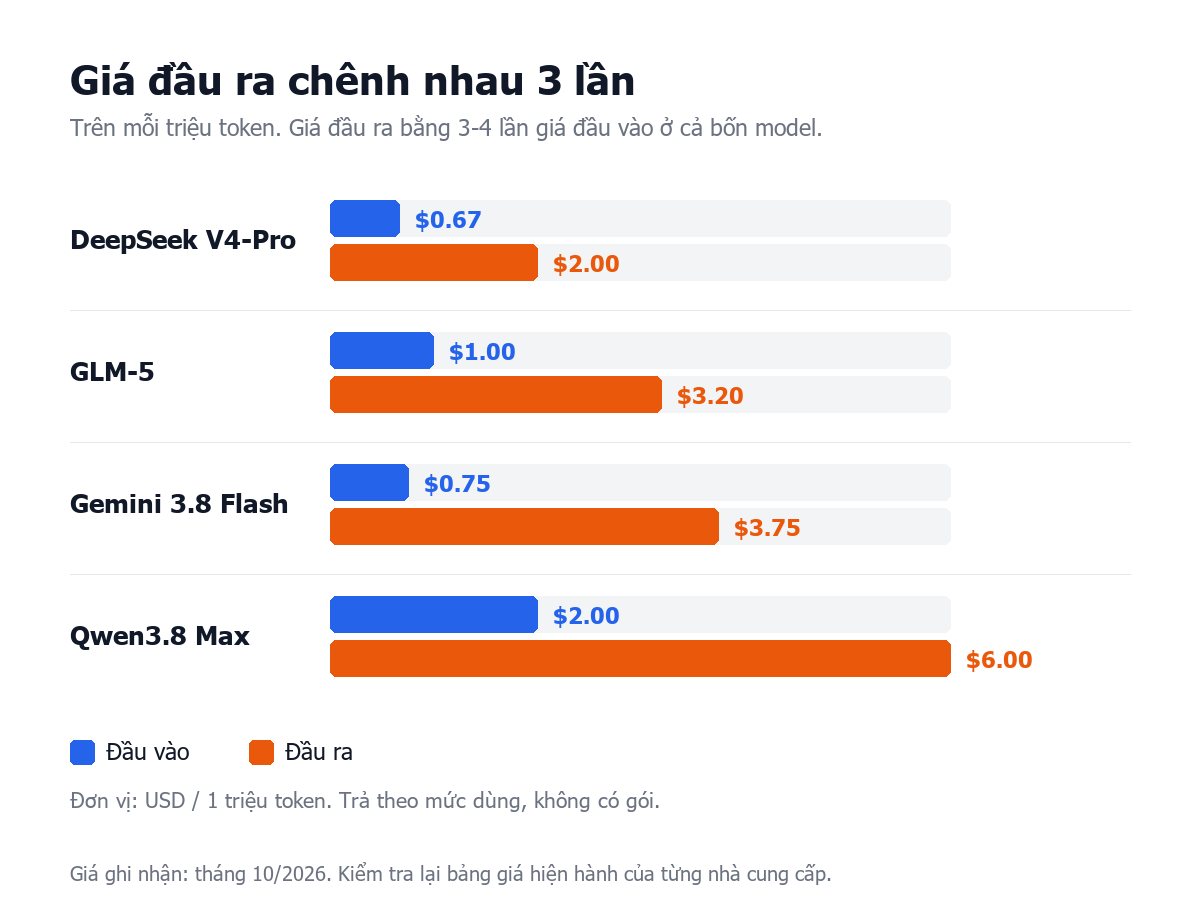
Giá đầu ra cao gấp ba bốn lần giá đầu vào ở cả bốn model.
Model đắt nhất trong bảng có giá đầu ra gấp ba lần model rẻ nhất. Nghe nhiều, nhưng thói quen dùng của bạn còn tạo ra khoảng cách lớn hơn: hỏi hai lần thay vì một lần là nhân đôi chi phí, và việc đó lớn hơn việc đổi từ model rẻ nhất sang đắt nhất.
Với công việc văn phòng bình thường, chênh lệch này tính ra tiền Việt rất nhỏ — vài chục nghìn đồng một tháng. Nên đừng chọn model vì giá. Chọn vì nó trả lời đúng cách bạn cần.
Riêng một trường hợp giá mới thật sự quan trọng: khi bạn hỏi đi hỏi lại trên cùng một tài liệu dài.
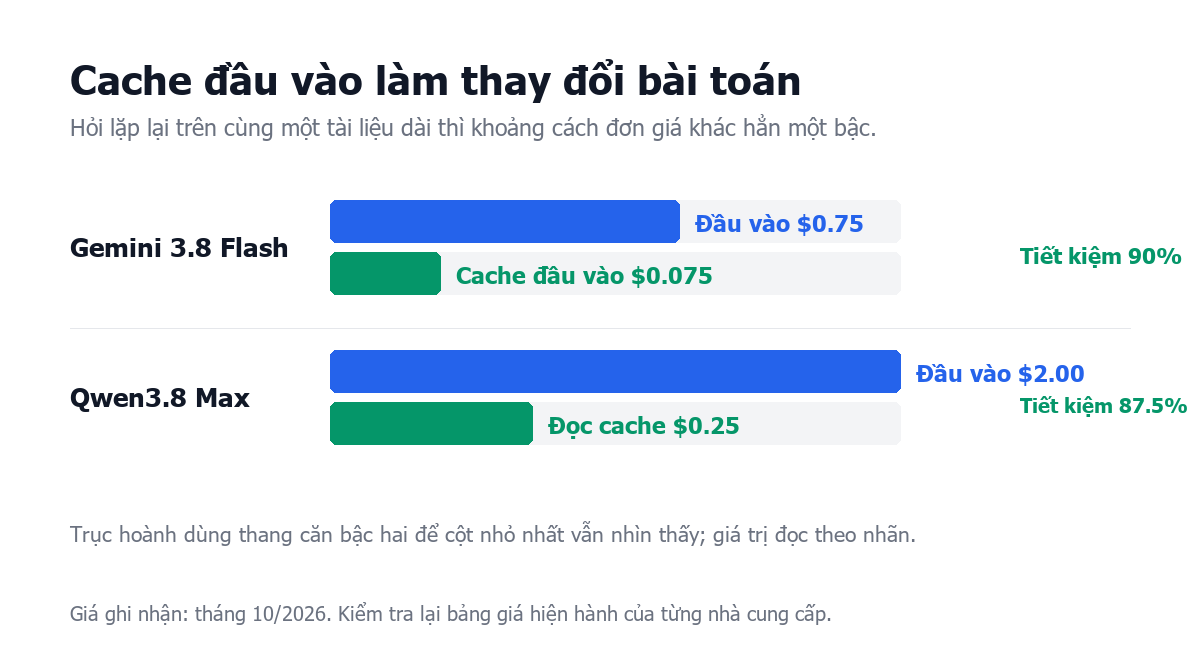
Cùng một tài liệu dài hỏi nhiều lần, cache quan trọng hơn việc chọn model nào.
Gemini 3.8 Flash có giá cache đầu vào 0,075 USD — bằng một phần mười giá thường. Nếu bạn có một tài liệu lớn phải hỏi đi hỏi lại nhiều lần, đây là chỗ tiết kiệm thật. Bạn có thể xem giá hiện hành của từng model trước khi quyết định.
Vậy nên chọn cái nào
Đây là cách tôi chọn, dựa trên việc chứ không dựa trên bảng xếp hạng:
- Cần đọc một tài liệu rất dài, hoặc hỏi đi hỏi lại trên cùng tài liệu đó → Gemini 3.8 Flash. Lợi thế ngữ cảnh dài và cache là thật.
- Cần sửa code, hoặc cần câu trả lời gọn để đưa vào chương trình → DeepSeek V4-Pro. Trả lời ít lan man, ít phải hỏi lại.
- Cần viết tiếng Trung, hoặc cần nội dung tiếng Trung chính xác → Qwen3.8 Max. Đắt nhất, nhưng đây là việc của nó.
- Cần một cái dùng chung cho mọi thứ, không muốn nghĩ nhiều → GLM-5. Không mạnh nhất ở đâu, không yếu nhất ở đâu.
Và một lời khuyên tôi ước mình biết sớm hơn: đừng đổi model giữa chừng một việc. Mỗi model có cách hiểu ngữ cảnh khác nhau. Đổi giữa chừng thường làm câu trả lời tệ đi, dù model mới tốt hơn.
Một lần hỏng tôi không quên
Có một việc yêu cầu tìm một dòng trong tệp log dài 400 dòng. Model chạy sáu lượt, dùng hết 42.766 token đầu vào, rồi trả về chuỗi rỗng. API báo hoàn thành bình thường. Không lỗi, không cảnh báo — chỉ có tiền bị trừ.
Điều đáng nhớ không phải số tiền (rất nhỏ) mà là kiểu hỏng. Một câu trả lời sai thì bạn biết nó sai. Một câu trả lời rỗng thì không có gì để đọc, và nếu nó chạy trong một đường ống tự động, nó lặp lại mỗi đêm mà không ai biết.
Từ đó tôi luôn kiểm tra: câu trả lời có ký tự nào không. Nghe hiển nhiên, nhưng tôi đã bỏ qua nó suốt nhiều tháng.
Giới hạn của bài này
Đây không phải kết quả đo, và đừng đọc như vậy.
Những gì tôi viết ở trên là cảm nhận từ việc dùng cả bốn model trong công việc hằng ngày suốt một tháng. Cỡ mẫu nhỏ, không có bài kiểm tra chuẩn, không lặp lại được. Chỉ có hai thứ trong bài là số liệu thật: bảng giá (công bố công khai, tháng 10/2026) và câu chuyện sáu lượt ở trên (tôi có ghi lại).
Nếu bạn cần so sánh chính xác, hãy tự chạy trên đúng công việc của bạn. Model tốt nhất là model làm xong việc của bạn, không phải model đứng đầu một bảng xếp hạng nào đó.
All rights reserved
