Từ Stockfish đến Lc0: Hai cách “suy nghĩ” khác nhau của AI trong cờ vua
Khi nhìn vào cờ vua máy tính, có một điều rất thú vị:
Stockfish và Leela Chess Zero đều chơi cờ cực mạnh, nhưng cách chúng “suy nghĩ” lại rất khác nhau.
Nếu đơn giản hóa tối đa, ta có thể hình dung:
Stockfish
Search rất mạnh
      +
Neural evaluation
      ↓
   Best move


Lc0
Neural intuition
      +
MCTS
      ↓
   Best move
Sự khác biệt này không chỉ thú vị với người chơi cờ. Nó còn là một ví dụ rất trực quan để hiểu một ý tưởng lớn trong AI hiện đại:
Một model không nhất thiết phải tự đưa ra câu trả lời cuối cùng.
Model có thể đóng vai trò “trực giác”, còn một hệ thống search/reasoning sẽ dùng trực giác đó để tìm lời giải tốt hơn.
1. Bài toán cơ bản: chọn nước đi tốt nhất
Giả sử một vị trí cờ có 30 nước hợp lệ.
Một cách ngây thơ là thử tất cả:
Position
 ├── move 1
 ├── move 2
 ├── move 3
 ├── ...
 └── move 30
Sau mỗi nước lại có thêm hàng chục nước đối phương có thể đi.
Chỉ vài ply sau, cây tìm kiếm đã tăng rất nhanh.
Nếu trung bình một vị trí có khoảng 30 nước:
Depth 1:        30
Depth 2:       900
Depth 3:    27,000
Depth 4:   810,000
Depth 5: 24,300,000
Đây chính là vấn đề kinh điển của game AI:
Không thể phân tích tất cả mọi thứ.
Do đó câu hỏi thật sự không phải là:
Làm sao search toàn bộ cây?
Mà là:
Làm sao biết nhánh nào đáng search?
Đây là nơi Stockfish và Lc0 chọn hai con đường khá khác nhau.
2. Stockfish: search trước, neural network giúp đánh giá
Stockfish thuộc dòng chess engine truyền thống được tối ưu qua hàng chục năm.
Core idea của nó là:
Generate moves
     ↓
Search sâu
     ↓
Prune rất nhiều nhánh vô ích
     ↓
Evaluate position
     ↓
Best move
Stockfish sử dụng các kỹ thuật search cực kỳ mạnh như:
- Alpha-beta pruning
- Principal Variation Search
- Iterative deepening
- Move ordering
- Null-move pruning
- Late Move Reduction
- Quiescence search
Ngày nay Stockfish còn sử dụng NNUE, một neural network nhỏ và rất nhanh để đánh giá vị trí.
Có thể hiểu NNUE như một hàm:
position
    ↓
 neural network
    ↓
evaluation
Ví dụ:
Position A → +0.3
Position B → -1.2
Position C → +2.1
Nhưng neural network không quyết định toàn bộ quá trình tìm kiếm.
Search vẫn là “động cơ chính”.
Có thể ví Stockfish giống một người:
“Tôi sẽ tính cực kỳ nhiều biến.
Khi đi đến một vị trí nào đó, neural network sẽ giúp tôi đánh giá vị trí ấy tốt hay xấu.”
Tóm lại:
Stockfish ≈ Search engine + Neural evaluator
3. Lc0: neural network tạo trực giác trước khi search
Leela Chess Zero đi theo hướng khác.
Lc0 được lấy cảm hứng mạnh từ AlphaZero.
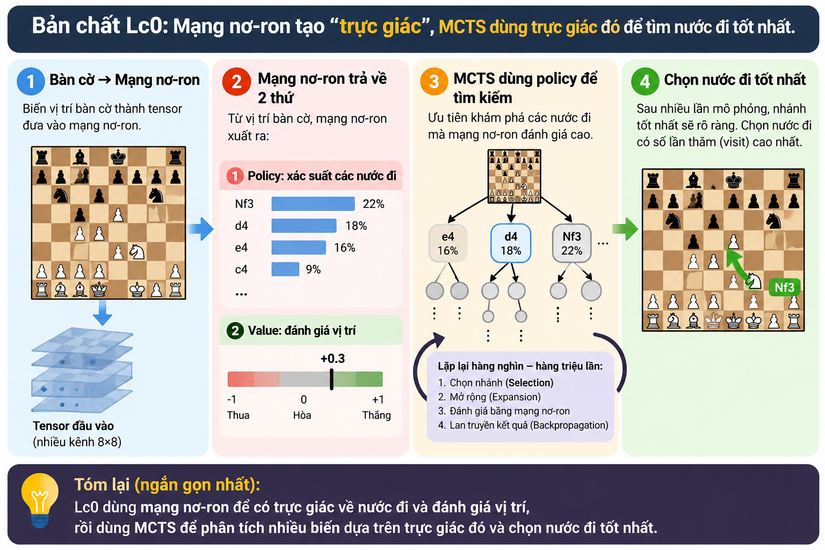
Thay vì search hàng loạt rồi mới đánh giá, Lc0 hỏi neural network trước:
Trong các nước đi này,
nước nào có vẻ đáng xem nhất?
Neural network của Lc0 nhận một vị trí:
Chess position
      ↓
Neural Network
và sinh ra hai output quan trọng:
Policy
Value
4. Policy: “Tôi nghĩ những nước này đáng xem”
Giả sử có bốn nước:
Nf3
d4
e4
c4
Neural network có thể trả về:
Nf3 → 40%
d4  → 25%
e4  → 20%
c4  → 5%
Đây không có nghĩa:
Nf3 chắc chắn là nước tốt nhất.
Nó có nghĩa gần giống:
“Dựa trên kinh nghiệm của tôi, Nf3 trông hứa hẹn nhất.”
Đây là policy network.
Ta có thể coi policy như:
Policy = trực giác về nước đi
Nó giúp giảm vấn đề branching factor.
Thay vì phân tích 30 nước ngang nhau:
30 moves
engine có thể tập trung phần lớn tài nguyên vào:
5–10 moves đáng chú ý
5. Value: “Tôi cảm thấy vị trí này tốt đến mức nào?”
Output thứ hai là value.
Ví dụ:
Position X
    ↓
Neural Network
    ↓
Value = +0.65
Ý nghĩa gần giống:
khả năng thắng khá cao
Hay đơn giản hơn:
position → good / drawish / bad
Điểm quan trọng ở đây là:
Lc0 không nhất thiết phải search đến tận checkmate mới biết một vị trí có vẻ tốt.
Neural network đã học được rất nhiều pattern như:
king safety
piece activity
space
pawn structure
weak squares
passed pawn
initiative
Nó có thể “nhìn” một vị trí và đánh giá khá tốt.
Giống như một Grandmaster nhìn bàn cờ rồi nói:
“Tôi chưa tính hết, nhưng thế này bên trắng có vẻ dễ chơi hơn.”
6. Nhưng chỉ dùng neural network thì chưa đủ
Giả sử neural network nói:
Nf3 → 40%
d4  → 25%
e4  → 20%
Liệu Lc0 có đơn giản chọn Nf3?
Không.
Đây chính là phần quan trọng nhất.
Neural network chỉ tạo trực giác ban đầu.
Lc0 còn phải kiểm chứng trực giác đó bằng search.
Và thuật toán search chính là:
Monte Carlo Tree Search
hay:
MCTS
7. MCTS làm gì?
MCTS xây dựng một cây:
                 Position
              /      |      \
            Nf3      d4      e4
            /         |       \
          ...        ...      ...
Nhưng nó không search đều tất cả nhánh.
Nó dùng policy của neural network để ưu tiên những nhánh đáng chú ý.
Quá trình lặp lại đại khái như sau:
1. Selection
2. Expansion
3. Neural Network Evaluation
4. Backpropagation
Selection
MCTS chọn một nhánh có vẻ hứa hẹn.
Ví dụ:
Root
 ├── Nf3   visits: 500
 ├── d4    visits: 200
 └── e4    visits: 150
Expansion
Nếu gặp một position chưa được phân tích:
new position
engine mở rộng node đó.
Neural Network Evaluation
Position mới được đưa vào neural network:
position
   ↓
network
   ↓
policy + value
Backpropagation
Kết quả được truyền ngược lên cây:
leaf
 ↑
parent
 ↑
parent
 ↑
root
MCTS lại tiếp tục vòng tiếp theo.
Quá trình này có thể chạy:
thousands
tens of thousands
millions
lần.
8. Điều thú vị: policy và search cải thiện lẫn nhau
Ban đầu network có thể nghĩ:
Nf3 → 40%
d4  → 25%
Nhưng sau khi search:
Nf3 → hóa ra có vấn đề chiến thuật
d4  → dẫn đến position cực mạnh
MCTS có thể thay đổi đánh giá:
Nf3 visits: 2,000
d4  visits: 8,000
Cuối cùng Lc0 chọn:
d4
dù policy ban đầu ưu tiên Nf3.
Đây chính là điểm quan trọng:
Neural network ≠ câu trả lời cuối cùng
Neural network chỉ giúp:
định hướng search
Search sau đó:
kiểm chứng trực giác
9. Đây là khác biệt cốt lõi giữa Stockfish và Lc0
Nếu cực kỳ đơn giản hóa:
Stockfish
Search
Search
Search
Search
   ↓
Neural evaluation
   ↓
Best move
Triết lý:
Tính rất nhiều, sau đó đánh giá thật tốt.
Lc0
Neural intuition
       ↓
Search các nhánh đáng chú ý
       ↓
Neural evaluation
       ↓
Search tiếp
       ↓
Best move
Triết lý:
Có trực giác trước, sau đó dùng search để kiểm chứng trực giác.
10. Một analogy rất dễ hiểu
Hãy tưởng tượng hai người giải một bài toán khó.
Người thứ nhất làm kiểu Stockfish:
Liệt kê rất nhiều khả năng
→ loại dần những khả năng sai
→ tính rất sâu
→ chọn đáp án
Người thứ hai làm kiểu Lc0:
“Có vẻ hướng này đúng”
→ thử sâu hướng đó
→ cập nhật nhận định
→ thử tiếp
→ chọn đáp án
Người thứ hai có một thứ gần giống:
intuition
Nhưng intuition không thay thế reasoning.
Nó chỉ giúp reasoning tập trung đúng chỗ.
11. Đây mới là phần thú vị đối với AI hiện đại
Lc0 cho ta một pattern rất quan trọng:
Model
   ↓
Prediction
   ↓
Search / Reasoning
   ↓
Verification
   ↓
Answer
Thay vì:
Model
   ↓
Answer
Trong Lc0:
Neural Network
       ↓
Policy + Value
       ↓
MCTS
       ↓
Best move
Ta có thể abstract thành:
Model intuition
      +
Search
      =
Better decision
12. Liên hệ với LLM
Một LLM thuần túy thường hoạt động gần giống:
prompt
  ↓
model
  ↓
next token
  ↓
next token
  ↓
answer
Model đang dự đoán:
token nào hợp lý tiếp theo?
Nhưng đối với bài toán khó, chỉ dựa vào prediction chưa chắc đủ.
Một architecture mạnh hơn có thể là:
LLM
 ↓
propose several solutions
 ↓
search / explore
 ↓
tool execution
 ↓
verification
 ↓
select best solution
Nhìn theo cách này, policy network của Lc0 khá giống một model nói:
“Tôi nghĩ những hướng này đáng thử.”
MCTS sau đó trả lời:
“Được, tôi sẽ kiểm tra các hướng đó kỹ hơn.”
13. Một pattern tổng quát hơn
Ta có thể gọi nó là:
Intuition + Search
hoặc:
Prediction + Reasoning
Ví dụ trong coding:
LLM đề xuất 5 cách sửa bug
        ↓
chạy test
        ↓
loại những solution fail
        ↓
refine
        ↓
solution cuối
Trong toán học:
model đề xuất hướng chứng minh
        ↓
search các bước
        ↓
symbolic verification
        ↓
proof
Trong planning:
model đề xuất kế hoạch
        ↓
simulate consequences
        ↓
evaluate
        ↓
adjust
Đây đều là cùng một ý tưởng:
Neural network tạo candidate
        +
Search kiểm chứng candidate
14. Bài học lớn nhất từ Lc0
Điều mình thấy thú vị nhất ở Lc0 không phải chỉ là:
“Neural network chơi cờ rất giỏi.”
Mà là architecture của nó.
Neural network không cần phải hoàn hảo.
Nó chỉ cần đủ tốt để nói:
“Có lẽ nên nhìn vào đây.”
Sau đó search sẽ làm phần còn lại.
Đây là một nguyên lý rất mạnh:
Không cần một model biết mọi thứ.

Chỉ cần model biết
nên tìm ở đâu.
Kết luận
Nếu rút gọn toàn bộ bài viết thành một hình:
Stockfish

Search cực mạnh
      +
Neural evaluation
      ↓
Best move
Trong khi:
Lc0

Neural intuition
      +
MCTS search
      ↓
Best move
Và nếu abstraction khỏi cờ vua:
Prediction
    +
Search
    +
Verification
    ↓
Better reasoning
Đó chính là lý do Lc0 rất đáng tìm hiểu ngay cả khi bạn không quan tâm nhiều đến cờ vua.
Nó là một ví dụ cực kỳ đẹp về việc kết hợp:
machine learning để tạo trực giác
với:
algorithmic search để suy luận
thay vì kỳ vọng neural network tự làm tất cả mọi thứ.
All rights reserved