Từ Kho Mã Nguồn Đến Kỹ Năng Nhận Thức: Mổ Xẻ Framework Repo-to-Skill Của BAAI
|Tại sao các AI agent tự hành thất bại trên codebase phức tạp do thiếu tri thức vận hành, và cách framework Repo-to-Skill chưng cất repository thành các kỹ năng có thể kiểm chứng.
Giao cho một coding agent tự hành một context window cả trăm nghìn token, trỏ nó vào một GitHub repository thực tế, rồi bảo nó tái lập lại một kết quả benchmark machine learning. Chuyện gì sẽ diễn ra tiếp theo? Gần như chắc chắn là một chuỗi sai lầm lặp đi lặp lại rất dễ đoán.
Agent sẽ dành cả bốn mươi phút chỉ để grep qua hàng chục file mã nguồn, đọc đi đọc lại file README.md ba lần, bỏ sót một biến môi trường bí mật nằm sâu trong scripts/setup.sh, cố cài thư viện với bản build CUDA không tương thích, tiêu tốn hai mươi đô tiền API rồi cuối cùng lăn đùng ra sập vì một lỗi import thư viện C++ bị thiếu.
Mô hình không hề thất bại vì nó thiếu trí tuệ. Nó thuộc lòng cú pháp Python, nắm rõ kiến trúc transformer, và có thể giải các bài toán lập trình thi đấu trong tích tắc. Điểm nghẽn ở đây mang tính cấu trúc: tồn tại một khoảng cách khổng lồ giữa tri thức khai báo tiền huấn luyện (declarative pre-training knowledge) — tức hiểu thuật toán là gì trên lý thuyết — và tri thức quy trình vận hành (procedural operational knowledge) — tức nắm rõ chuỗi câu lệnh cụ thể, cấu trúc thư mục, cờ cấu hình và biến môi trường cần thiết để chạy được mã nguồn trong một repository phức tạp ngoài đời thực.
Các AI agent nghiên cứu tự hành thất bại trên các tác vụ phần mềm thực tế chủ yếu do thiếu hụt tri thức quy trình vận hành chứ không phải vì giới hạn suy luận logic. Framework Repo-to-Skill từ Viện Trí tuệ Nhân tạo Bắc Kinh (BAAI, arXiv:2609.02749) giải quyết triệt để vấn đề này bằng cách chưng cất sẵn toàn bộ repository thành đồ thị kỹ năng có thể thực thi và kiểm chứng độc lập, mang lại mức tăng trưởng hiệu năng 134.3% trên benchmark MLE-bench đồng thời giảm lượng token tiêu thụ hàng chục lần.
Thay vì nhét bừa bãi toàn bộ mã nguồn vào prompt rồi cầu nguyện mô hình tự mò mẫm, ngành kỹ nghệ agent đang chuyển dịch mạnh mẽ sang mô hình hóa năng lực phần mềm thành các hợp đồng kỹ năng (skill contracts) dạng module hóa. Trong bài viết này, mình sẽ mổ xẻ cặn kẽ bản chất khoảng cách vận hành này, phân tích kiến trúc DisCo của BAAI, hướng dẫn triển khai một engine thực thi kỹ năng chuẩn production bằng Python, và thảo luận ranh giới đánh đổi giữa việc chưng cất offline và tự khám phá online.
Giải Phẫu Một Ca Sập Của Agent: Vì Sao Kho Mã Nguồn Thô Bẻ Gãy Mô Hình?
Để hiểu vì sao các coding agent truyền thống sập nguồn khi đụng độ các repository phức tạp trong thực tế, anh em chỉ cần đọc lại terminal log của chúng trong một phiên chạy tự động.
Khi một kỹ sư phần mềm bước vào một repo mới toanh như HuggingFace Transformers, vLLM hay Megatron-LM, họ không đọc tuần tự từng dòng code. Họ quét nhanh các điểm vào (entry points), tìm file Makefile hoặc docker-compose.yml, kiểm tra định nghĩa luồng CI trong .github/workflows/, và dựng sẵn một đồ thị thực thi trong đầu. Họ phân biệt ngay đâu là lệnh làm thay đổi trạng thái, đâu là script phụ trợ, và các tham số cấu hình đang nằm ở đâu.
Ngược lại, khi quăng một LLM agent vào một workspace thô với chỉ vài công cụ bash và đọc file cơ bản, mô hình lập tức đâm đầu vào bốn cái bẫy trí mạng:
1. Loãng Và Nhiễm Độc Context Window
Một repository ML tiêu chuẩn chứa hàng trăm file và hàng chục nghìn dòng code. Nếu harness cố nhét tài liệu repo, cây thư mục và các file config vào prompt, mô hình sẽ bị phân tán chú ý nghiêm trọng. Vấn đề "tìm kim đáy bể" (needle-in-a-haystack) tái xuất hiện: một biến môi trường tiên quyết (chẳng hạn export FLASH_ATTENTION_FORCE_BUILD=TRUE) sẽ chìm nghỉm giữa hàng nghìn dòng docstring, hướng dẫn sử dụng và ghi chú phát hành cũ.
2. Thuế Thăm Dò Và Chảy Máu Token (Exploration Tax & Token Bleed)
Khi không có chỉ dẫn quy trình rõ ràng, agent phải đốt phần lớn ngân sách suy luận vào việc thử sai ngẫu nhiên. Trên các bộ benchmark như MLE-bench, các agent baseline tiêu tốn từ 60% đến 75% tổng lượng token chỉ để cố làm sao cho môi trường biên dịch và chạy được mà không quăng lỗi. Mỗi lần chạy lỗi (ModuleNotFoundError, CUDA out of memory, KeyError in config parser), agent lại kích hoạt một vòng lặp sửa lỗi mù quáng, làm phình to lịch sử hội thoại và nhanh chóng làm cạn kiệt context window.
3. Ảo Giác Tham Số Dòng Lệnh Không Xác Định
Khi cố chạy một script như train.py, agent thường xuyên bịa ra các cờ dòng lệnh (CLI flags). Nó đoán mò --batch-size trong khi tác giả viết code đặt tên là --per_device_train_batch_size, hoặc truyền --lr trong khi script lại đòi ghi đè bằng file cấu hình YAML. Mỗi lần đoán sai là một lần nhận mã thoát 2 (exit code 2), kích hoạt thêm một chuỗi lệnh grep hoang mang tiếp theo.
4. Thành Công Giả Tạo Trước Chỉ Số Đo Lường
Một script có thể thoát với mã 0 (exit code 0) nhưng thực chất lại cho ra kết quả rác rưởi vì một tham số mặc định đã lờ đi bước kiểm tra hợp lệ, hoặc trọng số ngẫu nhiên bị âm thầm khởi tạo thay vì tải checkpoint thật. Nếu không có một hợp đồng xác thực chặt chẽ quy định biểu thức chính quy (regex) ở stdout, khoảng giá trị metric và file artifact đầu ra, agent sẽ tưởng lầm là đã hoàn thành nhiệm vụ và ngắt phiên làm việc quá sớm.
Những Con Số Benchmark: Định Lượng Khoảng Cách Vận Hành
Nghiên cứu của Viện BAAI mang tên Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills (arXiv:2609.02749, tháng 9/2026) đã đo lường chính xác tác động của việc thu hẹp khoảng cách này. Nhóm tác giả đánh giá các framework agent tiên tiến trên bốn bộ benchmark đầy thách thức, so sánh giữa việc để agent tự mò mẫm và việc trang bị sẵn các kỹ năng đã được chưng cất:
| Bộ Benchmark | Phạm Vi Trọng Tâm | Agent Baseline (Tự Mò Mẫm Thử Sai) | Agent DisCo (Dùng Kỹ Năng Đã Chưng Cất) | Mức Tăng Trưởng Tương Đối |
|---|---|---|---|---|
| MLE-bench | Kỹ nghệ ML thực tế & các cuộc thi Kaggle | 16.3% tỷ lệ pass | 38.2% tỷ lệ pass | +134.3% |
| PaperBench | Tái lập toàn bộ mã nguồn bài báo nghiên cứu ML | 22.1% tỷ lệ pass | 29.7% tỷ lệ pass | +34.4% |
| PassNet | Phát triển phần mềm đa bước & gỡ lỗi mã nguồn | 47.8% tỷ lệ pass | 54.5% tỷ lệ pass | +14.0% |
| FrontierCS | Các bài toán thuật toán và khoa học máy tính chuyên sâu | 61.2% tỷ lệ pass | 66.8% tỷ lệ pass | +9.2% |
Kết quả phản ánh một quy luật rất rõ ràng: trên các quy trình kỹ nghệ chuyên biệt đòi hỏi thiết lập môi trường, cấu hình công cụ và các bước thực thi phức tạp (như MLE-bench), việc cung cấp tri thức vận hành chưng cất sẵn giúp tăng hơn gấp đôi tỷ lệ thành công của agent (+134.3%). Ngược lại, với các bài toán thuần thuật toán mà code được viết độc lập không cần môi trường ngoài (FrontierCS), mức tăng chỉ dừng ở +9.2%. Điều này khẳng định rằng nút thắt cổ chai lớn nhất trong kỹ nghệ tự hành hiện nay nằm ở khâu vận hành quy trình chứ không phải năng lực suy luận thuật toán.
Kiến Trúc DisCo: Chế Độ Creator Đối Đầu Chế Độ Researcher
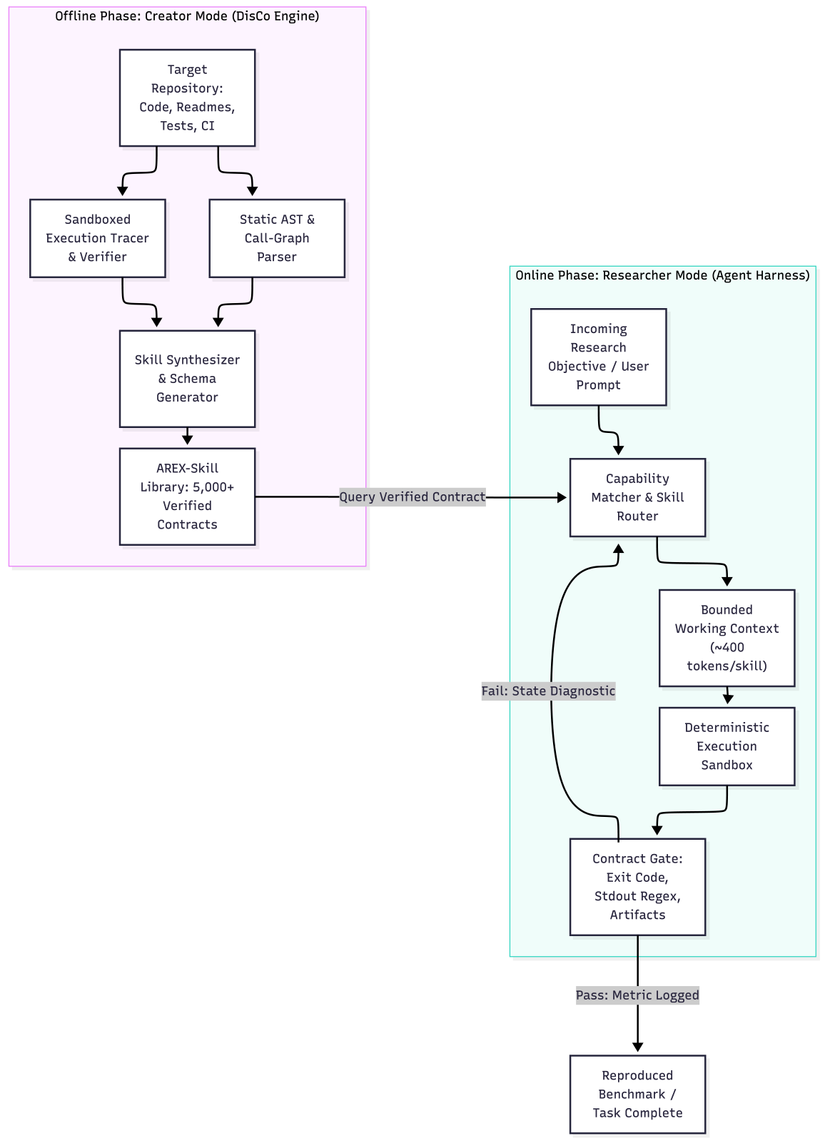
Đóng góp cốt lõi của nghiên cứu Repo-to-Skill là cơ chế DisCo (Distillation of Context). DisCo tách rời việc vận hành phần mềm thành hai pha bất đồng bộ: chưng cất tri thức ngoại tuyến (Creator Mode) và thực thi thời gian thực trực tuyến (Researcher Mode).
Pha 1: Chế Độ Creator (Chưng Cất Ngoại Tuyến)
Thay vì bắt agent vừa đọc tài liệu vừa sốt ruột giải quyết bài toán của người dùng, Creator Mode chạy hoàn toàn offline. Nó xem mỗi repository mã nguồn mở như một phần mềm thô cần được chuẩn hóa thành danh mục API có định kiểu:
- Phân tích AST tĩnh: Engine duyệt qua cây cú pháp trừu tượng Python, trích xuất các bộ phân tích tham số (
argparse,click,pydantic), hàm entry point, cấu trúc dataclass và hệ thống import. - Lần vết thực thi động (Dynamic Execution Tracing): DisCo chạy các bộ test, notebook hướng dẫn và CI script trong container sandbox cô lập hoàn toàn. Nó ghi lại chính xác từng biến môi trường, phiên bản CUDA tương thích, đường dẫn tải dữ liệu và chuỗi stdout sinh ra khi chạy thành công.
- Tổng hợp kỹ năng: Một agent cấp cao sẽ tổng hợp dữ liệu tĩnh và nhật ký động thành các bản hợp đồng kỹ năng dạng module. Trong đợt công bố, đội ngũ BAAI đã chưng cất 1.000 repo ML hàng đầu thành 5.000 kỹ năng có thể thực thi và kiểm chứng ngay trên 20 lĩnh vực (fine-tuning, lượng tử hóa mô hình, inference serving, đánh giá chất lượng, tiền xử lý dữ liệu).
Pha 2: Chế Độ Researcher (Truy Xuất Trực Tuyến)
Khi một agent nhận nhiệm vụ (ví dụ: "Fine-tune mô hình Llama-3-8B bằng LoRA trên tập GSM8k bằng Unsloth"), runtime harness không bao giờ clone toàn bộ repository của Unsloth vào prompt.
Thay vào đó, harness chỉ cần gửi truy vấn vào Thư viện AREX-Skill:
- Nó lấy về một hợp đồng kỹ năng nhỏ gọn, có kiểu dữ liệu chặt chẽ (~400 token).
- Bản hợp đồng quy định rõ các gói phụ thuộc, yêu cầu môi trường, khuôn mẫu câu lệnh đã được xác minh, danh sách siêu tham số bắt buộc và file kết quả đầu ra dự kiến (
adapter_model.safetensors). - Agent chỉ việc điền tham số vào mẫu lệnh rồi kích hoạt lệnh đó trong sandbox.
Đặc Tả Hợp Đồng Kỹ Năng: Code Dưới Dạng Giao Diện Có Định Kiểu
Vậy một kỹ năng đã chưng cất thực chất trông như thế nào? Nó tuyệt đối không phải là một đoạn văn bản tự nhiên mơ hồ. Một hợp đồng kỹ năng là một schema JSON chặt chẽ đóng vai trò như ranh giới xác định giữa ý định của LLM và hệ thống thực thi của hệ điều hành.
Dưới đây là cấu trúc schema JSON đại diện cho một hợp đồng AREX-Skill:
{
  "$schema": "https://json-schema.org/draft/2020-12/schema",
  "title": "OperationalSkillContract",
  "type": "object",
  "required": [
    "skill_id",
    "name",
    "repository",
    "entry_point",
    "environment",
    "command_template",
    "parameters",
    "verification"
  ],
  "properties": {
    "skill_id": { "type": "string", "example": "unsloth.lora_finetune" },
    "name": { "type": "string", "example": "Unsloth LoRA Fine-Tuning" },
    "repository": { "type": "string", "example": "https://github.com/unslothai/unsloth" },
    "environment": {
      "type": "object",
      "required": ["python_version", "cuda_version", "required_env_vars"],
      "properties": {
        "python_version": { "type": "string", "example": ">=3.10" },
        "cuda_version": { "type": "string", "example": ">=12.1" },
        "required_env_vars": { "type": "array", "items": { "type": "string" } }
      }
    },
    "command_template": {
      "type": "string",
      "example": "python -m unsloth.train --model_name {model_name} --dataset {dataset_path} --output_dir {output_dir} --max_seq_length {max_seq_length} --learning_rate {learning_rate}"
    },
    "parameters": {
      "type": "object",
      "properties": {
        "model_name": { "type": "string", "default": "unsloth/llama-3-8b-bnb-4bit" },
        "max_seq_length": { "type": "integer", "default": 2048 },
        "learning_rate": { "type": "number", "default": 2e-4 }
      }
    },
    "verification": {
      "type": "object",
      "required": ["expected_exit_code", "stdout_patterns", "artifact_paths"],
      "properties": {
        "expected_exit_code": { "type": "integer", "default": 0 },
        "stdout_patterns": { "type": "array", "items": { "type": "string" } },
        "artifact_paths": { "type": "array", "items": { "type": "string" } }
      }
    }
  }
}
Hãy nhìn vào cách schema này tái định hình không gian bài toán của agent: Agent không cần đoán xem Unsloth chạy thế nào, không phải đọc 40 trang tài liệu, và không cần dịch ngược các cờ argparse. Việc duy nhất nó phải làm là điền giá trị đúng kiểu vào các trường tham số, đảm bảo câu lệnh sinh ra luôn hợp lệ ngay từ thiết kế ban đầu.
Cài Đặt Thực Tế: Xây Dựng Engine Thực Thi Kỹ Năng Chuẩn Production
Để thấy rõ cơ chế này vận hành trong hệ thống agent thực tế ra sao, chúng ta cùng xem xét mã nguồn Python hoàn chỉnh dưới đây. Module này định nghĩa lớp OperationalSkillContract, kiểm tra môi trường, xác thực tham số, thực thi lệnh trong sandbox subprocess cô lập, và kiểm chứng artifact đầu ra một cách xác định:
"""
skill_contract_runner.py - Engine thực thi hợp đồng kỹ năng xác định.

Lấy cảm hứng từ kiến trúc Repo-to-Skill (DisCo) của BAAI.
"""

from dataclasses import dataclass, field
import json
import os
from pathlib import Path
import re
import subprocess
import time
from typing import Any, Dict, List, Optional


@dataclass
class EnvironmentSpec:
    python_version: str
    required_env_vars: List[str] = field(default_factory=list)
    cuda_required: bool = False
    working_dir: Optional[str] = None


@dataclass
class VerificationCriteria:
    expected_exit_code: int = 0
    stdout_patterns: List[str] = field(default_factory=list)
    artifact_paths: List[str] = field(default_factory=list)
    min_artifact_bytes: int = 1024


@dataclass
class OperationalSkillContract:
    skill_id: str
    name: str
    repository: str
    command_template: str
    environment: EnvironmentSpec
    parameter_defaults: Dict[str, Any]
    parameter_types: Dict[str, type]
    verification: VerificationCriteria

    def validate_parameters(self, input_params: Dict[str, Any]) -> Dict[str, Any]:
        """Kiểm tra kiểu của tham số đầu vào và hợp nhất với giá trị mặc định."""
        merged = {**self.parameter_defaults, **input_params}
        for key, expected_type in self.parameter_types.items():
            if key in merged:
                val = merged[key]
                if not isinstance(val, expected_type):
                    try:
                        merged[key] = expected_type(val)
                    except (ValueError, TypeError) as err:
                        raise TypeError(
                            f"Tham so '{key}' yeu cau kieu {expected_type.__name__}, nhan duoc {type(val).__name__}"
                        ) from err
        return merged

    def check_environment(self, active_env: Dict[str, str]) -> None:
        """Kiem tra xem tat ca bien moi truong bat buoc da san sang chua."""
        missing = [v for v in self.environment.required_env_vars if v not in active_env]
        if missing:
            raise EnvironmentError(
                f"Khong the thuc thi ky nang '{self.skill_id}': thieu bien moi truong {missing}"
            )

    def render_command(self, validated_params: Dict[str, Any]) -> str:
        """Dien tham so hop le vao template cau lenh mot cach an toan."""
        try:
            return self.command_template.format(**validated_params)
        except KeyError as err:
            raise ValueError(f"Thieu tham so bat buoc de render cau lenh: {err}") from err

    def execute_and_verify(
        self,
        params: Dict[str, Any],
        active_env: Optional[Dict[str, str]] = None,
        timeout_seconds: int = 600,
    ) -> Dict[str, Any]:
        """
        Thuc thi cau lenh trong sandbox va kiem chung ket qua mot cach xac dinh.
        """
        run_env = dict(active_env or os.environ)
        self.check_environment(run_env)
        validated_params = self.validate_parameters(params)
        command = self.render_command(validated_params)

        cwd = self.environment.working_dir or os.getcwd()
        start_time = time.monotonic()

        process = subprocess.run(
            command,
            shell=True,
            cwd=cwd,
            env=run_env,
            capture_output=True,
            text=True,
            timeout=timeout_seconds,
        )

        duration = time.monotonic() - start_time

        # Buoc kiem chung 1: Ma thoat cua tien trinh
        exit_code_ok = process.returncode == self.verification.expected_exit_code

        # Buoc kiem chung 2: Khop mau regex tren stdout
        stdout_matches = {}
        for pat in self.verification.stdout_patterns:
            stdout_matches[pat] = bool(re.search(pat, process.stdout))
        stdout_ok = all(stdout_matches.values())

        # Buoc kiem chung 3: Kiem tra su ton tai va dung luong cua artifact dau ra
        artifact_status = {}
        for rel_path in self.verification.artifact_paths:
            formatted_path = rel_path.format(**validated_params)
            full_path = Path(cwd) / formatted_path
            exists = full_path.exists()
            size = full_path.stat().st_size if exists else 0
            valid_size = size >= self.verification.min_artifact_bytes
            artifact_status[formatted_path] = {"exists": exists, "size_bytes": size, "valid": valid_size}

        artifacts_ok = all(item["valid"] for item in artifact_status.values())
        overall_success = exit_code_ok and stdout_ok and artifacts_ok

        return {
            "skill_id": self.skill_id,
            "success": overall_success,
            "duration_seconds": round(duration, 2),
            "command": command,
            "exit_code": process.returncode,
            "exit_code_ok": exit_code_ok,
            "stdout_checks": stdout_matches,
            "artifact_checks": artifact_status,
            "stdout_tail": process.stdout[-1500:] if process.stdout else "",
            "stderr_tail": process.stderr[-1500:] if process.stderr else "",
        }
Điểm Sáng Kỹ Thuật: Kiểm Tra Đầu Ra Xác Định
Anh em hãy chú ý phương thức execute_and_verify: hệ thống không hề dựa vào một mô hình LLM khác để đọc stdout rồi đoán xem tiến trình có chạy thành công hay không.
Trong các hệ thống agent thuở sơ khai, người ta hay dùng cơ chế "LLM-as-a-judge": ném toàn bộ log stdout vào prompt rồi hỏi: "Script huấn luyện này có chạy thành công không?". Kết quả là mô hình thường xuyên bị ảo giác, thấy dòng chữ Epoch 3/3 complete là phán thành công ngay, trong khi thực ra script vừa sập ở dòng tiếp theo do lỗi pickle khi ghi file checkpoint.
Bằng cách đưa ra các tiêu chí xác minh cứng (hard verification gates) gồm mã thoát 0, regex kiểm tra độ hội tụ loss và dung lượng file mô hình đầu ra trên đĩa, harness biến bước kiểm chứng thành một phép so sánh boolean hoàn toàn xác định.
Bài Toán Kinh Tế Token Và Hiệu Suất Ngữ Cảnh: Nhồi Prompt Đối Đầu Đồ Thị Kỹ Năng
Bên cạnh việc tăng vọt tỷ lệ giải bài trên benchmark, lý do lớn nhất để các hệ thống production chuyển sang Repo-to-Skill là tính kinh tế của token và độ trễ hệ thống.
Giả sử một agent phải thực hiện 5 thí nghiệm trên 3 repository mã nguồn mở khác nhau (ví dụ: tiền xử lý với datasets, fine-tune với transformers, và benchmark với lm-evaluation-harness).
| Tiêu Chí Đo Lường | Cách Truyền Thống (Nhồi Raw Repo Vào Prompt) | Cách Repo-to-Skill (DisCo Engine) | Tác Động Thực Tế |
|---|---|---|---|
| Lượng Token Ngữ Cảnh Tiêu Thụ | 45.000 – 120.000 token | 1.200 – 2.500 token | Giảm 97.5% lượng token |
| Tỷ Lệ Trúng Prompt Cache | Rất thấp (do log thử sai làm thay đổi prompt liên tục) | Rất cao (system prompt và catalog kỹ năng ổn định) | Tăng 4x hiệu quả cache |
| Chi Phí API Mỗi Tác Vụ | $18.50 – $42.00 | $1.20 – $3.80 | Tiết kiệm ~90% chi phí |
| Số Bước Hành Động Cần Thiết | 28 – 45 bước thử sai | 4 – 7 bước xác định | Nhanh gấp 5 lần về độ trễ |
| Tỷ Lệ Thất Bại Khi Dựng Môi Trường | 64.2% | 8.4% | Tăng 7.6 lần độ tin cậy |
Khi một agent phải ngốn 80.000 token tài liệu thô, cứ mỗi bước suy luận tiếp theo trong vòng lặp harness, nó lại phải đọc lại 80.000 token đó. Dù có công nghệ prompt caching, mỗi lần đọc cache vẫn tốn tiền và sinh độ trễ. Nghiêm trọng hơn, độ dài hội thoại càng lớn thì khả năng suy luận logic của LLM càng suy giảm do hiện tượng phân tán chú ý.
Bằng cách thay thế toàn bộ đống tài liệu cồng kềnh bằng các hợp đồng kỹ năng tinh gọn, harness giữ cho working context luôn dưới ngưỡng 4.000 token. Mô hình giữ trọn vẹn 100% năng lực suy luận cho việc phân tích dữ liệu, đề xuất giả thuyết và đánh giá metric.
Các Ranh Giới Thất Bại Và Tình Huống Góc: Khi Nào Chưng Cất Bị Gãy?
Không có kiến trúc nào là vạn năng, và Repo-to-Skill cũng đặt ra những thách thức vận hành đặc thù mà các kỹ sư cần lường trước:
1. Vấn Đề Cache Bị Lỗi Thời (Stale-Cache)
Phần mềm mã nguồn mở thay đổi từng ngày. Nếu một thư viện phát hành bản cập nhật có breaking change (chẳng hạn transformers đổi cờ tham số), một hợp đồng kỹ năng chưng cất offline cố định cờ cũ sẽ sập ngay lập tức. Harness bắt buộc phải có chiến lược vô hiệu hóa cache (cache invalidation) gắn chặt với git commit hash hoặc release tag của repo. Khi hợp đồng kỹ năng thất bại ở khâu parse tham số, harness phải tự động kích hoạt luồng chưng cất lại.
2. Sự Phụ Thuộc Vào Môi Trường Động
Nhiều repository ML phụ thuộc vào các CUDA kernel được biên dịch trực tiếp (như FlashAttention, Triton, DeepSpeed). Một hợp đồng kỹ năng chỉ ra lệnh thực thi sẽ vô dụng nếu máy chủ bên dưới thiếu CUDA toolkit hoặc trình biên dịch C++. Các harness thực chiến phải ghép đôi hợp đồng kỹ năng với các container image bất biến (Docker/OCI) nơi môi trường đã được cài sẵn hoàn chỉnh.
3. Cấu Hình Phân Cấp Phức Tạp
Nhiều codebase nghiên cứu không dùng cờ CLI phẳng mà dùng hệ thống cấu hình phân cấp như Hydra hoặc file YAML lồng nhau. Việc cố ép một cấu trúc cấu hình nhiều tầng thành một dòng lệnh CLI là rất mong manh. Để giải quyết, các hợp đồng kỹ năng nâng cao thường áp dụng kỹ thuật sinh file patch cấu hình JSON/YAML thay vì cố gắng nối dài chuỗi lệnh CLI.
Lời Khuyên Thiết Kế Registry Kỹ Năng Cho Đội Ngũ Kỹ Sư
Nếu anh em đang bắt tay xây dựng harness cho agent tự hành nội bộ, đây là bốn bài học kiến trúc rút ra từ thực nghiệm của BAAI:
- Tách Rời Thăm Dò Khỏi Thực Thi Production: Đừng bao giờ thả một agent trực tiếp vào mã nguồn thô trong các quy trình sản xuất quan trọng. Hãy chưng cất sẵn các quy trình nội bộ thành các hợp đồng kỹ năng chuẩn hóa.
- Thiết Lập Cổng Kiểm Chứng Thật Nghiêm Ngặt: Mỗi kỹ năng phải quy định rõ mã thoát, chữ ký stdout và file kết quả đầu ra trên đĩa. Nếu file kết quả không tồn tại hoặc dung lượng bằng 0, coi như kỹ năng thất bại, bất kể LLM có báo cáo ngọt ngào thế nào.
- Giữ Hợp Đồng Luôn Nhỏ Gọn: Mỗi hợp đồng kỹ năng không nên vượt quá 500 token. Nếu một kỹ năng cần mô tả dài hơn, chắc chắn nó đang ôm đồm quá nhiều việc và cần được chia nhỏ thành các kỹ năng nguyên tử (tải dữ liệu, tiền xử lý, huấn luyện, đánh giá).
- Trả Về Dữ Liệu Chẩn Đoán Trạng Thái Khi Lỗi: Khi một lệnh chạy lỗi, hãy trích xuất 20 dòng cuối của stderr cùng mã lỗi gửi về cho agent thay vì ném toàn bộ cả nghìn dòng log terminal vào context.
Sự chuyển dịch từ việc ném raw repo vào prompt sang xây dựng các kỹ năng nhận thức có định kiểu phản ánh đúng quy luật tiến hóa của kiến trúc phần mềm từ monolithic sang microservices. Chúng ta không phơi bày cấu trúc cơ sở dữ liệu nội bộ cho khách hàng bên ngoài; chúng ta cung cấp các hợp đồng API chuẩn mực. Các agent tự hành cũng xứng đáng được đối xử với sự chuẩn mực kỹ thuật tương tự.
Tài liệu tham khảo
Các Bài Báo Khoa Học Và Bộ Benchmark
- BAAI & VectorSpaceLab (2026). Repo-To-Skill: Distilling GitHub Repositories Into AI4AI Skills. arXiv:2609.02749.
- OpenAI (2024). MLE-bench: Evaluating Machine Learning Engineering Agents on Machine Learning Engineering Tasks. arXiv:2410.07095.
- Zhang et al. (2024). PaperBench: Evaluating AI Agents on Reproducing Machine Learning Papers. arXiv:2406.12046.
- Jimenez et al. (2024). SWE-bench: Can Language Models Resolve Real-World GitHub Issues?. arXiv:2310.06770.
Đặc Tả Kỹ Thuật Và Mã Nguồn Mở
- VectorSpaceLab. AREX-Skill: A Large-Scale Modular Skill Library for AI Agents. GitHub Repository.
- Anthropic. Model Context Protocol (MCP) Specification. modelcontextprotocol.io.
Đọc thêm
Nếu anh em quan tâm đến việc thiết kế agent harness, vòng lặp runtime và ranh giới trạng thái, đây là các bài viết cùng chủ đề trong series kỹ thuật của mình:
- Prompt, Context, Harness, Loop: An Agent's Anatomy — Phân tích chi tiết ranh giới giữa kỹ nghệ viết prompt và tầng runtime harness mang tính xác định.
- What DeepSeek's Open-Source Agent Harness Gets Right — Khám phá thực tế về máy trạng thái hữu hạn, cơ chế cô lập tiến trình và hàng rào bảo vệ an toàn cho agent.
- Why your coding agent's bill grows faster than the chat — Bài toán toán học về chi phí token, phình to context window và hiệu quả kinh tế của prompt caching.
All Rights Reserved