THUẬT TOÁN FLASHATTENTION VÀ PAGEDATTENTION TRONG SUY LUẬN MÔ HÌNH NGÔN NGỮ LỚN
Cơ chế Tự chú ý chuẩn (Standard Self-Attention) trong kiến trúc Transformer sở hữu độ phức tạp tính toán và độ phức tạp bộ nhớ tỷ lệ thuận với bình phương độ dài chuỗi ngữ cảnh. Khi kích thước cửa sổ ngữ cảnh mở rộng lên hàng chục nghìn ký hiệu, điểm nghẽn của hệ thống chuyển dịch từ giới hạn năng lực tính toán dấu phẩy động sang giới hạn băng thông truyền tải dữ liệu giữa các phân tầng bộ nhớ phần cứng (Memory-Bound Bottleneck).
Bài viết này phân tích bản chất toán học và kiến trúc của hai đột phá thuật toán then chốt trong kỹ nghệ AI, mà bất kỳ người làm và học AI Engineer nào cũng cần phải biết: thuật toán FlashAttention (tối ưu hóa luân chuyển dữ liệu giữa bộ nhớ tĩnh SRAM và bộ nhớ băng thông cao HBM) và thuật toán PagedAttention (ứng dụng nguyên lý phân trang bộ nhớ ảo của hệ điều hành để triệt tiêu hiện tượng phân mảnh KV Cache). Nghiên cứu đồng thời luận giải sự tác động của các giải thuật này đến thông lượng xử lý thời gian thực của các hệ thống AI cấp độ sản xuất.
1. ĐẶT VẤN ĐỀ VÀ BẢN CHẤT ĐIỂM NGHẼN BĂNG THÔNG BỘ NHỚ TRONG CƠ CHẾ TỰ CHÚ Ý
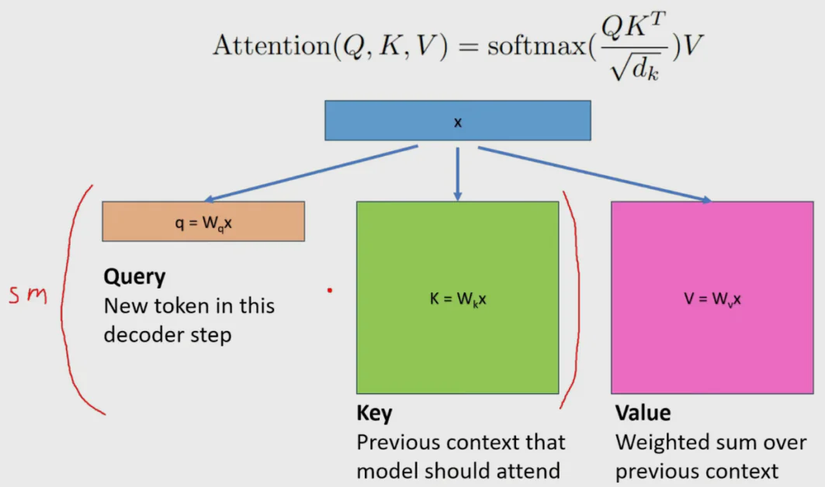
Trong kiến trúc Transformer kinh điển, cơ chế Tự chú ý tính toán tích vô hướng giữa ma trận truy vấn (Query) và ma trận khóa (Key), sau đó chuẩn hóa qua hàm Softmax và nhân với ma trận giá trị (Value). Về mặt lý thuyết toán học, thao tác này đòi hỏi ghi nhận một ma trận trọng số trung gian có kích thước bằng bình phương độ dài chuỗi ký hiệu.
Tại tầng phần cứng máy gia tốc đồ họa (GPU):
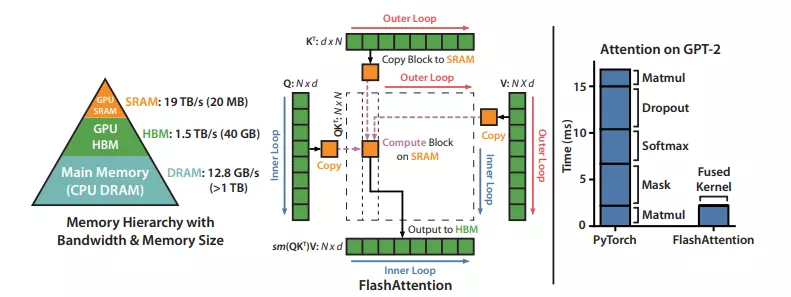
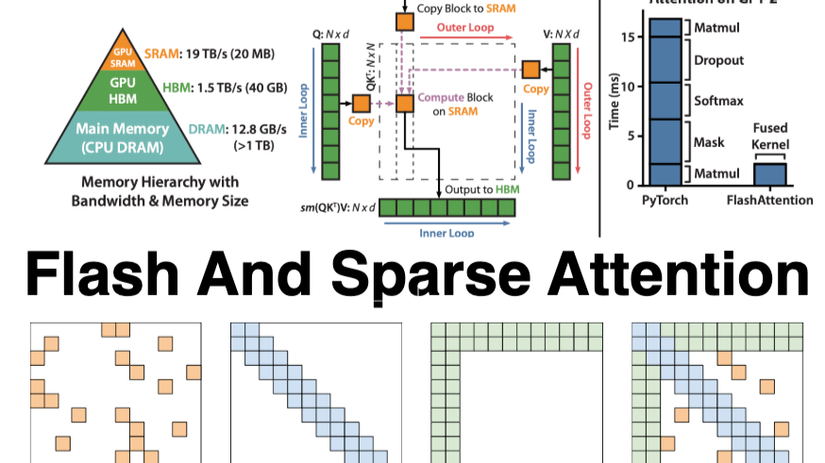
Phân tầng bộ nhớ GPU: Bộ nhớ băng thông cao (High Bandwidth Memory - HBM) sở hữu dung lượng lớn (từ 40GB đến 80GB trên các dòng kiến trúc máy chủ) nhưng tốc độ truy xuất chậm hơn đáng kể so với bộ nhớ đệm nội bộ (SRAM) nằm ngay sát các nhân xử lý ma trận (Tensor Cores). Bộ nhớ SRAM sở hữu băng thông đọc ghi cực nhanh (lên tới 19 Terabyte mỗi giây) nhưng dung lượng giới hạn nghiêm ngặt ở mức vài trăm Kilobyte trên mỗi bộ đa xử lý dòng (Streaming Multiprocessor).
Bản chất điểm nghẽn IO: Cơ chế Attention chuẩn liên tục nạp ma trận Query và Key từ HBM lên SRAM để tính toán ma trận tương quan, sau đó ghi ngược ma trận khổng lồ này về lại HBM. Tiếp theo, hệ thống lại đọc ma trận từ HBM lên SRAM để thực hiện phép toán Softmax, rồi tiếp tục ghi kết quả về HBM trước khi đọc lên lần thứ ba để nhân với ma trận Value. Chu kỳ đọc - ghi liên tục qua lại giữa HBM và SRAM khiến các nhân Tensor Core phải rơi vào trạng thái chờ nhàn rỗi (idle), biến toàn bộ quá trình xử lý trở thành bài toán nghẽn băng thông đọc ghi thay vì nghẽn tính toán.
Thách thức trong giai đoạn tự hồi quy (Autoregressive Generation): Khi mô hình sinh từng ký tự mới, nó phải lưu giữ toàn bộ các vector Key và Value của các ký hiệu trước đó vào bộ nhớ đệm (KV Cache). Do độ dài phản hồi của người dùng là ngẫu nhiên và khó đoán định, hệ thống quản trị bộ nhớ truyền thống buộc phải cấp phát trước các khối bộ nhớ liên tục có kích thước bằng độ dài tối đa. Điều này gây lãng phí từ 60% đến 80% dung lượng VRAM thực tế do hiện tượng phân mảnh nội tại và bộ nhớ dự phòng không được sử dụng.
2. THUẬT TOÁN FLASHATTENTION: TÁI CẤU TRÚC LUỒNG TÍNH TOÁN QUA TILING VÀ ONLINE SOFTMAX
Để phá vỡ giới hạn truyền tải của bộ nhớ HBM, thuật toán FlashAttention đề xuất một phương pháp tiếp cận triệt để: thực hiện toàn bộ phép tính cơ chế Tự chú ý ngay trên bộ nhớ cực nhanh SRAM mà không bao giờ ghi ma trận trung gian ra HBM.
Thuật toán vận hành dựa trên hai nguyên lý cơ bản:
Kỹ thuật phân khối nhỏ (Tiling Technique): Ma trận Query, Key và Value được chia nhỏ thành các khối (blocks) có kích thước vừa vặn với dung lượng của bộ nhớ SRAM. Thay vì nạp toàn bộ ma trận cùng lúc, GPU chỉ nạp một khối nhỏ của Query và một khối nhỏ của Key/Value lên SRAM tại một thời điểm, thực hiện tính toán cục bộ và cập nhật tích lũy kết quả đầu ra.
Kỹ thuật chuẩn hóa trực tuyến (Online Softmax): Thách thức lớn nhất của việc phân khối là hàm Softmax yêu cầu mẫu số chuẩn hóa phải là tổng số mũ của toàn bộ các phần tử trong hàng. Thuật toán FlashAttention giải quyết điều này bằng cách duy trì hai chỉ số thống kê cục bộ trên SRAM: giá trị cực đại tạm thời và tổng số mũ tạm thời. Khi chuyển sang một khối Key/Value tiếp theo, hệ thống sử dụng các phép biến đổi toán học để hiệu chỉnh lại trọng số đầu ra của khối trước đó theo giá trị cực đại mới mà không cần phải duyệt lại dữ liệu cũ.
Bằng cách loại bỏ hoàn toàn các lượt đọc ghi ma trận trung gian có kích thước bình phương chuỗi ra HBM, FlashAttention cắt giảm số lượng lượt truy xuất bộ nhớ từ cấp số bình phương xuống cấp số tuyến tính theo chiều dài chuỗi, giúp tăng tốc độ thực thi phép toán Attention từ hai đến bốn lần trong khi bảo toàn độ chính xác số học nguyên bản.
3. THUẬT TOÁN PAGEDATTENTION: QUẢN TRỊ BỘ NHỚ ẢO CHO BỘ ĐỆM KV CACHE
Nếu như FlashAttention giải quyết tốc độ tính toán của một lượt suy luận, thì PagedAttention tập trung giải phóng toàn bộ năng lực chứa của bộ nhớ GPU trong giai đoạn phục vụ đồng thời hàng ngàn luồng người dùng.
Lấy cảm hứng từ cơ chế bộ nhớ ảo và phân trang (Paging) kinh điển của hệ điều hành hiện đại, thuật toán PagedAttention chia nhỏ chuỗi KV Cache vốn liên tục về mặt logic thành các khối trang bộ nhớ (KV Blocks) không cần liên tục về mặt vật lý:
Cấu trúc khối trang cố định: Mỗi khối trang được thiết lập để lưu trữ một số lượng ký hiệu cố định (thường là 16 hoặc 32 tokens) của các vector Key và Value.
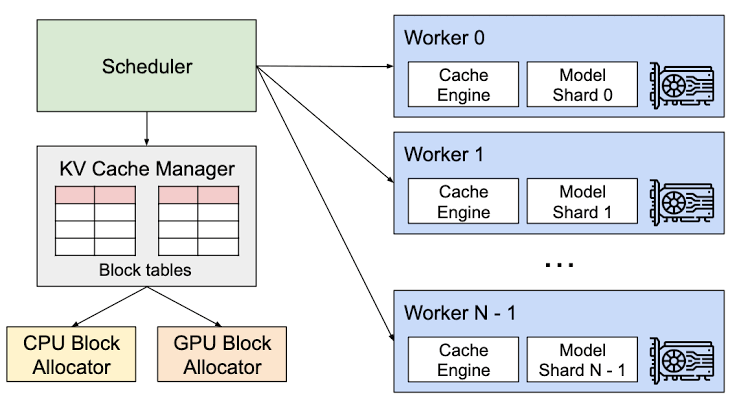
Bảng ánh xạ trang (Block Table): Hệ thống duy trì một bảng trang tương tự như Bảng quản lý trang bộ nhớ của nhân hệ điều hành. Bảng này ánh xạ vị trí logic của các ký hiệu trong chuỗi văn bản tới các ô nhớ vật lý nằm rải rác trong không gian VRAM của GPU.
Triệt tiêu hiện tượng phân mảnh: Khi một ký hiệu mới được sinh ra trong quá trình tự hồi quy, hệ thống chỉ cấp phát thêm một khối trang mới khi khối trang hiện tại đã được lấp đầy hoàn toàn. Thuật toán loại bỏ hoàn toàn hiện tượng phân mảnh bộ nhớ bên trong (Internal Fragmentation) và phân mảnh bên ngoài (External Fragmentation), nâng tỷ lệ khai thác hữu ích của bộ nhớ VRAM từ mức dưới 40% lên tiệm cận 96%.
Cơ chế chia sẻ bộ nhớ cho luồng song song (Copy-on-Write Memory Sharing): Đối với các kỹ thuật suy luận nâng cao như lấy mẫu chùm (Beam Search) hoặc phục vụ nhiều tác tử cùng chia sẻ một đoạn ngữ cảnh chỉ dẫn hệ thống (System Prompt), PagedAttention cho phép nhiều luồng cùng trỏ đến các khối trang vật lý giống nhau. Chỉ khi một luồng bắt đầu thay đổi hoặc sinh ký hiệu phân kỳ, khối trang mới mới được nhân bản và ghi nhận riêng biệt.
4. KHẢO SÁT THỰC NGHIỆM VÀ TÁC ĐỘNG TỚI THÔNG LƯỢNG SUY LUẬN
Sự kết hợp giữa giải thuật tính toán FlashAttention và cấu trúc dữ liệu PagedAttention tạo ra bước nhảy vọt trong năng lực vận hành thực tế của các mô hình ngôn ngữ lớn:
Nâng cao thông lượng xử lý đồng thời (Serving Throughput): Nhờ việc bộ nhớ KV Cache không còn bị lãng phí do cấp phát thừa, một máy chủ GPU đơn lẻ có thể tiếp nhận kích thước mẻ xử lý (Batch Size) lớn gấp ba đến năm lần so với các bộ khung truyền thống. Điều này giúp giảm thiểu chi phí khấu hao điện toán phần cứng trên mỗi yêu cầu của người dùng.
Kiểm soát độ trễ sinh ký tự đầu tiên (Time To First Token - TTFT): FlashAttention giúp pha tiền nạp ngữ cảnh (Prefill Phase) đạt tốc độ xử lý gần như tức thời ngay cả khi tài liệu đầu vào dài hàng chục nghìn từ, do thời gian tính toán không còn bị kéo dài bởi băng thông HBM.
Ổn định độ trễ giữa các ký tự kế tiếp (Time Per Output Token - TPOT): PagedAttention đảm bảo việc cấp phát bộ nhớ động diễn ra với độ phức tạp thời gian cố định O(1), triệt tiêu các hiện tượng đứng luồng đột ngột do máy chủ phải dọn dẹp phân mảnh bộ nhớ (Garbage Collection) trong quá trình phục vụ.
5. HÀM Ý THỰC TIỄN TRONG PHÁT TRIỂN HỆ THỐNG TRÍ TUỆ NHÂN TẠO VÀ KẾT LUẬN
Việc tối ưu hóa các giải thuật cấp độ phần cứng và quản trị bộ nhớ cho thấy ranh giới cốt lõi của ngành AI hiện đại: một kỹ sư phát triển giải pháp thông minh không thể chỉ dừng lại ở việc xem các mô hình ngôn ngữ lớn như một chiếc hộp đen toán học, mà phải hiểu sâu sắc kiến trúc điện toán phân tán bên dưới.
Để có thể làm chủ trọn vẹn chuỗi công nghệ từ việc hiểu rõ cơ chế toán học của nhân suy luận vLLM, thiết kế thuật toán PagedAttention, cho đến việc đóng gói và triển khai các cụm máy chủ hiệu năng cao phục vụ doanh nghiệp, việc tiếp cận chương trình đào tạo AI Engineer thực chiến của Cole cung cấp một lộ trình nghiên cứu thực chứng toàn diện, kết nối mật thiết giữa nền tảng khoa học máy tính kinh điển và kỹ nghệ vận hành mô hình tiên tiến nhất.
Tóm lại, FlashAttention và PagedAttention không đơn thuần là những cải tiến kỹ thuật nhỏ lẻ, mà là những công trình đột phá tái định hình phương pháp luận tính toán của kỷ nguyên AI. Bằng cách tái cấu trúc luồng di chuyển dữ liệu trên kiến trúc vi xử lý và ứng dụng triệt để các nguyên lý kinh điển của hệ điều hành, các giải thuật này đã đưa công nghệ mô hình ngôn ngữ lớn vượt qua rào cản chi phí phần cứng, mở đường cho việc phổ cập các hệ thống trí tuệ nhân tạo quy mô lớn vào mọi mặt của nền kinh tế số.
All rights reserved