

Tên của các mô hình AI đến từ đâu?
Ảnh bìa được tạo bằng mô hình AI, minh hoạ việc tra cứu nguồn gốc tên các mô hình.
Trong sáu họ mô hình AI lớn mà tôi tra cứu, chỉ có hai cái tên thực sự mô tả công nghệ. GPT đúng nghĩa là một bảng thông số. Mistral nhúng kiến trúc thẳng vào tên mô hình. Bốn cái còn lại — Claude, Gemini, Grok và Llama — là thương hiệu, là tình cờ, và trong một trường hợp là biệt danh mà đồng nghiệp đặt cho một người.
Bài viết này được soạn với sự hỗ trợ của công cụ viết AI. Phần thử nghiệm API ở cuối bài do tôi tự chạy, ảnh chụp màn hình là kết quả thật từ console, không phải ảnh tạo sinh.
Vấn đề
Khi cấu hình danh sách mô hình, tôi mở cùng lúc ba định danh:
claude-haiku-4-5gemini-3-flashgpt-5-4-mini
Và tôi nhận ra mình không nói được hậu tố nào trong ba cái đó nghĩa là "nhỏ hơn", cái nào nghĩa là "nhanh hơn", cái nào là cả hai.
Haiku là một thể thơ. Flash nghĩa là chớp nhoáng. Mini nghĩa là nhỏ. Ba khái niệm khác nhau hoàn toàn, nhưng đứng ở cùng một vị trí trong định danh, như thể chúng là cùng một loại nhãn.
Nên tôi quyết định tra trước chính cái tên, chưa vội tra hậu tố.
Bối cảnh: vài thuật ngữ cần làm rõ trước
Để phần sau dễ theo dõi, xin giải thích nhanh ba khái niệm sẽ xuất hiện:
- Acronym (từ viết tắt): lấy chữ cái đầu của các từ ghép lại, ví dụ GPT.
- Backronym (từ viết tắt ngược): có từ trước, sau đó mới nghĩ ra cụm từ để khớp ngược lại với các chữ cái. Llama rơi vào nhóm này.
- MoE (Mixture-of-Experts): kiến trúc thưa, trong đó chỉ một phần các "chuyên gia" được kích hoạt cho mỗi token, thay vì toàn bộ mạng như mô hình dày đặc.
GPT — cái tên chính là bản mô tả kỹ thuật
Generative Pre-trained Transformer. Ba từ, ba sự thật kỹ thuật:
- Generative — sinh ra nội dung, đối lập với mô hình phân biệt
- Pre-trained — huấn luyện trước trên kho ngữ liệu lớn, rồi mới tinh chỉnh cho tác vụ cụ thể
- Transformer — kiến trúc nền
Không điển tích, không chơi chữ. Đây là cái tên nhàm chán nhất trong danh sách và đồng thời là cái tên nhiều thông tin nhất.
Mistral — kiến trúc đúng, nhưng phép nhân thì sai
Mixtral là từ ghép của Mixture-of-experts và Mistral. Chỉ riêng cái tên đã cho biết mô hình này thưa chứ không dày đặc.
Ký hiệu đầy đủ Mixtral-8x7B còn mô tả cả cấu trúc tham số: tám chuyên gia, khoảng 7B tham số được kích hoạt cho mỗi token, một router chọn 2 trong 8 cho từng token, và đầu ra của tầng là tổng có trọng số của hai chuyên gia đó.
Tôi làm phép nhân hiển nhiên: 8 × 7 = 56B. Rồi tra số tham số thật.
46,7B.
Ít hơn gần 10B. Lý do là chỉ các khối feed-forward được nhân lên tám lần; các tầng self-attention và embedding được dùng chung cho cả tám chuyên gia. Nghĩa là phép nhân trong tên phóng đại kích thước thật khoảng 20%.
Nếu bạn ước lượng phần cứng theo cái tên, bạn sẽ cấp dư. Đây là cái tên duy nhất trong nhóm này có thể khiến bạn tốn tiền thật.
Còn tên công ty thì chẳng liên quan gì đến machine learning. Mistral là ngọn gió tây bắc lạnh thổi từ miền nam nước Pháp ra Địa Trung Hải, trung bình khoảng 50 km/h, đôi khi kéo dài nhiều ngày. Từ này đến từ phương ngữ Languedoc của tiếng Occitan, gốc có nghĩa là "chế ngự". Ba nhà sáng lập Arthur Mensch, Guillaume Lample và Timothée Lacroix gặp nhau ở École Polytechnique và đăng ký công ty theo tên ngọn gió này vào tháng 4 năm 2023.
Hậu tố đó được giữ xuyên suốt dòng sản phẩm:
- Pixtral — thị giác
- Codestral — sinh mã
- Mathstral — toán
- Devstral — lập trình dạng agent
- Voxtral — giọng nói
Trong sáu công ty, chỉ nhà này mã hoá chức năng thay vì kích thước vào hậu tố. Nhìn Codestral là biết dùng để làm gì, khỏi mở tài liệu.
Llama — chữ cái không khớp với số từ
Llama = Large Language Model Meta AI.
Thoạt nhìn thì giống GPT: một từ viết tắt kỹ thuật gọn gàng. Nhưng xếp chữ cái cạnh các từ:
- Large, Language, Model, Meta, AI → năm từ
- L-L-a-M-A → năm vị trí, nhưng Model và Meta dùng chung một chữ M
Wikipedia xếp nó vào nhóm backronym: có từ llama trước, cụm giải nghĩa được suy ngược ra sau.
Trò này thậm chí không phải Meta nghĩ ra đầu tiên. LlamaIndex dùng trước; nhà sáng lập Jerry Liu kể rằng họ đang nghĩ tên các con vật dễ thương và llama tình cờ có sẵn LLM bên trong.
Ban đầu Meta viết là LLaMA để nhấn mạnh từ viết tắt, sau đó bỏ luôn cách viết đó và dùng Llama bình thường.
Claude — không ai xác nhận, kể cả Anthropic
Cách giải thích phổ biến là tên này tri ân Claude Shannon, người mà bài báo năm 1948 A Mathematical Theory of Communication đã đặt nền móng cho lý thuyết thông tin và được trích dẫn hơn 160.000 lần.
Tôi đi tìm xác nhận chính thức. Blog của Anthropic, trung tâm trợ giúp, model card, phát biểu của nhà sáng lập — không có ở đâu cả. Mọi nguồn đều viết theo kiểu "được cho là".
Một bài trên The New Yorker năm 2026 có tiêu đề đúng nghĩa đen: "What Is Claude? Anthropic Doesn't Know, Either." Theo phiên bản nội bộ mô tả trong đó, cái tên một phần là tri ân Shannon, phần còn lại đơn giản là họ muốn một tên người nghe thân thiện, không giống tên thiết bị nhà bếp, cũng không giống trợ lý giọng nói kiểu Siri hay Alexa.
Các bậc Haiku / Sonnet / Opus cũng vậy. Cách giải thích theo thể thơ thì ai cũng biết, nhưng bài blog công bố chính thức không hề viết điều đó — cộng đồng tự ghép lại.
Gemini — suýt nữa thì mang tên Titan
Câu chuyện chính thức ở đây có nội dung thật. Jeff Dean đã giải thích rằng "song sinh" chỉ hai đội đã sáp nhập: Google Brain cũ, chủ yếu đến từ các công trình PaLM và PaLM-2, và DeepMind cũ, chủ yếu đến từ Chinchilla. Họ sáp nhập tháng 4 năm 2023 và cùng xây một mô hình đa phương thức.
Chồng lên đó là hai lớp nghĩa nữa: chương trình Gemini của NASA, loại tàu hai chỗ nối giữa Mercury và Apollo, và chính chòm sao với cặp sao Castor và Pollux.
Nhưng tên mã trong giai đoạn phát triển là Titan — vệ tinh lớn nhất của Sao Thổ, đồng thời là các thần Titan trong thần thoại Hy Lạp. Nó bị đổi vì một lý do rất người: Dean không thích cái tên đó. Dù vậy chính tên mã này đã đẩy ông đi tìm một cái tên "gắn với vũ trụ", và Gemini ra đời từ đó.
Oriol Vinyals, đồng trưởng nhóm kỹ thuật, sau này còn đùa công khai: liệu bản kế nhiệm có tên Apollo không? Ở NASA, sau Gemini đúng là Apollo.
Một dự án quy mô như vậy, cái tên được quyết bởi khẩu vị của một người.
Và câu chuyện ngắn nhất danh sách: Nano Banana là biệt danh mà các đồng nghiệp đặt cho Naina Raisinghani, một product manager ở Google DeepMind. Biệt danh đó đi thẳng thành tên mô hình chính thức, tương ứng với Gemini 2.5 Flash Image.
Grok — một từ trong tiểu thuyết năm 1961
Grok do Robert A. Heinlein đặt ra cho tiểu thuyết Stranger in a Strange Land, kể về một người sinh ra trên Sao Hoả và được người Sao Hoả nuôi lớn. Trong ngôn ngữ Sao Hoả của truyện, từ này nghĩa đen là "uống", nghĩa mở rộng là hấp thụ một thứ trọn vẹn đến mức nó trở thành một phần của mình. Từ điển Oxford đã thu nhận từ này với nghĩa "hiểu bằng trực giác hoặc bằng sự đồng cảm".
xAI chưa bao giờ xác nhận chính thức đây là nguồn gốc. Musk chỉ đăng dòng "Stranger in a Strange Land" trên X một ngày sau khi công bố chatbot.
Thực hành: hỏi thẳng chính các mô hình
Vì phía con người không xác nhận được, tôi gửi cùng một câu hỏi — "tên của bạn đến từ đâu?" — cho bốn mô hình và ghi lại phản hồi thô.
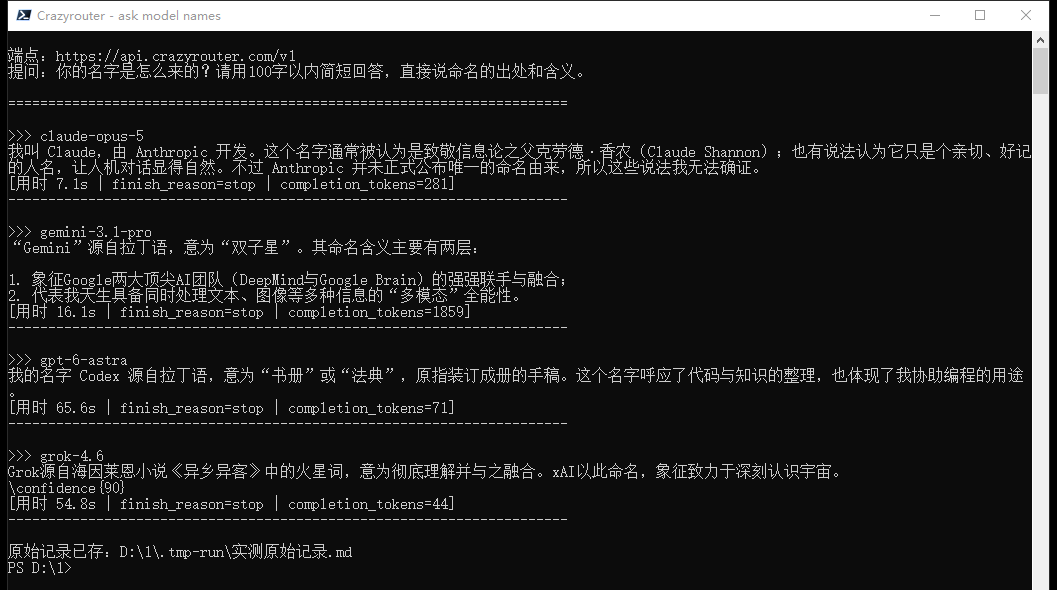
Ảnh chụp màn hình thật của lần chạy nói trên, không phải ảnh tạo sinh.
Một thuật ngữ cần giải thích trước khi đọc kết quả: finish_reason là trường cho biết vì sao mô hình dừng lại. Giá trị stop nghĩa là mô hình tự kết thúc câu trả lời; length nghĩa là bị cắt vì chạm giới hạn token.
GPT-6 Astra cho kết quả lạ nhất. Tôi hỏi bảy lần. Ba lần nó giải thích ChatGPT là viết tắt của gì. Hai lần nó nói nó không có tên riêng. Lần cuối nó bảo tên nó là Codex, "từ tiếng Latin nghĩa là sách hay bộ luật".
Qua cả bảy lần, nó không nhắc tới Astra một lần nào. finish_reason luôn là stop, tức là câu trả lời không hề bị cắt — nó đơn giản là không nói về chính mình.
Claude là mô hình duy nhất tự nêu giới hạn của câu trả lời: mỗi lần nó đều nói thêm rằng Anthropic chưa công bố một nguồn gốc chính thức duy nhất, nên không thể khẳng định. Điều này khớp chính xác với những gì tôi tìm được trong các nguồn.
Gemini đưa ra câu trả lời đầy đủ nhất và tiêu 1.859 token đầu ra cho nó, so với 281 của Claude cho cùng câu hỏi. Chi phí suy luận của các mô hình reasoning không hiện ra trong phần trả lời nhìn thấy được.
Grok nêu đúng nguồn nhưng nói quá: nó khẳng định xAI chọn tên để tượng trưng cho việc thấu hiểu vũ trụ, trình bày như một sự thật đã xác lập, trong khi Musk chưa từng xác nhận. Nó còn để lọt một marker nội bộ \confidence{90} vào phần văn bản trả lời.
Điểm mỉa mai khó bỏ qua: mô hình mà chính công ty của nó không chịu giải thích cái tên lại là mô hình duy nhất thừa nhận mình không chắc.
Kết quả và tổng kết
Hai trong sáu cái tên mang thông tin kỹ thuật thật: GPT và dòng Mistral. Bốn cái còn lại là một lời tri ân chưa được xác nhận, một vụ sáp nhập đội ngũ, một cuốn tiểu thuyết năm 1961, và một biệt danh.
Còn hậu tố — thứ khiến tôi bắt đầu tra cứu — thì không đo cùng một đại lượng giữa các nhà cung cấp:
- Flash của Google → độ trễ
- mini của OpenAI → quy mô tham số
- Codex của OpenAI → chức năng
- Haiku của Anthropic → cả quy mô lẫn tốc độ
- Dòng -stral của Mistral → chức năng
Flash, mini và Haiku đều nằm ở ô "nhỏ và nhanh", nhưng chúng không đo cùng một thứ. Với Pro thì còn tệ hơn: Pro của OpenAI và Pro của Google nằm ở hai khung giá hoàn toàn khác nhau.
Kết luận thực dụng: chỉ so hậu tố trong nội bộ một nhà cung cấp. Khi so giữa các nhà cung cấp, hãy nhìn thẳng vào số liệu — độ dài ngữ cảnh, bậc tính phí, độ trễ đo được. Ví dụ trang mô hình GPT-5 liệt kê sẵn các thông số này, và đọc chúng mất chưa tới một phút, nhanh hơn nhiều so với suy ngược từ cái tên.
Sự bối rối ban đầu của tôi hoá ra không phải do thiếu hiểu biết. Ba hậu tố đó vốn dĩ chưa bao giờ được căn chỉnh với nhau.
All rights reserved
