

So sánh 6 LLM API trên cùng một bộ prompt: chênh 30 lần tốc độ và 4 lỗi âm thầm
Ngày 12/11/2026, mình gửi đúng ba bài tập giống nhau cho sáu mô hình, tổng cộng 18 request, dùng một khóa API duy nhất. Mình tưởng sẽ viết được một bảng xếp hạng về độ chính xác. Không có bảng xếp hạng nào cả: năm trên sáu mô hình làm đúng cả ba bài, và thứ phân biệt chúng là ba chỉ số ít ai đọc trên trang giới thiệu — thời gian chờ, số token đầu ra, và việc phản hồi có nội dung hay không. Bài này dành cho người sắp viết code gọi API: trả tiền theo token, chạy theo lô, có timeout. Nếu bạn chỉ thỉnh thoảng mở chat trên trình duyệt, mấy con số dưới đây không giúp được gì.
Môi trường đo
| Hạng mục | Giá trị |
|---|---|
| Ngày đo | 12/11/2026 |
| Số request | 18 (3 bài × 6 mô hình, mỗi bài một lần gọi) |
| Endpoint | một URL tương thích OpenAI, một khóa |
| Temperature | 0,3 cho suy luận và code; 0,7 cho viết |
| Ngôn ngữ prompt | tiếng Trung |
Sáu mô hình, kèm ID thực tế gửi đi: claude-sonnet-5-5, gpt-5.3-codex, gemini-3.1-pro, deepseek-v4-pro, doubao-seed-2-1-turbo-260628 và hy4 (Tencent Hunyuan).
Suy luận. Ba câu có đáp án duy nhất: từ 1 đến 1000 có bao nhiêu số nguyên chia hết cho 3 hoặc 5 nhưng không chia hết cho 15; ngày 1/3/2027 là thứ mấy, biết 12/11/2026 là thứ Năm; xác suất có điều kiện để năm lần tung đầu tiên đều là mặt ngửa, với điều kiện trong mười lần tung có ít nhất một lần mặt sấp. Mình tính đáp án bằng script trước khi chạy: 401, thứ Hai, 31/1023.
Viết. Một đoạn quảng cáo 140–160 ký tự cho robot hút bụi, hướng tới gia đình. Ba điểm bán hàng bắt buộc, bốn cụm từ bị cấm, không tiêu đề phụ, không emoji. Chính ràng buộc mới là bài test: ai cũng viết được ba dòng quảng cáo, nhưng không phải ai cũng giữ được số ký tự.
Code. Cài parse_duration(s) bằng Python: chuyển 1h30m và 90s thành số giây, trả None với đầu vào sai, kèm ít nhất sáu assert. Mình bỏ qua assert do mô hình viết, chạy code của chúng trên 13 ca ẩn tự soạn: đơn vị lặp, chỉ có đơn vị, thiếu đơn vị, chuỗi bị cắt, số âm, thứ tự khác thường nhưng hợp lệ.
Suy luận: chỉ một mô hình sai, và không phải mô hình chậm nhất
Năm mô hình đúng cả ba câu. Codex đúng hai.
Lỗi nằm ở bài tính ngày. Đếm từ 12/11/2026 đến 1/3/2027, Codex ra 108 ngày thay vì 109, chia bảy, và kết luận là Chủ nhật thay vì thứ Hai. Phần trình bày rất gọn: các bước đánh số, định dạng sạch, kết luận dứt khoát. Không có chỗ nào trong câu trả lời gợi ý rằng phải kiểm tra lại. Mình chỉ phát hiện vì đáp án đúng đã nằm sẵn trong script.
Đây mới là kiểu hỏng tốn tiền khi chạy thật: không phải mô hình từ chối trả lời, mà là mô hình đưa cho bạn sai một ngày kèm lời giải thích rất thuyết phục.
| Mô hình | Đúng | Độ trễ | Token đầu ra |
|---|---|---|---|
| Codex | 2/3 | 6,1 giây | 547 |
| Claude | 3/3 | 6,6 giây | 612 |
| Gemini | 3/3 | 39,1 giây | 3.531 |
| Hunyuan | 3/3 | 45,8 giây | 3.690 |
| Doubao | 3/3 | 186,0 giây | 11.958 |
| DeepSeek | 3/3 | 195,0 giây | 16.138 |
Hai mô hình trả lời trong sáu giây, hai mô hình khoảng bốn mươi giây, hai mô hình gần ba phút. Trong cửa sổ chat thì chỉ hơi khó chịu. Với một lô vài nghìn câu chạy ban đêm, đó là độ dài hàng đợi và tỷ lệ timeout.
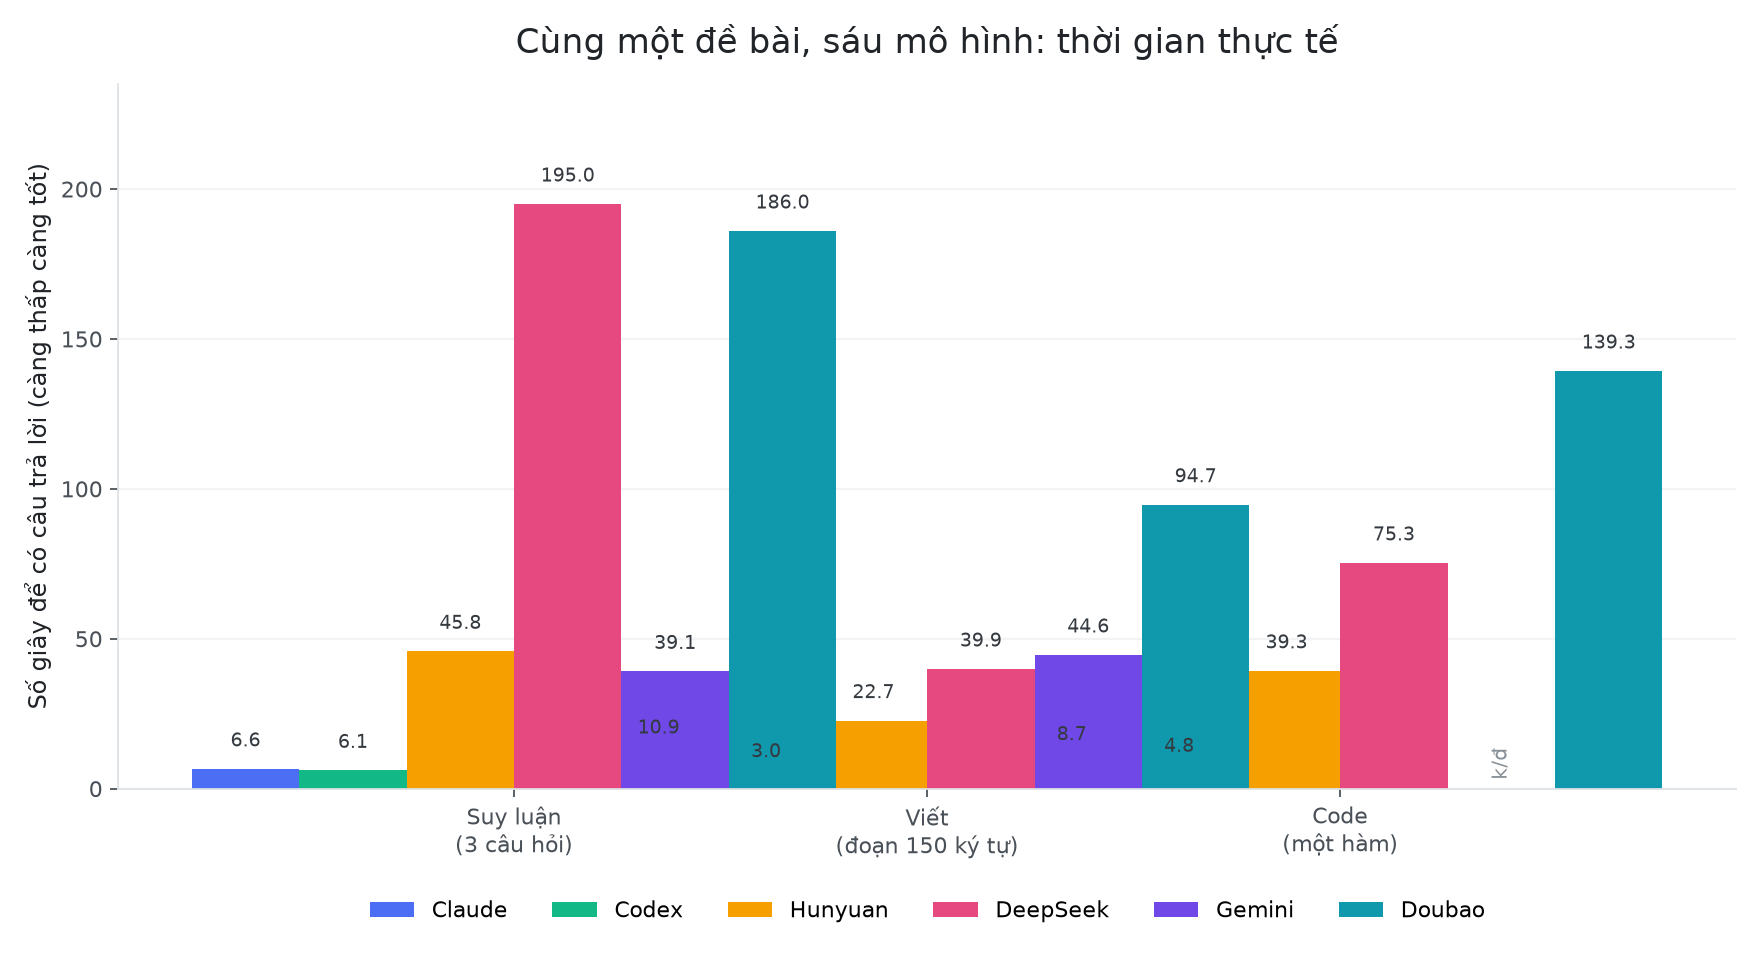
Để ý cột token: mô hình chậm nhất tiêu gấp ba mươi lần token đầu ra của mô hình nhanh nhất trên cùng ba câu, và gần như toàn bộ là token suy luận — bạn trả tiền cho chúng nhưng không đọc.
Viết: mô hình nhanh nhất lại là mô hình trượt
Năm mô hình trả về đoạn văn dùng được: 145–150 ký tự, đủ ba điểm bán hàng, không có cụm từ bị cấm. Khác biệt về giọng điệu là khác biệt kênh phân phối, không phải chất lượng.
Codex trả 117 ký tự. Điểm bán hàng có, cụm cấm không có, chỉ mỗi giới hạn độ dài bị bỏ — trong 3,0 giây và 104 token đầu ra, lần chạy rẻ nhất của cả bài test. Nhanh và biết nghe lời là hai trục khác nhau. Hãy kiểm tra đầu ra của nó bằng máy, rồi cứ để nó chạy số lượng lớn.
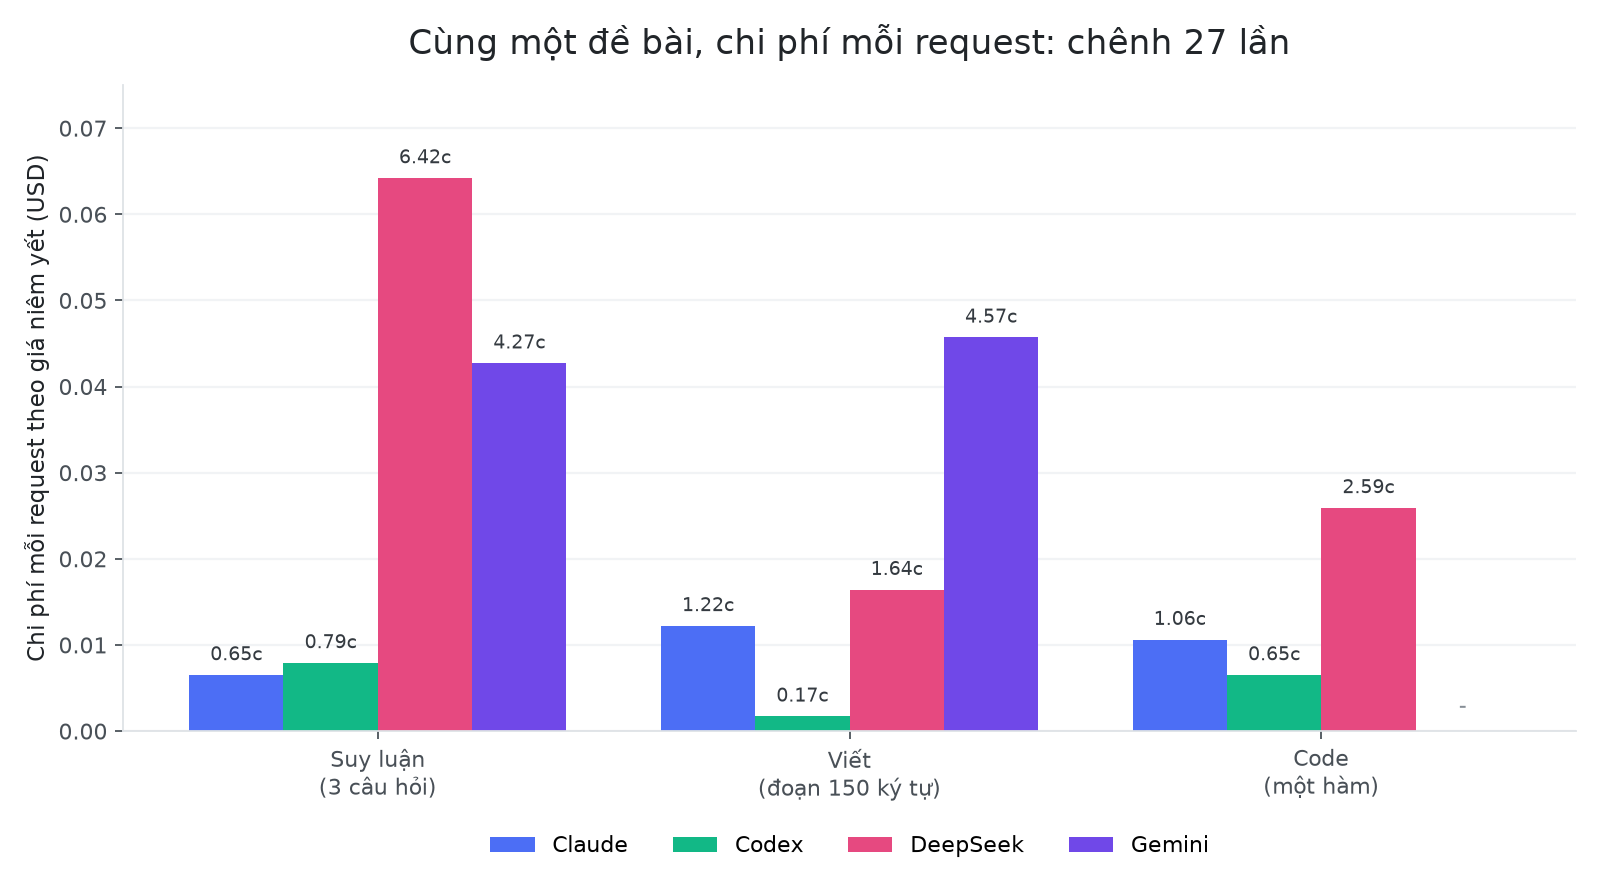
Với cùng độ dài đầu ra, tính theo giá niêm yết:
| Mô hình | Chi phí mỗi request |
|---|---|
| Codex | 0,17 cent |
| Claude | 1,22 cent |
| DeepSeek | 1,64 cent |
| Gemini | 4,57 cent |
Chênh 27 lần cho đúng một đoạn 150 ký tự. Gần như không phần nào của khoảng chênh này đến từ giá mỗi token: nó đến từ số token mô hình tiêu để nghĩ về một đoạn văn ngắn. Một bản dự toán chỉ dựa trên "giá mỗi triệu token" sẽ lệch cả một bậc độ lớn ở dạng việc này.
Code: năm mô hình qua cùng bộ test, một mô hình không trả lời
Claude, Codex, Hunyuan, DeepSeek và Doubao đều qua 13/13. Đơn vị lặp, số bị thiếu, số âm, thứ tự lộn xộn — không mô hình nào vấp. Ở mức khó này, câu hỏi "mô hình nào viết code tốt hơn" không còn hữu ích. Tốc độ giao hàng thì có.
| Mô hình | Độ trễ | Ca ẩn |
|---|---|---|
| Codex | 4,8 giây | 13/13 |
| Claude | 8,7 giây | 13/13 |
| Hunyuan | 39,3 giây | 13/13 |
| DeepSeek | 75,3 giây | 13/13 |
| Doubao | 139,3 giây | 13/13 |
| Gemini | — | không hoàn thành |
Chênh 29 lần cho một hàm mà đặc tả gói trong bốn dòng. Gemini không trả về code dùng được: liên tục 429 khi giới hạn đầu ra 4.096 token, rồi một phản hồi 200 với giới hạn 2.048 nhưng thân hàm bị cắt giữa. Đây không phải bằng chứng nó không viết nổi hàm đó; đây là bằng chứng rằng qua đường này và với ngân sách đó, nó không tạo ra kết quả ổn định — đúng thứ bạn cần biết trước khi dồn traffic vào.
Bốn lỗi tích hợp mà bảng điểm không cho thấy
Không lỗi nào trong bốn lỗi này hiện ra trong bảng kết quả, và mỗi lỗi tốn hơn một lựa chọn mô hình sai trong tuần đầu.
Phản hồi 200 với thân rỗng. Hunyuan và DeepSeek, với giới hạn 4.096 token đầu ra, dùng hết ngân sách cho phần suy luận và trả về nội dung rỗng kèm finish_reason: length. Tầng HTTP không báo gì. Mình phải nâng lên 16.384 mới có câu trả lời. Client chỉ kiểm tra response.status == 200 rồi đi tiếp sẽ phát hành một tính năng trả về rỗng, và lỗi sẽ trông như lỗi mô hình trong khi thực ra là lỗi cấu hình.
Giới hạn tần suất trông như hệ thống chập chờn. Lỗi 429 của Gemini chỉ xuất hiện khi giới hạn đầu ra cao. Hạ xuống thì mất, nâng lên thì quay lại. Trong log, nó giống một sự cố ngắt quãng không có quy luật — kiểu tệ nhất. Retry với backoff và jitter không phải tùy chọn, và cũng cần một mô hình dự phòng cấu hình sẵn: bão retry vào 429 chỉ là một lần sập chậm hơn.
Không API nào trong sáu cái tự tìm web. Mình hỏi giá đóng cửa chứng khoán Mỹ hôm trước. Cả sáu nói không truy cập được, và không mô hình nào bịa số — điểm cộng. Sau đó mình khai báo công cụ web_search trong request: năm mô hình trả 400 (chỉ hỗ trợ function tool, hoặc tham số không hợp lệ), Codex trả 200 nhưng không tìm, mà bịa một tiêu đề cụ thể kèm link trang chủ một báo công nghệ. Chỉ cái 200 đó là nguy hiểm: client tin vào mã trạng thái sẽ coi đó là một lần tìm kiếm thành công.
Tên mô hình mới, kiến thức cũ. Hỏi mốc cắt kiến thức: Codex và DeepSeek trả tháng 6/2024, Hunyuan và Doubao tháng 7/2024, Gemini tháng 1/2025, Claude "khoảng 2025". Một mô hình ra mắt năm nay vẫn có thể chậm mười tám tháng về dữ kiện. Mọi thứ phụ thuộc thời gian đều cần một bước truy xuất dữ liệu, bất kể thẻ mô hình ghi gì.
Một endpoint thay cho sáu tài khoản
Mình không tạo sáu tài khoản để viết bài này. Sáu mô hình nằm sau một endpoint tương thích OpenAI của Crazyrouter, một khóa, một định dạng request. Đổi mô hình là đổi một trường, không phải SDK mới, hóa đơn mới, luồng xác thực mới. Với bản thân phép đo, điều này quan trọng: mọi thứ trừ mô hình đều giữ nguyên giữa các lần gọi, và đó là lý do duy nhất khiến các con số so sánh được với nhau.
https://api.crazyrouter.com/v1
Giữ nguyên body, chỉ đổi model, và phép so sánh vẫn trung thực. Danh mục mô hình thực tế đang mở và cách truy vấn nằm trong tài liệu truy cập. Một lần chạy cỡ này tốn chưa tới một đô la, nên bạn có thể lặp lại thí nghiệm trước khi cam kết bất cứ điều gì.
Việc nào giao cho ai
| Nhu cầu | Chọn trước | Dự phòng | Căn cứ |
|---|---|---|---|
| Văn bản cho người đọc | Claude | Doubao | 3/3, 6,6 giây, đoạn quảng cáo dùng được ngay |
| Khối lượng lớn, cần độ trễ thấp | Codex | Claude | Nhanh nhất ở cả ba bài, rẻ nhất ở hai bài |
| Hàm nhỏ, viết một lần | Codex | Claude | 13/13 trong 4,8 giây |
| Nội dung thương mại tiếng Trung | Doubao | Hunyuan | Giọng tự nhiên nhất, đổi lại 186 giây ở bài suy luận |
| Chi phí mỗi request thấp nhất | Codex | DeepSeek | 0,17 cent cho một đoạn, với điều kiện kiểm tra đầu ra |
| Không có ưu tiên rõ ràng | Hunyuan | Claude | Đúng ở mọi bài, không có cạnh sắc |
Bài test này không chứng minh điều gì
Một mẫu cho mỗi bài, một ngày, một endpoint. Chạy lại cùng bộ prompt hai mươi lần, bản đồ lỗi sẽ dịch chuyển, nhất là ở bài suy luận: một lần lệch ngày chỉ là một điểm đo, không phải một thứ hạng. Context dài, khả năng nhìn ảnh và gọi công cụ hoàn toàn chưa được kiểm. Giá là giá niêm yết quy đổi, không phải giá bạn trả theo hợp đồng.
Điều còn đứng vững: ở mức khó này, độ chính xác đã thôi làm ranh giới. Ranh giới là độ trễ, số token đầu ra và các giá trị mặc định trong ngân sách request của bạn. Hãy chọn theo ba dòng đó, và đo lại trên chính bộ prompt của mình trước khi cam kết. Nếu việc của bạn là văn bản ngắn với số lượng lớn, hãy bắt đầu bằng việc đo chi phí thật trên năm mươi mẫu — đó là dự báo hóa đơn duy nhất đáng tin.
All rights reserved
