

Mô hình BERT là gì? Giải mã cuộc cách mạng Pre-trained Transformer trong Xử lý Ngôn ngữ Tự nhiên (NLP)
Trước năm 2018, cộng đồng Xử lý Ngôn ngữ Tự nhiên (Natural Language Processing - NLP) vẫn đối mặt với một rào cản lớn: Tính một chiều của ngữ cảnh (Contextual Asymmetry). Dù các kiến trúc tuần tự như LSTM, Bi-LSTM hay GRU đã cải thiện khả năng học chuỗi, việc nắm bắt ngữ cảnh đồng thời từ cả hai phía (trái qua phải và phải qua trái) ở cấp độ sâu vẫn là bài toán nan giải.
Tháng 10 năm 2018, nhóm nghiên cứu của Jacob Devlin tại Google AI công bố bài báo khoa học: "BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding". Công trình này lập tức tạo ra cơn địa chấn khi xô đổ kỷ lục trên 11 tác vụ NLP tiêu chuẩn, bao gồm bộ benchmark GLUE và bài toán hỏi đáp SQuAD.
Bài viết này sẽ đưa bạn đi sâu vào bản chất kỹ thuật của BERT: từ lý do ra đời, kiến trúc Transformer Encoder, các tác vụ Pre-training cốt lõi, công thức toán học Self-Attention, đến việc triển khai mã nguồn PyTorch và ứng dụng thực tế.
1. Bối cảnh lịch sử: Vì sao thế giới cần BERT?
Để hiểu được bước đột phá của BERT, chúng ta cần nhìn lại các thế hệ biểu diễn từ (Word Representation) trước đó:
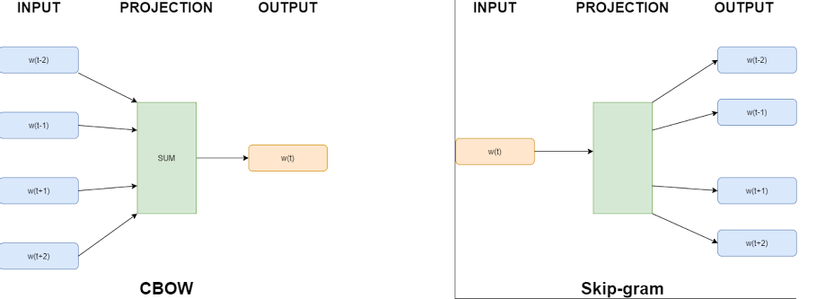
1.1. Word2Vec và GloVe: Biểu diễn tĩnh (Static Embeddings)
Word2Vec hay GloVe ánh xạ mỗi từ thành một vector cố định trong không gian đa chiều.
- Hạn chế chí mạng: Không giải quyết được hiện tượng đa nghĩa (Polysemy).
- Ví dụ: Trong hai câu:
- "Tôi đi rút tiền ở ngân hàng."
- "Con thuyền neo đậu bên ngân hàng cây số mười lăm." (dải đất ven sông)
Word2Vec đều gán cùng một vector biểu diễn cho từ "ngân hàng", bất chấp ngữ cảnh xung quanh hoàn toàn khác nhau.
1.2. ELMo và OpenAI GPT-1: Ngữ cảnh động nhưng chưa thực sự hai chiều
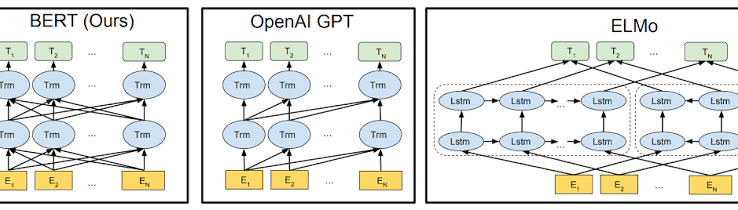
- ELMo (2018): Sử dụng mạng Bi-LSTM gồm hai mô hình độc lập: một mạng đọc từ trái sang phải (), một mạng đọc từ phải sang trái (). Sau đó, hai vector ẩn được ghép nối (concatenation) lại. Đây chỉ là ghép nối ngữ cảnh hai chiều nông (shallow bidirectional) chứ không phải tương tác sâu giữa các từ ở từng lớp mạng.
- GPT-1 (2018): Sử dụng kiến trúc Transformer Decoder với cơ chế Masked Multi-Head Attention. GPT chỉ học theo chiều từ trái sang phải (Causal/Autoregressive LM), điều này phù hợp cho bài toán sinh văn bản (Text Generation) nhưng lại làm mất đi thông tin từ phía sau khi cần hiểu toàn diện một câu văn (Language Understanding).
1.3. Sự ra đời của BERT
BERT viết tắt của Bidirectional Encoder Representations from Transformers. Khác với GPT hay ELMo, BERT quan sát đồng thời toàn bộ các từ ở bên trái và bên phải của từ mục tiêu tại mọi tầng (layer) của mạng nơ-ron thông qua cơ chế Self-Attention.
2. Kiến trúc cốt lõi của BERT
BERT sử dụng kiến trúc Transformer Encoder thuần túy (dựa trên bài báo kinh điển "Attention Is All You Need" của Vaswani et al., 2017).
Google công bố hai biến thể tiêu chuẩn ban đầu:
- BERT-Base: Gồm tầng (Transformer blocks), kích thước vector ẩn , attention heads. Tổng tham số: 110 triệu (110M).
- BERT-Large: Gồm tầng, , attention heads. Tổng tham số: 340 triệu (340M).
2.1. Cấu trúc đầu vào (Input Representation)
Đầu vào của BERT không chỉ là một danh sách từ đơn thuần, mà là sự tổng hợp của ba lớp vector nhúng (Embeddings):
- Token Embeddings: Văn bản được phân tách bằng thuật toán WordPiece Tokenizer (vốn từ vựng khoảng 30.522 tokens). Các từ hiếm hoặc từ chưa từng thấy sẽ được bẻ nhỏ thành các subwords (ví dụ:
"playing"["play", "##ing"]), loại bỏ triệt để vấn đề Out-of-Vocabulary (OOV).- Token đặc biệt
[CLS]luôn được đặt ở đầu chuỗi (vector biểu diễn của nó đại diện cho ý nghĩa toàn bộ câu văn). - Token đặc biệt
[SEP]dùng để phân tách ranh giới giữa hai câu văn và .
- Token đặc biệt
- Segment Embeddings: Vector nhị phân giúp mô hình phân biệt token nào thuộc về Câu () và token nào thuộc về Câu ().
- Position Embeddings: Do Transformer không sử dụng cấu trúc tuần tự (như RNN/CNN), thông tin thứ tự của từ trong câu bị mất. BERT học trực tiếp các vector vị trí (Learnable Positional Embeddings) tương ứng với vị trí từ 0 đến 512.
3. Cơ chế toán học: Scaled Dot-Product và Multi-Head Attention
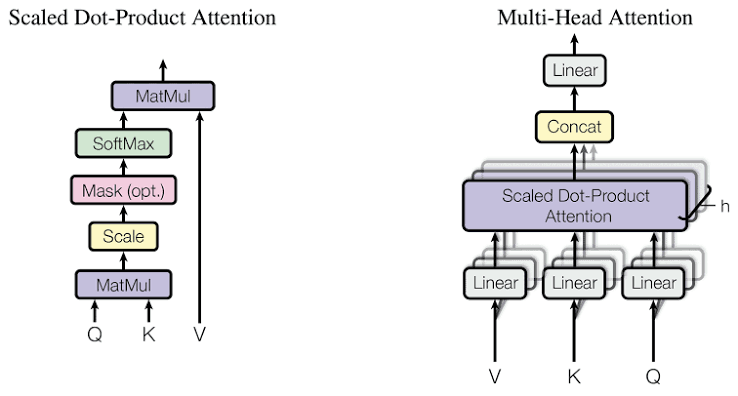
Trái tim của Transformer Encoder trong BERT là cơ chế Multi-Head Self-Attention.
3.1. Scaled Dot-Product Attention
Với mỗi vector đầu vào , mô hình nhân với ba ma trận trọng số khả vi để tạo ra ba vector:
- Query (): Đại diện cho token đang tìm kiếm thông tin liên quan.
- Key (): Đại diện cho nhãn định danh của các token khác trong câu.
- Value (): Chứa thông tin nội dung thực sự của token.
Điểm Attention giữa các token được tính bằng công thức:
- Hệ số (Scaling factor): Khi chiều vector lớn, tích vô hướng có xu hướng nhận giá trị cực lớn, đẩy hàm Softmax vào vùng gradient tiệm cận 0 (hiện tượng triệt tiêu gradient - Vanishing Gradient). Việc chia cho giúp ổn định phương sai về 1.
3.2. Multi-Head Attention
Thay vì chỉ tính toán Attention một lần với chiều , BERT chia các vector Query, Key, Value thành không gian con độc lập (ví dụ với BERT-Base: , ):
Cơ chế đa đầu cho phép mô hình đồng thời chú ý đến thông tin ở nhiều khía cạnh khác nhau: head thứ nhất học quan hệ ngữ pháp (chủ ngữ - vị ngữ), head thứ hai học quan hệ sở hữu, head thứ ba học quan hệ đồng nghĩa/trái nghĩa.
4. Hai tác vụ tiền huấn luyện (Pre-training Objectives)
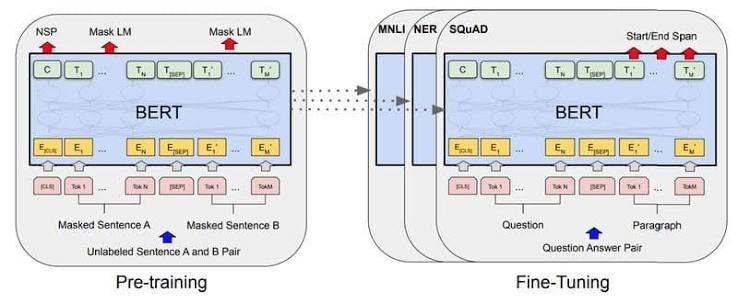
Nếu huấn luyện một mô hình Transformer hai chiều sâu theo phương pháp dự đoán từ kế tiếp truyền thống, mô hình sẽ gặp lỗi "nhìn thấy trước tương lai" (Information Leakage), dẫn đến việc học tầm thường (trivial learning). Để giải quyết bài toán này, nhóm tác giả đề xuất hai chiến lược học tự giám sát (Self-supervised Learning):
4.1. Masked Language Model (MLM - "Cloze Task")
Thuật toán chọn ngẫu nhiên 15% tổng số token trong văn bản để xử lý. Trong số 15% token được chọn:
- 80% trường hợp: Thay thế token bằng ký hiệu đặc biệt
[MASK].- Ví dụ:
"Hà Nội là [MASK] của Việt Nam"Dự đoán"thủ đô".
- Ví dụ:
- 10% trường hợp: Thay thế bằng một token ngẫu nhiên khác trong từ điển.
- Ví dụ:
"Hà Nội là [quả táo] của Việt Nam"Mô hình phải học cách sửa lỗi và nhận diện từ đúng.
- Ví dụ:
- 10% trường hợp: Giữ nguyên token gốc.
- Mục đích: Giúp mô hình duy trì biểu diễn ngữ cảnh chính xác của token thật mà không mặc định rằng mọi vị trí được chọn đều bị sai lệch.
Mục tiêu tối ưu hóa của MLM là hàm Cross-Entropy Loss chỉ tính riêng trên các token được chọn này:
4.2. Next Sentence Prediction (NSP)
Nhiều tác vụ NLP quan trọng (như Hỏi đáp - QA, Suy luận ngôn ngữ tự nhiên - NLI) đòi hỏi khả năng hiểu mối quan hệ logic giữa hai câu văn. BERT giải quyết việc này bằng tác vụ phân loại nhị phân NSP:
- Lấy 50% cặp câu liên tiếp có thật trong văn bản gốc (nhãn
IsNext). - Lấy 50% cặp câu trong đó câu được bốc ngẫu nhiên từ kho dữ liệu (nhãn
NotNext). - Vector đầu ra tại vị trí token
[CLS]được đưa qua một lớp Feed-Forward để dự đoán xác suất .
Tổng hàm mất mát tiền huấn luyện:
5. Triển khai thực chiến: Fine-tuning BERT cho bài toán Phân loại Văn bản
Sau khi BERT được tiền huấn luyện trên kho dữ liệu khổng lồ (Wikipedia + BookCorpus với 3.3 tỷ từ), chúng ta có thể tinh chỉnh mô hình (Fine-tuning) cho một tác vụ cụ thể chỉ sau vài epoch với chi phí tính toán rất nhỏ.
Dưới đây là pipeline hoàn chỉnh sử dụng thư viện transformers của Hugging Face và PyTorch.
import torch
from torch.utils.data import DataLoader, Dataset
from transformers import BertTokenizer, BertForSequenceClassification, AdamW
from transformers import get_linear_schedule_with_warmup

# 1. Cấu hình thiết bị tính toán
device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
print(f"Đang sử dụng thiết bị: {device}")

# 2. Khởi tạo Tokenizer và Mô hình đã pre-trained
MODEL_NAME = "bert-base-uncased"
tokenizer = BertTokenizer.from_pretrained(MODEL_NAME)
model = BertForSequenceClassification.from_pretrained(MODEL_NAME, num_labels=2)
model.to(device)

# 3. Định nghĩa Dataset tùy chỉnh
class TextClassificationDataset(Dataset):
    def __init__(self, texts, labels, tokenizer, max_len=128):
        self.texts = texts
        self.labels = labels
        self.tokenizer = tokenizer
        self.max_len = max_len

    def __len__(self):
        return len(self.texts)

    def __getitem__(self, item):
        text = str(self.texts[item])
        label = self.labels[item]

        encoding = self.tokenizer.encode_plus(
            text,
            add_special_tokens=True,       # Thêm [CLS] và [SEP]
            max_length=self.max_len,
            padding='max_length',
            truncation=True,
            return_attention_mask=True,    # Mask các token padding (0 cho pad, 1 cho token thật)
            return_tensors='pt',
        )

        return {
            'input_ids': encoding['input_ids'].flatten(),
            'attention_mask': encoding['attention_mask'].flatten(),
            'labels': torch.tensor(label, dtype=torch.long)
        }

# Dữ liệu mẫu giả lập
sample_texts = [
    "I absolutely loved this movie, the plot was amazing!",
    "Terrible customer service, I am deeply disappointed.",
    "The software performance is incredibly fast and reliable.",
    "Worst experience ever, totally a waste of time and money."
]
sample_labels = [1, 0, 1, 0] # 1: Tích cực, 0: Tiêu cực

train_dataset = TextClassificationDataset(sample_texts, sample_labels, tokenizer)
train_loader = DataLoader(train_dataset, batch_size=2, shuffle=True)

# 4. Cấu hình Optimizer và Learning Rate Scheduler
epochs = 3
optimizer = AdamW(model.parameters(), lr=2e-5, eps=1e-8)
total_steps = len(train_loader) * epochs
scheduler = get_linear_schedule_with_warmup(optimizer, num_warmup_steps=0, num_training_steps=total_steps)

# 5. Vòng lặp huấn luyện (Training Loop)
model.train()
for epoch in range(epochs):
    total_loss = 0
    for batch in train_loader:
        optimizer.zero_grad()

        input_ids = batch['input_ids'].to(device)
        attention_mask = batch['attention_mask'].to(device)
        labels = batch['labels'].to(device)

        # Forward pass: Mô hình tự động tính CrossEntropyLoss khi có tham số labels
        outputs = model(
            input_ids=input_ids,
            attention_mask=attention_mask,
            labels=labels
        )

        loss = outputs.loss
        total_loss += loss.item()

        # Backward pass & Gradient Clipping
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)

        optimizer.step()
        scheduler.step()

    avg_loss = total_loss / len(train_loader)
    print(f"Epoch {epoch + 1}/{epochs} | Training Loss trung bình: {avg_loss:.4f}")
6. So sánh thực nghiệm: BERT vs. GPT vs. RoBERTa vs. DistilBERT
Sau khi BERT ra đời, nhiều biến thể cải tiến liên tục xuất hiện nhằm khắc phục các điểm yếu về tốc độ hoặc tối ưu quy trình tiền huấn luyện:
| Mô hình | Kiến trúc cốt lõi | Chiến lược huấn luyện chính | Ưu điểm nổi bật | Điểm hạn chế |
|---|---|---|---|---|
| BERT | Transformer Encoder | MLM + NSP | Hiểu sâu ngữ cảnh 2 chiều, chuẩn mực cho NLU | Kích thước lớn, chậm khi suy luận |
| GPT (1/2/3/4) | Transformer Decoder | Autoregressive (Causal LM) | Xuất sắc trong sinh văn bản, reasoning | Kém tối ưu hơn BERT ở các bài toán phân loại/trích xuất |
| RoBERTa | Transformer Encoder | Chỉ dùng MLM (Bỏ NSP), Dynamic Masking | Độ chính xác cao hơn BERT, train trên dữ liệu lớn gấp 10 lần | Chi phí tính toán huấn luyện rất đắt |
| DistilBERT | Transformer Encoder | Knowledge Distillation từ BERT | Giảm 40% kích thước, tăng 60% tốc độ, giữ 97% hiệu năng | Độ chính xác suy giảm nhẹ ở tác vụ khó |
| ALBert | Transformer Encoder | Cross-layer parameter sharing + SOP | Giảm số lượng tham số đáng kể (Parameters) | Tốc độ suy luận không tăng nhiều do số phép tính giữ nguyên |
7. Các thách thức kỹ thuật khi đưa BERT vào Production
Dù BERT mang lại độ chính xác vượt trội, việc triển khai nó trên hệ thống phục vụ hàng nghìn lượt truy cập mỗi giây (Serving Production) đặt ra nhiều bài toán hóc búa cho các kỹ sư:
- Độ trễ suy luận cao (Latency Bottleneck):
- Độ phức tạp tính toán của cơ chế Self-Attention là , với là độ dài chuỗi (sequence length). Khi độ dài đạt mốc tối đa 512 tokens, ma trận Attention tiêu tốn lượng lớn bộ nhớ RAM và thời gian tính toán.
- Giải pháp: Áp dụng kỹ thuật nén mô hình (Quantization sang INT8, Pruning cắt tỉa trọng số dư thừa) hoặc chuyển đổi mô hình sang định dạng tối ưu hóa thực thi như ONNX Runtime hoặc TensorRT.
- Kích thước mô hình lớn:
- Một checkpoint BERT-Base tiêu chuẩn nặng xấp xỉ 440 MB. Khi nhân bản nhiều instance phục vụ microservices, dung lượng VRAM GPU bị chiếm dụng rất lớn.
- Giải pháp: Sử dụng các mô hình chưng cất tri thức (Knowledge Distillation) như DistilBERT, TinyBERT hoặc MobileBERT cho các dịch vụ đòi hỏi phản hồi dưới 20ms.
- Giới hạn độ dài ngữ cảnh (512 tokens):
- BERT nguyên bản không thể xử lý trực tiếp các tài liệu dài hàng chục trang (văn bản pháp lý, báo cáo tài chính).
- Giải pháp: Chia nhỏ tài liệu theo kỹ thuật Sliding Window hoặc sử dụng các biến thể hỗ trợ chuỗi dài như Longformer hoặc BigBird (sử dụng Sparse Attention để giảm độ phức tạp xuống ).
8. Lời kết
Sự xuất hiện của BERT là cột mốc lịch sử phân chia kỷ nguyên NLP thành hai giai đoạn rõ rệt: Trước BERT (kỷ nguyên các mô hình đặc thù, phụ thuộc vào kỹ nghệ trích xuất đặc trưng thủ công) và Sau BERT (kỷ nguyên của Pre-trained Foundation Models và Fine-tuning).
Hiểu sâu về cơ chế hai chiều, cấu trúc Transformer Encoder và hàm mục tiêu Masked LM của BERT không chỉ giúp bạn làm chủ các bài toán phân loại văn bản, trích xuất thực thể (NER) hay hệ thống tìm kiếm ngữ nghĩa (Semantic Search), mà còn là nền tảng tư duy vững chắc để tiếp cận các mô hình ngôn ngữ lớn (LLM) hiện đại ngày nay.
All rights reserved
