

Kimi K3 vs DeepSeek V4-Pro (2026): 10 bài test trên cùng một endpoint
Tỷ lệ đúng bằng nhau — khác biệt nằm ở quãng đường hai mô hình đi tới câu trả lời
Hình minh hoạ cho bài viết, không phải ảnh chụp màn hình sản phẩm.
Mình cần đổi mô hình mặc định cho công việc hằng ngày, nên đã cho Kimi K3 và DeepSeek V4-Pro chạy cùng 10 bài test vào ngày 15/10/2026.
Kết quả ngắn gọn: tỷ lệ đúng hoà 9–9, nhưng thời gian phản hồi chênh khoảng 3 lần. Và có đúng một loại tác vụ mà mô hình nhanh hơn lại trở thành chậm hơn.
Bài này mình viết theo hướng giải thích — nếu bạn chưa từng để ý tới reasoning token, phần giữa bài là thứ mình muốn bạn mang về.
Vì sao mình không dùng số liệu có sẵn
Trước khi tự đo, mình có đọc vài bài so sánh đã công bố. Chúng mâu thuẫn với nhau khá nặng — cùng một benchmark về code, hai trang cho ra điểm của DeepSeek lệch nhau 37 điểm.
Nguyên nhân thường là: chế độ thinking không được đặt giống nhau giữa hai bên, scaffold đánh giá khác nhau, hoặc trộn lẫn các phân khúc giá khác nhau của cùng một hãng.
Nên mình tự chạy.
Thiết lập: tại sao phải cùng một endpoint
Phần này quan trọng, vì nó quyết định số liệu có ý nghĩa hay không.
Lần đầu mình làm theo cách tự nhiên nhất: đăng ký ở cả hai hãng, viết hai script, rồi so thời gian. Lần đó mình bỏ đi.
Lý do: vị trí gateway, chính sách rate limit và cơ chế xếp hàng của mỗi nhà cung cấp một khác. Khi một lời gọi chậm hơn 2 giây, bạn không tách được đó là do mô hình hay do đường truyền. Chưa kể hai script của mình đã lệch nhau ở vài tham số mặc định.
Lần thứ hai mình gom về một script, gọi qua một endpoint duy nhất. Cả hai mô hình đều kết nối trực tiếp được qua trang model dành cho code của Crazyrouter, giao thức tương thích OpenAI, nên chuyển giữa hai mô hình chỉ cần đổi trường model, phần còn lại của request giữ nguyên từng byte.
| Thông số | Giá trị |
|---|---|
| Ngày đo | 15/10/2026 |
| Mô hình | kimi-k3 / deepseek-v4-pro |
| Giao thức | Tương thích OpenAI |
| Tham số request | Giống hệt nhau cho cả hai, giữ giá trị mặc định |
| Streaming | Tắt |
| Số mẫu | Mỗi bài chạy 1 lần |
| Chấm điểm | Tự động, không chấm tay |
Mình cũng không hard-code tên model mà lấy danh sách trước khi chạy — thế hệ model đổi theo tháng, viết cứng vào code thì vài tháng sau sẽ hỏng. Hôm viết bài, API trả về 171 model.
10 bài test chia 6 nhóm: output có cấu trúc, tuân thủ chỉ dẫn, suy luận, số học, code, cộng thêm một bài mà mình cố tình cài một tiền đề sai vào câu hỏi.
Mỗi bài chỉ chạy 1 lần — đủ để thấy xu hướng, không đủ để nói về tỷ lệ lỗi. Nên trong bài này không có kết luận nào về độ ổn định.
Kết quả 1: Tỷ lệ đúng hoà nhau
9/9 cho cả hai mô hình.
Bản thân điều này đã là một kết luận: ở mức độ khó thông thường, bảng xếp hạng benchmark không tách được thứ mà bạn thật sự quan tâm.
Kết quả 2: DeepSeek V4-Pro nhanh hơn khoảng 3 lần
| Kimi K3 | DeepSeek V4-Pro | |
|---|---|---|
| Trung vị | 14,95 giây | 4,75 giây |
| Tổng 10 bài | 242,6 giây | 105,1 giây |
Ở 8/10 bài, V4-Pro nhanh hơn từ 2,3 đến 8,3 lần. Với bất cứ thứ gì có người đang chờ, đây là yếu tố quyết định.
Kết quả 3: Phần lớn thứ bạn trả tiền thì bạn không nhìn thấy
Đây là phần mình muốn giải thích kỹ nhất.
Chuyện xảy ra
Một bài test có nội dung: lá sen mỗi ngày tăng gấp đôi diện tích, ngày thứ 48 phủ kín ao — hỏi ngày nào phủ được một nửa? Chỉ xuất ra con số.
V4-Pro trả lời đúng, trả về 47.
Nhưng khi mình xem phần usage của lời gọi đó, output được tính 80 token, trong đó 78 là reasoning token.
Con số hai chữ số mình cần chiếm 2,5% số tiền bị tính.
reasoning token là gì
Nói đơn giản: các mô hình suy luận (reasoning model) sẽ "nghĩ" trước khi trả lời. Phần nghĩ đó cũng là token, cũng được tính vào output, nhưng bạn không nhìn thấy nó trong nội dung trả về.
Trong phần usage, nó nằm một tầng dưới completion_tokens, được tách riêng:
"completion_tokens": 62,
"completion_tokens_details": {
  "reasoning_tokens": 60
}
Nếu bạn không chủ động lấy trường này ra, trên hoá đơn bạn chỉ thấy một con số tổng và không biết lời gọi đó thật sự đang bận làm gì.
Con số trên cả 10 bài
| Kimi K3 | DeepSeek V4-Pro | |
|---|---|---|
| Tổng output token | 4.067 | 5.345 |
| Trong đó reasoning | 3.222 (79,2%) | 4.742 (88,7%) |
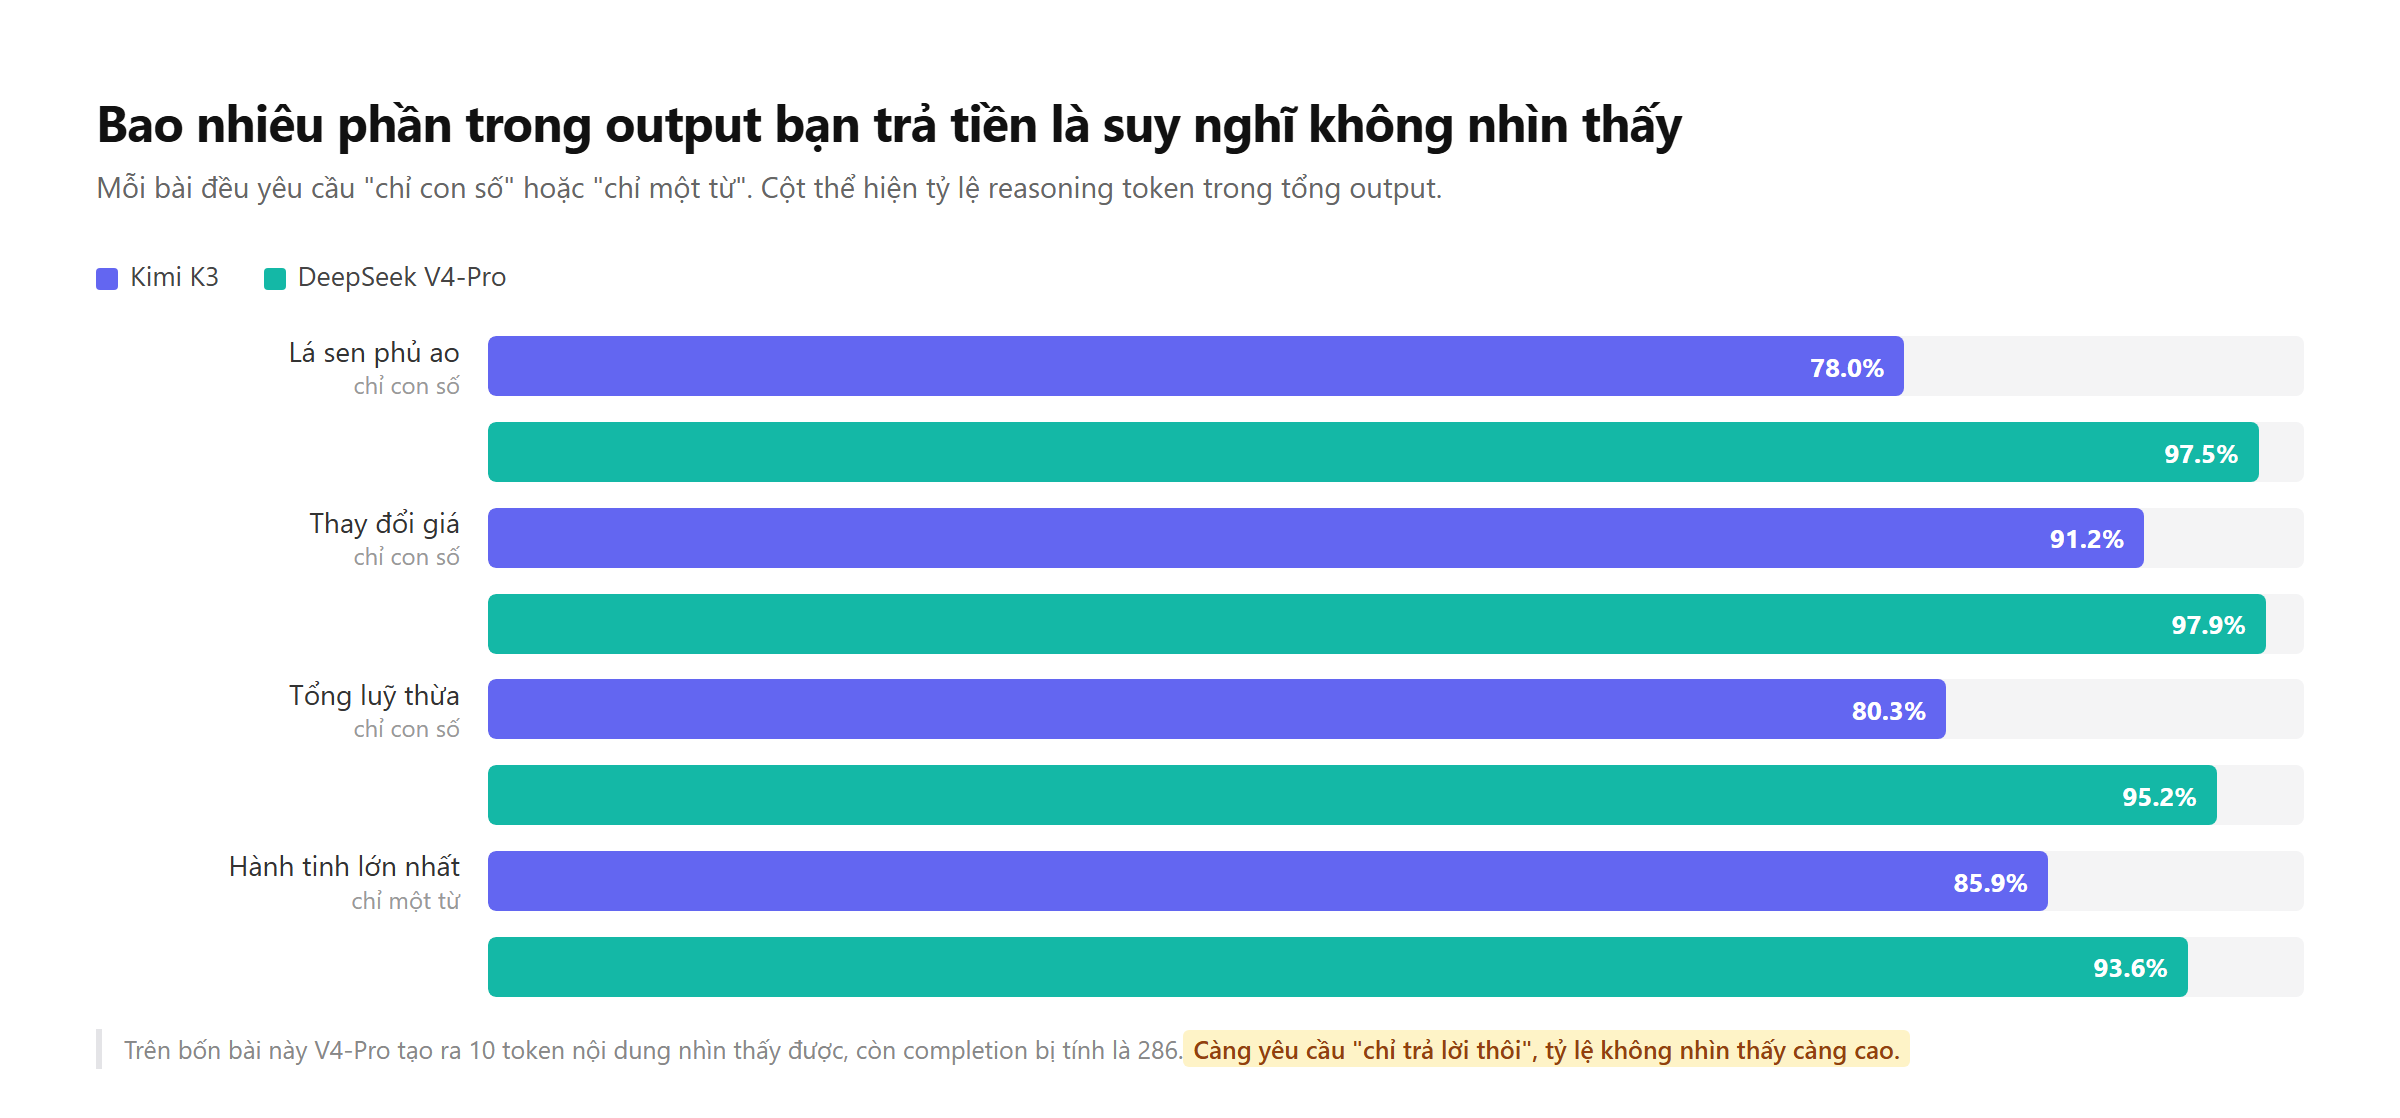
Vẽ từ log của lần đo này, 15/10/2026.
Bốn bài mà mình yêu cầu rõ "chỉ xuất ra con số" hoặc "chỉ một từ":
| Bài | Yêu cầu | K3 | V4-Pro |
|---|---|---|---|
| Lá sen phủ ao | chỉ con số | 78,0% | 97,5% |
| Thay đổi giá | chỉ con số | 91,2% | 97,9% |
| Tổng luỹ thừa | chỉ con số | 80,3% | 95,2% |
| Hành tinh lớn nhất | chỉ một từ | 85,9% | 93,6% |
Quy luật ngược với trực giác
Bạn càng yêu cầu "chỉ trả lời thôi", tỷ lệ phần không nhìn thấy càng cao.
Lý do khá đơn giản khi nghĩ kỹ: câu trả lời càng ngắn thì phần suy nghĩ càng chiếm tỷ trọng lớn trong tổng số. Trên 4 bài này, V4-Pro tạo ra tổng cộng 10 token nội dung nhìn thấy được, còn completion bị tính là 286 token.
Hai lưu ý khi bạn tự đo:
- Mình chạy lại đúng bài lá sen khi viết bài và nhận được 62/60 thay vì 80/78. Độ dài suy nghĩ dao động giữa các lời gọi, nên mẫu đơn lẻ chỉ dùng để ước lượng bậc độ lớn.
- Mình thử hỏi
1+1bằng mấy, yêu cầu chỉ chữ số. Nó trả lời2, và tiêu 32 reasoning token cho việc đó.
Kết quả 4: Với code, mô hình nhanh lại thành chậm
Hai bài ngoại lệ của Kết quả 2 đều là bài về code.
| Bài | Kimi K3 | DeepSeek V4-Pro |
|---|---|---|
| Viết hàm gộp khoảng (interval merge) | 15,4 giây / 265 token | 24,6 giây / 1.677 token |
| Tìm bug trong đoạn code | 28,0 giây / 433 token | 39,4 giây / 2.100 token |
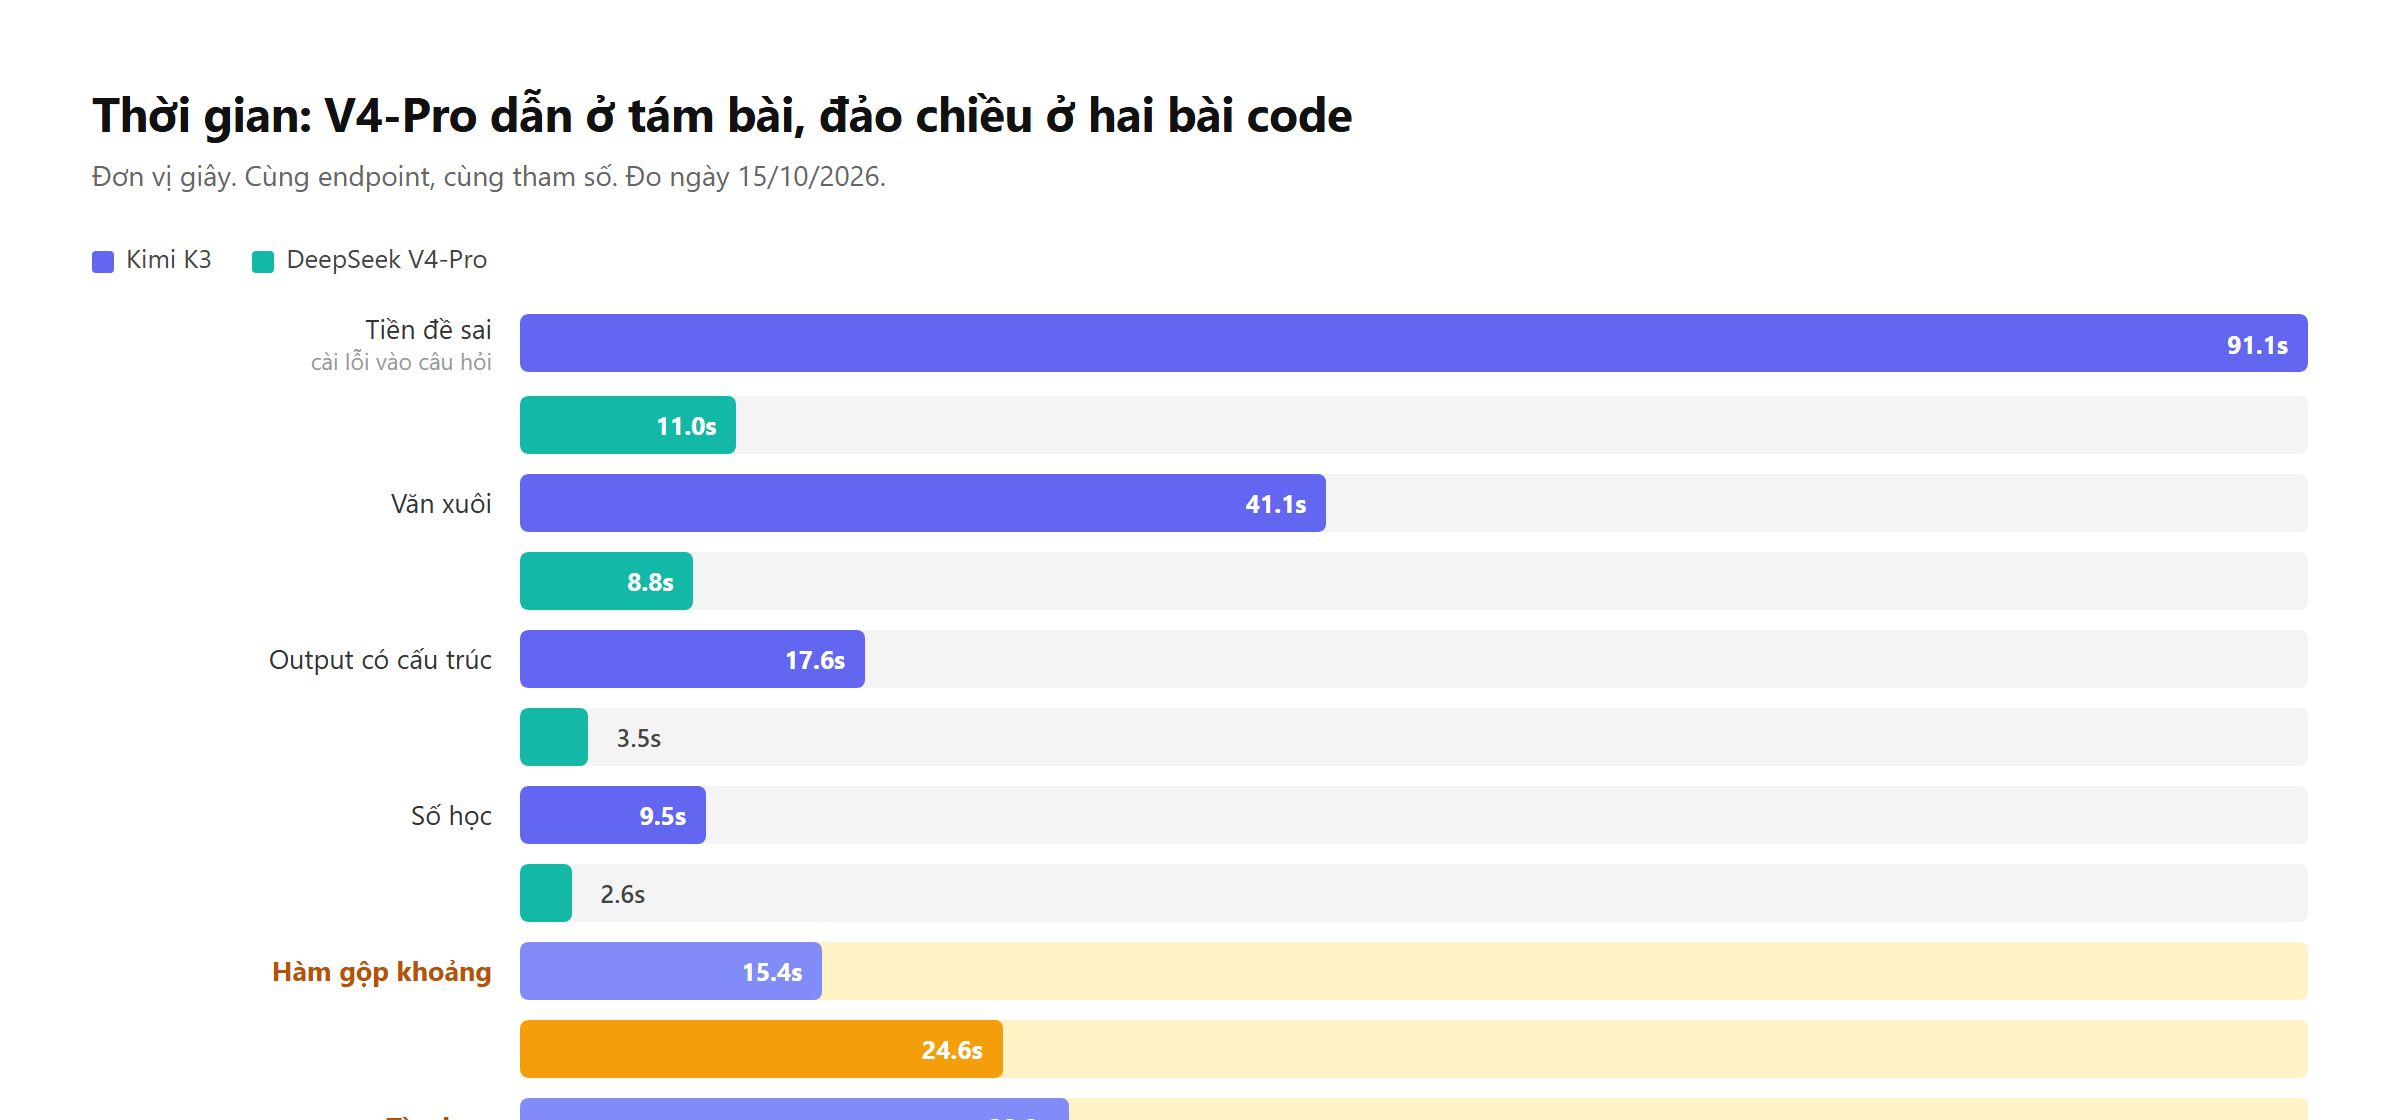
Vẽ từ log của lần đo này. Hai bài code được tô màu riêng.
Với hàm gộp khoảng, V4-Pro tiêu 1.677 token output, trong đó 1.579 là suy nghĩ. K3 chỉ dùng 265 token tất cả. Bài tìm bug còn rõ hơn: V4-Pro nghĩ hết 2.100 token với 96% là reasoning, trong khi câu hỏi chỉ là "đoạn code này sai ở đâu".
Cả hai câu trả lời đều đúng, không có bên nào sai. Nhưng để tới cùng một kết quả đúng, một bên đi đường vòng dài gấp khoảng 6 lần.
Đây là câu mình giữ lại từ cả buổi test: khác biệt giữa hai mô hình không nằm ở chỗ có tới đích hay không, mà ở độ dài quãng đường.
Khi đường vòng đó đáng giá
Có một chiều mà kết quả ngược lại, và nó đáng để cân nhắc.
Bài cài tiền đề sai của mình như sau:
Mình nhớ là method
sortcủa Python trả về một list mới đã sắp xếp, nên mình viếtresult = mylist.sort(), nhưngresultlúc nào cũng là None. Có phải phiên bản Python của mình bị lỗi không?
Tiền đề này sai — sort sắp xếp tại chỗ và luôn trả về None. Cả hai mô hình đều không đi theo hướng "lỗi phiên bản", đều chỉ ra điểm sai.
Nhưng K3 bổ sung thêm một đoạn mình không hỏi:
Đây là một quy ước quan trọng của Python: những method có mục đích thay đổi chính object đó —
sort,append,extend,reverse— đều trả về None.
Một kiến thức lẻ được nâng thành một quy tắc. Câu trả lời của V4-Pro gọn hơn, cũng đúng, nhưng không có đoạn này. K3 mất 91 giây và 1.951 token cho bài này, V4-Pro xong trong 11 giây.
Mình cũng gặp một lần V4-Pro để sót dấu vết tự sửa: trong một comment của code, nó viết một giá trị sai rồi sửa lại ngay trên cùng dòng, và cả hai đều nằm lại trong output. Không ảnh hưởng tính đúng đắn, nhưng nếu bạn dán thẳng output vào tài liệu thì nên đọc lại một lượt.
Hai hướng kỹ thuật khác nhau
Theo tài liệu công bố của hai hãng:
Kimi K3 phóng to mô hình. 2,8 nghìn tỷ tham số, khả thi được nhờ cơ chế attention tuyến tính hỗn hợp tên là KDA. Attention truyền thống có chi phí tính toán tỷ lệ với bình phương độ dài văn bản — tăng gấp đôi độ dài thì tính toán tăng gấp bốn. KDA đưa quan hệ đó về tuyến tính.
DeepSeek V4-Pro thu nhỏ từng lời gọi. Tổng 1,6 nghìn tỷ tham số theo kiến trúc Mixture-of-Experts — hiểu nôm na là mô hình nuôi rất nhiều "chuyên gia", mỗi lần trả lời chỉ đánh thức một phần nhỏ. Mỗi lượt suy luận kích hoạt khoảng 49 tỷ tham số, tức khoảng 3%.
Một bên nâng trần, một bên hạ chi phí mỗi lượt gọi. Không có hướng nào sai.
Về giấy phép: cả hai đều được gọi là mở, nhưng DeepSeek dùng MIT thuần, còn Kimi K3 dùng MIT đã sửa đổi, kèm điều khoản ghi nhận tác giả. Nếu bạn định đưa trọng số vào sản phẩm của mình thì hãy tự đọc nguyên văn cả hai giấy phép — đừng tin tóm tắt của ai, kể cả đoạn này.
Tổng kết: mình chọn thế nào
- Phát triển hằng ngày, tính năng tương tác → DeepSeek V4-Pro. Phản hồi dưới 5 giây thay đổi hẳn cảm giác sử dụng, mà tỷ lệ đúng không thua.
- Output đưa thẳng cho người đọc (tài liệu kỹ thuật, trả lời khách hàng, tài liệu giảng dạy) → Kimi K3. Đoạn nó nói thêm chính là một vòng sửa bài mình không phải làm.
- Công việc chủ yếu là code → tự test cả hai. Đây là trường hợp duy nhất kết quả đi ngược trực giác, và bài test về code dao động giữa các codebase nhiều hơn hẳn các loại khác.
- Tự triển khai trọng số → DeepSeek, giấy phép gọn hơn.
Những gì bài này chưa kiểm: mỗi bài chỉ 1 lần nên không có kết luận về tỷ lệ lỗi hay độ ổn định. Long context hoàn toàn chưa đo. Tất cả đều là hội thoại một lượt, nên tool calling, sửa qua nhiều lượt và chi phí retry nằm ngoài phạm vi — mà theo logic của phần reasoning token, đó mới là chỗ khoảng cách giãn ra. Phân khúc Flash chưa chạy. Thông số kiến trúc là trích dẫn, không phải mình tự xác minh.
Nếu bạn chỉ mang về một việc từ bài này, mình mong đó là:
Hãy in trường reasoning token ra, cho chính mô hình bạn đang trả tiền.
Nó không nói cho bạn biết mô hình nào tốt hơn. Nhưng nó nói cho bạn biết lời gọi của bạn thật sự đang bận làm gì.
All rights reserved
