

# Hướng dẫn kỹ thuật Claude Opus 5.5: tự test và chọn model phù hợp
Khi Anthropic ra mắt Claude Opus 5.5, câu hỏi thực tế thường không phải "nó mạnh cỡ nào", mà là: mình có nên dùng nó không, và nên chọn model nào cho công việc của mình? Thay vì tin vào các bảng benchmark, bài viết này hướng dẫn bạn tự chạy một vòng kiểm thử nhỏ, có thể tái lập, rồi tự đưa ra quyết định.
Vấn đề
"Dùng model mạnh nhất" nghe thì hợp lý, nhưng model mạnh nhất chưa chắc là model phù hợp với bạn — và nó thường đắt hơn nhiều. Để trả lời cho đúng, ta cần dữ liệu từ chính tác vụ của mình, chứ không phải điểm số của người khác. Mục tiêu của bài: sau khi đọc, bạn có thể gọi cả hai thế hệ model, chạy vài phép thử đơn giản, và biết khi nào nên trả tiền cho Opus.
Bối cảnh: Opus 5 và Opus 5.5
Trước tiên, làm rõ hai model để biết ta đang so sánh cái gì.
- Claude Opus 5 (ID
claude-opus-5) là flagship của dòng Opus trước 5.5: cửa sổ ngữ cảnh 1M token, output tối đa 128K, giá khoảng 5 USD/25 USD cho mỗi triệu token (vào/ra), cache read 0.50 USD, và mức "effort" mặc định làhigh. Đây vẫn là bản mà nhiều nhóm đang dùng. - Claude Opus 5.5 (ID
claude-opus-5-5, ra mắt 22/09/2026) là bản kế nhiệm cùng dòng. Giữ nguyên 1M ngữ cảnh và 128K output, nhưng có ba thay đổi quan trọng:- Rẻ hơn: 4 USD/20 USD mỗi triệu token (giảm ~20%), và cache read giảm từ 0.50 USD xuống 0.20 USD (~60%) — phần mà agent tiêu tốn nhiều nhất.
- Nhanh hơn: tốc độ sinh output cao hơn Opus 5 hơn 30%.
- "Suy nghĩ" ít hơn theo mặc định: thinking luôn bật và không tắt được; mức mặc định hạ từ
highxuốngmedium.
Vài thuật ngữ cho người mới: token là đơn vị tính tiền (xấp xỉ "từ"); effort là mức độ model "suy nghĩ sâu" trước khi trả lời, có 5 mức low, medium, high, xhigh, max; cache read là chi phí đọc lại phần ngữ cảnh đã được cache (thường chiếm phần lớn chi phí của agent).
Thử tính một ví dụ chi phí
Vì cache read thường chiếm phần lớn hóa đơn của agent, mức giảm 60% ở đây rất đáng kể. Ví dụ một agent gọi 10.000 lần/ngày, mỗi lần đọc ~5k token ngữ cảnh (phần lớn trúng cache) và sinh ~500 token:
- Riêng cache read: ~50 triệu token/ngày → Opus 5.5 khoảng 10 USD/ngày, còn Opus 5 khoảng 25 USD/ngày — chênh vài trăm USD mỗi tháng.
- Nếu những việc đó thật ra Sonnet 5.5 làm được (giá output bằng một nửa Opus), bạn còn tiết kiệm thêm một nửa ở phần output.
Bài học: khoản tiết kiệm lớn nhất thường không đến từ việc "chọn Opus rẻ hơn", mà từ việc không dùng Opus cho những việc không cần đến nó. (Bảng giá Opus 5 theo từng nhà cung cấp để tham khảo: giá Claude Opus 5.)
Thực hành: tự gọi và kiểm thử
Bạn có thể dùng Opus 5.5 qua API của Anthropic, các nhà cung cấp cloud, hoặc một API gateway cho phép dùng chung một key và đổi model chỉ bằng một trường. Các phép thử dưới đây mình chạy qua một gateway (Crazyrouter, https://cn.crazyrouter.com, theo chuẩn Anthropic Messages API) — đổi model là chuyển qua lại giữa hai thế hệ:
from anthropic import Anthropic

client = Anthropic(base_url="https://cn.crazyrouter.com", auth_token="<key>")

for model in ["claude-opus-5-5", "claude-opus-5"]:
    msg = client.messages.create(
        model=model, max_tokens=16000,
        messages=[{"role": "user",
                   "content": "Generate an SVG of a pelican riding a bicycle. Only the SVG."}],
    )
    print(model, msg.usage)
Vài lưu ý khi gọi
- Tên model dùng gạch nối:
claude-opus-5-5. Viết thànhclaude-opus-5.5sẽ bị404. - thinking tính vào
max_tokens: dù phần "suy nghĩ" không được trả về theo mặc định, nó vẫn ăn vào hạn mức. Hãy đặtmax_tokensđủ cho cả phần suy nghĩ lẫn câu trả lời (với tác vụ agent dài, 64K là mức khởi đầu hợp lý), và dùng streaming cho các yêu cầu lớn để tránh timeout. - Đặt
effortcó chủ đích: mặc định làmedium; chỉ nâng lên khi bạn thực sự đo được lợi ích — nâng mù thường chỉ tốn thêm token.
Mình cố ý chọn hai phép thử ở hai thái cực: một bài sinh nội dung dài và một bài suy luận ngắn.
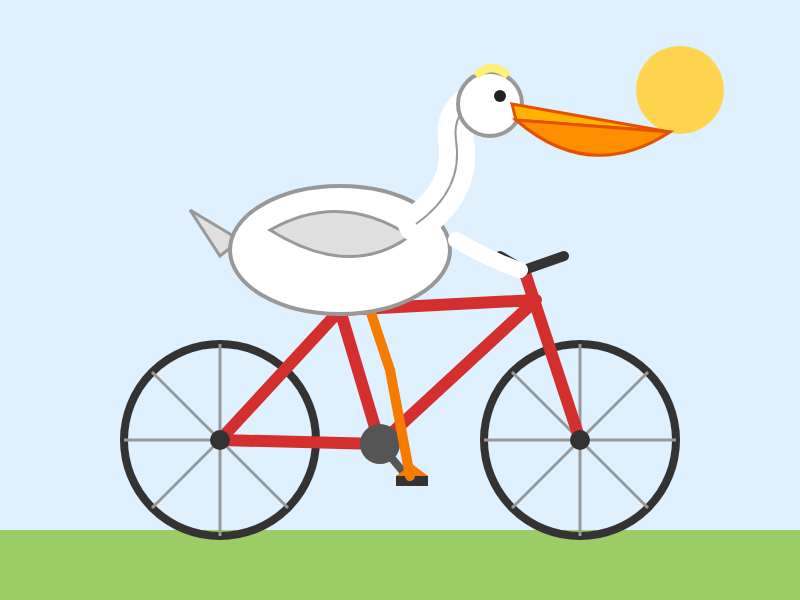
Phép thử 1: vẽ một con bồ nông đạp xe (SVG)
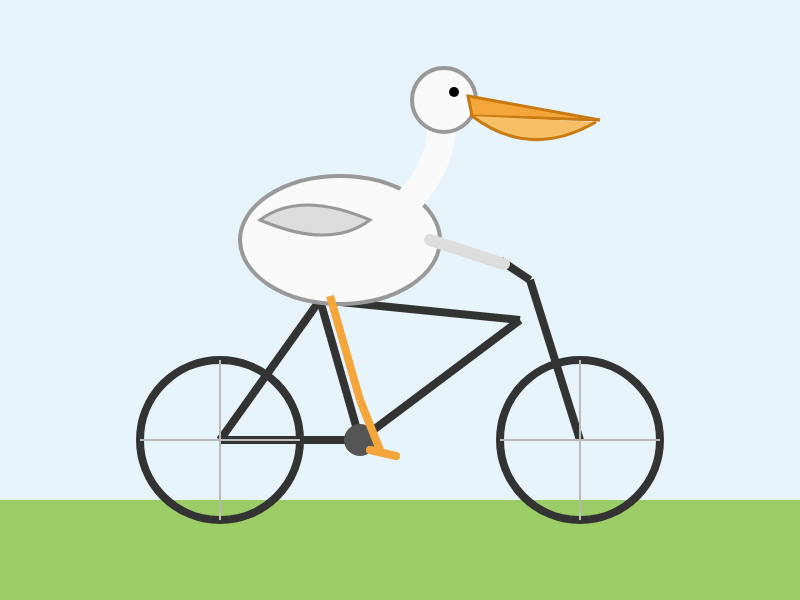
Yêu cầu model xuất một đoạn SVG trong một lần, rồi render ra xem cấu trúc có hợp lý không. Chạy tham số mặc định (5.5 ở medium, 5 ở high):
| Mặc định | Thời gian | Token (ra) |
|---|---|---|
| opus-5-5 | 11,5 giây | 1.076 |
| opus-5 | 32,2 giây | 2.462 |
| opus-5-5 (mặc định, medium) | opus-5 (mặc định, high) |
|---|---|
 |
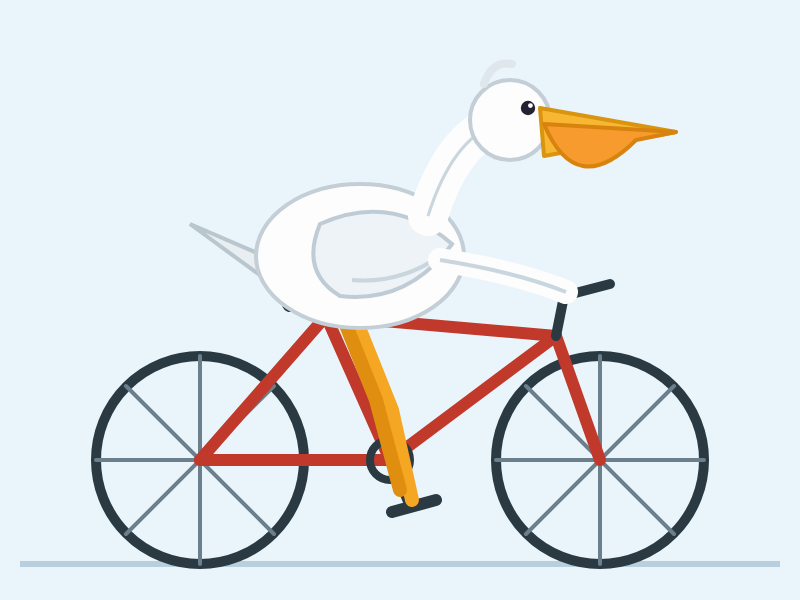 |
Ở mặc định, 5.5 nhanh gần 3 lần và vẽ gọn gàng — đó là do mức effort mặc định, không phải vì yếu hơn. Đặt cả hai về high để so cùng mức:
| effort=high | Thời gian | Token (ra) | SVG |
|---|---|---|---|
| opus-5-5 | 16,8 giây | 1.688 | 2.740 |
| opus-5 | 22,3 giây | 1.863 | 3.038 |
| opus-5-5 (high) | opus-5 (high) |
|---|---|
 |
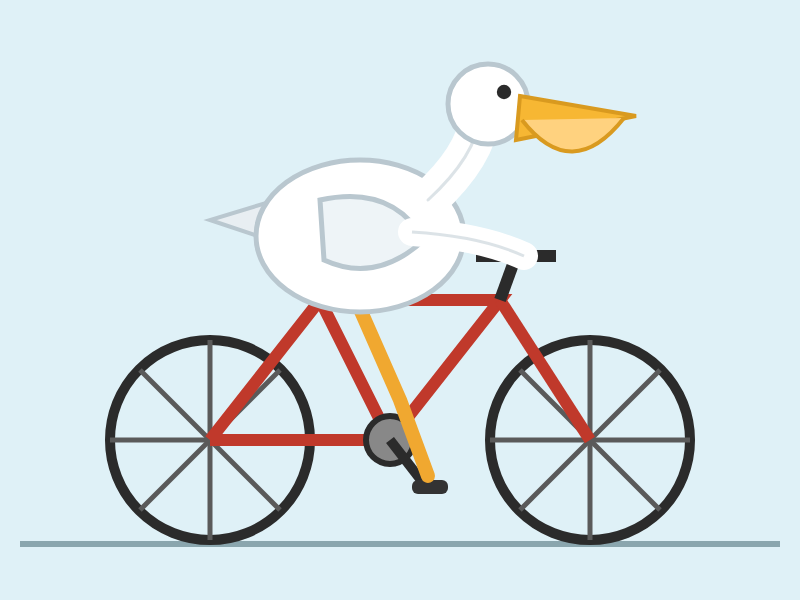 |
Cùng mức high, chi tiết của 5.5 bắt kịp (khung xe, nan hoa, bàn đạp nối với chân, thậm chí thêm mặt trời) mà vẫn nhanh hơn.
Phép thử 2: một bài toán có đáp án duy nhất
Một số có hai chữ số, tổng hai chữ số bằng 12; đổi chỗ hàng chục và hàng đơn vị thì số mới lớn hơn số cũ 18. Tìm số đó. (Đáp án: 57.)
| Bài toán | Đáp án | Thời gian | Token (vào/ra) |
|---|---|---|---|
| opus-5-5 | 57 ✅ | 6,4 giây | 102 / 431 |
| opus-5 | 57 ✅ | 6,0 giây | 78 / 394 |
Cả hai đều đúng, thời gian và token gần như nhau (lần này Opus 5 còn nhỉnh hơn một chút).
Kết quả và tổng kết
Gộp hai phép thử lại, kết luận khá rõ: khác biệt thế hệ chủ yếu nằm ở việc sinh nội dung dài, phức tạp; còn với suy luận ngắn đơn giản thì hai thế hệ gần như ngang nhau. Vì vậy "có nên dùng Opus 5.5 không" không có một câu trả lời chung.
Gợi ý chọn model theo công việc:
- Code hằng ngày, sửa bug, refactor thông thường → Sonnet 5.5. Giá bằng một nửa Opus, thậm chí còn nhỉnh hơn Opus 5.5 ở coding dạng terminal; dùng hằng ngày là đủ.
- Việc dài, mở, rủi ro cao (migration lớn, kiến trúc phức tạp, debug khó, chạy agent lâu) → Opus 5.5, nhưng hãy chỉnh
efforttheo từng task, đừng mặc định kéo lênmax. - Nhiều lệnh gọi đơn giản, số lượng lớn (phân loại, trích xuất, routing, subagent) → Haiku 5.5, nhanh và rẻ.
Nếu bạn đang chạy code trên Opus 5 và muốn chuyển sang 5.5, lưu ý bốn thay đổi gây lỗi: thinking không tắt được (budget_tokens/disabled → 400), bỏ ép tool (tool_choice: any/tool → 400), preserved thinking (giữ lịch sử ở dạng chỉ-thêm), và computer use đổi sang computer_toolset_20260801. Và nhớ đặt effort một cách có chủ đích thay vì kế thừa mặc định của Opus 5.
Tự xây một bộ test nhỏ cho riêng bạn
Hai phép thử trên chỉ là ví dụ; điều đáng mang về là phương pháp:
- Chọn vài tác vụ sát với công việc thật của bạn và kiểm chứng được (một đoạn code phải chạy đúng, một câu hỏi có đáp án cố định).
- Khi so hai model, giữ
effortgiống nhau, và chạy mỗi ca vài lần rồi lấy giá trị đại diện — chạy một lần rất dễ bị nhiễu. - So sánh bằng token và chất lượng đầu ra, đừng chỉ nhìn thời gian (thời gian còn phụ thuộc gateway và tải mạng).
- Mỗi lần đổi model, đổi nhà cung cấp hoặc đổi tuyến, hãy chạy lại bộ test này; đồng thời đọc lại tên model trong phản hồi để chắc chắn bạn đang dùng đúng model đã trả tiền — vài gateway giá rẻ có thể âm thầm trả về một model nhỏ hơn.
Lời khuyên cuối: đừng quyết dựa trên bảng xếp hạng. Hãy lấy chính tác vụ thật của bạn, cho vài model chạy thử như trên, rồi để kết quả và hóa đơn lên tiếng.
Thông số và giá lấy từ tài liệu chính thức của Anthropic (tính đến 10/2026), hãy kiểm tra lại trước khi dùng. Các phép thử ở trên là lần chạy đơn lẻ qua một gateway; thời gian là end-to-end (gồm cả định tuyến của gateway), không phải tốc độ thuần của model, nên token là chỉ số đáng tin hơn. Bài viết được soạn với sự hỗ trợ của AI.
All rights reserved
