

GPT-6.1 Sol hay GPT-6 Sol: mình thử cùng một bộ việc và chọn thế nào?
GPT-6 Sol vừa ổn trong vài script thì GPT-6.1 Sol đã ra. Nếu bạn đã gắn model vào assistant viết code, script xử lý tài liệu hay một service nội bộ, câu hỏi thực tế không phải “bản nào mới hơn”, mà là: đổi xong, mình bớt được những bước sửa tay nào?
Sau khi chạy cùng một bộ việc, mình rút ra cách chọn khá thẳng:
- Sửa code nhiều file, hoặc chuỗi việc nhiều bước có tool → ưu tiên thử GPT-6.1 Sol
- Script ngắn, rule rõ, đã qua kiểm tra ổn định → đừng đổi chỉ vì tên model có
.1
Ngày 30/9/2026, mình gửi cùng nhiệm vụ code và xử lý tài liệu cho hai model qua Crazyrouter. Hàm nhỏ cả hai viết đúng; bản mới vẫn có lần đếm thiếu. Ngày 3/11/2026 khi viết bài này, mình chạy lại code đã lưu. Kết hợp phần OpenAI công bố, một số thay đổi đáng thử trên pipeline thật; một số việc giữ GPT-6 Sol vẫn hợp lý.
GPT-6.1 Sol liên quan thế nào với GPT-6 Sol?
GPT-6.1 Sol là bản cập nhật của GPT-6 Sol. Hai bản lần lượt ra ngày 29 và 22/9/2026 — cách nhau một tuần. Nên xem GPT-6 Sol là phiên bản liền trước, không phải “sản phẩm cũ lâu năm”.
Khi công bố, OpenAI nhấn mạnh cải thiện ở lập trình, tài liệu chuyên môn và công việc nhiều bước. Nếu bạn hay nhờ model đọc hết logic nghiệp vụ rồi mới làm bước tiếp theo, hướng này đáng kiểm trên case của bạn. Mức lợi cụ thể chỉ hiện khi chạy trên quy trình thật. OpenAI: Introducing GPT-6.1 Sol
Hai định danh cần nhớ khi gọi API:
| Tên trên giao diện | Chuỗi chính xác trong request | Câu hỏi nên tự hỏi |
|---|---|---|
| GPT-6 Sol | gpt-6-sol |
Có cần đụng luồng đang chạy ổn không? |
| GPT-6.1 Sol | gpt-6.1-sol |
Việc khó hơn có mang lại lợi ích đo được không? |
Một chi tiết dễ vấp: URL trang model đôi khi ghi gpt-6-1-sol, trong khi field model cần dấu chấm — gpt-6.1-sol. Sai chỗ này là request dừng ngay từ bước đầu.
Khi nhờ GPT-6.1 Sol và GPT-6 Sol viết code: thứ tự rule nghiệp vụ quan trọng hơn “code đẹp”
Phần khó khi nhờ model viết code thường nằm ở thứ tự bước, không phải cú pháp.
Ví dụ hàm xử lý billing: trước hết khử trùng theo event ID (bản ghi đến trước thắng), rồi lọc khoảng thời gian, loại tài khoản nội bộ, cuối cùng cộng trừ phí và hoàn tiền. Từng bước đều đơn giản; đổi chỗ hai bước là kết quả khác.
Mình đưa cùng yêu cầu cho hai model. Cả hai đều xử lý đúng. Hình dung cùng một ID xuất hiện trước ngoài khoảng thống kê, sau đó lại xuất hiện trong khoảng. Theo “đến trước được ưu tiên”, bản ghi sau là trùng và không được cộng. Nếu lọc thời gian trước, bản ghi đầu biến mất và bản thứ hai có thể bị tính nhầm là sự kiện hợp lệ.
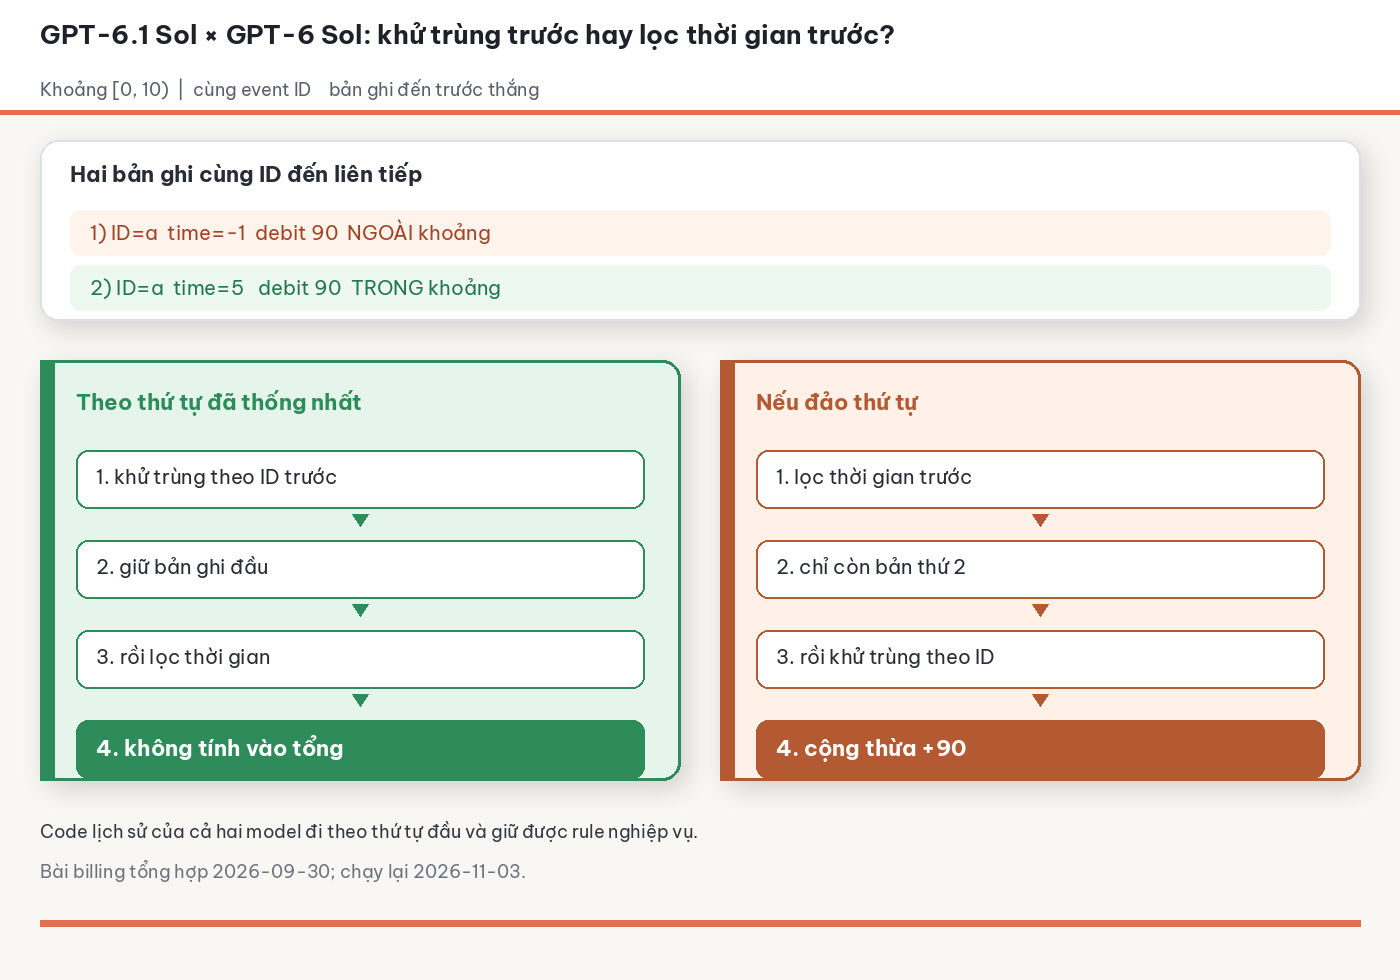
Sai thứ tự có thể cộng thừa 90. Code hai model tạo ra đều tránh được bẫy này.
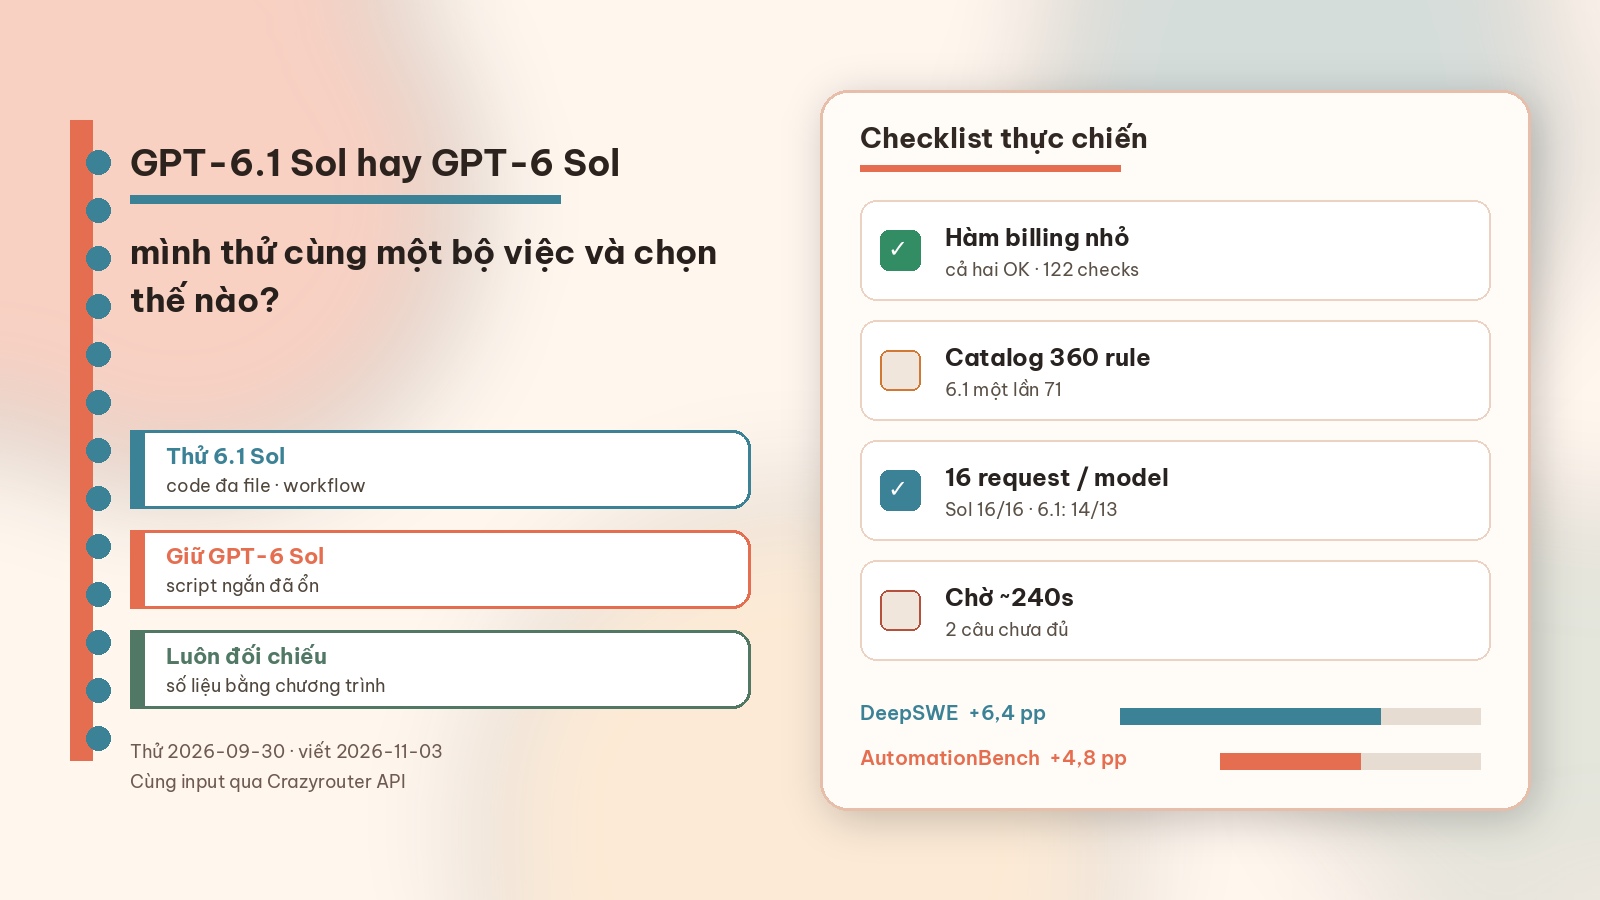
Mỗi model mình cho viết hai lần, cùng prompt tiếng Anh, reasoning_effort: "high", max_completion_tokens: 8192. Sau đó chạy lại bốn hàm đã lưu: mỗi hàm vượt 122 kiểm tra — trùng lặp, biên thời gian, hoàn tiền, tài khoản nội bộ, và không làm thay đổi input gốc. Một hàm nhỏ không nói lên khoảng cách trên repo lớn. Nhưng nếu khối việc hằng ngày của bạn đúng kiểu script này, mình không thấy lý do gỡ GPT-6 Sol ngay.
Khi công việc chuyển sang sửa xuyên file, đọc project lạ, vòng “test → sửa → test lại”, hướng nâng cấp của GPT-6.1 Sol thú vị hơn. Trên DeepSWE v1.1, OpenAI cho biết bản mới, ở cường độ suy luận thấp hơn, cao hơn điểm tốt nhất của GPT-6 Sol 6,4 điểm phần trăm. Đây là thước đo cho bài toán codebase phức tạp, khác hẳn một hàm gọn. Nếu bạn thường xuyên để model sửa project liên tục, nên xem chỉ số này hơn là kết quả sinh hàm đơn. Đánh giá OpenAI
Trên thực tế, đưa kèm đoạn code lỗi, hành vi kỳ vọng và các rule không được phá thường hiệu quả hơn câu “tối ưu giúp mình”. Hàm nhỏ đã đúng thì đổi model thường chẳng thấy gì; việc phải giải thích lần hai, lần ba mới đáng xem GPT-6.1 Sol có rút vòng lặp không.
Khi GPT-6.1 Sol và GPT-6 Sol đọc tài liệu: hiểu đúng nghĩa vẫn cần đối chiếu số
Xử lý tài liệu cũng có bẫy tương tự: model giải thích đúng văn bản vẫn có thể đếm sai.
Mình chuẩn bị catalog tổng hợp 360 rule và nhờ kiểm một khẳng định: chỉ có hai rule thỏa điều kiện, và tài liệu có ưu tiên “thời gian lưu càng dài càng quan trọng”. Đáp án đúng là 72 rule, và ưu tiên đó không có trong nguồn.
GPT-6 Sol trả lời đúng cả hai lần. GPT-6.1 Sol cũng nhận ra khẳng định sai và ưu tiên không được viết, nhưng một lần ghi 71 thay vì 72, lần còn lại mới đúng hoàn toàn.
Một đơn vị thiếu nhắc mình cách chia việc: model giải thích rule, tìm căn cứ, gom field; còn tổng số và số tiền nên để chương trình chốt. Với báo cáo vận hành, mình muốn có kết luận, các bản ghi liên quan và cách tính — để lần từng con số.
Nếu bạn hay xử lý PDF dày, điều kiện trải nhiều đoạn, hoặc nhiều file cùng lúc, GPT-6.1 Sol đáng thử. Nhưng với số tiền, số lượng, ngày tháng và ngoại lệ điều khoản, vẫn giữ bằng chứng gốc để đối chiếu. Input của mình là plain text; mình chưa thử nhận diện biểu đồ trong PDF — tài liệu scan cần chạy riêng trên file thật của bạn.
Chuỗi nhiều bước với GPT-6.1 Sol và GPT-6 Sol: kế hoạch của model ≠ tool đã chạy
Nối nhiều bước — đọc ticket, phân loại, tra tài liệu, soạn phản hồi — là lý do khác để thử GPT-6.1 Sol. Lượng thông tin và phụ thuộc trước-sau nhiều hơn một câu hỏi ngắn.
Trên AutomationBench, OpenAI báo GPT-6.1 Sol ở cường độ trung bình cao hơn GPT-6 Sol cùng cấu hình 4,8 điểm phần trăm. Thước đo nhắm đúng bài toán nghiệp vụ nhiều bước có tool, đủ để làm lý do “nên thử”. Ghi chú OpenAI về workflow
Trong app thật, hành động do tool và code của bạn thực hiện. Câu “đã cập nhật” do model viết không thay được một dòng trong DB; kế hoạch đầy đủ cũng không chứng minh tool đã chạy theo kế hoạch. Khi đổi model, hãy kiểm kết quả cuối theo quy trình hiện có — đặc biệt các bước ghi dữ liệu hoặc kích hoạt bước tiếp.
Đang dùng GPT-6 Sol ổn rồi thì có cần chuyển sang GPT-6.1 Sol?
Nhìn lại vài phiên gần đây: bước nào bạn vẫn phải nhảy vào sửa tay?
Nếu GPT-6 Sol đã đủ cho đổi format, nháp tóm tắt hay script ngắn, cảm giác sau khi đổi model có thể gần như không. Bản cập nhật không tự vá thiếu dữ liệu đầu vào, yêu cầu mơ hồ hay bug của chương trình bạn. Giữ cấu hình hiện tại và chăm input/quy trình đôi khi nhanh hơn.
Nếu điều kiện hay bị sót trong việc dài, sửa một chỗ làm hỏng chỗ cạnh, hoặc phải giải thích đi giải thích lại cùng một yêu cầu — hãy đưa đúng những việc đó cho GPT-6.1 Sol. Đo xem số lần giải thích lại, vá code và sửa tay có giảm không. Cách này sát mục tiêu nâng cấp hơn là bày một bài thi mới chỉ để so điểm.
Thời gian chờ cũng phải đọc theo ngữ cảnh công việc. Trong bài tổng hợp sự kiện ngày 30/9, hai phản hồi đầy đủ của GPT-6.1 Sol khoảng 19,25 giây và 12,62 giây; GPT-6 Sol khoảng 22,83 giây và 20,62 giây. Ở bài code khoảng thời gian khác, không có lợi thế tốc độ ổn định.
Hôm đó mỗi model nhận 16 request. GPT-6 Sol hoàn thành cả 16, kết quả khớp yêu cầu. GPT-6.1 Sol hoàn thành 14, trong đó 13 hoàn toàn đúng; hai request còn lại (tra rule và chọn ràng buộc) chờ khoảng 240 giây rồi vẫn không có câu trả lời đầy đủ. Mình không tách được lỗi thuộc model, hàng đợi hay đường truyền, nhưng phía người dùng thì việc chờ là có thật. Một lần 12,62 giây thành công không đủ để kết luận đổi bản mới sẽ tiết kiệm thời gian.
Tín hiệu nên nâng cấp là ít phải làm lại, ít chờ vô ích, hoặc làm được việc trước đây khó đóng. Nếu chưa thấy, giữ GPT-6 Sol làm chính và dùng GPT-6.1 Sol bổ sung cho phần khó.
Cách gắn GPT-6.1 Sol và GPT-6 Sol vào tool đang dùng
Khi đã quyết “có đáng thử”, bước tiếp theo là gắn vào client hiện có.
Nếu bạn đã có script API, Crazyrouter cho một điểm vào chung: cùng một client gọi nhiều model. Mình gửi qua Chat Completions cùng message và tham số cho cả hai. So sánh lúc đó tập trung vào câu trả lời, không phải vào khác biệt client.
Tạo API Key trong console Crazyrouter, rồi kiểm danh sách model trên tài khoản. Ngày 3/11/2026, cả hai model vẫn hiện trong môi trường của mình. Trước khi chạy, xác nhận thấy gpt-6-sol và gpt-6.1-sol, rồi thử một việc của bạn. Field chi tiết nằm ở trang GPT-6.1 Sol.
| Cấu hình | Giá trị dùng trong bài |
|---|---|
| Base URL client tương thích OpenAI | https://api.crazyrouter.com/v1 |
| URL request đầy đủ | https://api.crazyrouter.com/v1/chat/completions |
| Model ID | gpt-6-sol hoặc gpt-6.1-sol |
| Cường độ suy luận lúc đó | reasoning_effort: "high" |
| Trần output lúc đó | max_completion_tokens: 8192 |
Sau khi cấu hình, lấy một việc gần đây và đưa cho cả hai model với cùng input. Với billing, xem thứ tự khử trùng, rule hoàn tiền và biên thời gian có giữ không, chỗ nào ít phải sửa tay hơn.
Nếu dùng IDE/tool có sẵn, điểm cấu hình nằm trong hướng dẫn integrations. Lần đó mình chỉ gọi text thông thường; nếu tool của bạn còn đọc file, chạy lệnh hoặc sửa code liên tục, hãy theo tutorial tương ứng rồi chạy lại cả kịch bản để chắc các thao tác đi đến cuối.
Chốt lựa chọn giữa GPT-6.1 Sol và GPT-6 Sol
Mới bắt đầu gắn model và chủ yếu làm code phức tạp hoặc chuỗi nhiều bước → bắt đầu với GPT-6.1 Sol. Hướng cập nhật chính thức gần các nhu cầu đó; sau đó xác nhận lợi ích trên project của bạn.
GPT-6 Sol đã ổn định → đổi từ bước tốn thời gian nhất. Script billing đã đúng không cần viết lại chỉ để “theo version”; nếu sửa xuyên file luôn đòi giải thích dài, hãy đưa cùng việc đó một lần cho GPT-6.1 Sol rồi so.
Ở chỗ cần đếm chính xác, số tiền hoặc thứ tự ưu tiên rule, cả hai model nên đi cùng tính toán bằng chương trình và bằng chứng gốc. Chọn số version mới hơn không thay được lớp kiểm này.
Cách mình sẽ làm: giữ cấu hình hiện tại, dùng cùng client Crazyrouter, đưa cho bản mới đúng một việc mình đang sửa quá nhiều lần. Nếu nó gỡ được một ma sát thật, việc chuyển có lý do cụ thể. Nếu không, tiếp tục với GPT-6 Sol vẫn hợp lý.
All rights reserved
