

GPT-6 Astra là gì? Hướng dẫn tích hợp API và kiểm chứng kết quả trong ứng dụng
Từ dữ liệu đầu vào đến kết quả có thể kiểm tra trong ứng dụng.
Khi tích hợp một mô hình ngôn ngữ vào ứng dụng, phần khó thường không nằm ở chỗ gọi được API. Phần khó là: làm sao biết câu trả lời trả về có dùng được hay không, và khi nó sai thì sai ở lớp nào. Bài này đi qua trọn vẹn một luồng nhỏ — phân loại phản hồi người dùng — để bạn thấy rõ đâu là việc của mô hình, đâu là việc của ứng dụng, và đâu là việc bắt buộc phải kiểm tra bằng code của chính bạn.
Mục lục
- Vị trí của mô hình trong ứng dụng
- Chuẩn bị một nhóm phản hồi có thể kiểm tra thủ công
- Bắt đầu từ một request
- Biến câu trả lời thành kết quả mà ứng dụng chấp nhận được
- Khi có lỗi, nên kiểm tra lớp nào trước?
- Làm sao biết Astra có đáng giữ lại trong luồng này không?
1. Vị trí của mô hình trong ứng dụng
GPT-6 Astra là một mô hình của OpenAI, được định vị cho những công việc khó và nhiều bước: suy luận phức tạp, lập trình, nghiên cứu và tạo tài liệu.
Điều quan trọng nhất cần nắm ngay từ đầu: mô hình chỉ nhận văn bản và hình ảnh, rồi trả về văn bản. Nó không tự đọc cơ sở dữ liệu của bạn, không tự gọi API nội bộ, không tự ghi file. Mọi hành động thực tế đều do ứng dụng của bạn thực hiện.
| Thông tin | GPT-6 Astra |
|---|---|
| Model ID | gpt-6-astra |
| Đầu vào | Văn bản, hình ảnh |
| Đầu ra | Văn bản |
| Cửa sổ ngữ cảnh | 1.050.000 token |
| Đầu ra có cấu trúc | Tài liệu chính thức ghi là có hỗ trợ |
| Gọi công cụ (function calling) | Tài liệu chính thức ghi là có hỗ trợ |
Chi tiết thông số xem tại tài liệu mô hình chính thức của OpenAI.
Luồng dữ liệu tối giản trong một ứng dụng thực tế chỉ có ba chặng:
Dữ liệu của bạn → Mô hình → Lớp kiểm tra của ứng dụng → Lưu / Hiển thị
Chặng thứ ba là chặng hay bị bỏ qua nhất, và cũng là chặng bài này tập trung vào.
2. Chuẩn bị một nhóm phản hồi có thể kiểm tra thủ công
Trước khi gọi API, hãy chuẩn bị dữ liệu mà bạn đã biết đáp án đúng. Nếu không, bạn sẽ không có cách nào đánh giá kết quả ngoài cảm tính.
Lấy hai phản hồi người dùng làm ví dụ, cố ý chọn hai loại khác hẳn nhau:
- Phản hồi rõ ràng: "Sau khi cập nhật bản mới, mở app lên là bị thoát ngay. Tôi dùng Android 14."
- Phản hồi mơ hồ: "App này cũng được nhưng mà hơi kỳ kỳ."
Cái thứ nhất có đủ thông tin: có triệu chứng, có nền tảng, có mốc thời gian. Cái thứ hai thì không — nó không cho biết vấn đề là gì, cũng không cho biết thiết bị nào.
Yêu cầu đầu ra được định nghĩa như sau:
loai: một trong bốn giá trịloi,yeu_cau_tinh_nang,khen,khong_rodan_chung: phải trích nguyên văn từ phản hồi, không được diễn giải lạinen_tang: nền tảng người dùng nêu ra, nếu không có thìkhong_ro
Hai ràng buộc cuối chính là phép thử thật sự. Trích nguyên văn giúp bạn đối chiếu được ngay. Còn giá trị khong_ro tồn tại để xem mô hình có chịu thừa nhận là nó không biết hay không, hay sẽ đoán bừa cho đủ trường.
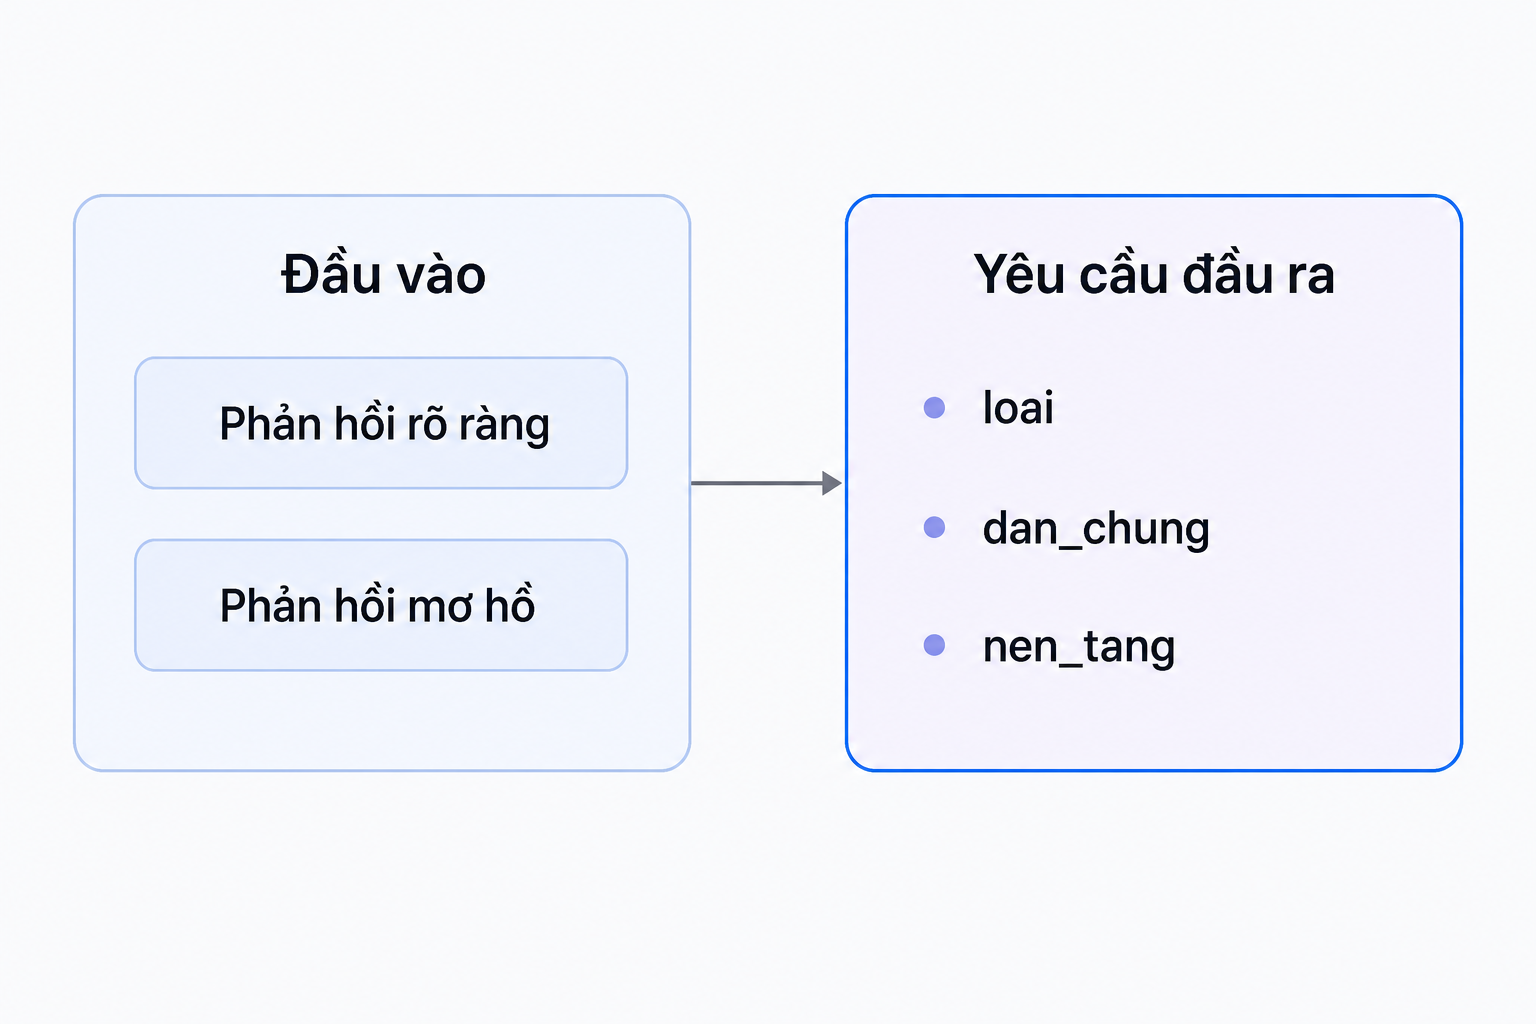
Hình 1: Đầu vào và yêu cầu đầu ra (hình minh họa do AI tạo, không phải ảnh chụp màn hình).
3. Bắt đầu từ một request
Gọi lần đầu nên đơn giản nhất có thể: một request, không streaming, không công cụ. Mục tiêu là xác nhận đường đi thông suốt, chứ chưa phải xác nhận chất lượng.
Bạn cần ba thứ: địa chỉ endpoint, khóa API đặt trong biến môi trường (đừng bao giờ viết thẳng vào code), và model ID chính xác.
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model":"gpt-6-astra","messages":[{"role":"user","content":"xin chào"}]}'
Nếu bước này trả về 200, bạn đã xác nhận được đúng ba điều: khóa hợp lệ, model ID tồn tại trên kênh đang dùng, và mạng thông. Nó chưa chứng minh bất cứ điều gì về các tính năng khác. Việc một kênh tương thích giao thức OpenAI không có nghĩa là mọi tham số và mọi công cụ đều hoạt động như tài liệu gốc mô tả — mỗi thứ phải thử riêng.
Thông tin về model ID và tình trạng hỗ trợ trên kênh có thể tham khảo tại tài liệu tích hợp mô hình của Crazyrouter (tiếng Anh). Trước khi tích hợp, vẫn nên tự kiểm tra lại các tham số mà ứng dụng của bạn thực sự cần.
Một chi tiết nhỏ nhưng đáng nhớ: hãy đọc trường model trong phản hồi để xác nhận request thực sự chạy trên mô hình bạn muốn, thay vì chỉ tin vào những gì bạn đã gửi đi.
4. Biến câu trả lời thành kết quả mà ứng dụng chấp nhận được
Đây là phần dài nhất, vì đây là phần quyết định luồng có dùng được hay không.
Để nhận JSON thay vì văn bản tự do, ta khai báo response_format dạng json_schema, liệt kê đúng ba trường ở mục 2 và đặt additionalProperties: false. Dưới đây là kết quả thật khi chạy với hai phản hồi mẫu (ngày 2026-10-13, model gpt-6-astra).
Với phản hồi rõ ràng:
{
  "dan_chung": "Sau khi cập nhật bản mới, mở app lên là bị thoát ngay. Tôi dùng Android 14.",
  "loai": "loi",
  "nen_tang": "Android 14"
}
Với phản hồi mơ hồ:
{
  "dan_chung": "App này cũng được nhưng mà hơi kỳ kỳ.",
  "loai": "khong_ro",
  "nen_tang": "khong_ro"
}
Kết quả thứ hai mới là điều đáng chú ý. Mô hình không bịa ra một nền tảng, cũng không ép phản hồi đó thành loi hay khen. Đó là hành vi ta mong muốn, và nó có được là nhờ ràng buộc trong mô tả yêu cầu, chứ không phải tự nhiên mà có.
Parse được không có nghĩa là đúng
Nhưng đến đây mới là lúc phải nói điều quan trọng nhất của cả bài:
Parse JSON thành công không có nghĩa là nội dung đúng.
Schema chỉ đảm bảo hình dạng dữ liệu. Nó không đảm bảo dan_chung thật sự là trích nguyên văn, cũng không đảm bảo loai được gán hợp lý. Vì vậy ứng dụng phải có lớp kiểm tra riêng. Tối thiểu nên có ba phép kiểm tra:
function validate(result, phanHoiGoc) {
  const loaiHopLe = ["loi", "yeu_cau_tinh_nang", "khen", "khong_ro"];
  // 1. Giá trị enum có nằm trong danh sách cho phép không
  if (!loaiHopLe.includes(result.loai)) return "loai_khong_hop_le";
  // 2. Dẫn chứng có thật sự nằm trong phản hồi gốc không
  if (!phanHoiGoc.includes(result.dan_chung)) return "dan_chung_khong_khop";
  // 3. Trường rỗng phải thành khong_ro, không được để chuỗi rỗng
  if (!result.nen_tang) return "thieu_nen_tang";
  return null;
}
Phép kiểm tra thứ hai là quan trọng nhất và cũng dễ bị bỏ sót nhất. Nếu dan_chung không xuất hiện nguyên văn trong phản hồi gốc, nghĩa là nó đã bị diễn giải lại — và một dẫn chứng bị diễn giải lại thì không còn là dẫn chứng nữa.
Trong thực tế, phép kiểm tra này hay vướng ở chuyện khoảng trắng và dấu câu. Phản hồi người dùng thường có khoảng trắng thừa, xuống dòng giữa câu, hoặc dấu câu không thống nhất. Nếu so sánh chuỗi một cách cứng nhắc, bạn sẽ nhận về rất nhiều cảnh báo giả. Cách xử lý hợp lý là chuẩn hóa cả hai phía trước khi so sánh — gộp khoảng trắng liên tiếp, bỏ khoảng trắng đầu cuối — nhưng không đổi chữ hoa chữ thường và không bỏ dấu tiếng Việt, vì hai thứ đó mới thực sự mang thông tin.
Một điểm nữa đáng cân nhắc: nên lưu lại cả phản hồi gốc lẫn kết quả phân loại, thay vì chỉ lưu kết quả. Khi cần rà soát lại sau này, hoặc khi bạn muốn đổi sang mô hình khác để so sánh, dữ liệu gốc là thứ duy nhất cho phép bạn chạy lại và đối chiếu. Chỉ lưu nhãn đã gán thì mọi đánh giá về sau đều mất cơ sở.
Khi lớp kiểm tra báo lỗi, hãy đưa bản ghi đó sang hàng đợi xem xét thủ công, đừng tự động thử lại nhiều lần. Thử lại chỉ hợp lý khi bạn biết nguyên nhân là tạm thời.
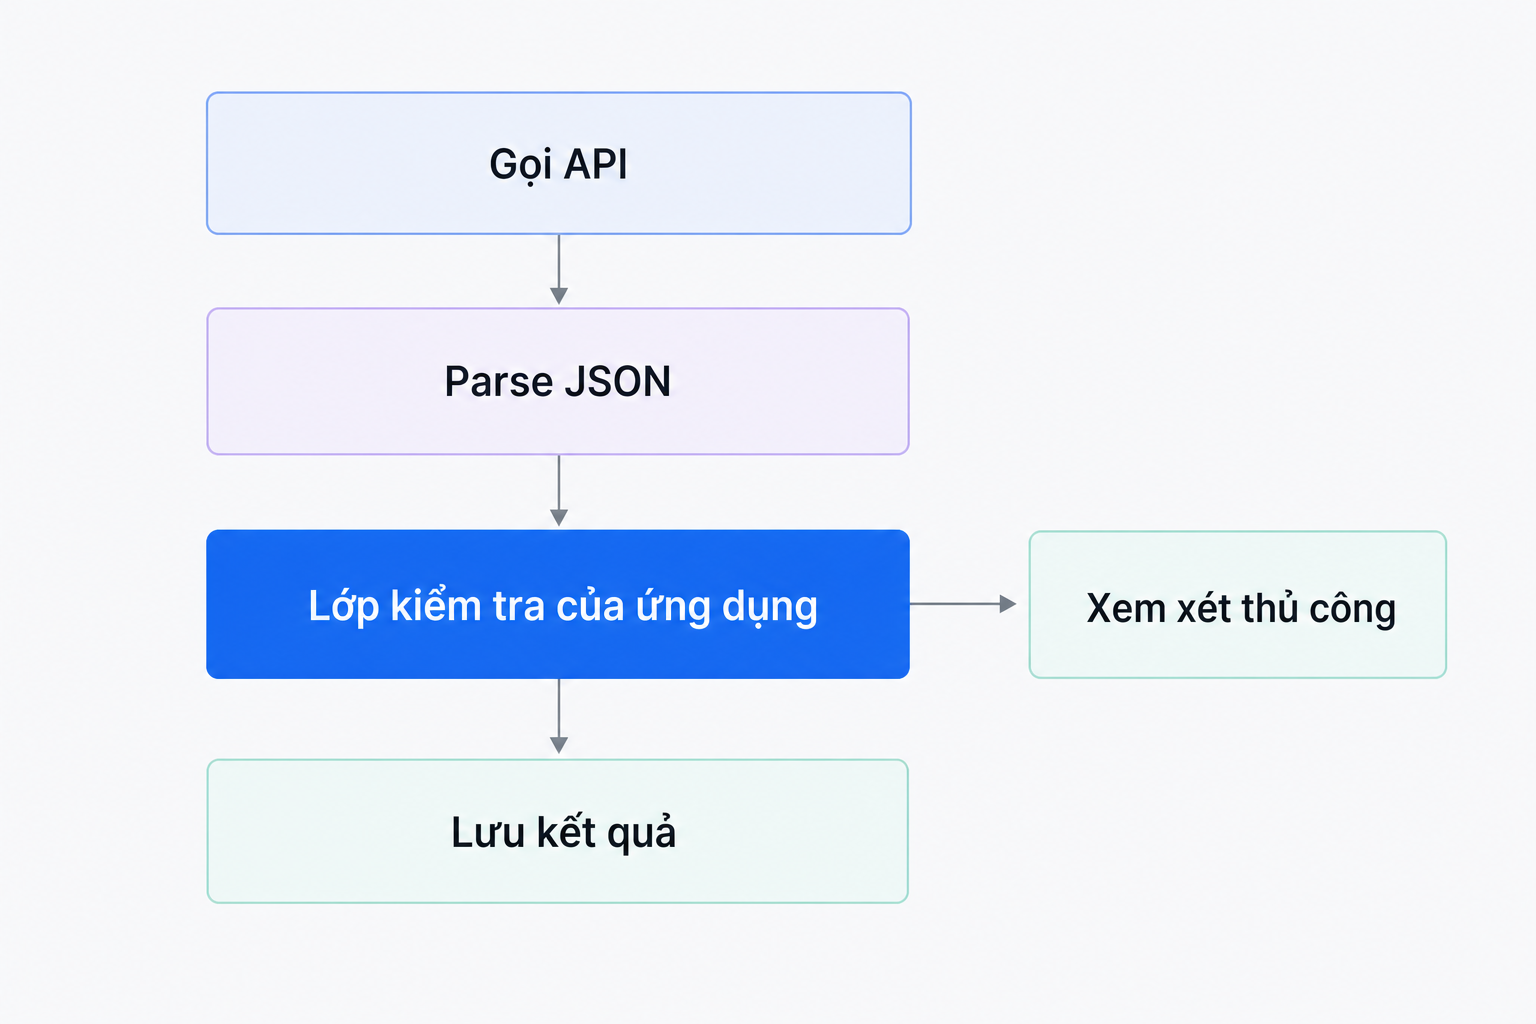
Hình 2: Luồng kiểm tra kết quả (hình minh họa do AI tạo, không phải ảnh chụp màn hình).
5. Khi có lỗi, nên kiểm tra lớp nào trước?
Lỗi trong luồng này rơi vào bốn lớp khác nhau, và cách xử lý hoàn toàn khác nhau. Sai lầm phổ biến nhất là gặp lỗi gì cũng sửa prompt hoặc tăng số lần retry.
| Lớp | Dấu hiệu | Hướng xử lý |
|---|---|---|
| Xác thực | HTTP 401 | Kiểm tra định dạng header, khóa hết hạn hay dư khoảng trắng |
| Định dạng request | HTTP 400 / 404 | Sai model ID, sai cấu trúc tham số. Đọc kỹ nội dung lỗi trả về |
| Phản hồi mô hình | HTTP 200 nhưng nội dung trống hoặc bị cắt | Kiểm tra finish_reason; nếu bị cắt thì tăng giới hạn đầu ra |
| Kiểm tra nghiệp vụ | HTTP 200, JSON hợp lệ, nhưng sai nội dung | Siết lại mô tả yêu cầu, bổ sung ví dụ, hoặc chuyển sang xem xét thủ công |
Chỉ có lớp cuối cùng mới nên sửa bằng cách chỉnh prompt. Ba lớp đầu là vấn đề kỹ thuật, chỉnh prompt không giải quyết được gì cả.
Khi báo lỗi, hãy luôn ghi lại request id mà dịch vụ trả về. Lúc cần đối chiếu, một request id cụ thể có giá trị hơn nhiều so với một ảnh chụp màn hình.
6. Làm sao biết Astra có đáng giữ lại trong luồng này không?
Hãy tách bài toán ra làm hai nhóm.
Với phản hồi rõ ràng, bài toán phân loại này không khó. Một mô hình nhẹ hơn, rẻ hơn, nhanh hơn nhiều khả năng cũng xử lý được. Dùng mô hình mạnh nhất cho loại dữ liệu này thường là lãng phí.
Với phản hồi mơ hồ, nhiều tầng ý, hoặc trộn nhiều vấn đề trong một câu, khác biệt mới xuất hiện — đặc biệt ở khả năng chịu trả về khong_ro thay vì đoán bừa. Nếu dữ liệu thật của bạn chủ yếu thuộc nhóm này, mô hình mạnh hơn có thể đáng giá.
Ba yếu tố cần cân nhắc khi quyết định:
- Độ trễ. Trong các lần chạy thử ở trên, mỗi request mất khoảng 4–5 giây. Nếu luồng của bạn chạy nền theo lô thì không sao; nếu người dùng đang ngồi chờ thì đó là con số phải tính.
- Công sức kiểm tra. Nếu tỷ lệ bản ghi phải xem thủ công không giảm, thì tự động hóa chưa mang lại giá trị thực.
- Chi phí. Hãy đọc trường
usagetrong phản hồi thật, đừng ước lượng theo độ dài prompt bạn viết. Trong các lần chạy thử, cùng một tác vụ ngắn màprompt_tokensdao động khá lớn tùy cấu hình request — nghĩa là con số duy nhất đáng tin là con số do dịch vụ trả về.
Cách bắt đầu hợp lý: lấy 50 phản hồi thật đã được gán nhãn thủ công, chạy qua luồng này, rồi so sánh. Bạn sẽ có câu trả lời chắc chắn hơn mọi bài benchmark.
All rights reserved
