

GLM-5.3 qua API: cách kiểm tra độ trễ và đầu ra
Kết luận nhanh: Trong một phép thử nhỏ ngày 27 tháng 10 năm 2026, GLM-5.3 hoàn thành tác vụ trích xuất dữ liệu nhanh hơn mẫu so sánh 5,45 giây. Cùng lúc, tác vụ viết mã cho thấy một yêu cầu có thể kết thúc mà không trả về mã hoàn chỉnh nếu giới hạn đầu ra quá thấp. Bạn nên kiểm tra tính đúng và tính đầy đủ trước, rồi mới dùng thời gian để đánh giá.
Ba con số đủ để định hướng: 8 yêu cầu, 3 loại tác vụ và 31 ca kiểm thử. Kết quả đủ để mở một thử nghiệm hẹp với quy trình có thể kiểm tra bằng máy; chưa đủ để tuyên bố mô hình nào tốt hơn trên mọi tác vụ.
Điều kiện của phép đo
Hai mô hình là GLM-5.3 và doubao-seed-2-1-turbo-260628. Cả hai đi qua cùng một tuyến API của Crazyrouter, nhận cùng lời nhắc trong các cuộc hội thoại riêng và dùng thiết lập suy luận mặc định. Có 8 yêu cầu, gồm một lần thử lại mã cho mỗi mô hình.
Thời gian được tính từ lúc gửi yêu cầu đến khi nhận đủ phản hồi. Con số này gồm mạng, hàng đợi, suy luận và sinh văn bản; không phải thời gian đến token đầu tiên. Đây cũng không phải phép đo dài hạn hay thay thế cho kiểm thử trên giao diện web và ứng dụng di động.
| Tác vụ | GLM-5.3 | Mẫu so sánh | Khác biệt |
|---|---|---|---|
| Viết lại thông báo bảo trì | 26,46 giây | 28,11 giây | GLM hoàn tất sớm 1,65 giây |
| Trích xuất đơn hàng và tính doanh thu | 11,53 giây | 16,98 giây | GLM hoàn tất sớm 5,45 giây |
| Viết hàm Python theo quy tắc | Đạt 31 ca khi giới hạn 4096 token | Đạt 31 ca khi giới hạn 4096 token | Cùng kết quả kiểm thử; chưa đủ cơ sở so sánh tốc độ |
Hai tác vụ văn bản cho thấy điều gì
Tác vụ thông báo yêu cầu giữ đúng khung thời gian bảo trì, phân biệt chức năng xuất báo cáo bị gián đoạn với truy vấn và thanh toán vẫn hoạt động, đồng thời đề nghị xuất báo cáo trước. Cả hai mô hình giữ đủ các ý này và không tự thêm cam kết đền bù.
GLM dùng tiêu đề và khoảng nghỉ nhiều hơn; mẫu so sánh viết gọn hơn. Đó là khác biệt về cách trình bày. Chưa có căn cứ để biến sở thích biên tập đó thành kết luận về chất lượng ngôn ngữ nói chung.
Tác vụ thứ hai rõ hơn về mặt kiểm tra. Dữ liệu đầu vào có 1.200 lượt truy cập, 72 giao dịch thành công trị giá 50 nhân dân tệ mỗi giao dịch và 6 giao dịch hoàn tiền toàn phần. Cả hai mô hình đều trả về:
- Tổng doanh thu: 3.600 nhân dân tệ.
- Hoàn tiền: 300 nhân dân tệ.
- Doanh thu ròng: 3.300 nhân dân tệ.
- Tỷ lệ chuyển đổi: 6,00%, tính bằng số thanh toán thành công chia cho lượt truy cập.
Không mô hình nào tự bịa lý do hoàn tiền khi dữ liệu không có thông tin đó. Đây là điểm quan trọng hơn việc câu trả lời trông tự nhiên hay không: phép tính và giới hạn nguồn đều kiểm tra được.
Đưa 5,45 giây về quy mô công việc
Một lần nhanh hơn 5,45 giây chưa nói nhiều. Khi tác vụ lặp lại, khoảng cách mới có ý nghĩa vận hành.
| Số yêu cầu trích xuất mỗi ngày | Chênh lệch mỗi ngày | Ước tính 30 ngày |
|---|---|---|
| 20 | 109 giây | Khoảng 54,5 phút |
| 100 | 545 giây | Khoảng 4,5 giờ |
Các tổng này giả định khoảng cách 5,45 giây lặp lại ở mọi yêu cầu. Giả định đó cần mẫu lớn hơn. Cách đọc hợp lý là: nếu quy trình đã xử lý ít nhất 20 yêu cầu có quy tắc rõ mỗi ngày, một thử nghiệm có kiểm soát là đáng làm. Nếu chỉ dùng vài lần mỗi ngày, mức tiết kiệm từ mẫu này chưa đủ để tự động đổi công cụ.
Giới hạn đầu ra làm hỏng một yêu cầu trông thành công
Bài toán mã yêu cầu đếm các bản ghi đã thanh toán có số tiền hợp lệ. Số nguyên không âm và chuỗi chỉ gồm chữ số ASCII được chấp nhận. Boolean, số thực, số âm và dữ liệu sai định dạng bị loại. Mảng đầu vào phải giữ nguyên.
Bộ kiểm thử có 31 ca: mảng rỗng, số 0, chuỗi có số 0 ở đầu, dữ liệu sai kiểu, nhiều trạng thái đơn hàng và dữ liệu trộn. Khi có mã hoàn chỉnh, cả hai mô hình đều vượt qua 31 ca.
Ở lần đầu với giới hạn 1.600 token, GLM-5.3 kết thúc bằng finish_reason = length và không có phần mã cuối. Đây không phải bằng chứng rằng mô hình không viết được hàm. Đó là lỗi cấu hình đầu ra: ngân sách token không đủ cho yêu cầu thực tế. Sau khi nâng lên 4.096 token, mã hoàn chỉnh mới xuất hiện.
Khung kiểm tra tối thiểu có thể dùng với endpoint tương thích OpenAI:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["CRAZYROUTER_API_KEY"],
    base_url="https://api.crazyrouter.com/v1",
)

response = client.chat.completions.create(
    model="glm-5.3",
    messages=[
        {
            "role": "user",
            "content": "Write an order-amount validator with boundary tests.",
        }
    ],
    max_tokens=4096,
)

choice = response.choices[0]
content = choice.message.content or ""

print("finish_reason:", choice.finish_reason)
print("content_length:", len(content))
print(content)

if choice.finish_reason == "length" or not content.strip():
    raise RuntimeError("The response was truncated or empty; inspect max_tokens.")
Trong hệ thống chạy theo lô, nên ghi cả finish_reason, độ dài đầu ra, số ca kiểm thử và lý do lỗi. Chỉ ghi mã HTTP 200 sẽ khiến bảng điều khiển báo thành công trong khi người dùng nhận một câu trả lời rỗng.
Không nên dùng thời gian của tác vụ mã làm xếp hạng tốc độ. Kênh thử nghiệm ghi nhận đầu ra của mẫu so sánh vượt giới hạn yêu cầu, còn lần thử lại của GLM có một phần đầu vào được lưu trong bộ nhớ đệm. Chiến lược suy luận mặc định cũng có thể khác. Vì vậy, kết quả mã phù hợp để kiểm tra độ hoàn chỉnh, không phù hợp để tuyên bố mô hình nào luôn nhanh hơn.
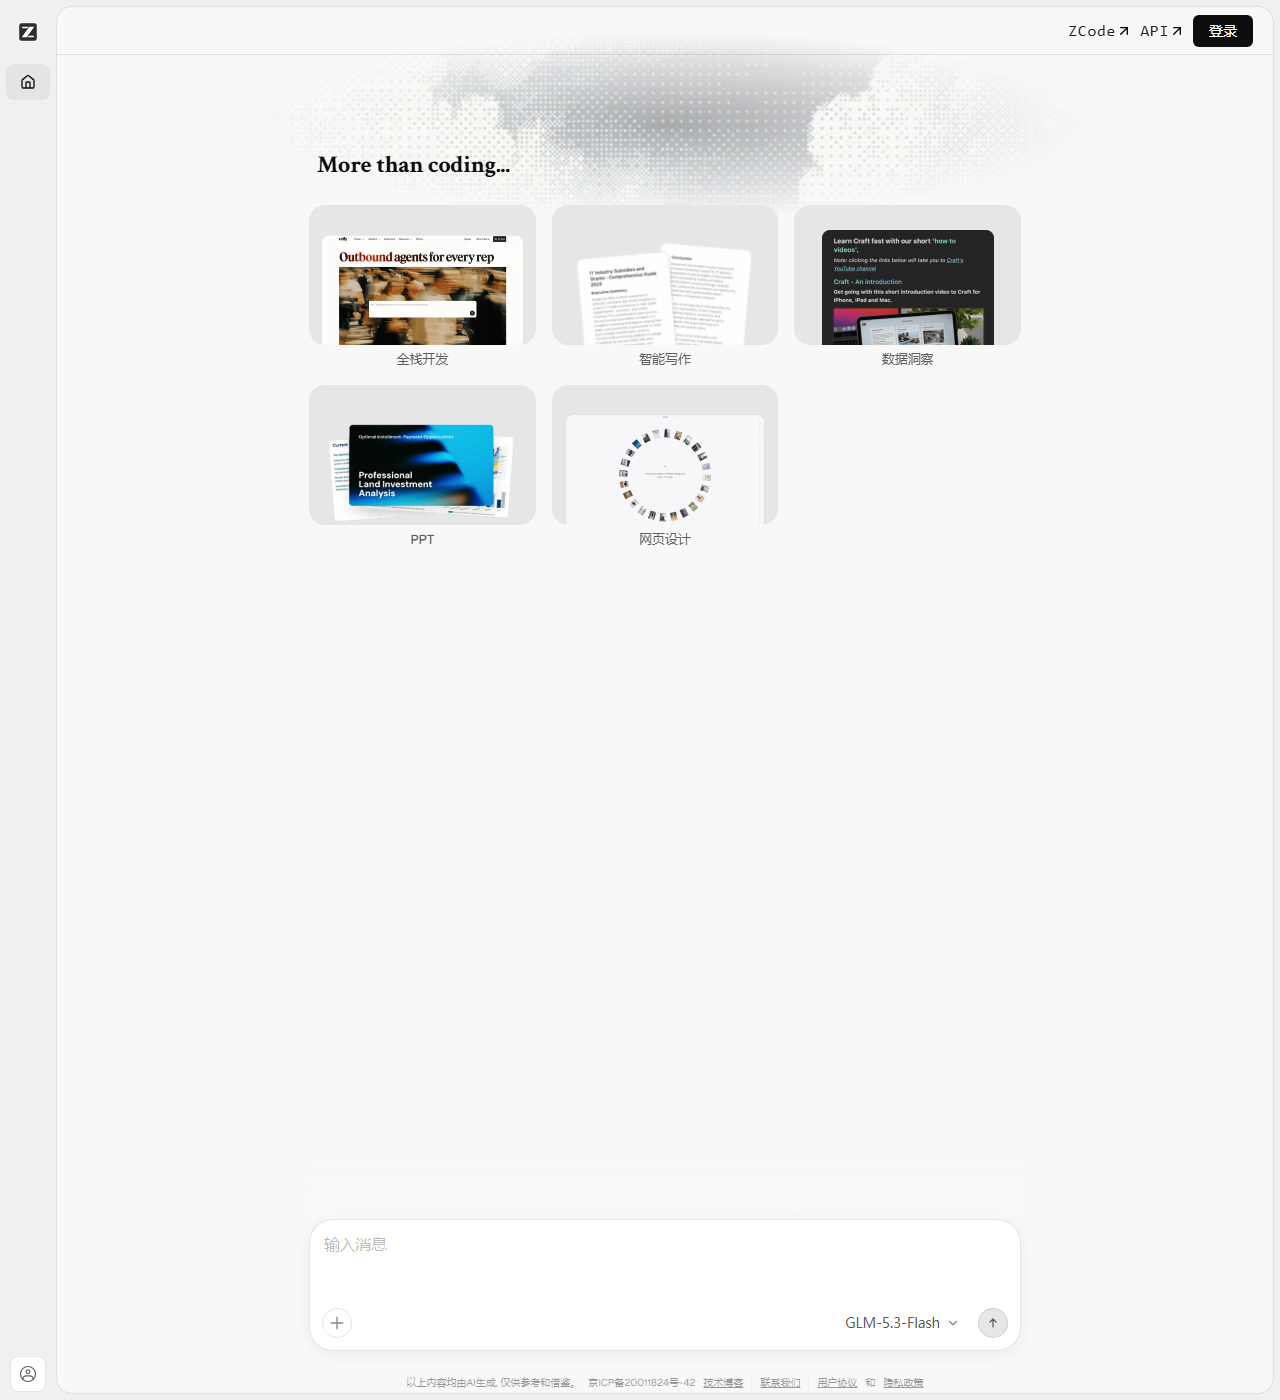
Ảnh chụp cho thấy giao diện có thể đang chọn GLM-5.3-Flash. GLM-5.3 và GLM-5.3-Flash là hai mô hình khác nhau; cần đọc bộ chọn mô hình thay vì chỉ nhìn tên trang.
Giá niêm yết và chi phí hoàn thành không phải một con số
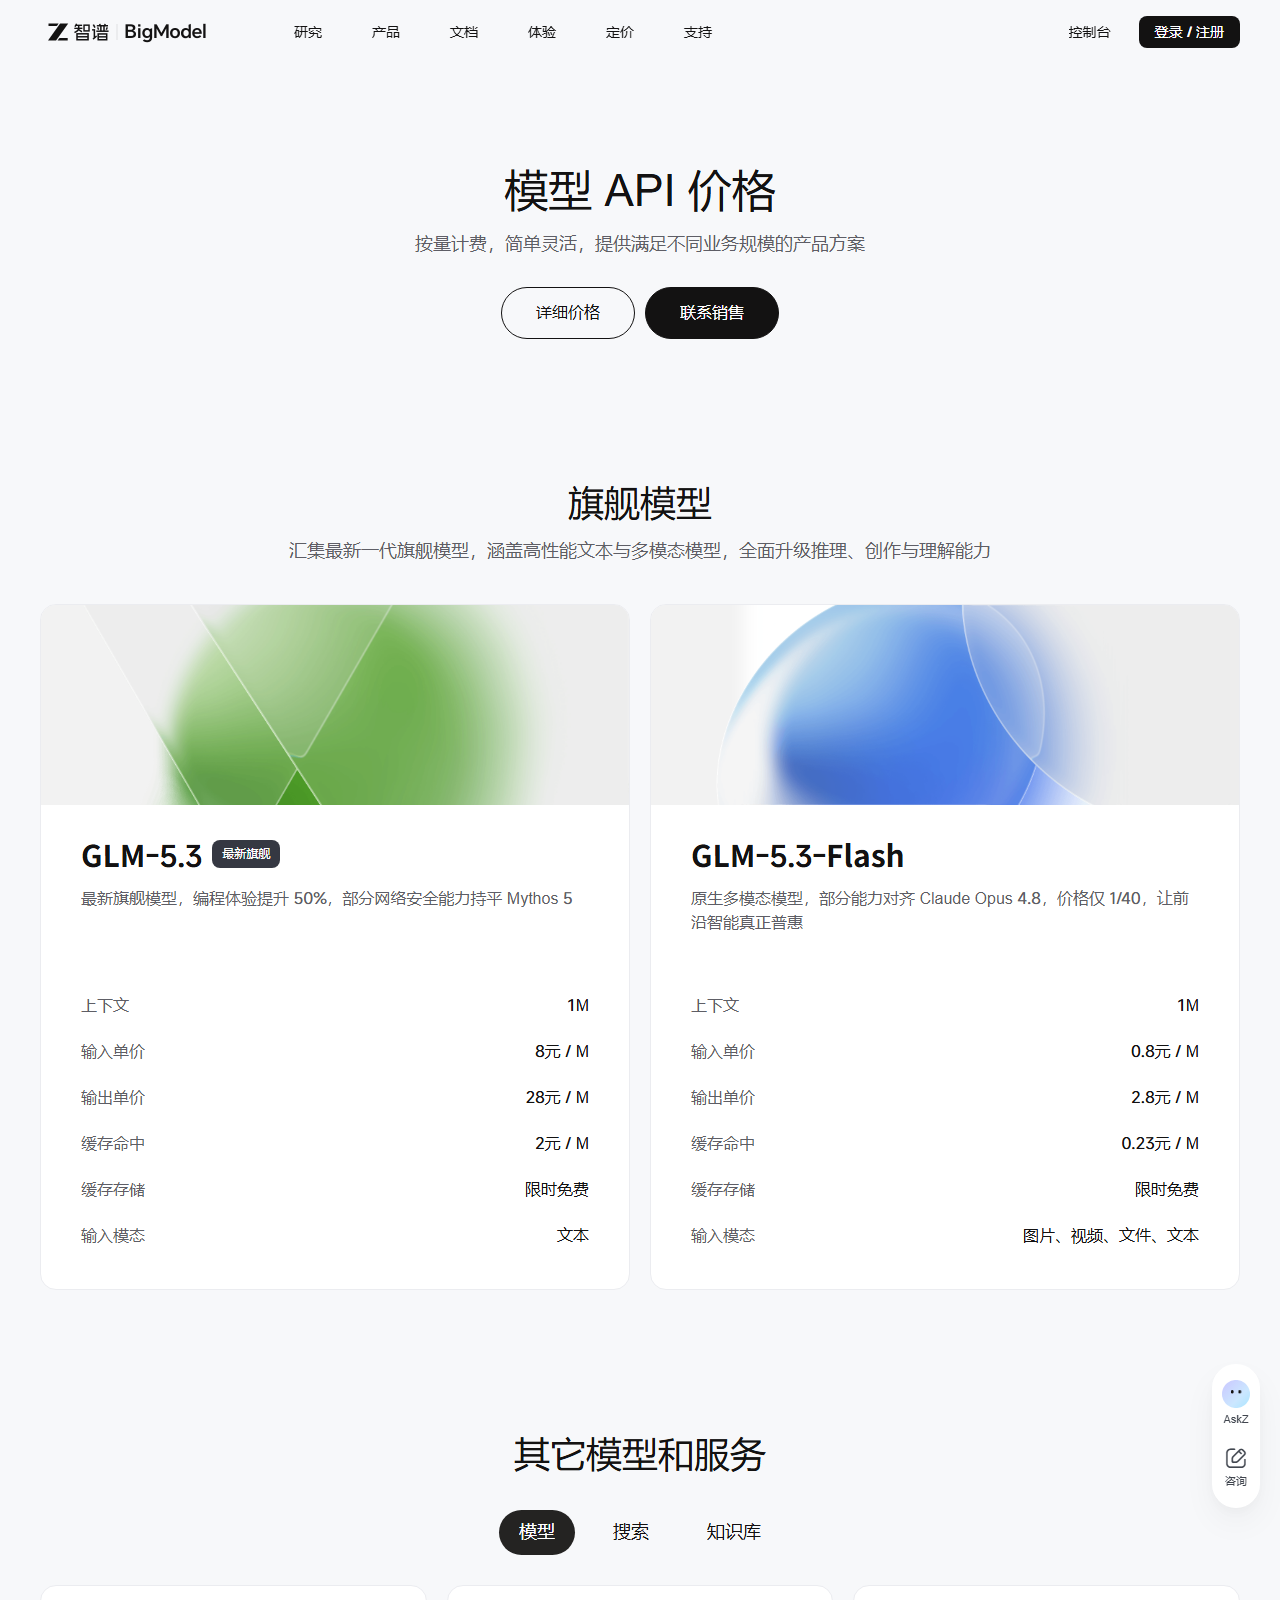
Ảnh chụp trang giá cho thấy GLM-5.3 có giá niêm yết 8 nhân dân tệ cho mỗi triệu token đầu vào và 28 nhân dân tệ cho mỗi triệu token đầu ra. GLM-5.3-Flash có mức 0,8 và 2,8 nhân dân tệ cho cùng đơn vị, cùng cửa sổ ngữ cảnh 1 triệu token theo thông tin hiển thị.
Giá đơn vị không trả lời câu hỏi chi phí của một tác vụ hoàn chỉnh. Một mô hình có thể cần thử lại, sinh nhiều token hơn hoặc trả về đầu ra cần sửa. Phép thử ngày 27 tháng 10 không đối chiếu hóa đơn, nên không có cơ sở tuyên bố mô hình nào rẻ hơn cho toàn bộ quy trình.
Cũng cần tách GLM-5.3 khỏi GLM-5.3-Flash. Theo trang giá trong ảnh, GLM-5.3 nhận đầu vào văn bản, còn Flash nhận hình ảnh, video, tệp và văn bản. Một tác vụ cần đọc ảnh không thể được đánh giá bằng kết quả của mô hình văn bản.
Cách chọn thử nghiệm tiếp theo
Dùng ba cổng thay vì một điểm số chung:
- Đầu ra được chấp nhận. Lấy 20 lời nhắc từ công việc thật. Đếm lỗi dữ kiện, lỗi định dạng, kết luận không có nguồn và ca kiểm thử thất bại. Loại mô hình không đạt ngưỡng đúng, bất kể tốc độ.
- Đầu ra hoàn chỉnh. Chạy với giới hạn token thực tế. Ghi tỷ lệ câu trả lời rỗng, bị cắt và số lần phải thử lại. Nếu tác vụ mã thất bại ở 1.600 token nhưng đạt ở 4.096, hãy xem lần đầu là lỗi cấu hình.
- Thời gian và hóa đơn. Chỉ so sánh các yêu cầu đã qua hai cổng đầu. Lặp lại nhiều lần để xem phân bố, rồi đối chiếu usage với hóa đơn thật.
Nếu quy trình trích xuất lặp lại ít nhất 20 lần mỗi ngày và chênh lệch 5,45 giây còn đúng sau khi lặp lại, đó là tín hiệu đủ cụ thể để thử GLM-5.3. Nếu công việc chỉ gồm vài lần trò chuyện hoặc soạn thảo mỗi ngày, ba tác vụ nhỏ chưa tạo ra lý do rõ ràng để chuyển đổi.
Với tài liệu dài, kho mã lớn và đầu vào đa phương thức, phép thử này không đưa ra bằng chứng trực tiếp. Cần một bộ đánh giá riêng cho từng loại đầu vào và từng ngưỡng lỗi.
Nguồn và phạm vi
- Bản ghi kiểm thử ngày 27 tháng 10 năm 2026: glm-5.3 và doubao-seed-2-1-turbo-260628; 3 loại tác vụ, 8 yêu cầu; thử lại mã ở 4.096 token; cả hai mô hình vượt 31 ca biên.
- Thông tin mô hình và cập nhật: GLM-5.3 trên Crazyrouter.
- Endpoint tương thích OpenAI: https://api.crazyrouter.com/v1.
All rights reserved
