Dynamic Reasoning Budgets: Giảm Một Nửa Chi Phí Suy Luận Trên Các Mô Hình Test-Time Compute
Nâng cấp một pipeline production lên các mô hình suy luận (reasoning models) cho cảm giác như một bước thắng lợi rõ rệt trong bốn mươi tám giờ đầu tiên. Các bài benchmark về toán học, sinh mã nguồn phức tạp và lập luận nhiều bước đều cho thấy độ chính xác tăng vọt. Bạn đẩy mô hình lên môi trường staging, chạy bộ test tích hợp và thấy tỷ lệ pass tăng thêm ba đến bốn phần trăm.
Thế rồi hóa đơn dịch vụ đám mây cuối tháng ập đến.
Trong hệ thống theo dõi của tụi mình, việc chuyển toàn bộ một service xử lý văn bản đa agent sang chế độ full-depth reasoning đã khiến chi phí token tăng ngay lập tức 420%. Độ trễ trung vị (median latency) vọt từ tám trăm mili giây lên mười một giây. Khi kéo log token ra phân tích nguyên nhân, sự thật phơi bày một cách cay đắng: mô hình đã đốt tới ba nghìn reasoning token chỉ để đắn đo trích xuất regex cơ bản, định dạng lại một dictionary JSON tĩnh, hoặc cân nhắc các quyết định điều hướng database đơn giản mà một script Python năm mươi dòng có thể giải quyết trong hai mili giây.
Việc triển khai các mô hình suy luận test-time compute mà không có giới hạn tính toán sẽ gây ra độ trễ nghiêm trọng và làm bùng nổ chi phí trên các tác vụ vận hành đơn giản. Các hệ sinh thái production bắt buộc phải áp dụng dynamic reasoning budgets, điều hướng các truy vấn đơn giản qua đường dẫn nhanh không cần suy luận, đồng thời giữ lại token tư duy mở rộng và vòng lặp kiểm chứng cho các bài toán mơ hồ và sinh mã nguồn phức tạp.
Inference-time scaling là một bước tiến mạnh mẽ, nhưng việc đối xử với mọi lượt sinh token như một bài toán hóc búa cần giải đố là một thảm họa về mặt vận hành. Nếu muốn hệ thống đạt hiệu năng chuẩn production, bạn cần xây dựng một bộ điều khiển suy luận thích ứng (adaptive reasoning controller) coi token tư duy như một nguồn tài nguyên hữu hạn được đo đếm chặt chẽ.
Kinh Tế Học Của Một Token Tư Duy
Các định luật scaling trong giai đoạn pre-training từng dạy ngành AI rằng trí tuệ được mua trả trước bằng các cụm GPU khổng lồ. Kỹ thuật test-time compute đã thay đổi hoàn toàn bài toán kinh tế đó: bạn thuê trí tuệ theo từng lượt truy vấn bằng cách cho phép mô hình sinh ra hàng trăm hoặc hàng nghìn token suy luận ẩn trước khi đưa ra câu trả lời cuối cùng.
Cái bẫy ở đây là việc ngộ nhận rằng số lượng token tư duy sẽ tỷ lệ thuận với độ khó của tác vụ. Trong thực tế, tỷ suất hoàn vốn (ROI) chạm ngưỡng bão hòa rất nhanh tùy thuộc vào loại truy vấn:
| Nhóm tác vụ | Ví dụ thực tế | Tỷ lệ Pass khi không dùng Reasoning | Tỷ lệ Pass khi dùng Full Reasoning | Hệ số nhân chi phí Token | Tác động độ trễ |
|---|---|---|---|---|---|
| Trích xuất dữ liệu & Regex | Bóc tách số điện thoại hoặc ngày tháng từ hóa đơn | 99.1% | 99.3% | 7.8x | +8.4s |
| Định dạng Schema | Chuyển văn bản tự do thành JSON có cấu trúc | 96.4% | 97.1% | 6.2x | +6.1s |
| Điều hướng xác định (Routing) | Chọn 1 trong 5 tools dựa trên ý định của user | 94.2% | 95.0% | 5.4x | +5.5s |
| Sinh mã nguồn nhiều ràng buộc | Tạo câu lệnh SQL với nhiều bảng join phức tạp | 68.2% | 89.4% | 3.1x | +4.2s |
| Kiểm chứng ký hiệu (Symbolic) | Rà soát tuân thủ chính sách trên tài liệu pháp lý | 51.0% | 84.6% | 2.8x | +3.9s |
Đối với các tác vụ phân loại, định dạng và trích xuất thông tin, việc bật full reasoning chỉ mang lại chưa đầy 1% cải thiện chất lượng nhưng lại nhân hóa đơn lên từ sáu đến tám lần. Ngược lại, đối với sinh code và kiểm chứng ràng buộc, những token bổ sung này mang lại mức tăng độ chính xác hai mươi đến ba mươi phần trăm, hoàn toàn tương xứng với chi phí bỏ ra.
Bật reasoning một cách bừa bãi sẽ đốt sạch ngân sách vào những nơi không hề tạo ra giá trị gia tăng.
Kiến Trúc Hai Tầng: Fast Path Và Cổng Leo Thang (Escalation Gate)
Để giải quyết sự mất cân đối này, tụi mình thiết kế pipeline suy luận theo mô hình Inception Deck: phân định rõ ranh giới cứng giữa những tác vụ cần chạy nhanh rẻ và những tác vụ thực sự xứng đáng được cấp tài nguyên tính toán sâu.
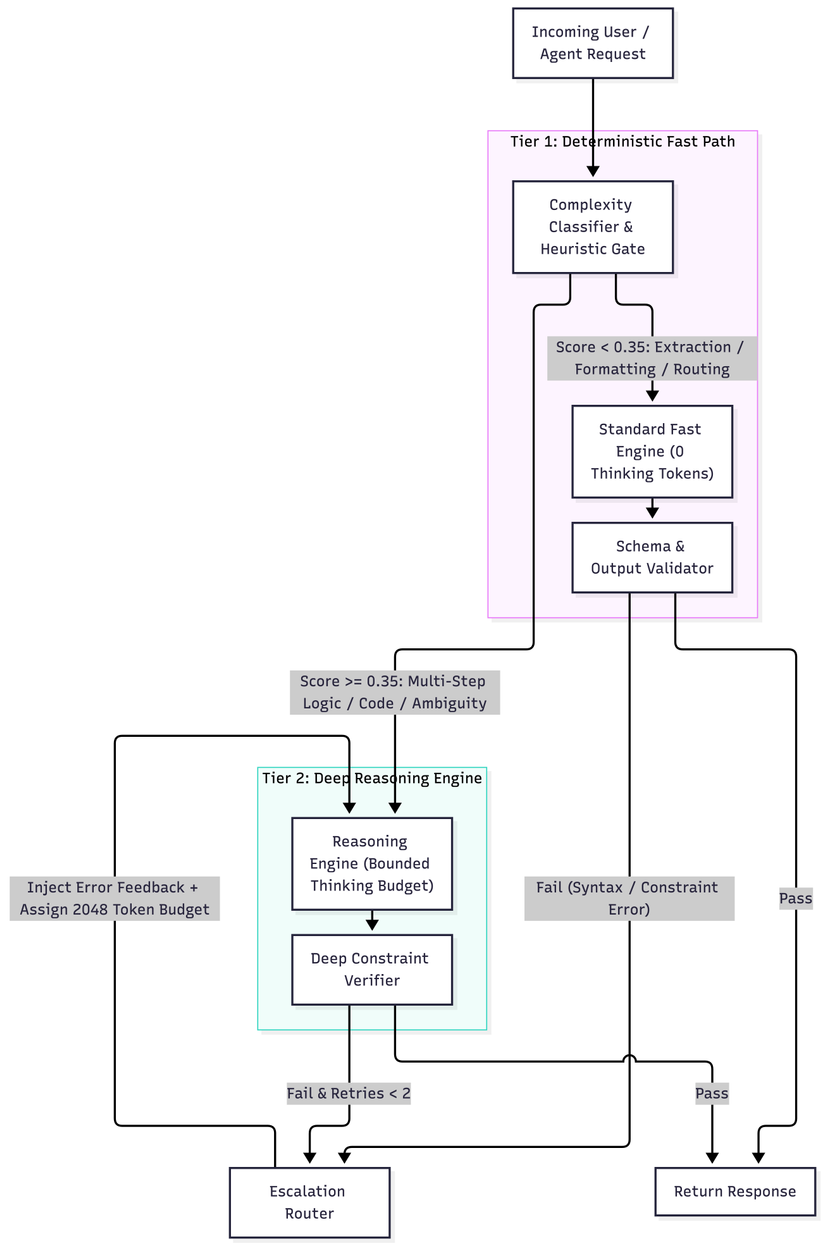
Hệ thống vận hành dựa trên ba quy tắc rõ ràng:
- Thực Thi Lạc Quan Không Cần Suy Luận (Optimistic Zero-Thought): Các tác vụ có độ hỗn loạn thấp (định dạng JSON, routing intent, bóc tách trường thông tin) được chuyển đến mô hình tiêu chuẩn mà không bật thinking tokens. Hơn 85% truy vấn trong hệ thống được xử lý tại đây dưới một giây.
- Kiểm Tra Xác Định Làm Đòn Bẩy Leo Thang: Nếu phản hồi ban đầu không vượt qua được bước xác thực pydantic schema hoặc regex, request sẽ không retry mù quáng. Nó được chuyển lên tầng reasoning kèm theo thông báo lỗi xác thực cụ thể làm ngữ cảnh phản hồi.
- Giới Hạn Ngân Sách Cứng (Hard Budget Capping): Thay vì để mô hình suy nghĩ vô hạn định, harness gán trần
max_thinking_tokenscụ thể cho từng tầng tác vụ (ví dụ: 512 token cho sửa lỗi định dạng, 2.048 token cho sinh truy vấn SQL, và 4.096 token cho lập kế hoạch agent nhiều bước).
Triển Khai Bộ Quản Lý Suy Luận Thích Ứng Bằng Python
Dưới đây là đoạn code thực tế mô phỏng bộ điều khiển suy luận động. Bộ điều khiển này phân tích metadata của tác vụ, ước tính độ phức tạp, đặt giới hạn token và kích hoạt vòng lặp leo thang khi gặp lỗi:
from enum import Enum
from typing import Any, Callable, Dict, Optional
from pydantic import BaseModel, ValidationError


class TaskComplexity(Enum):
    TRIVIAL = 0        # 0 thinking tokens (đường dẫn nhanh)
    MODERATE = 1024    # Suy luận có kiểm soát để sửa cú pháp
    COMPLEX = 4096     # Suy luận sâu cho logic và sinh code


class QueryProfile(BaseModel):
    task_type: str
    expected_output_schema: Optional[Dict[str, Any]] = None
    requires_symbolic_math: bool = False
    requires_code_synthesis: bool = False


class DynamicInferenceController:
    def __init__(self, llm_client: Any):
        self.client = llm_client

    def classify_budget(self, profile: QueryProfile) -> TaskComplexity:
        """Phân bổ ngân sách thinking token dựa trên yêu cầu truy vấn."""
        if profile.requires_code_synthesis or profile.requires_symbolic_math:
            return TaskComplexity.COMPLEX
        if profile.task_type in ("extract_fields", "intent_route", "reformat_json"):
            return TaskComplexity.TRIVIAL
        return TaskComplexity.MODERATE

    def execute_request(
        self,
        prompt: str,
        profile: QueryProfile,
        validator: Optional[Callable[[str], Any]] = None,
    ) -> str:
        budget = self.classify_budget(profile)

        # 1. Thử thực thi lần đầu với ngân sách được gán
        response = self._call_llm(prompt, thinking_budget=budget.value)

        # 2. Nếu không có hàm validator, trả kết quả luôn
        if not validator:
            return response

        # 3. Kiểm tra tính hợp lệ một cách lạc quan
        try:
            validator(response)
            return response
        except (ValidationError, ValueError) as err:
            # 4. Leo thang: chuyển sang tầng reasoning sâu kèm theo ngữ cảnh lỗi
            escalation_prompt = (
                f"{prompt}\n\n"
                f"LAN THU TRUOC BI LOI XAC THUC:\n"
                f"{str(err)}\n"
                f"Hay sua loi tren va chi tra ve ket qua hop le."
            )
            return self._call_llm(
                escalation_prompt, thinking_budget=TaskComplexity.COMPLEX.value
            )

    def _call_llm(self, prompt: str, thinking_budget: int) -> str:
        """Gọi mô hình với giới hạn token tư duy theo từng provider."""
        return self.client.generate(prompt=prompt, max_reasoning_tokens=thinking_budget)
Bằng cách tách biệt ngân sách suy luận khỏi cấu hình mặc định toàn cục, bộ điều khiển này chuyển 75% các lệnh gọi thông thường qua đường dẫn nhanh không tốn thinking token, cắt giảm hơn một nửa tổng chi phí token toàn hệ thống mà vẫn giữ được năng lực suy luận sâu khi có lỗi phát sinh.
Ba Đánh Đổi Kỹ Thuật Cần Giám Sát Trong Production
- Chi Phí Của False Negative Ở Cổng Phân Loại: Nếu bộ phân loại đưa nhầm một câu lệnh SQL phức tạp vào đường dẫn nhanh, lần thử đầu tiên chắc chắn thất bại và kích hoạt leo thang. Dù vòng lặp sửa lỗi sẽ cứu vãn kết quả, bạn sẽ phải chịu chi phí độ trễ của hai lần gọi LLM tuần tự. Nếu tỷ lệ leo thang vượt quá 15%, hãy nới lỏng ngưỡng phân loại.
- Ảnh Hưởng Đến Prompt Caching: Các mô hình reasoning thường sinh ra các chuỗi suy nghĩ không mang tính tất định (non-deterministic). Nếu chuỗi suy nghĩ này bị lưu vào lịch sử hội thoại, nó sẽ phá hủy cơ chế KV cache của các bước tiếp theo. Hãy luôn cô lập chuỗi suy nghĩ khỏi log hội thoại của user.
- Quản Lý Độ Trễ Cho Các Tác Vụ Tương Tác: Tuyệt đối không đặt một lệnh gọi reasoning 4.096 token vào luồng tương tác đồng bộ của người dùng (như endpoint autocomplete hay chatbot trực tiếp). Hãy dùng dynamic budget để siết chặt các tác vụ đồng bộ dưới 512 token, và dồn các lượt suy luận sâu hàng nghìn token cho các worker chạy ngầm không đồng bộ.
Tài nguyên suy luận là một núm vặn kỹ thuật, không phải một công tắc bật tắt nhị phân. Việc căn chỉnh núm vặn đó linh hoạt theo từng request chính là cách bạn khai thác sức mạnh của test-time compute mà không thiêu rụi ngân sách hạ tầng của mình.
All rights reserved