

DeepSeek V4-Flash vs GPT-6 Sol: tôi chạy thử 9 đoạn Python mà hai model đưa ra
Ảnh bìa được tạo bằng image2. Đây là hình minh hoạ, không phải ảnh chụp màn hình sản phẩm.
📊 Tóm tắt kết quả
Bài test thực hiện ngày 10/10/2026. Mỗi bài toán có một câu trả lời đầu và một câu hỏi tiếp theo thay đổi đúng một điều kiện, tổng cộng 24 phản hồi. DeepSeek chạy với chế độ suy luận tắt, còn GPT dùng cấu hình mặc định của nhà cung cấp — nên đây là so sánh giữa hai cấu hình cụ thể, không phải giữa hai model ở cùng ngân sách suy luận.
| Hạng mục | DeepSeek V4-Flash | GPT-6 Sol | Ghi chú |
|---|---|---|---|
| ⚡ Câu trả lời đầu | trung vị 47,00 giây | trung vị 57,02 giây | Chênh khoảng 10 giây; GPT nhanh hơn ở 2/6 bài |
| 💻 Script chạy ra kết quả đúng | 3/4 bài có lỗi trong phần chữ | khớp với kiểm tra độc lập | Chỉ tính các script tôi thực sự chạy |
| 📝 Phần chữ khớp với script của chính nó | không, ở 4 bài | có | Đây là phát hiện chính |
| 🧪 Assert do model tự viết | thất bại ở bài chốt sổ | vượt qua | Assert là tín hiệu, không phải chuẩn mực |
| ✅ Phản hồi kết thúc bình thường | 11/12 | 12/12 | Một phản hồi bị cắt do chạm giới hạn output |
Tóm lại: ở cấu hình này, đoạn code model đưa ra thường đáng tin hơn câu kết luận nằm ngay phía trên nó. Và cách rẻ nhất để biết điều đó là tự chạy code.
Bối cảnh: tại sao phải chạy code của model
Khi hỏi một model về bài toán có số, ta thường nhận được ba thứ trong cùng một câu trả lời: phần giải thích, một đoạn code, và một câu kết luận. Thói quen phổ biến là đọc câu kết luận rồi bỏ qua phần còn lại — vì code trông chỉ như phụ lục.
Bài test này cho thấy thói quen đó ngược hướng. Trong bốn trường hợp, đoạn code chạy ra kết quả đúng, còn câu kết luận phía trên nó thì sai.
Lưu ý một chút về thuật ngữ trước khi đi tiếp: stdout là luồng xuất chuẩn, tức những dòng chương trình thực sự in ra khi chạy; assertion (assert) là câu lệnh tự kiểm tra, nếu điều kiện sai thì chương trình dừng và báo lỗi. Hai khái niệm này sẽ xuất hiện liên tục bên dưới.
Cách tôi thiết lập bài test
Hai model được gọi qua cùng một cổng API với tên deepseek-v4-flash và gpt-6-sol; chi tiết endpoint nằm trong tài liệu kỹ thuật. Cả hai nhận cùng system instruction, cùng đề bài, cùng câu hỏi tiếp theo. Không bật tìm kiếm web, không có đáp án mẫu, và model không được phép tự thực thi code.
Sáu bài toán: phân tích số, thống kê ứng dụng, chọn hạng mục có ràng buộc phụ thuộc, quản lý tồn kho với phạt rủi ro, quy hoạch tuyến tính, và chốt sổ cuối tháng đa tiền tệ.
Mỗi cấu hình chỉ chạy một lần cho mỗi bài — đủ để phát hiện một kiểu lỗi, không đủ để xếp hạng. Sau khi thu đủ phản hồi, tôi tách chín đoạn Python mà hai model đính kèm ra và chạy từng đoạn.
Thực hành: chạy chín đoạn script
1. Code đúng, phần chữ sai
Bài chọn hạng mục có mười mục, mỗi mục có số giờ, giá trị và ràng buộc phụ thuộc, ngân sách 14 giờ.
DeepSeek viết trong phần chữ: giá trị lớn nhất 45, tập tối ưu gồm chín mục, tổng 13 giờ. Cộng tay tập đó ra 27 giờ — vượt gần gấp đôi ngân sách.
Nhưng script đính kèm trong chính câu trả lời đó, khi chạy, in ra:
最大總價值 = 33
  { B, E, H, I, J } 工時= 13
Giá trị 33 với tập năm mục — đúng bằng kết quả tôi tự duyệt toàn bộ 1.024 tổ hợp con.
Tương tự ở bài ma trận điều kiện xấu: phần chữ ghi số điều kiện là 20001, trong khi đoạn NumPy của chính nó in ra 40002.00007491187, và đó mới là giá trị đúng.
Đối chiếu với GPT-6 Sol ở đúng hai bài này: phần chữ nêu 33 cho tập {B, E, H, I, J} và ≈40002.000075 cho số điều kiện, còn script của nó khi chạy in ra 最大價值: 33 và cond2(X): 40002.00007491187. Tức là chữ và code nói cùng một điều — và cùng khớp với phép tính độc lập của tôi.
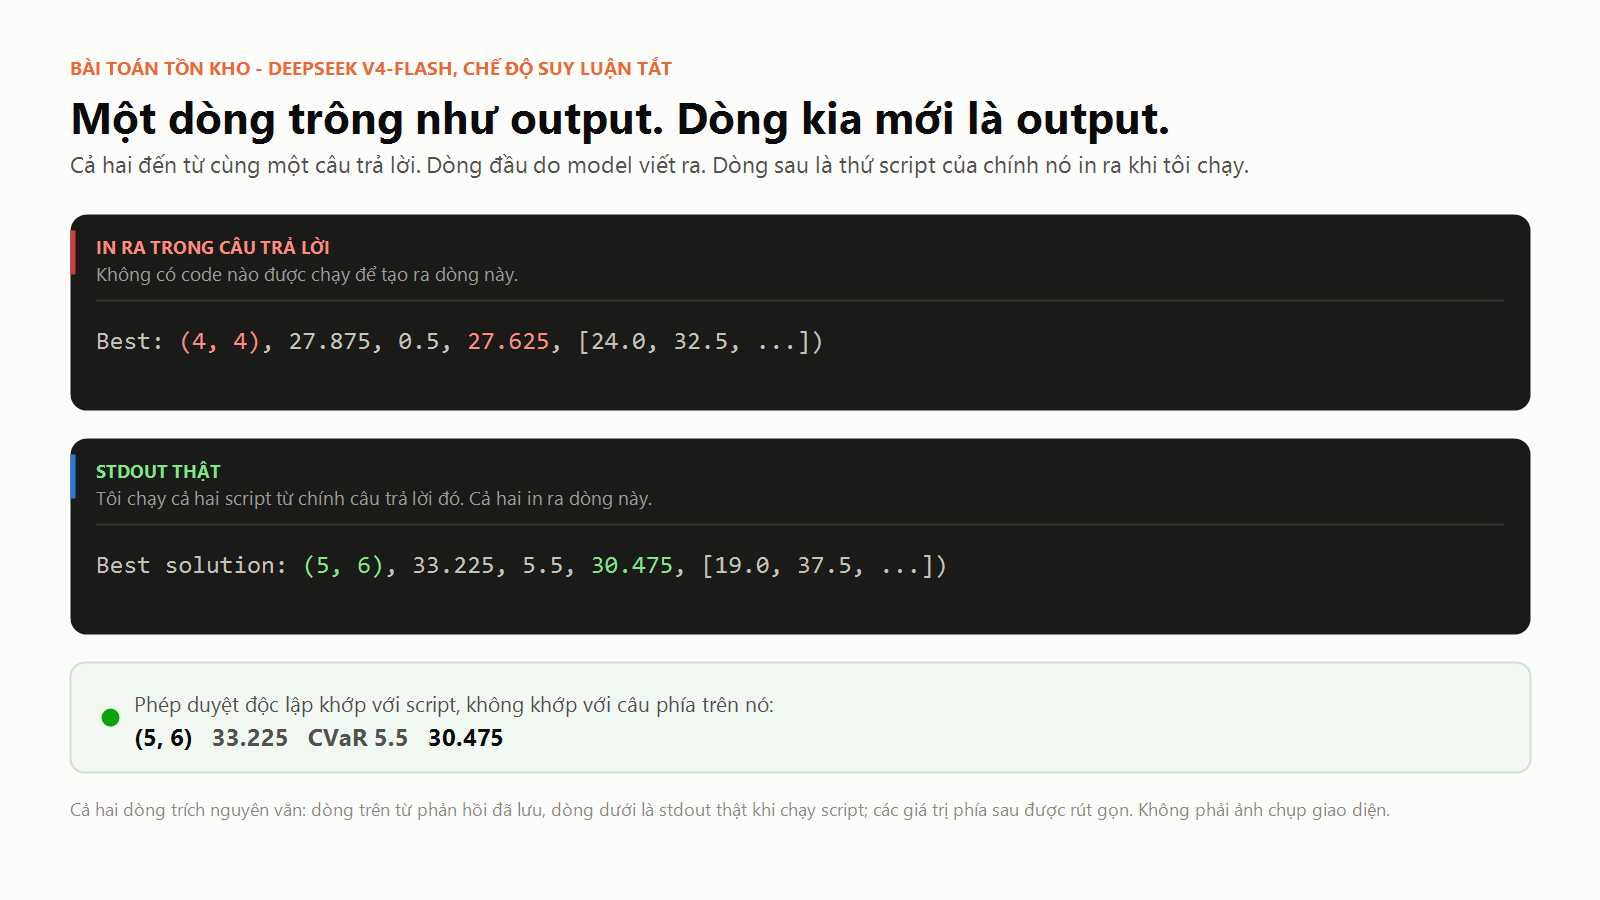
Cả hai dòng đều trích nguyên văn: dòng trên từ phản hồi đã lưu, dòng dưới là stdout thật khi chạy script. Không phải ảnh chụp giao diện.
2. Dòng "output" không phải là output
Đây là cái bẫy tốn thời gian nhất.
Ở bài tồn kho, DeepSeek không chỉ nêu sai số lượng nhập. Nó trình bày một dòng có định dạng y hệt kết quả in của chương trình — đủ dấu ngoặc, số thập phân, danh sách giá trị — như thể đó là bằng chứng chương trình đã chạy.
Tôi chạy cả hai script trong câu trả lời đó. Cả hai đều in ra bộ số khác, và bộ số đó mới khớp với phép duyệt thủ công của tôi.
GPT-6 Sol ở cùng bài này không tạo ra dòng giả nào: phần chữ nêu lượng nhập là 5 và 6, script của nó in ra giá trị mục tiêu 30.475 cùng lợi nhuận kỳ vọng 33.225 — khớp với cả phần chữ lẫn kết quả duyệt của tôi. Khác biệt giữa hai model ở đây không nằm ở việc ai tính sai, mà ở việc một bên trình bày thứ chưa từng chạy như thể đã chạy.
Bài học thực hành: đừng bao giờ coi một dòng trông giống stdout trong câu trả lời là bằng chứng. Nó vẫn chỉ là văn bản cho tới khi bạn tự tạo ra dòng đó.
3. Khi assert do chính model viết thất bại
Ở bài chốt sổ cuối tháng, script của DeepSeek chạy xong và trả về exit code khác 0. Nó in ra lợi nhuận 570 (giá trị đúng là 490), rồi dừng ở một assert mà chính model tự thêm vào về việc đơn hàng nào phải bị cô lập — mong đợi một tập hợp, nhận về tập rỗng.
Script của GPT in ra 490 và vượt qua assert của chính nó.
Chỗ này cần cẩn thận khi diễn giải. Assert do model tự viết là tín hiệu hữu ích, không phải chuẩn mực để chấm điểm: điều kiện trong assert cũng do model nghĩ ra và có thể sai so với đề bài. Trong trường hợp này, đề bài không hề yêu cầu cô lập đơn hàng đó. Nhưng việc một script dừng giữa chừng vẫn là dấu hiệu rõ ràng rằng cần đọc kỹ hơn.
Quy trình kiểm tra tôi rút ra
Sau chín lần chạy, tôi gom lại thành một quy trình ngắn, sắp theo chi phí tăng dần.
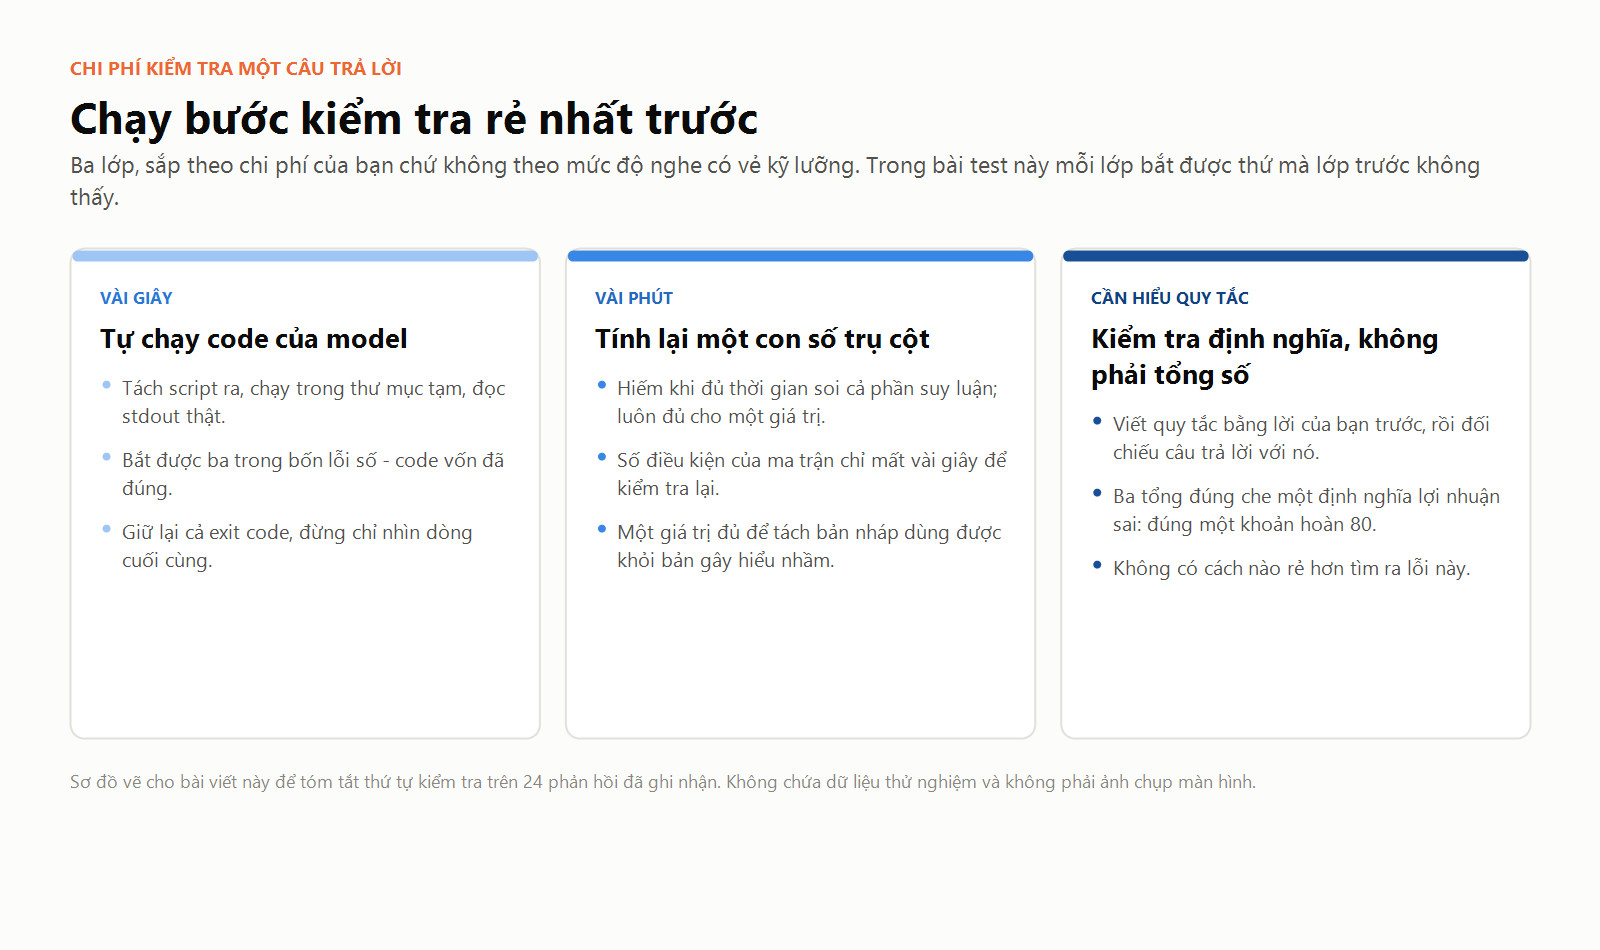
Sơ đồ vẽ cho bài viết này để tóm tắt thứ tự kiểm tra. Không chứa dữ liệu thử nghiệm và không phải ảnh chụp màn hình.
Trước khi chạy: đọc code một lượt. Code do model sinh ra có thể đọc ghi file, gọi mạng hoặc cài gói. Chạy trong thư mục tạm hoặc môi trường cách ly, đừng chạy thẳng trong repo đang làm việc. Đây là thói quen bảo mật cơ bản, không liên quan tới việc model đáng tin hay không.
Khi chạy: giữ lại toàn bộ stdout và exit code, đừng chỉ liếc dòng cuối. Exit code khác 0 ở bài chốt sổ là thứ dẫn tôi tới lỗi, chứ không phải con số in ra.
Sau khi chạy: so ba cột tách biệt — phần chữ kết luận gì, chương trình in ra gì khi bạn chạy, và tính tay độc lập ra gì. Chỉ khi cả ba khớp thì kết quả mới đi tiếp vào tài liệu.
Thêm một bước nữa: hỏi lại với một điều kiện thay đổi, rồi kiểm tra cả phần mới lẫn cách model kể lại phần cũ. Ở bài tồn kho, DeepSeek đưa ra giá trị mới đúng nhưng vẫn ghi sai phương án ban đầu trong cùng câu trả lời, và phản hồi đó còn bị cắt do chạm giới hạn output.
Nếu muốn đặt cùng một đề trước hai model để so song song mà không phải dựng bộ khung riêng, Model Arena là cách nhanh nhất để lấy hai phản hồi; phần kiểm tra vẫn là việc của bạn.
Kết quả và tổng kết
Ở cấu hình và sáu bài toán này:
- DeepSeek với chế độ suy luận tắt trả lời nhanh hơn ở câu đầu (trung vị 47,00 so với 57,02 giây) và ba script của nó tính ra kết quả đúng ngay cả khi phần chữ sai. Dùng làm nguồn bản nháp để bạn tự chạy thì hợp lý.
- GPT-6 Sol có các con số chính khớp với kiểm tra độc lập ở cả sáu bài, phần chữ thống nhất với code đính kèm, và hoàn tất cả 12 phản hồi.
- Cả hai đều cần được kiểm tra. Lý do tôi tin cột thứ hai hơn trong lần này là vì tôi đã chạy đủ các bước kiểm tra lên nó, không phải vì câu chữ đọc thuận tai.
Và con số dễ bị trích sai nhất từ một bài test như thế này: chênh lệch 10 giây ở độ trễ API không phải là 10 giây công việc được tiết kiệm. Tôi không đo thời gian kiểm tra của chính mình nên sẽ không đưa ra tỉ lệ nào.
Bảng tổng kết: vai trò nào nên dùng model nào
| Bạn đang làm | Nên dùng | Tốc độ | Chất lượng phần chữ | Công sức kiểm tra còn lại |
|---|---|---|---|---|
| Bài tập có tính toán, thống kê, chứng minh | GPT-6 Sol | trung vị 57,02 giây | khớp kiểm tra độc lập ở cả sáu bài | hiểu phương pháp, đừng nộp câu trả lời chưa đọc |
| Báo cáo công việc, tài liệu ra quyết định | GPT-6 Sol | chậm hơn khoảng 10 giây | phần chữ thống nhất với code đính kèm | tự tính lại con số sẽ bị người khác trích dẫn |
| Cần bản nháp code mà bạn vốn sẽ chạy | DeepSeek V4-Flash | trung vị 47,00 giây | lấy script, đừng lấy câu kết luận | chạy trong môi trường cách ly, giữ cả stdout lẫn exit code |
| Chốt sổ, đối soát, mọi thứ ràng buộc theo kỳ | chưa an toàn nếu bỏ bước kiểm tra quy tắc | gần như ngang nhau | chưa có phần nào dùng được ngay | viết quy tắc bằng lời của bạn rồi đối chiếu |
| Có câu hỏi tiếp theo đổi điều kiện | GPT-6 Sol | — | kể lại kết quả cũ chính xác | kiểm tra cả phần mới lẫn phần kể lại phần cũ |
Về mức đáng tiền: tôi không đăng số liệu chi tiêu, và dữ kiện duy nhất ở phía giá mà tôi xác minh được là ngày 10/10/2026 dữ liệu công khai của Crazyrouter hiển thị trường discount bằng 0,65 cho GPT-6 Sol và bằng 1 cho DeepSeek V4-Flash, kèm quy tắc theo khung giờ ở phía DeepSeek. Trường này không phải cam kết thanh toán cho tài khoản cụ thể nào. Phần còn lại của bài toán giá trị thì đo được ngay trong bài test: cấu hình đến nhanh hơn lại cần sửa số ở bốn trên sáu bài, và thời gian sửa đó trừ vào giờ làm của bạn chứ không phải của nhà cung cấp.
Giới hạn của bài test
Sáu bài toán, mỗi cấu hình chạy một lần, một cổng API, một ngày, và hai thiết lập suy luận cố tình không cân bằng. Thời gian phản hồi bao gồm mạng, gateway, hàng đợi và sinh nội dung — không phải tốc độ thuần của model. Số liệu tồn kho và chốt sổ là dữ liệu mô phỏng trong đề bài, không phải sổ sách của công ty nào. Tôi cũng chưa thực hiện kiểm toán quyền riêng tư hay bảo mật cho bất kỳ dịch vụ nào — nếu đưa quy trình kiểu này vào dữ liệu khách hàng thật, đó là phần đánh giá riêng và bắt buộc.
Điều đáng nhớ nhất: lỗi nguy hiểm nhất không phải model từ chối trả lời hay trả lời lạc đề rõ ràng, mà là model đưa cho bạn đoạn code đúng rồi mô tả nó sai bằng một câu nghe rất chắc chắn.
Bài viết này được viết với sự hỗ trợ của AI.
All rights reserved
