

Claude cho từng loại tác vụ: chọn Haiku, Sonnet hay Opus — và cái giá phải trả
Chọn model theo cảm giác "mạnh nhất" thường làm hóa đơn tăng mà kết quả không khá hơn. Dưới đây là cách chọn theo loại việc, kèm bảng giá ngày 23 tháng 10 năm 2026 và các con số cụ thể.
Ảnh bìa: minh họa do AI tạo, ngày 23 tháng 10 năm 2026. Đây là hình minh họa, không phải ảnh chụp màn hình và không phải kết quả kiểm thử.
Vấn đề: cùng một việc, ba mức giá khác nhau
Một nhóm công việc giống nhau — phân loại tin nhắn, tóm tắt tài liệu, viết lại nội dung, sửa lỗi trong mã nguồn — có thể chạy trên model nhỏ nhất hoặc model đắt nhất. Chênh lệch giữa hai lựa chọn không phải vài phần trăm: với cùng một khối lượng token, model đắt nhất có thể tốn gấp hai mươi lần model rẻ nhất. Nhưng chọn rẻ cũng có cái giá của nó: nếu phải chạy lại ba lần mới xong việc, phần tiết kiệm biến mất.
Câu hỏi cần trả lời không phải "model nào tốt nhất" mà là "với loại việc này, model nào cho chi phí thấp nhất trên một việc đã hoàn thành". Muốn trả lời được, cần biết chính xác cái gì được tính tiền.
Bối cảnh: những khái niệm quyết định hóa đơn
Token là đơn vị mà model đọc và sinh ra; giá được tính trên một triệu token. Token vào là phần nội dung gửi lên, token ra là phần model sinh ra. Ngữ cảnh (context) là lượng token tối đa mà một lần gọi có thể chứa. Cache là cơ chế lưu lại một tiền tố đã xử lý để lần gọi sau không phải trả giá đầy đủ cho phần đó; cơ chế này có hai mức giá riêng: ghi vào cache và đọc từ cache.
Bảng dưới đây là giá niêm yết lấy từ trang giá chính thức của Anthropic ngày 23 tháng 10 năm 2026 — đây là liên kết nguồn không thuộc thương hiệu duy nhất, các nguồn khác được nêu tên. Đơn vị: đô la Mỹ cho một triệu token.
| Model | Token vào | Token ra | Đọc cache | Ghi cache |
|---|---|---|---|---|
| Fable 5.1 | 10 | 50 | 0,25 | 12,50 |
| Opus 5.5 | 4 | 20 | 0,20 | 5,00 |
| Sonnet 5.5 | 2 | 10 | 0,10 | 2,50 |
| Haiku 5.5, câu lệnh đến 100K | 0,10 | 0,50 | 0,01 | 0,125 |
| Haiku 5.5, câu lệnh trên 100K | 0,50 | 2,50 | 0,05 | 0,625 |
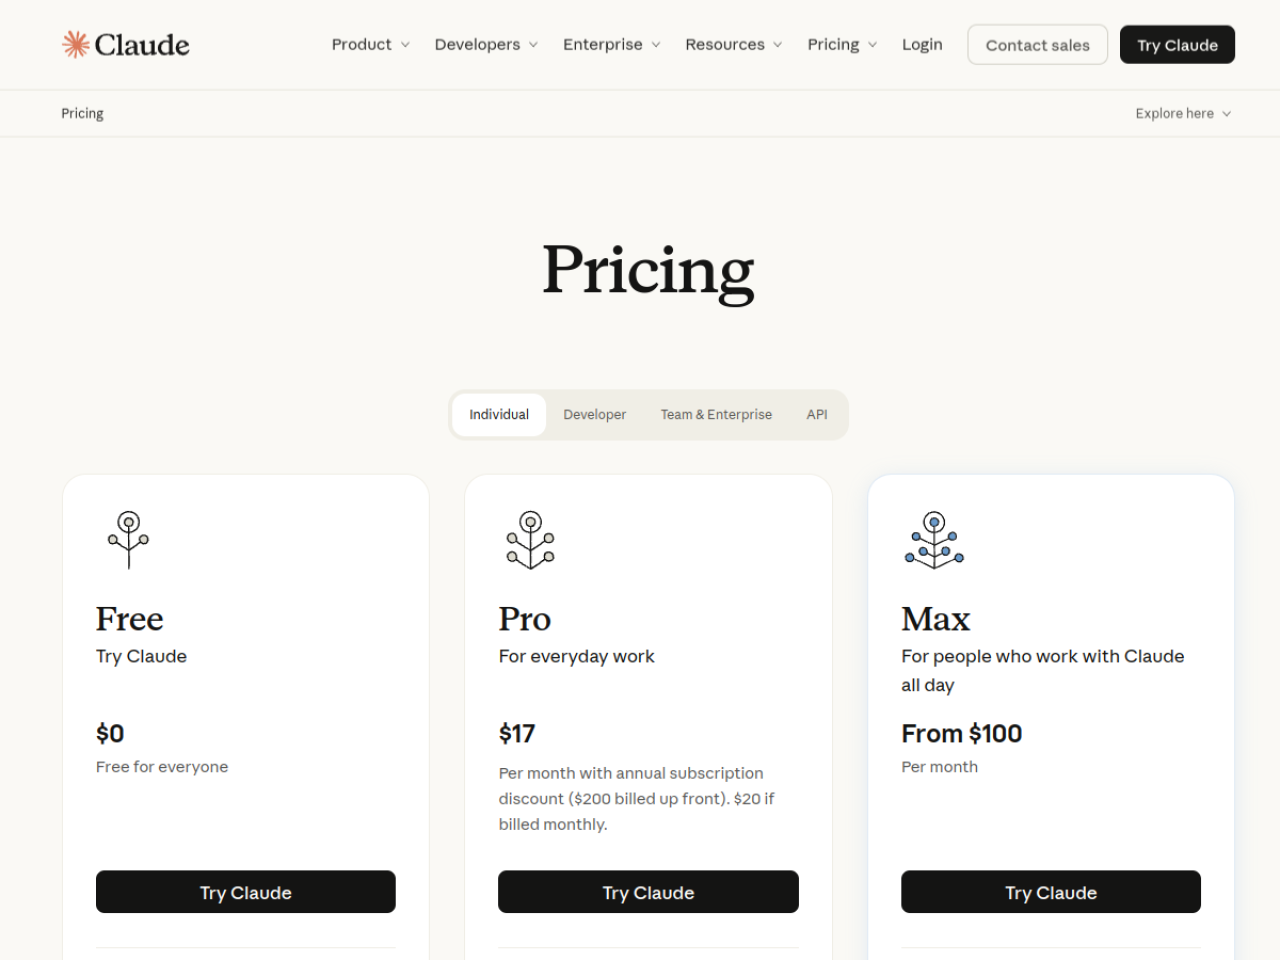
Ảnh chụp trang giá chính thức ngày 23 tháng 10 năm 2026: các thẻ gói Free, Pro và Max với mức giá hiển thị trong ngày, trong đó Pro là 17 đô la mỗi tháng khi trả theo năm và 20 đô la khi trả theo tháng. Đây là ảnh chụp một ngày cụ thể: bảng giá API và điều kiện tín dụng của gói Max nằm ở phần dưới cùng trang và được dẫn riêng ở đây.
Ba đặc điểm của bảng giá quyết định phần lớn hóa đơn. Thứ nhất, ở cả ba model hiện hành, token ra đắt đúng gấp năm lần token vào — nghĩa là câu trả lời dài tốn tiền nhanh hơn nhiều so với câu hỏi dài. Thứ hai, ghi cache đắt hơn token vào thường 1,25 lần, còn đọc cache rẻ hơn token vào hai mươi lần, nên cache chỉ có lợi khi tiền tố thực sự được dùng lại. Thứ ba, Haiku 5.5 có hai mức giá và mức cao áp dụng cho toàn bộ yêu cầu khi câu lệnh vượt 100.000 token.
Không có lần gọi API trả phí nào được thực hiện, vì vậy mọi con số dưới đây là phép tính số học với giả định ghi rõ, không phải hóa đơn thật.
Thực hành: chọn model theo loại việc
Việc ngắn, đầu ra ngắn: phân loại, trích xuất, kiểm tra định dạng
Ví dụ một lần gọi 8.000 token vào và 300 token ra. Trên Haiku 5.5 chi phí khoảng 0,00095 đô la: 8.000 × 0,10 / 1.000.000 = 0,0008 cho phần vào, cộng 300 × 0,50 / 1.000.000 = 0,00015 cho phần ra. Cùng yêu cầu đó trên Sonnet 5.5 tốn khoảng 0,019 đô la: 0,016 cộng 0,003. Chênh lệch khoảng hai mươi lần, trong khi loại việc này thường không cần đến khả năng suy luận của model lớn.
Điều cần kiểm tra: độ chính xác trên chính dữ liệu của mình, chứ không phải trên ví dụ minh họa. Nếu model nhỏ trả về đúng định dạng và đúng nhãn ở phần lớn trường hợp, phần tiết kiệm là thật.
Việc viết và phân tích văn bản: Sonnet là mức mặc định hợp lý
Ví dụ 30.000 token vào và 4.000 token ra. Sonnet 5.5 cho kết quả khoảng 0,10 đô la (0,06 cho phần vào cộng 0,04 cho phần ra). Opus 5.5 cho cùng khối lượng tốn khoảng 0,20 đô la — gấp đôi. Haiku 5.5 chỉ tốn khoảng 0,005 đô la, rẻ hơn hai mươi lần, nhưng với văn bản dài cần mạch lạc thì chất lượng phải tự đo, và đây là chỗ dễ tiết kiệm sai nhất: một lần chạy lại vì kết quả không dùng được đã xóa sạch phần chênh lệch.
Việc khó, nhiều bước: Opus và rủi ro cháy token đầu ra
Với việc cần suy luận nhiều bước, model lớn có thể rẻ hơn trên một việc hoàn thành, vì nó xong sớm hơn. Nhưng có một rủi ro riêng: chi phí vẫn phát sinh ngay cả khi không có kết quả. Trong một thử nghiệm công khai của Simon Willison công bố ngày 22 tháng 9 năm 2026, Opus 5.5 ở chế độ suy luận tối đa đã hai lần chạm trần 128.000 token đầu ra, mỗi lần tốn khoảng 2,56 đô la và gần hai mươi phút, mà vẫn không trả về kết quả. Đây là một thử nghiệm đơn lẻ của bên thứ ba, không phải quy luật chung, nhưng nó cho thấy vì sao cần ghi lại lý do dừng của mỗi lần gọi.
Tiền tố lặp lại: khi cache thật sự có lợi
Giả sử một tiền tố cố định 50.000 token được gửi ba lần trong vòng năm phút. Không dùng cache: 3 × 50.000 × 2 / 1.000.000 = 0,30 đô la. Có cache: ghi một lần 50.000 × 2,50 / 1.000.000 = 0,125 đô la, rồi hai lần đọc 2 × 50.000 × 0,10 / 1.000.000 = 0,01 đô la, tổng 0,135 đô la — tiết kiệm khoảng 0,165 đô la, tức hơn một nửa.
Điều kiện đi kèm không được bỏ qua. Theo kiểu dữ liệu của bộ SDK Python chính thức, thời gian sống của cache mặc định là năm phút, có tùy chọn một giờ; trang giá ghi rõ mức giá cache của trang áp dụng cho mốc năm phút.
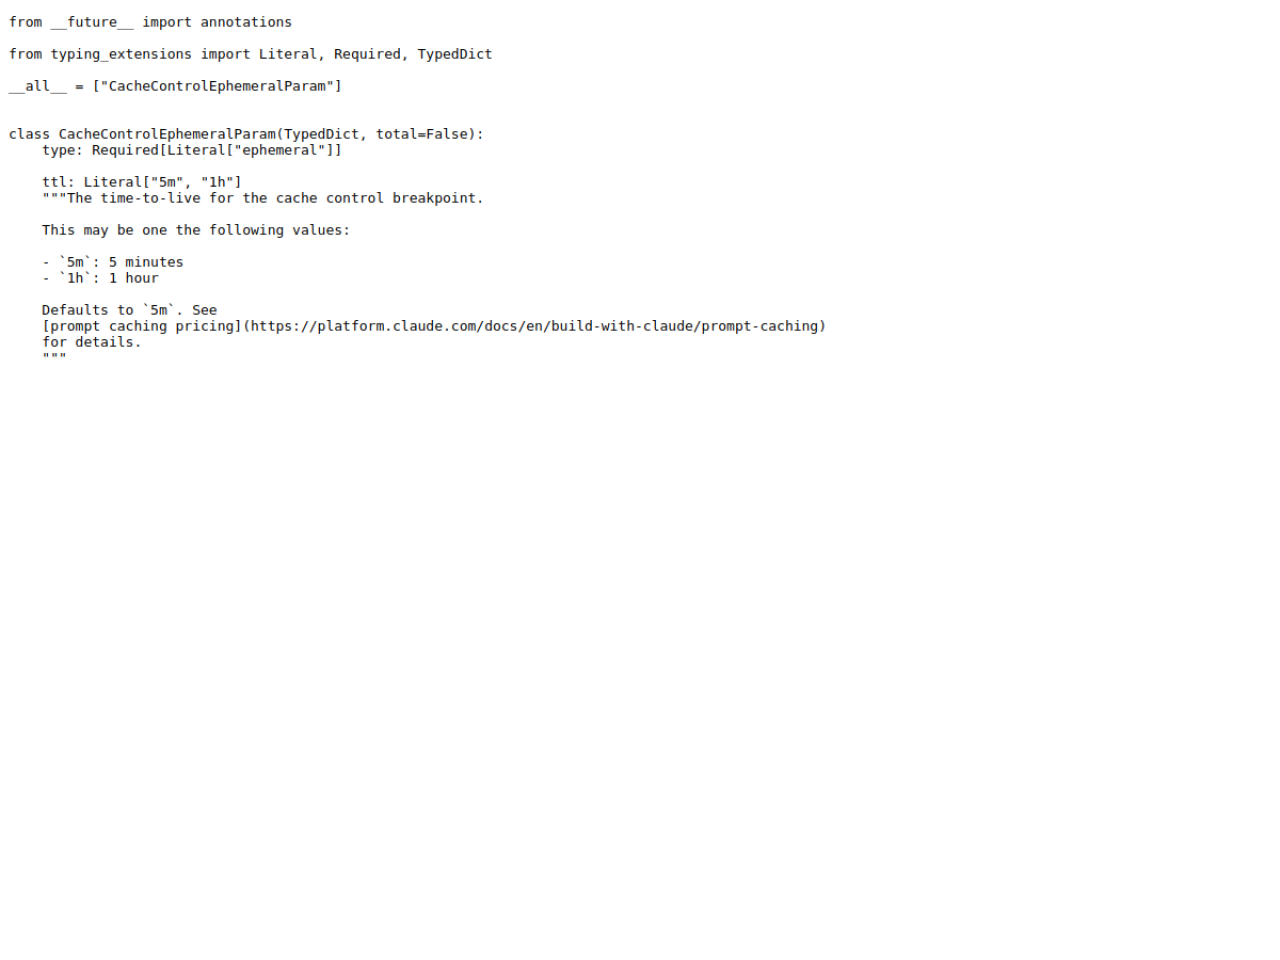
Ảnh chụp ngày 23 tháng 10 năm 2026: kiểu dữ liệu trong bộ SDK Python chính thức quy định thời gian sống của cache. Nó nhận hai giá trị 5m và 1h, mặc định là 5m. Tài liệu này mô tả một tham số: không phải giá, không phải độ dài tối thiểu của tiền tố được cache, và cũng không chứng minh rằng cache đã được đọc.
Nếu tiền tố thay đổi giữa các lần gọi, hoặc khoảng cách vượt quá thời gian sống, khoản ghi cache trở thành chi phí thuần. Đây là dòng dễ bị bỏ sót nhất khi ước tính, vì cache thường được mặc định coi là có lợi.
Ngưỡng 100.000 token của Haiku 5.5
Đây là cái bẫy rõ nhất trong bảng giá. Một câu lệnh 90.000 token với 2.000 token đầu ra tốn khoảng 0,010 đô la: 0,009 cho phần vào cộng 0,001 cho phần ra. Cùng loại việc nhưng câu lệnh 110.000 token tốn khoảng 0,060 đô la: 0,055 cộng 0,005. Văn bản chỉ tăng khoảng 22 phần trăm, hóa đơn tăng khoảng sáu lần, vì mức giá cao hơn được áp cho toàn bộ yêu cầu chứ không chỉ phần vượt ngưỡng.
Với việc xử lý tài liệu dài, cần tính trên đúng độ dài câu lệnh thật trước khi quyết định dùng model rẻ.
Chênh lệch giữa các thế hệ
Một nguyên nhân khác khiến ước tính lệch khỏi hóa đơn: tokenizer. Theo phần giới thiệu chính thức của thế hệ 4.7, cùng một văn bản có thể được đếm thành 1,0 đến 1,35 lần số token so với trước, và trong thử nghiệm nêu trên, cùng một câu lệnh hệ thống cho ra 5.039 token và 7.335 token, tức khoảng 1,46 lần. Giá không đổi nhưng số token tăng, nên ước tính theo số từ luôn thấp hơn thực tế.
Khi so sánh với thế hệ trước, bảng giá ngày 23 tháng 10 năm 2026 cho thấy giá cũ cao hơn: Sonnet 4.6 ở mức 3 và 15 đô la, Haiku 4.5 ở mức 1 và 5 đô la cho một triệu token. Trang model của Claude Sonnet 4.6 là một ví dụ cho cách các trang theo model ghi lại mô tả và giá của từng phiên bản; nếu ước tính đang dựa trên con số cũ, phần lệch đã nằm sẵn trong ước tính.
Với Haiku 5.5, một trang giá theo model như trang giá Claude Haiku 5.5 cho thấy cách một trang niêm yết có ghi ngày và ghi rõ mức giá theo từng model. Cần phân biệt rõ: đó là trang niêm yết của một tuyến truy cập, không phải bằng chứng rằng tuyến đó giữ nguyên mọi hành vi của model gốc, và giá theo tuyến, hành vi cache cùng cách tính các yêu cầu thất bại vẫn phải kiểm tra riêng.
Kết quả: chi phí trên một việc đã hoàn thành
| Loại việc | Model gợi ý | Chi phí một lần gọi (ước tính) | Điều quyết định chi phí thật |
|---|---|---|---|
| Phân loại, trích xuất, 8.000 vào / 300 ra | Haiku 5.5 | khoảng 0,00095 đô la | độ chính xác trên dữ liệu thật |
| Viết, phân tích, 30.000 vào / 4.000 ra | Sonnet 5.5 | khoảng 0,10 đô la | số lần phải chạy lại |
| Suy luận nhiều bước | Opus 5.5 | từ 0,20 đô la trở lên | lý do dừng và trần token đầu ra |
| Tiền tố 50.000 token lặp ba lần trong năm phút | Sonnet 5.5 + cache | khoảng 0,135 đô la thay vì 0,30 | tiền tố có ổn định không |
| Câu lệnh dài trên 100.000 token | Haiku 5.5 | khoảng 0,060 đô la thay vì 0,010 | độ dài câu lệnh so với ngưỡng |
Con số quyết định không phải giá một lần gọi mà là tổng tiền chia cho số việc đã xong. Ba lần chạy trên Sonnet vẫn có thể rẻ hơn một lần chạy trên Opus, và ngược lại — điều đó chỉ đo được bằng log của chính mình: model và tuyến, token vào và token ra lấy từ trường thông tin sử dụng của phản hồi, số lần ghi và đọc cache, số lần thử, lý do dừng.
Tổng kết và giới hạn
Cách chọn hợp lý khá đơn giản: việc ngắn thì dùng model nhỏ, việc viết và phân tích văn bản thì lấy Sonnet làm mức mặc định, việc khó nhiều bước thì mới cần Opus, và cache chỉ đáng dùng khi tiền tố thật sự lặp lại trong thời gian sống. Điểm cần nhớ là mọi so sánh chỉ đúng khi tính trên một việc đã hoàn thành, không phải trên một lần gọi.
Các giới hạn của phần tính toán này: không có lần gọi API trả phí nào được thực hiện, nên tất cả là phép tính với giả định đã ghi; giá là ảnh chụp ngày 23 tháng 10 năm 2026 và có thể thay đổi; độ dài tối thiểu của tiền tố được cache chưa kiểm chứng vì trang tài liệu tương ứng không mở được trong môi trường của tôi; khả năng xử lý ngữ cảnh tới 1M token chưa được kiểm thử, và độ dài ngữ cảnh không đồng nghĩa với độ chính xác khi truy hồi; bằng chứng về tokenizer thuộc thế hệ cũ hơn; thử nghiệm giới hạn token đầu ra là một trường hợp đơn lẻ của bên thứ ba; giá của các nhà cung cấp khác không được dùng vì trang tương ứng trả về lỗi 403.
Nguồn
- Trang giá chính thức của Anthropic, kiểm tra ngày 23 tháng 10 năm 2026: giá theo model, hai mức giá của Haiku 5.5, giá đọc và ghi cache, nhãn gói Pro và Max, ghi chú về mốc cache năm phút. Liên kết có thể bấm nằm ở phần trên.
- Kiểu dữ liệu của bộ SDK Python chính thức của Anthropic (tham số thời gian sống của cache): ảnh chụp ở phần trên.
- Phần giới thiệu chính thức của thế hệ 4.7: ước lượng tokenizer 1,0 đến 1,35 lần.
- Simon Willison, thử nghiệm Opus 5.5 ở chế độ suy luận tối đa, công bố ngày 22 tháng 9 năm 2026: hai lần chạm trần 128.000 token đầu ra, khoảng 2,56 đô la và gần hai mươi phút mỗi lần; ví dụ 5.039 và 7.335 token.
All rights reserved
