

Cấu trúc dữ liệu và Giải thuật Bài 80: Bloom Filter - Cấu trúc xác suất lọc dữ liệu siêu tốc bảo vệ LSM-Tree.
Ở Bài 79, chúng ta đã thấy LSM-Tree hi sinh tốc độ Đọc (Read) để đổi lấy tốc độ Ghi (Write) vô song. Khi bạn truy vấn một từ khóa (Key), LSM-Tree phải lục lọi qua MemTable trên RAM, và nếu không thấy, nó tiếp tục đọc qua hàng tá file SSTable trên ổ cứng.
Bi kịch lớn nhất xảy ra khi Key đó hoàn toàn không tồn tại trong hệ thống. Hệ thống sẽ phải thực hiện hàng loạt lệnh Disk I/O vô ích, đọc toàn bộ các tệp SSTable chỉ để nhận về một con số 0 tròn trĩnh. Để bảo vệ ổ cứng khỏi những truy vấn "mù" tốn kém này, các kỹ sư hệ thống sử dụng một cấu trúc dữ liệu xác suất vô cùng thanh lịch: Bloom Filter.
1. Bloom Filter là gì?
Bloom Filter là một cấu trúc dữ liệu xác suất (Probabilistic Data Structure) được phát minh bởi Burton Howard Bloom vào năm 1970. Nó được thiết kế để trả lời một câu hỏi duy nhất với tốc độ và bộ nhớ siêu nhỏ: "Phần tử này đã tồn tại trong tập hợp hay chưa?"
Câu trả lời của Bloom Filter có một đặc tính vô cùng kỳ lạ:
-
"Chắc chắn CHƯA từng tồn tại" (100% chính xác). Nếu Bloom Filter nói KHÔNG, bạn hoàn toàn tự tin chặn đứng truy vấn, không cần chạm vào ổ cứng.
-
"CÓ THỂ đã tồn tại" (Dương tính giả - False Positive). Nếu Bloom Filter nói CÓ, Key đó khả năng cao là có mặt, nhưng vẫn có một tỷ lệ nhỏ là nó bị nhầm lẫn. Lúc này, hệ thống mới tiến hành xuống ổ cứng để kiểm tra thực tế.
Nhờ việc bắt cạn 100% các trường hợp "Không tồn tại", Bloom Filter cắt giảm được 90-99% các lượt Disk I/O dư thừa cho LSM-Tree.
2. Giải phẫu Cơ chế Hoạt động
Cấu trúc nội tại của Bloom Filter cực kỳ tối giản. Nó bao gồm 2 thành phần:
-
Một Mảng bit (Bit array) có kích thước , ban đầu tất cả các bit đều bằng
0. -
Một tập hợp gồm Hàm băm (Hash Functions) độc lập.
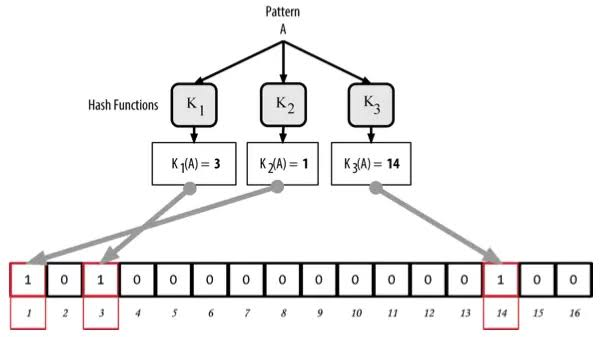
Thao tác Thêm (Insert):
Khi bạn muốn thêm một Key (ví dụ: "apple"), bạn đưa nó qua hàm băm. hàm này sẽ trả về vị trí độc lập trên mảng bit. Bạn chỉ cần bật tất cả các bit ở các vị trí đó thành 1.
Thao tác Truy vấn (Query):
Khi cần kiểm tra xem "apple" có tồn tại hay không, bạn đưa nó qua lại hàm băm cũ để lấy ra vị trí.
-
Bạn kiểm tra các vị trí đó trên mảng. Nếu có BẤT KỲ một bit nào bằng
0, chắn chắn"apple"chưa từng được thêm vào. -
Nếu TẤT CẢ bit đều bằng
1, hệ thống kết luận"apple"có thể đã tồn tại.
Tại sao lại có Dương tính giả (False Positive)?
Giả sử bạn tìm Key "banana". Mặc dù "banana" chưa từng được thêm vào, nhưng rất có thể vị trí băm của nó vô tình trùng lấp hoàn toàn với các bit đã bị bật lên bởi các Key khác trước đó (như "apple" và "orange" kết hợp lại). Lúc này, Bloom Filter sẽ báo CÓ một cách "dương tính giả". Tuy nhiên, nếu bạn thiết kế kích thước mảng và số hàm băm hợp lý, tỷ lệ này thường được kiểm soát ở mức dưới 1%.
4. Triển khai Bloom Filter Tối ưu bằng Golang
Một kỹ sư backend lão luyện sẽ không dùng []bool vì mỗi phần tử bool chiếm trọn 1 Byte (8 bits) trong RAM. Thay vào đó, chúng ta thao tác bitwise trực tiếp trên mảng []uint64 để tiết kiệm tối đa không gian.
Go
package main

import (
	"fmt"
	"hash/fnv"
)

// BloomFilter cấu trúc sử dụng mảng số nguyên 64-bit để tối ưu RAM
type BloomFilter struct {
	bitset []uint64
	size   uint32 // Tổng số bit (M)
	k      uint32 // Số lượng hàm băm (K)
}

func NewBloomFilter(size uint32, k uint32) *BloomFilter {
	// Số lượng uint64 cần thiết = ceil(size / 64)
	numWords := (size + 63) / 64
	return &BloomFilter{
		bitset: make([]uint64, numWords),
		size:   size,
		k:      k,
	}
}

// Giả lập K hàm băm bằng cách sử dụng chung hàm FNV-1a và trộn thêm seed (số nguyên i)
func (bf *BloomFilter) getHashes(key string) []uint32 {
	hashes := make([]uint32, bf.k)
	for i := uint32(0); i < bf.k; i++ {
		h := fnv.New32a()
		// Gắn thêm index i vào đuôi key để tạo ra sự khác biệt cho mỗi hàm băm
		h.Write([]byte(fmt.Sprintf("%s-%d", key, i)))
		hashes[i] = h.Sum32() % bf.size
	}
	return hashes
}

// Insert thêm một key vào Bloom Filter
func (bf *BloomFilter) Insert(key string) {
	hashes := bf.getHashes(key)
	for _, pos := range hashes {
		wordIdx := pos / 64
		bitIdx := pos % 64
		// Bật bit tại vị trí bitIdx lên 1 (sử dụng toán tử OR)
		bf.bitset[wordIdx] |= (1 << bitIdx)
	}
}

// Query kiểm tra sự tồn tại của key
func (bf *BloomFilter) Query(key string) bool {
	hashes := bf.getHashes(key)
	for _, pos := range hashes {
		wordIdx := pos / 64
		bitIdx := pos % 64
		// Kiểm tra bit tại vị trí bitIdx (sử dụng toán tử AND)
		if (bf.bitset[wordIdx] & (1 << bitIdx)) == 0 {
			// Bất kỳ bit nào bằng 0 -> Chắc chắn KHÔNG tồn tại
			return false
		}
	}
	// Tất cả các bit đều bằng 1 -> CÓ THỂ tồn tại (False Positive)
	return true
}

func main() {
	// Khởi tạo Bloom Filter với 1000 bit và 3 hàm băm
	bf := NewBloomFilter(1000, 3)

	bf.Insert("apple")
	bf.Insert("orange")

	fmt.Println("Truy vấn 'apple':", bf.Query("apple"))   // Output: true
	fmt.Println("Truy vấn 'orange':", bf.Query("orange")) // Output: true
	fmt.Println("Truy vấn 'banana':", bf.Query("banana")) // Output: false (Tuyệt đối không tồn tại)
}
5. Phân tích Hiệu năng và Ứng dụng Thực tế
-
Không gian RAM (Space): Cực kỳ nhỏ. Nếu bạn muốn lưu trữ 1 tỷ URL trang web chống lừa đảo (Phishing), thay vì cần hàng trăm GB cho Database, một Bloom Filter chỉ tốn khoảng ~1GB RAM để đạt tỷ lệ dương tính giả dưới 1%.
-
Thời gian (Time): cho cả phép thêm và phép truy vấn. Thời gian không bị ảnh hưởng bởi độ lớn của cơ sở dữ liệu.
Vị trí của Bloom Filter trong Hệ thống:
-
LSM-Tree (Cassandra, RocksDB): Được đặt ngay trước khi hệ thống quyết định đọc các tệp SSTable. Nó chặn 99% các lệnh đọc ổ cứng vô ích.
-
Trình duyệt Web (Chrome Safe Browsing): Trình duyệt lưu sẵn một Bloom Filter nhỏ gọn chứa toàn bộ URL của các trang web độc hại. Khi bạn truy cập, nó quét qua RAM siêu tốc; nếu phát hiện, nó mới gọi API từ server Google để kiểm tra chéo (tránh dương tính giả trước khi cảnh báo).
-
Mạng Phân phối Nội dung (CDN - Akamai/Cloudflare): Ngăn chặn hiện tượng "One-hit Wonder" (những file rác chỉ được người dùng tải đúng 1 lần nhưng lại ngốn bộ nhớ Cache). Bloom Filter sẽ ghi nhớ file đó, và chỉ đưa file vào RAM Cache đắt đỏ nếu có người dùng truy cập file đó lần thứ hai.
Cấu trúc dữ liệu xác suất là một trường phái nghệ thuật tối ưu hóa trong Big Data. Đánh đổi một chút sai số nhỏ để tiết kiệm hàng ngàn lần tài nguyên phần cứng chính là dấu ấn của các kỹ sư vĩ đại.
All rights reserved
