

Cấu trúc dữ liệu và Giải thuật Bài 79: LSM-Tree (Log-Structured Merge-Tree) - Động cơ lưu trữ cho các hệ thống NoSQL Write-Heavy.
B+ Tree (Bài 78) là vị vua tuyệt đối của các cơ sở dữ liệu quan hệ (RDBMS) nhờ khả năng cân bằng hoàn hảo giữa tốc độ Đọc và Ghi. Tuy nhiên, khi hệ thống backend đối mặt với kỷ nguyên Big Data, IoT, hoặc lưu trữ Log sự kiện liên tục — nơi có hàng triệu thao tác GHI (Write) đổ về mỗi giây — B+ Tree bộc lộ một điểm yếu vật lý chí mạng liên quan đến kiến trúc ổ cứng.
1. Nỗi đau của B+ Tree khi Ghi dữ liệu (Random I/O)
Khi bạn chèn một bản ghi mới vào B+ Tree, hệ thống phải duyệt từ Root xuống Leaf để tìm đúng Block cần chèn. Nếu Block đó đã đầy, nó phải thực hiện tách Node (Page Split), kéo theo việc cập nhật lại hàng loạt con trỏ ở các Node cha.
Hệ quả là đầu từ của ổ cứng từ tính (hoặc các chip nhớ SSD) phải liên tục nhảy cóc đến các vị trí ngẫu nhiên trên toàn bộ không gian lưu trữ để ghi các mảnh dữ liệu nhỏ (4KB - 16KB). Thao tác này gọi là Random I/O (Ghi ngẫu nhiên). Dù SSD hiện đại có nhanh đến đâu, việc ghi ngẫu nhiên diện rộng vẫn tạo ra độ trễ khổng lồ và làm giảm tuổi thọ ổ đĩa.
Để xử lý các hệ thống "Write-Heavy" (Ghi cực nhiều), các kiến trúc sư như Google (với Bigtable, LevelDB) và Facebook (với Cassandra, RocksDB) đã từ bỏ B+ Tree để tạo ra LSM-Tree (Log-Structured Merge-Tree), dựa trên một triết lý vật lý duy nhất: Ổ cứng ghi tuần tự (Sequential I/O) nhanh hơn ghi ngẫu nhiên hàng nghìn lần.
2. Ba trụ cột kiến trúc của LSM-Tree
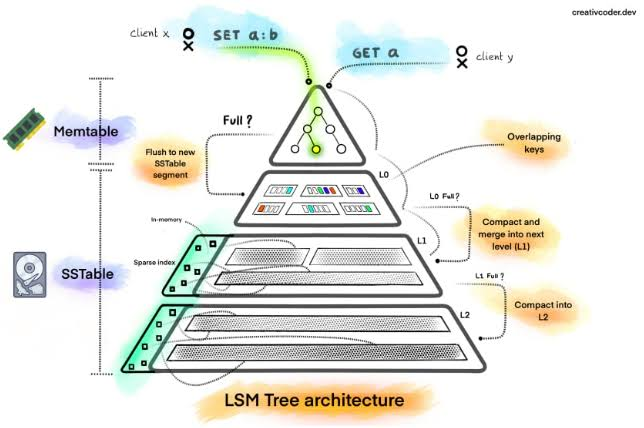
Thay vì cố gắng nhét dữ liệu vào đúng vị trí ngay từ đầu, LSM-Tree tiếp nhận dữ liệu trên RAM trước, sắp xếp gọn gàng, rồi mới xả (flush) một cục lớn xuống ổ cứng theo đường thẳng.
A. MemTable (Trên RAM)
Mọi lệnh PUT (Key, Value) từ client đều được ghi trực tiếp vào MemTable nằm trên RAM.
-
MemTable thường được cài đặt bằng Red-Black Tree hoặc Skip List để đảm bảo dữ liệu luôn được sắp xếp theo thứ tự Key với tốc độ .
-
Nhờ ghi trên RAM, tốc độ phản hồi cho Client gần như tức thời (tính bằng micro-giây).
B. Write-Ahead Log (WAL - Trên Ổ cứng)
RAM bay hơi khi mất điện. Để đảm bảo không mất dữ liệu, trước khi cập nhật MemTable, hệ thống sẽ ghi nối (Append-only) lệnh đó vào một file nhật ký WAL trên ổ cứng. Vì là ghi nối đuôi tuần tự, nó cực kỳ nhanh và không bị dính nút thắt Random I/O.
C. SSTable (Sorted String Table - Trên Ổ cứng)
Khi MemTable trên RAM đạt tới giới hạn (ví dụ: 64MB), toàn bộ dữ liệu đã được sắp xếp của nó sẽ được "đóng băng" và xả (Flush) thẳng xuống ổ cứng tạo thành một file SSTable.
-
Đây là một luồng Ghi Tuần Tự (Sequential Write) khổng lồ và nguyên khối.
-
Khi SSTable đã được ghi xuống ổ đĩa, nó mang tính chất Bất biến (Immutable) — không bao giờ bị sửa đổi hay xóa đi, tránh hoàn toàn được sự phân mảnh và Random I/O.
3. Cơ chế Compaction: Dọn rác và Hợp nhất
Vì SSTable là bất biến, nếu bạn cập nhật (Update) cùng một Key 5 lần, LSM-Tree sẽ ghi ra 5 bản ghi mới ở 5 SSTable khác nhau. Khi một Key bị xóa (Delete), hệ thống không xóa dữ liệu thật trên ổ cứng mà chỉ ghi thêm một cờ đánh dấu Tombstone (Bia mộ).
Khi số lượng file SSTable ngày càng nhiều, thao tác Đọc (Read) sẽ trở nên cực kỳ chậm vì phải tìm kiếm qua hàng chục file khác nhau. Để giải quyết, LSM-Tree kích hoạt một tiến trình ngầm gọi là Compaction (Hợp nhất).
-
Compaction sẽ đọc tuần tự nhiều file SSTable nhỏ ở tầng trên (Level 0, Level 1).
-
Nó trộn (Merge) chúng lại (giống thuật toán Merge Sort).
-
Loại bỏ các giá trị cũ, xóa hẳn các Key có cờ Tombstone.
-
Ghi ra một file SSTable lớn hơn, sạch sẽ hơn ở tầng sâu hơn (Level 2, Level 3).
4. Mô phỏng MemTable cơ bản bằng Golang
Dưới đây là mô hình nguyên lý của một MemTable, giúp Hiếu nắm bắt cách dữ liệu được tích lũy trên RAM và chuẩn bị cấu trúc sắp xếp để sẵn sàng Flush xuống ổ đĩa:
Go
package main

import (
	"fmt"
	"sort"
	"sync"
)

// MemTable đơn giản sử dụng Map để lưu trữ và Slice để duy trì thứ tự khi Flush
type MemTable struct {
	mu    sync.RWMutex
	data  map[string]string
	limit int
}

func NewMemTable(limit int) *MemTable {
	return &MemTable{
		data:  make(map[string]string),
		limit: limit,
	}
}

// Ghi dữ liệu vào RAM (O(1) trên Map, cực kỳ nhanh)
func (m *MemTable) Put(key, value string) bool {
	m.mu.Lock()
	defer m.mu.Unlock()

	m.data[key] = value
	return len(m.data) >= m.limit // Trả về true nếu MemTable đã đầy và cần Flush
}

// Lấy dữ liệu (Chỉ tìm trên RAM)
func (m *MemTable) Get(key string) (string, bool) {
	m.mu.RLock()
	defer m.mu.RUnlock()
	val, ok := m.data[key]
	return val, ok
}

// Flush chuyển dữ liệu từ RAM xuống Disk (SSTable Segment)
func (m *MemTable) Flush() []struct{ Key, Value string } {
	m.mu.Lock()
	defer m.mu.Unlock()

	// Trích xuất và sắp xếp các Key (Đặc trưng cốt lõi của SSTable: Phải được sort)
	var keys []string
	for k := range m.data {
		keys = append(keys, k)
	}
	sort.Strings(keys)

	// Tạo một khối dữ liệu tuần tự chuẩn bị ghi xuống ổ đĩa
	var sstableSegment []struct{ Key, Value string }
	for _, k := range keys {
		sstableSegment = append(sstableSegment, struct{ Key, Value string }{k, m.data[k]})
	}

	// Reset MemTable sau khi xả
	m.data = make(map[string]string)

	return sstableSegment
}

func main() {
	memTable := NewMemTable(3) // Giới hạn giả lập là 3 bản ghi

	memTable.Put("user_102", "Data A")
	memTable.Put("user_101", "Data B")

	isFull := memTable.Put("user_103", "Data C")

	if isFull {
		fmt.Println("MemTable đã đầy! Tiến hành Flush xuống SSTable...")
		segment := memTable.Flush()

		// Dữ liệu khi xả xuống ổ cứng đã được tự động sắp xếp (101 -> 102 -> 103)
		for _, record := range segment {
			fmt.Printf("Ghi tuần tự vào đĩa: %s -> %s\n", record.Key, record.Value)
		}
	}
}
5. B+ Tree vs. LSM-Tree: Chọn Vũ Khí Nào Cho Hệ Thống?
| Tiêu chí | B+ Tree (MySQL, PostgreSQL) | LSM-Tree (Cassandra, RocksDB, ScyllaDB) |
|---|---|---|
| Tốc độ Ghi (Write) | Chậm (Random I/O, Page Split) | Cực nhanh (Sequential Append, MemTable) |
| Tốc độ Đọc (Read) | Nhanh, độ trễ ổn định | Chậm hơn (Phải quét MemTable và nhiều SSTable) |
| Không gian (Space) | Dễ bị phân mảnh, tốn dung lượng | Dữ liệu được nén rất tốt trong SSTable |
| Bảo trì hệ thống | Ít tiến trình nền | Compaction tốn CPU và Disk I/O ngầm |
LSM-Tree đánh đổi tốc độ Đọc để đạt được tốc độ Ghi vô song. Để khắc phục nhược điểm Đọc chậm (phải mò mẫm qua quá nhiều file SSTable để tìm một Key không tồn tại), các hệ thống LSM-Tree buộc phải tích hợp thêm một cấu trúc dữ liệu xác suất để chặn đứng các truy vấn vô ích ngay từ vòng gửi xe.
All rights reserved
