

Vì sao cần kiểm tra dữ liệu trước tiên trong ứng dụng do Claude Code tạo | Các ví dụ thực tế về lược đồ CSDL
Lược đồ CSDL do AI tạo ra — tức cấu trúc quy định các loại thông tin được lưu trong cơ sở dữ liệu và mối quan hệ giữa chúng — có thể trông rất hợp lý. Nếu dữ liệu được lưu bình thường và mã chạy được thì thiết kế đó đã ổn chưa? Dưới đây là năm trường hợp tôi đã xem xét và chỉnh sửa thiết kế do AI đề xuất khi xây dựng một dịch vụ thực tế.
1. Tạo bảng thống kê mà không hỏi có cần thiết hay không
Dịch vụ tôi đang phát triển cần số người đăng ký, số video và tổng lượt xem của các kênh YouTube. Vì những con số này liên tục thay đổi, ban đầu tôi nghĩ đến việc lưu chúng theo ngày trong một bảng thống kê riêng — bảng tập hợp cùng loại dữ liệu theo hàng và cột. AI cũng đề xuất cấu trúc lưu một dòng dữ liệu cho mỗi ngày.
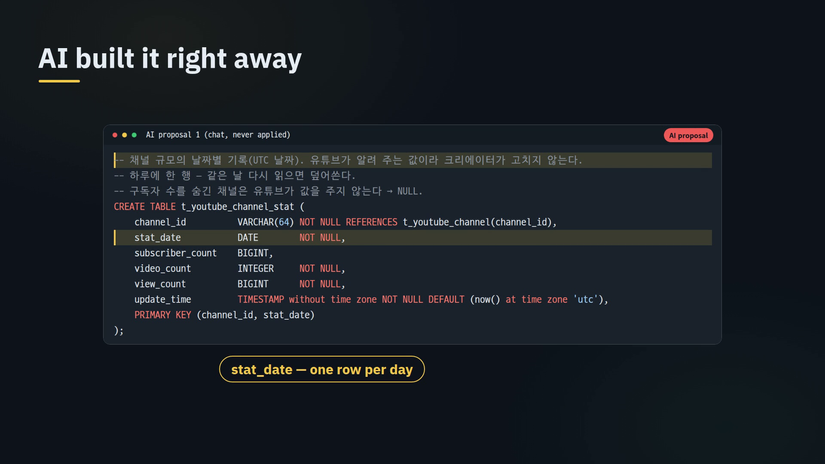
Nhưng điều đầu tiên cần xác nhận là: “Vì sao phải liên tục tích lũy dữ liệu này?” Số người đăng ký tăng hoặc giảm theo ngày có thể được tra cứu qua API bên ngoài. Vì phân tích của dịch vụ hiện tại không cần lưu riêng dữ liệu này, tôi đã xóa bảng. Vấn đề không hẳn là thiết kế sai, mà là chưa xem xét liệu nó có cần thiết cho dịch vụ hiện tại hay không.
2. Ghi vào chú thích những quy tắc không tồn tại trên thực tế
Trong chú thích của cột lưu số người đăng ký — tức mục dữ liệu trong bảng — AI đã đưa ra ví dụ: “điều kiện về số người đăng ký theo quy tắc của nền tảng đăng bài”. Nhưng dịch vụ của chúng tôi không có quy tắc như vậy. Số người đăng ký được dùng để phân tích hiệu quả bằng cách so sánh quy mô kênh với lượt xem video.
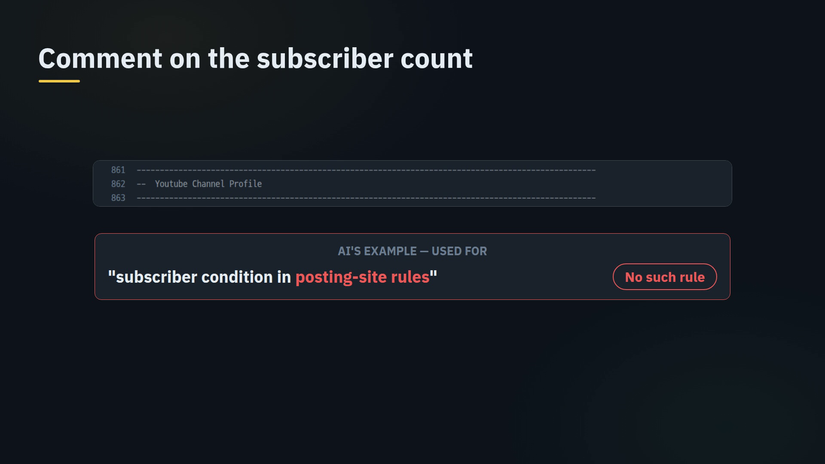
Chú thích không chỉ đơn thuần là phần giải thích. AI tiếp theo có thể hiểu nhầm nội dung đó là chính sách thực tế rồi dựa vào đó để tạo mã. Vì vậy, cần kiểm tra xem các câu chữ mô tả chính sách dịch vụ hoặc mục đích sử dụng dữ liệu có đúng sự thật hay không.
3. Bỏ sót thứ tự sử dụng các tính năng
Để tạo bài quảng bá, cần biết ngôn ngữ của video gốc. Tuy nhiên, có những kênh YouTube chưa thiết lập ngôn ngữ mặc định. AI đề xuất tái sử dụng dữ liệu ngôn ngữ đang được dùng trong tính năng phụ đề đa ngôn ngữ.
Vấn đề là người dùng không nhất thiết sử dụng cả ba tính năng: phân tích kênh, phụ đề đa ngôn ngữ và quảng bá video. Nếu họ chỉ dùng tính năng quảng bá mà chưa dùng phụ đề đa ngôn ngữ, dữ liệu ngôn ngữ cần thiết có thể không tồn tại. Không chỉ cần xem dữ liệu định tái sử dụng có sẵn hay không, mà còn phải cân nhắc thứ tự người dùng sử dụng các tính năng.
4. Bỏ qua quy ước về tên gọi và thời gian của dự án
Tên bảng đầu tiên AI tạo ra là t_creator_profile. Tên này có nghĩa rộng là hồ sơ nhà sáng tạo, nhưng các cột thực tế chỉ chứa thông tin kênh YouTube. Vì vậy, tôi đổi tên thành t_youtube_channel và t_youtube_channel_profile. Một cái tên có vẻ dùng được ngay vẫn có thể gây nhầm lẫn về sau nếu không phản ánh đúng ý nghĩa của dữ liệu.
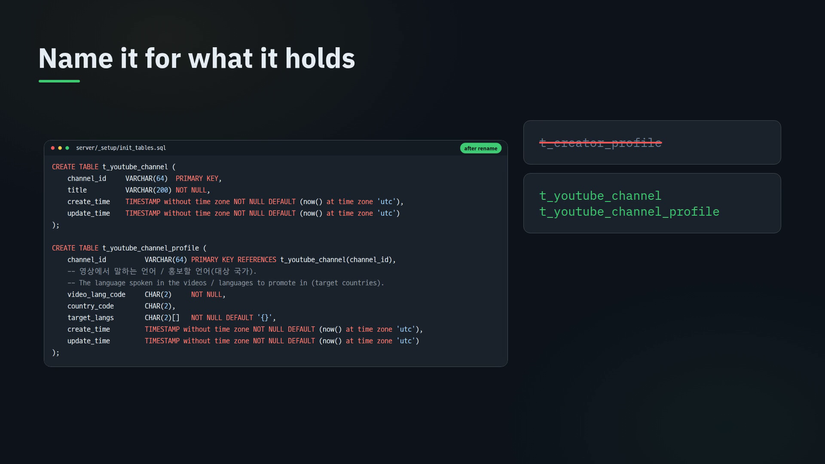
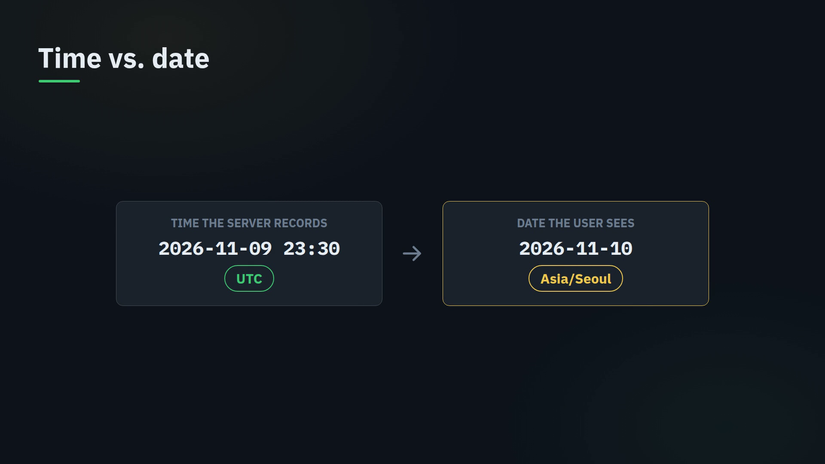
Tôi cũng kiểm tra quy ước về thời gian. Khi được thông báo rằng giờ máy chủ là UTC, AI đã xử lý cả cột ngày theo UTC. Nhưng cần phân biệt thời điểm với ngày tháng. Thời điểm có thể được lưu theo UTC, trong khi ngày hiển thị cho người dùng có thể cần được xử lý theo múi giờ của họ. Tôi đã bổ sung quy tắc này vào CLAUDE.md.
AI đặt tên measure_time cho thời điểm đo, nhưng trong dự án, thời điểm tạo được đặt tên là create_time. Nếu tên gọi có vẻ lạ, hãy kiểm tra xem nó có phù hợp với quy ước hiện có hay không, đồng thời xác nhận ý nghĩa của hai thời điểm có giống nhau không.
5. Đề xuất giải pháp không phù hợp với mục tiêu dịch vụ
Mục tiêu không chỉ là viết bài quảng bá mà còn tự động hóa cả quá trình đăng bài lên nhiều trang web. Với những trang không có API, AI đề xuất cung cấp bản nháp và nút sao chép để người dùng tự đăng. Giải pháp này khả thi về mặt kỹ thuật, nhưng người dùng vẫn phải chuyển qua lại giữa các trang và tự dán nội dung, nên không phù hợp với mục tiêu tự động hóa.
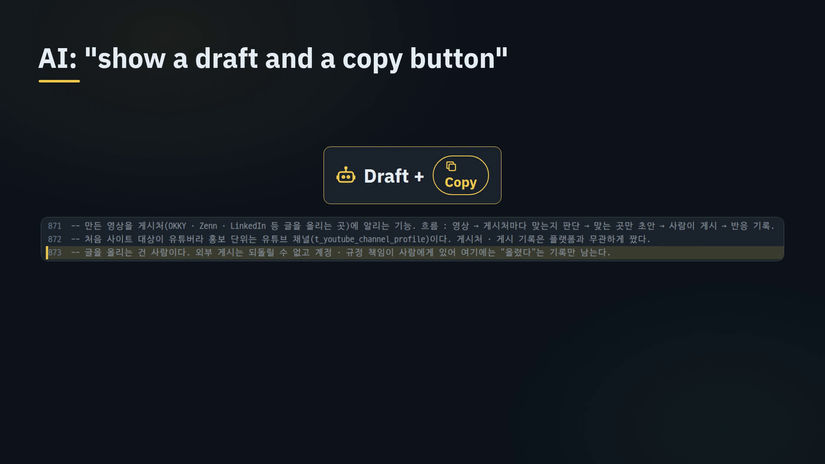
Vì vậy, tôi thiết kế để người dùng sử dụng AI của chính họ khi làm việc với các trang không có API. Máy chủ cung cấp bản nháp cho từng nơi đăng cùng hướng dẫn đăng bài trong một tệp duy nhất, sau đó người dùng gửi tệp đó cho AI của mình. Tiếp theo, AI đề xuất một cấu trúc để máy chủ quản lý cả trạng thái đăng thành công, địa chỉ bài đăng, lượt xem và số bình luận. Tuy nhiên, để tiếp tục quản lý dữ liệu từ các trang không có API thì cần có một hệ thống thu thập riêng. Theo nhận định của tôi, lượng dữ liệu này vượt quá phạm vi cần thiết cho mục tiêu của dịch vụ.
Vì sao cần tự mình kiểm tra lược đồ CSDL?
Năm trường hợp trên không phải là những lỗi khiến mã không chạy. Chúng rất dễ bị bỏ qua chính vì mọi thứ vẫn hoạt động bình thường. Dữ liệu được lưu không đồng nghĩa với thiết kế tốt. Tôi thường xuyên tự hỏi:
“Nếu không có giá trị này thì chuyện gì sẽ xảy ra?” “Ai sẽ điền giá trị này, và vào lúc nào?” “Vì sao phải tích lũy dữ liệu này?” “Máy chủ có cần quản lý cả việc này không?”
Để tìm câu trả lời, cần hiểu mục tiêu của dịch vụ, luồng sử dụng và phạm vi quản lý. Cung cấp đủ thông tin cho AI có thể giúp nhận được đề xuất tốt hơn, nhưng quyết định xây dựng gì và chịu trách nhiệm đến đâu vẫn là việc của lập trình viên. Đặc biệt, dữ liệu là tài sản chỉ có được theo thời gian. Nếu tích lũy dữ liệu ngay từ đầu theo một cấu trúc sai, sẽ khó làm lại đơn giản như với mã nguồn. Vì vậy, ngay cả khi giao cho AI viết mã phía client và server, tôi vẫn tự mình kiểm tra lược đồ CSDL.
Trong lược đồ CSDL của dịch vụ bạn đang xây dựng, mục nào là điều bạn muốn kiểm tra đầu tiên?
Bài viết tóm tắt video YouTube tiếng Hàn của tôi (có phụ đề tiếng Việt) và được dịch bằng AI.
All rights reserved
