


p10logs: xem log pod Kubernetes đa cluster, log không mất khi pod restart, tốn ~100 MiB RAM (open source)
Vì sao Dozzle, kubetail lag khi pod nổ lúc 3h sáng, và cách p10logs giải quyết
Ai làm K8s cũng đều nếm trải cảm giác này: 3h sáng pod crash-loop, gõ kubectl logs --previous thì chỉ xem được đúng 1 lần restart ngay trước đó. Pod bị xoá, node bị reschedule là toàn bộ log đi sạch.
Các tool xem log trực tiếp như Dozzle hay kubetail rất tiện, nhưng khi scale là dính đạn ngay. Nguyên nhân nằm ở chính kiến trúc: chúng stream log qua kube-apiserver → kubelet → file log. Mỗi container bạn đang xem là một kết nối TLS được giữ liên tục qua control plane. kubelet phải gọi CRI ContainerStatus liên tục mỗi giây cho từng stream. Subresource log lại không bị giới hạn bởi API Priority & Fairness (APF), stream nào cũng bị kubelet ngắt sau 4 giờ, và bạn chỉ nhìn thấy đúng file 0.log hiện tại (tối đa 10 MiB). Lag hay treo control plane không phải do UI cùi, mà do kiến trúc stream quá tải.
Muốn lưu log lâu dài? Giải pháp kinh điển là dựng Loki + Grafana (ngốn 1.5–7 GiB RAM) hoặc Elastic/SigNoz (≥4 GB RAM) đi kèm hàng đống thứ xịn xò như metrics, dashboard, compactor... Nhưng đôi khi, nhu cầu thực tế chỉ đơn giản là: "Cho tôi xem lại log của cái pod vừa chết mà không bắt cluster gánh thêm cả tấn infrastructure." (VictoriaLogs là ngoại lệ nhẹ hiếm hoi, nếu bạn đang dùng ổn thì cứ tiếp tục).
Đó là lý do mình viết p10logs.
Architecture & Giải pháp
1. Agent (Go, DaemonSet, ~30 MiB RAM)
- Bypass control plane: Đọc trực tiếp
/var/log/podstrên node. Các metadata như namespace, pod, container, restart count đều parse từ đường dẫn file nên hoàn toàn không tốn 1 request nào gọi apiserver (nếu bật label enrichment thì chỉ dùng 1 watch/node, scope chặt theospec.nodeName). - Xử lý edge-case ở cấp filesystem:
- Rotation: Theo dõi log rotation của kubelet bằng cặp
inode + hash 16 bytes dòng đầu. Nguyên nhân: kernel thường tái sử dụng inode của file vừa bị rotate, nếu chỉ dùngpath + inodethì file mới sinh ra bị coi là trùng và drop sạch (mình dính đạn quả này trên cluster k3s sau ~3 giờ chạy). - Assembly & Spooling: Ghép các dòng partial 16 KiB của containerd, gom multiline stack trace, ghi checkpoint ra hostPath. Khi Hub chập chập hoặc nghẽn mạng, Agent tự động spool log ra disk trên node rồi drain dần khi Hub sống lại.
- Rotation: Theo dõi log rotation của kubelet bằng cặp
2. Hub (Go, StatefulSet + 1 PVC)
- Ingestion pipeline:
Push→WAL fsync→Ack→Memtable theo stream→zstd frame→Chunk theo stream/ngày UTC. - Indexing nhẹ nhõm: Seal chunk ở mốc 4 MiB kèm footer chứa time index và trigram bloom filter. Catalog SQLite đóng vai trò là derived state, có thể rebuild hoàn toàn từ log chunks nếu DB hỏng.
- Retention & Offload: Xoá log theo age (mặc định 7 ngày) hoặc % dung lượng PVC, hỗ trợ override theo namespace. Cần lưu lâu thì offload chunk lạnh lên S3.
- Design choice: Chạy 1 replica để tối ưu dung lượng và IOPS. Restart không mất dữ liệu, chấp nhận không HA để giữ kiến trúc tối giản nhất có thể.
3. Built-in UI & Multi-cluster
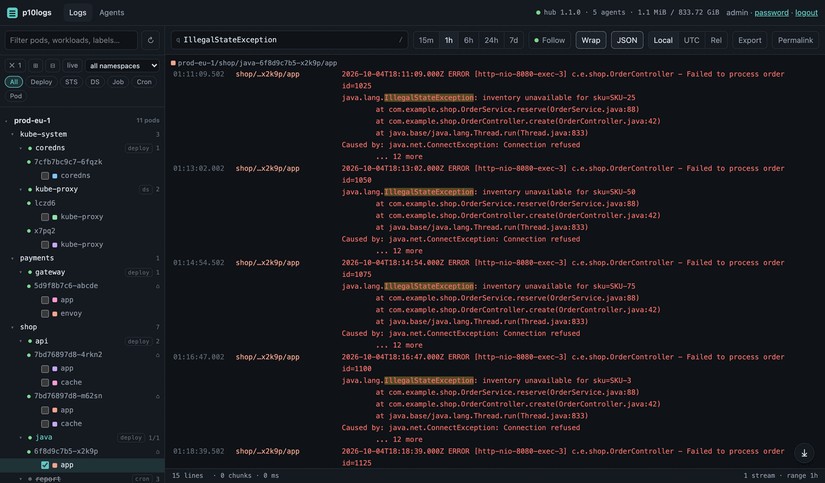
- UI nhúng sẵn trong binary Hub: Cây điều hướng
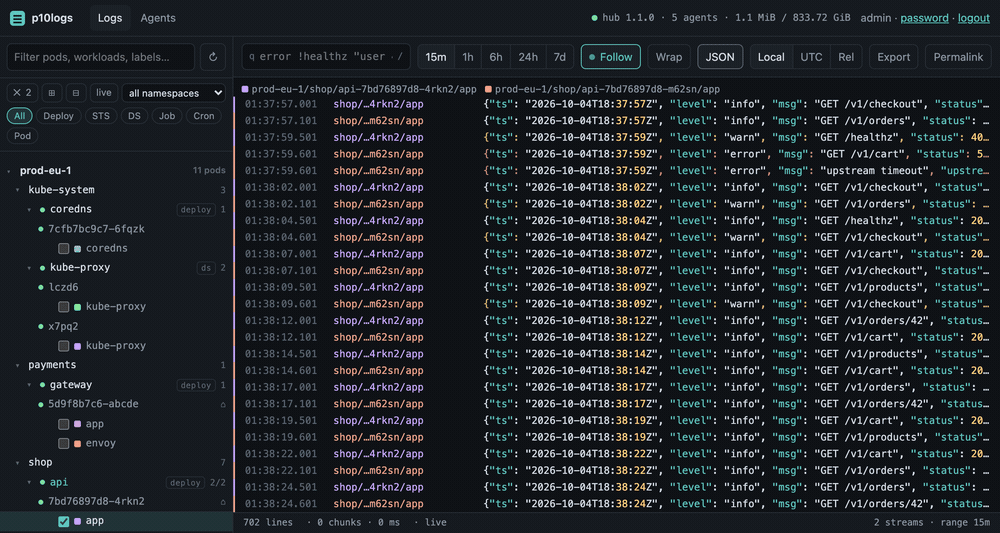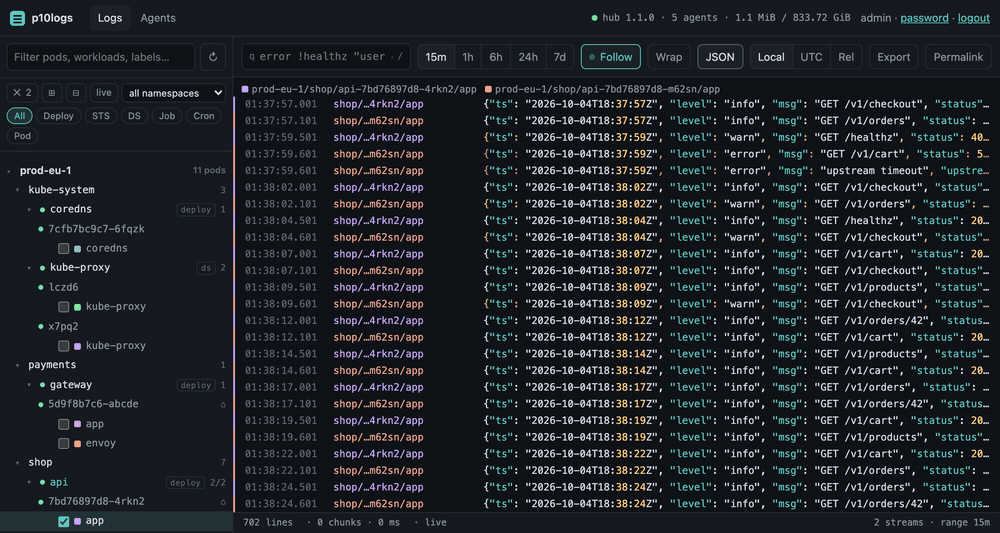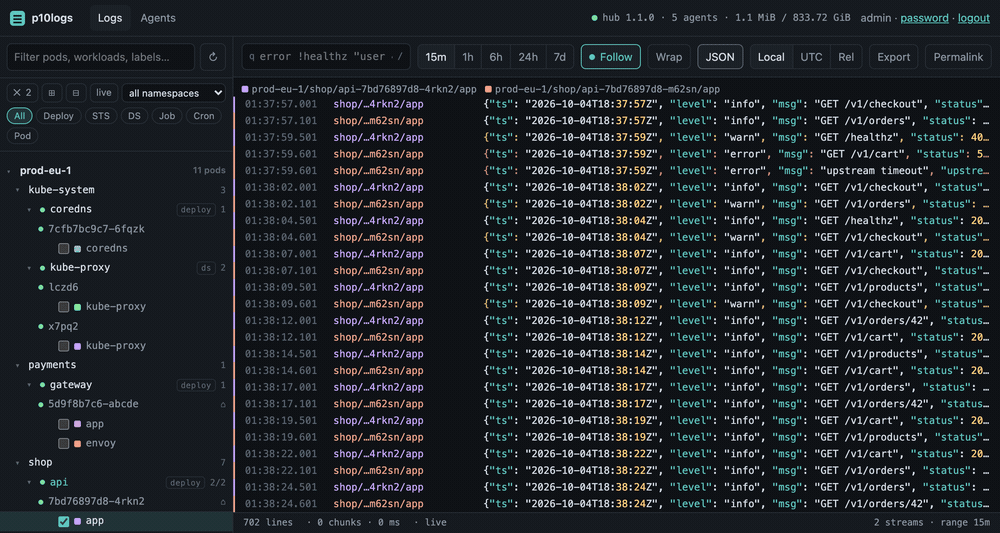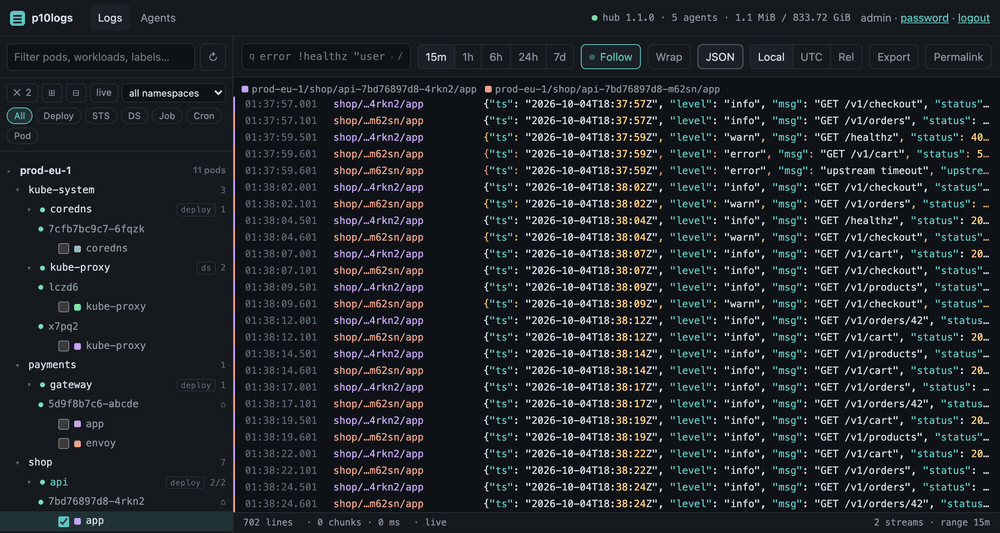
cluster → namespace → pod → container, cho phép tail nhiều pod xen kẽ theo timeline thực, có rate-limit server-side, vạch kẻ đánh dấu mốc restart, filter kiểu grep (word,!word,"phrase",/regex/,key=value). - Auth & Multi-cluster out-of-the-box: Mọi thứ nằm trong 1 Helm chart. Cluster phụ chỉ cần cài Agent, push log về Hub trung tâm qua HTTPS bằng token riêng. Đã tối ưu cho cluster nằm sau NAT/CGNAT vì chỉ cần kết nối outbound (egress).
Benchmark & Current State
- Benchmark (laptop): Push 10k dòng/s trên 50 pod liên tục → Agent xài ~44 MiB, Hub xài ~100 MiB RAM, tỉ lệ nén zstd đạt 7.3× trên disk.
- Idle (kind): Agent ~18 MiB, Hub ~24 MiB.
- Image: Distroless ~16 MB (Agent) / 23 MB (Hub), hỗ trợ cả
amd64vàarm64.
Trạng thái dự án: v1.1 (Data format và /api/v1 đã freeze từ v1.0). Đã pass toàn bộ e2e test trên kind (1-node, 3-node hub-spoke, test log rotation, kill -9 hub để test spool/drain, upgrade Helm bảo toàn data) và đang chạy thực tế trên cluster k3s 3 node của mình.
Tuy nhiên, mình chưa test trên các môi trường production quá lớn.
helm install p10logs oci://ghcr.io/p10node/charts/p10logs \
  -n p10logs --create-namespace --set global.clusterName=dev

kubectl label ns p10logs pod-security.kubernetes.io/enforce=privileged --overwrite
kubectl -n p10logs port-forward svc/p10logs-hub 8080:8080
- Demo live: https://demo-p10logs.p10node.org (
admin/BqJDmpsGRJE85Z0cULFOeoRP) - Architecture Spec & Failure Mode Table: p10logs/docs/ARCHITECTURE.md
Nhờ anh em Dev/DevOps góp ý
Mình đang cần feedback thực tế từ những người trực tiếp vận hành cluster:
- HostPath & Policy: Agent cần mount
hostPath(/var/log/pods) nên namespace bắt buộc phải set Policyprivileged. Mức độ này có phải là dealbreaker trong môi trường SecOps/Production của bên bạn không? - Single Replica Hub: Hub thiết kế 1 replica chạy với PVC để giữ tối giản. Với nhu cầu xem log/debug, việc thiếu HA ở Hub có phải vấn đề lớn không?
- Query Experience: Hiện p10logs chỉ hỗ trợ filter kiểu grep/regex cơ bản. Nếu chuyển từ Loki/VictoriaLogs sang, tính năng query nào bạn cảm thấy thiếu thốn nhất?
Mọi gạch đá hay góp ý về mặt kiến trúc đều rất hoan nghênh.
All rights reserved
