

Mình làm radar công nghệ tự so sánh với stack của bạn, mọi nhận định đều có nguồn uy tín
Demo: https://huynguyenvietwork.github.io/StackScout/ · Mã nguồn (MIT): https://github.com/huynguyenvietwork/StackScout
1. Vấn đề: theo kịp công nghệ đã thành việc bán thời gian
Tuần nào cũng có model AI mới, thư viện mới, bản release mới, và vài bảng benchmark nói ngược nhau. Newsletter thì liệt kê mọi thứ, nên đọc xong mình vẫn phải tự hỏi: cái này có liên quan tới stack mình không, và nó hơn cái mình đang dùng ở đâu?
StackScout bắt đầu từ chính stack của bạn và trả lời đúng câu hỏi đó cho từng tin.
2. Cách hoạt động
- Hồ sơ: bạn gõ những gì đang dùng, sai chính tả cũng được ("c#, entity framwork, postgres, k8s"). AI chuẩn hoá tên và cấp độ, bạn xác nhận rồi mới lưu.
- Thu thập: mỗi tuần đọc khoảng 60 nguồn: blog chính chủ của Anthropic, OpenAI, Google DeepMind, Hugging Face…, release feed của chính các công nghệ bạn dùng, và tuỳ chọn thêm Hacker News, GitHub trending.
- Phân loại bằng AI theo một bộ danh mục cố định, rồi ghép bằng Python thuần:
| Trường hợp | Bạn nhận được |
|---|---|
| Bản mới của công cụ bạn đang dùng | Một dòng changelog ngắn |
| Cùng loại, cùng hệ sinh thái | Tự so sánh với công cụ của bạn |
| Cùng loại, khác hệ sinh thái | Ghi chú tham khảo |
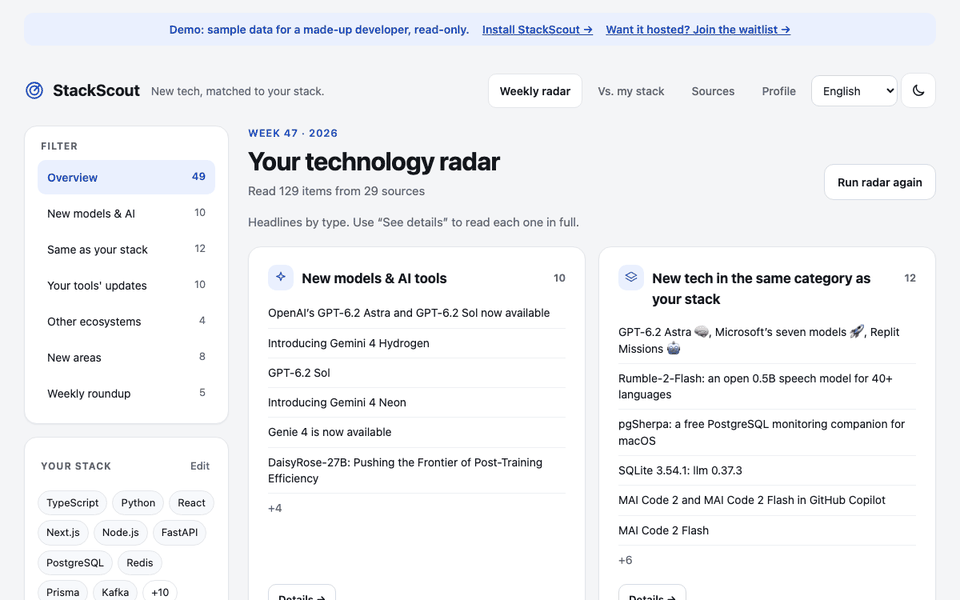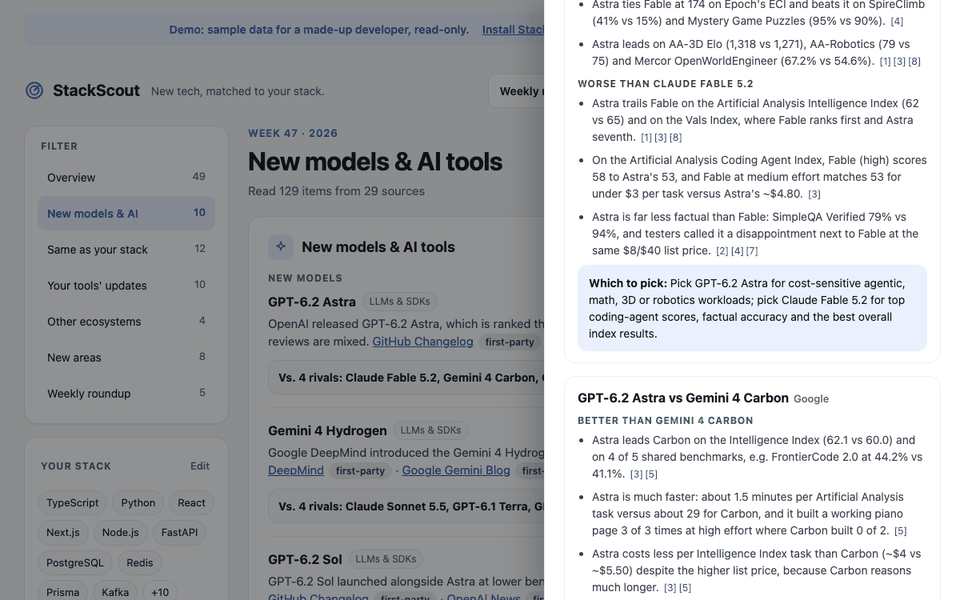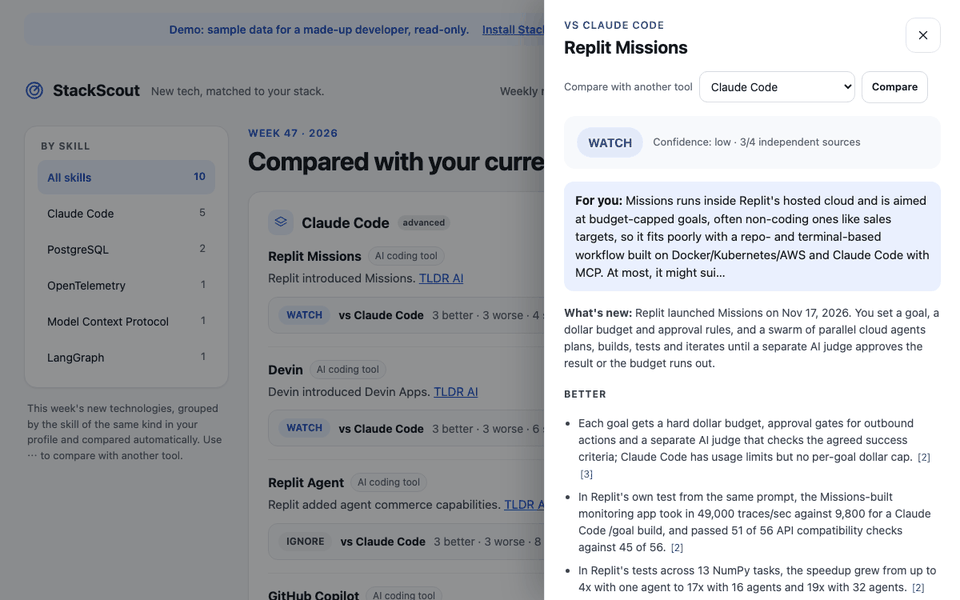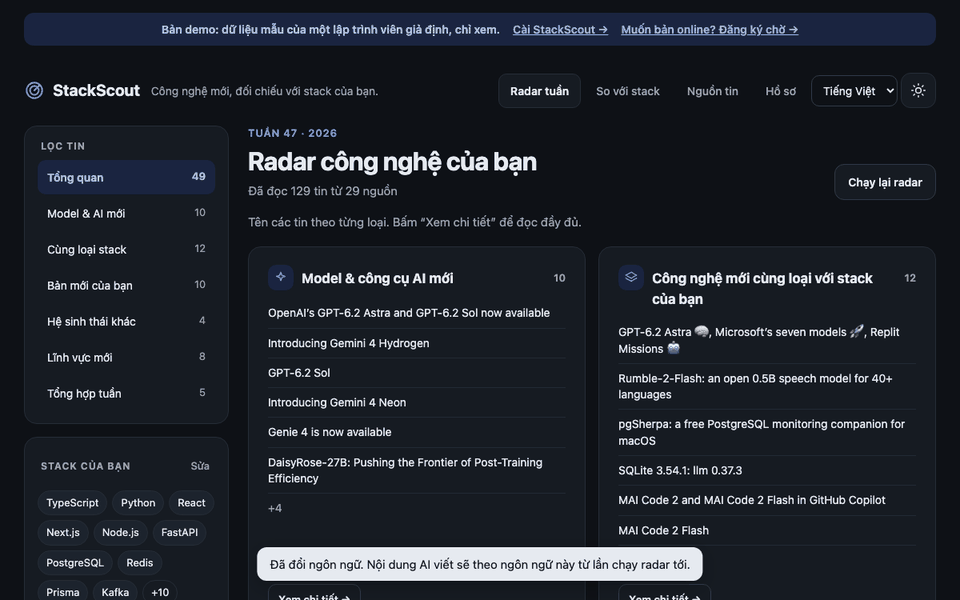
| Model hoặc công cụ AI mới | So với 3–5 đối thủ mạnh nhất |
| Loại bạn chưa dùng | "Đáng để xem" |
- So sánh bằng AI có web search, rồi gửi bản tin qua Telegram, Email, Slack, Discord hoặc webhook, theo ngày, tuần hoặc tháng.
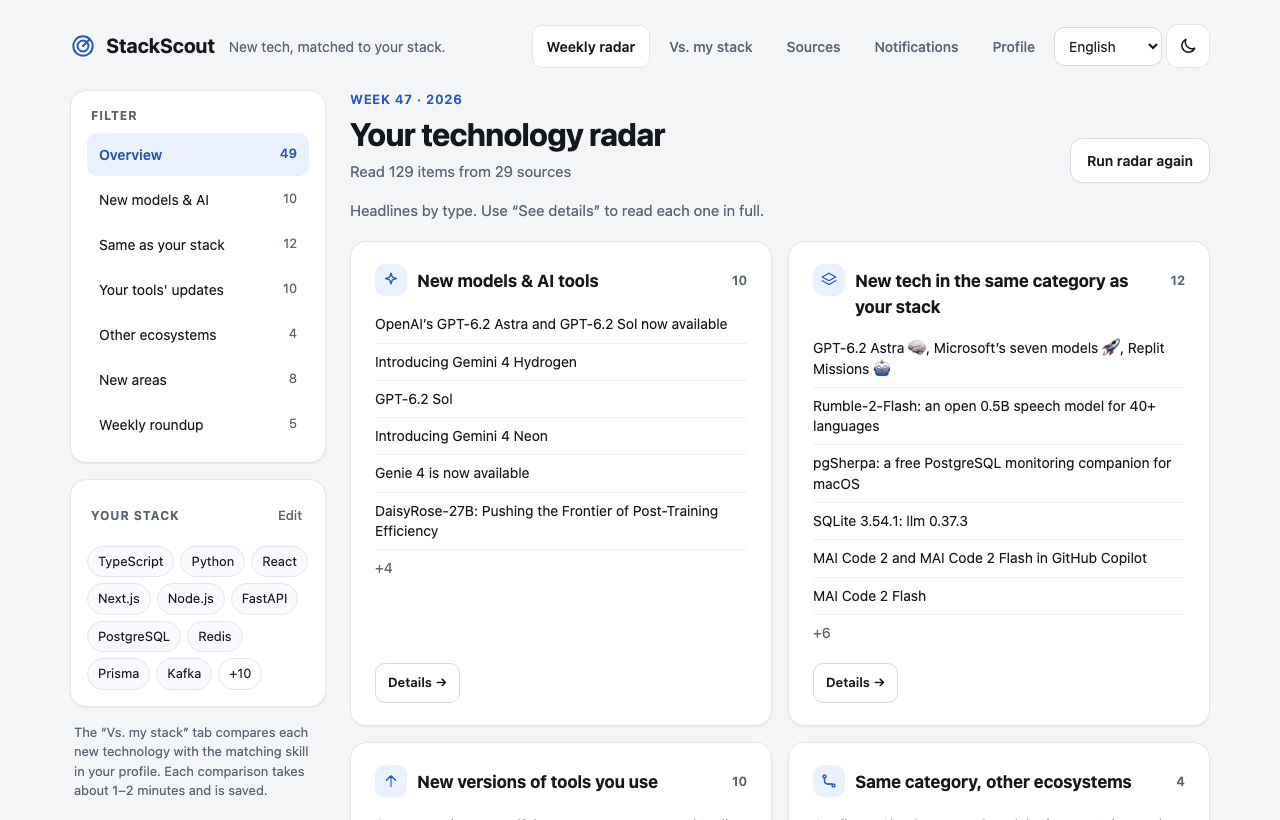
Mỗi so sánh có kết luận nên chuyển / thử nghiệm / theo dõi / bỏ qua, kèm số liệu đặt cạnh nhau, ưu nhược điểm, độ khó khi chuyển đổi và danh sách nguồn.
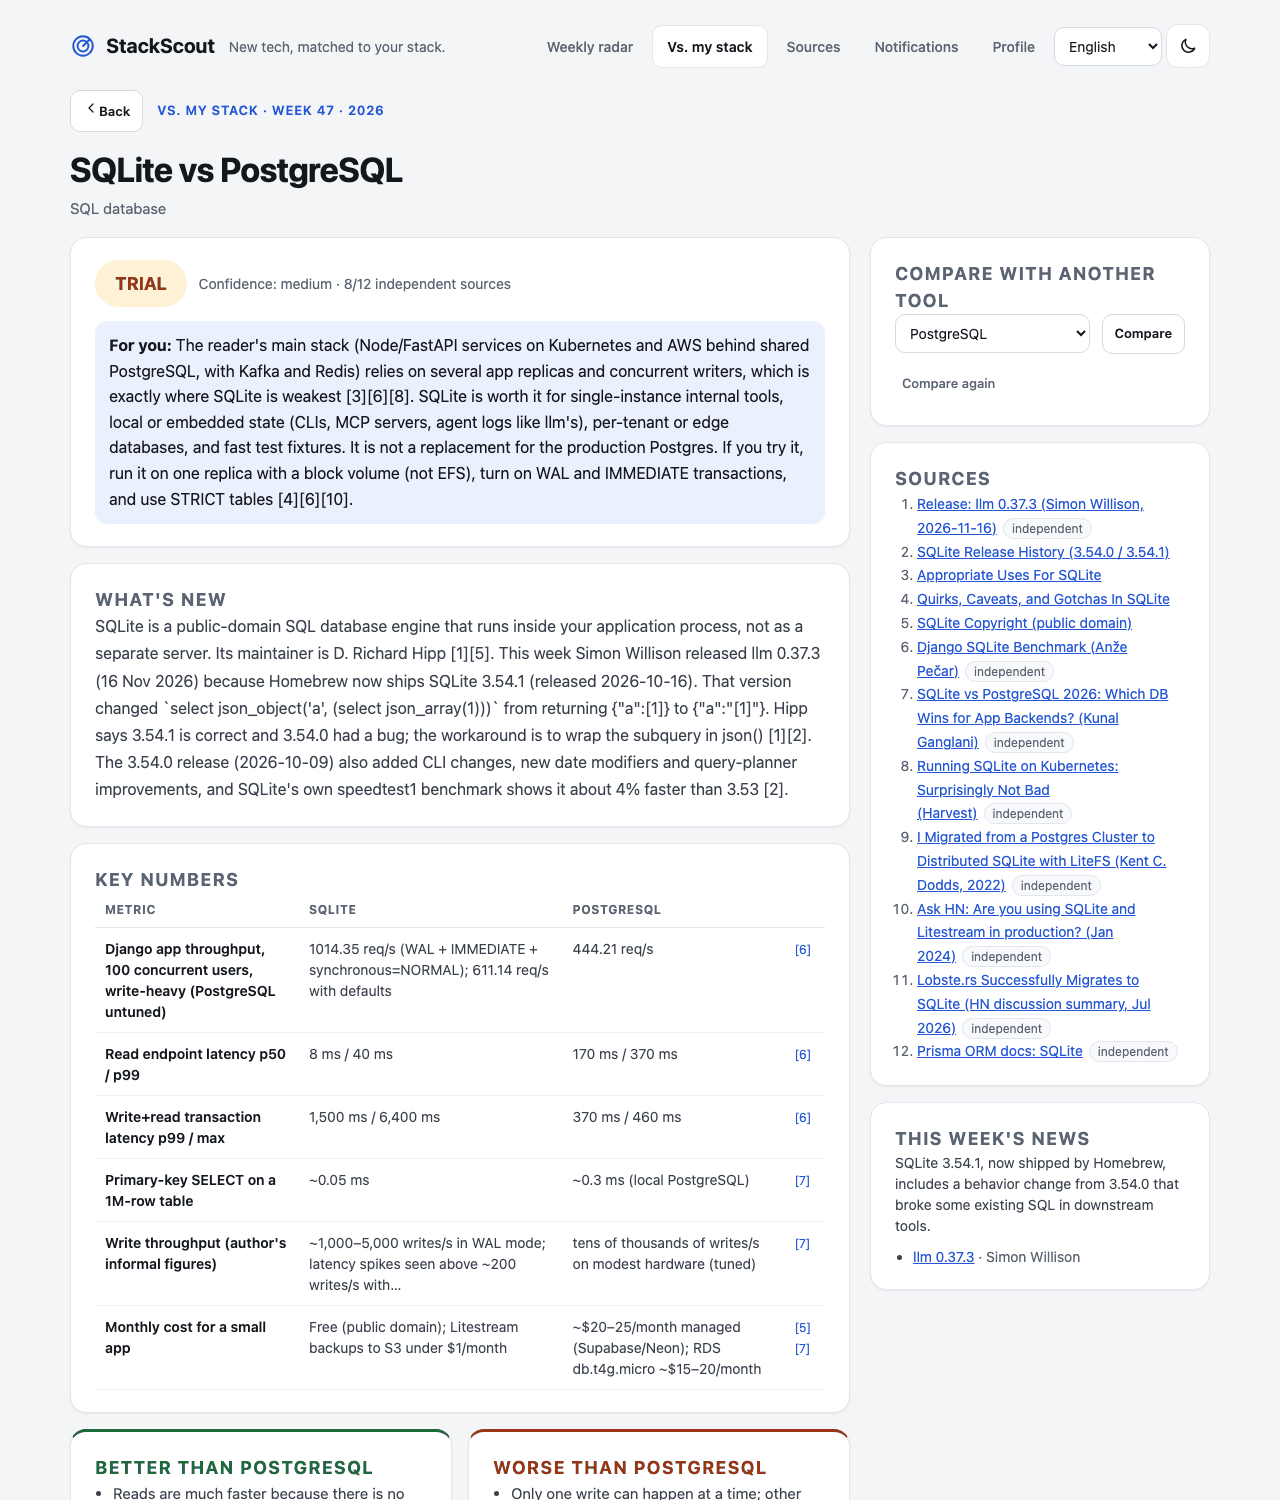
Model AI mới thì được so với các đối thủ mạnh nhất về benchmark, giá và context window:
3. Phần mình thích nhất: luật về nguồn được ép bằng code
AI rất giỏi viết những câu nghe có vẻ đúng. Vì vậy StackScout không để AI tự quyết, mà kiểm tra lại bằng code sau mỗi lần so sánh:
- Nhận định nào không có link hợp lệ thì bị bỏ.
- Dưới 2 nguồn thì ghi "chưa đủ dữ liệu" thay vì đoán.
- Ưu tiên benchmark độc lập và gắn nhãn rõ; nếu chỉ có nguồn của chính hãng thì độ tin cậy bị hạ.
4. Quyền riêng tư
- Hồ sơ chỉ lưu tên công nghệ và cấp độ. Tên dự án, repo, mục đích sử dụng hay thông tin công ty đều bị loại khi lưu và khi import.
- URL, email, IP, hostname và chuỗi trông giống token đều bị lọc khỏi văn bản tự do.
- Hồ sơ của bạn không bao giờ bị đưa vào câu truy vấn tìm kiếm.
- Token và mật khẩu chỉ nằm trên máy bạn (file chỉ chủ sở hữu đọc được) và không bao giờ được trả ngược ra trình duyệt.
5. Cài đặt
Cần API key Anthropic hoặc Claude Code CLI đã đăng nhập.
git clone https://github.com/huynguyenvietwork/StackScout && cd StackScout
cp .env.example .env          # điền ANTHROPIC_API_KEY
docker compose up -d          # mở http://127.0.0.1:8000
Không dùng git thì tải bản mới nhất, giải nén rồi chạy các lệnh trên. Tạo hồ sơ mất khoảng 2 phút; chạy radar lần đầu mất 2–3 phút.
Hiện tại StackScout thiết kế cho một người tự host: chạy ở 127.0.0.1, chưa có đăng nhập.
6. Hướng phát triển
Dự án còn sơ khai, mình rất cần góp ý về nguồn tin, chất lượng so sánh và ngôn ngữ (hiện có tiếng Việt, Anh, Trung, Nhật, Hàn).
- ⭐ Thấy hữu ích thì cho mình 1 sao: https://github.com/huynguyenvietwork/StackScout
- 🐛 Báo lỗi, đề xuất: https://github.com/huynguyenvietwork/StackScout/issues
- ☁️ Muốn dùng bản hosted (không cần cài, không cần API key)? Đăng ký tại đây, số lượng đăng ký sẽ quyết định mình có làm hay không: https://github.com/huynguyenvietwork/StackScout/issues/new?template=hosted_waitlist.yml
Cảm ơn mọi người đã đọc!
All rights reserved
