

GPT-6.2 Astra rẻ hơn GPT-6 Astra, nhưng có nên đổi model trong workflow?
Một bản nâng cấp model thường được tóm gọn bằng vài con số benchmark. Với người duy trì workflow, câu hỏi thực tế khó hơn: nếu thay GPT-6 Astra bằng GPT-6.2 Astra, phần nào của công việc có khả năng tốt lên, chi phí thay đổi ra sao, và lỗi nào vẫn có thể xuất hiện ở đầu ra cuối cùng?
OpenAI công bố GPT-6.2 Astra ngày 17/11/2026. Tài liệu công khai tính đến 18/11 cho thấy điểm số tăng ở một số bài đánh giá chuyên môn, agent và khoa học; đơn giá API tiêu chuẩn cũng giảm. Tuy nhiên, một bài kiểm tra phân tích dữ liệu độc lập ghi nhận model mới trả lời đúng ít câu hơn model cũ dù tốn ít tiền hơn. Vì vậy, tôi sẽ đọc các số liệu theo từng loại nhiệm vụ thay vì gộp mọi thứ thành một nhận xét “phiên bản mới mạnh hơn”. Đây là phần đối chiếu tài liệu công khai, không phải kết quả chạy benchmark mới của riêng bài viết.
Trước khi đổi GPT-6 Astra: phân biệt nâng cấp năng lực và thay đổi thông số
Nếu hệ thống đang dùng GPT-6 Astra để xử lý tài liệu dài, gọi công cụ hoặc tạo nội dung nhiều bước, GPT-6.2 Astra không phải một loại model hoàn toàn khác. Hai phiên bản đều có cửa sổ ngữ cảnh 1.050.000 token, đầu ra tối đa 128.000 token, nhận văn bản và hình ảnh rồi xuất văn bản. Chế độ Fast cũng đã có ở phiên bản trước. Tài liệu của phiên bản mới có liệt kê Ultrafast, nhưng chỉ dựa vào đó không thể kết luận đây là tính năng được giới thiệu lần đầu cùng bản 6.2.
Điểm này quan trọng khi lập kế hoạch thay model. Nếu workflow gặp vấn đề vì thiếu ngữ cảnh, không thể đưa ảnh vào đầu vào hoặc giới hạn đầu ra quá thấp, bảng thông số hiện có không cho thấy 6.2 tự động giải quyết được các vấn đề đó. Lý do đáng kiểm tra phiên bản mới nằm ở chất lượng trên một số loại nhiệm vụ và mức phí mới. Cần tách chuyện “model có tính năng này” khỏi chuyện “model làm cùng công việc tốt hơn”.
Về giá API tiêu chuẩn, tài liệu OpenAI ghi các mức sau, tính theo một triệu token:
| Thành phần chi phí | GPT-6 Astra | GPT-6.2 Astra | Thay đổi đơn giá |
|---|---|---|---|
| Token đầu vào | $10 | $8 | Giảm 20% |
| Token đầu vào được cache | $1 | $0,40 | Giảm 60% |
| Token đầu ra | $50 | $40 | Giảm 20% |
Đơn giá thấp hơn là thay đổi rõ ràng nhất để đưa vào dự toán, nhưng không nên ghi thẳng “mỗi job rẻ hơn 20%”. Một job có prompt dài và câu trả lời ngắn sẽ có cơ cấu token khác job sinh báo cáo dài. Tỷ lệ cache thực tế cũng có thể thay đổi theo cách tổ chức yêu cầu. Yêu cầu vượt 272.000 token đầu vào và các lựa chọn xử lý Fast, Ultrafast có quy tắc tính giá riêng. Muốn ước tính tổng phí, phải bắt đầu từ số token đầu vào, phần cache, đầu ra và chế độ xử lý của chính workflow đó.
Nếu cần đọc thêm các bài cập nhật model, blog Crazyrouter bằng tiếng Trung là một điểm tham khảo. Việc có danh mục model hay trang cập nhật không thay thế bước kiểm tra kết quả trên nhiệm vụ cụ thể.
GPT-6.2 Astra tăng điểm ở đâu theo số liệu của OpenAI?
Ba kết quả chính thức thường được nhắc cùng nhau, nhưng chúng đo ba loại công việc khác nhau:
| Bộ đánh giá | Kết quả GPT-6.2 Astra so với GPT-6 Astra | Cần hiểu đúng phạm vi |
|---|---|---|
| GDPval v2 | Cao hơn 6,2 điểm phần trăm; ít hơn 22% token đầu ra | Dự án chuyên môn dài hạn trong điều kiện đánh giá của OpenAI |
| Agents’ Last Exam | Cao hơn 5,2 điểm | Tác vụ agent nhiều bước theo đề và cách chấm của bộ đánh giá |
| Terminal-Bench-Science 0.1 | Cao hơn 9 điểm | Công việc khoa học trong môi trường terminal của bài kiểm tra |
GDPval v2 bao gồm những dự án thuộc các lĩnh vực như tư vấn, tài chính và thiết kế. Hai con số của bộ này nên được đọc cùng nhau: model mới đạt điểm cao hơn trong khi tạo ít token đầu ra hơn. Điều đó có thể hấp dẫn với công việc tạo tài liệu, nơi cả chất lượng lẫn lượng nội dung đều ảnh hưởng đến thời gian đọc và chi phí. Tuy nhiên, ít hơn 22% token là kết quả trong GDPval v2, không phải mức tiết kiệm cố định của mọi báo cáo. Nếu một câu trả lời ngắn bỏ mất điều kiện quan trọng trong yêu cầu, đó không phải một bản giao việc tốt hơn.
Hai benchmark còn lại cho thấy khả năng tiến bộ với tác vụ nhiều bước và khoa học. Nhưng điểm Agents’ Last Exam không trả lời trực tiếp câu hỏi một agent có chạy hết quy trình kỹ thuật nhiều giờ hay không. Tương tự, điểm của Terminal-Bench-Science không cho biết model sẽ đúng với mọi yêu cầu nghiên cứu. Benchmark chỉ là phép đo ở điều kiện xác định; một pipeline thực tế còn có lỗi công cụ, yêu cầu thay đổi và bước nghiệm thu đầu ra.
Với developer, cách dùng hợp lý là đối chiếu loại nhiệm vụ của mình với loại nhiệm vụ benchmark đang đo. Nếu ứng dụng chủ yếu tạo tài liệu chuyên môn, GDPval v2 có liên quan. Nếu ứng dụng xử lý chuỗi hành động có phụ thuộc, Agents’ Last Exam đáng đọc. Nếu ứng dụng không có các đặc điểm đó, mức tăng điểm không thể tự động biến thành mức tăng chất lượng trong sản phẩm.
Hai nguồn bên ngoài cho hai câu chuyện khác nhau
Vals Science Index là một góc nhìn bổ sung cho công việc khoa học. Bảng công khai ghi độ chính xác 68,44% ± 2,13 với GPT-6.2 Astra, so với 65,09% ± 2,26 của GPT-6 Astra. Chi phí trung bình mỗi câu lần lượt là $4,76 và $8,03; thời gian là 22 phút 15 giây và 40 phút 37 giây.
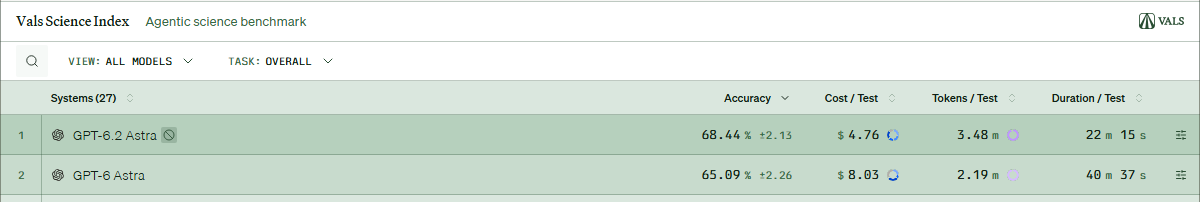
Trong điều kiện của Vals, model mới có ước lượng điểm về độ chính xác cao hơn, đồng thời chi phí và thời gian thấp hơn. Tuy nhiên, hai con số độ chính xác đều đi kèm khoảng sai số. Chênh lệch 3,35 điểm phần trăm giữa hai ước lượng không đủ để tuyên bố model mới chắc chắn thắng trong mọi bài toán khoa học. Giá và thời gian trên bảng cũng là số của bài đánh giá, không phải giá cố định hay độ trễ chung cho mọi request.
Một nguồn khác lại làm rõ giới hạn của câu “bản mới luôn đúng hơn”. Trong bài kiểm tra phân tích dữ liệu của Plotly, ở một lượt chạy gồm 43 câu, GPT-6.2 Astra trả lời đúng 41 câu, GPT-6 Astra đúng 43 câu. Hai câu model mới bỏ lỡ nằm trong nhóm “hidden needles”, tức thông tin cần tìm có trong dữ liệu nhưng không dễ nhận ra. Chi phí cả lượt là $4,11 với model mới so với $19,97 với model cũ.
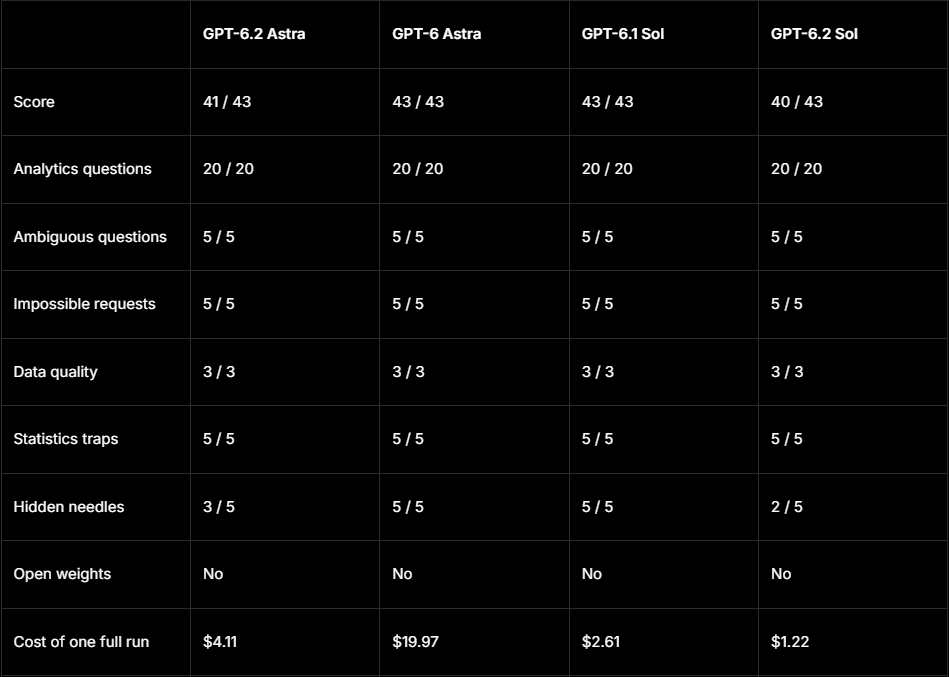
Ở đây cần giữ nguyên cả hai vế: GPT-6.2 Astra rẻ hơn trong lượt chạy được công bố, nhưng trả lời đúng ít hơn hai câu. Đây không phải bằng chứng model mới kém hơn trên toàn bộ tác vụ phân tích dữ liệu. Plotly cũng lưu ý rằng số câu đúng có thể dao động giữa các lần chạy. Ngược lại, không thể dùng kết quả Vals để xóa đi hai câu sai này, vì Vals và Plotly kiểm tra hai công việc khác nhau.
Nếu sản phẩm của bạn phải tìm một điều khoản hiếm trong nhiều trang tài liệu, loại lỗi “hidden needles” là điều nên chú ý. Nếu nhiệm vụ gần với khoa học nhiều bước, dữ liệu của Vals lại mang tính tham khảo hơn. Trước khi gộp điểm, hãy xác định chính xác dữ liệu đầu vào, yêu cầu đầu ra và lỗi nào gây hậu quả lớn nhất cho người dùng của bạn.
Phản hồi sớm trên X nói gì về đoạn cuối của workflow?
Benchmark có điểm kết thúc rõ ràng. Một workflow thực tế thường còn bước tiếp theo: sửa phần bị thiếu, tạo artifact, phản hồi review, hoặc kiểm tra xem agent có dừng quá sớm hay không. Vì thế, trải nghiệm của người dùng khác có thể chỉ ra câu hỏi nên kiểm tra, dù không thể dùng làm tỷ lệ lỗi chung.
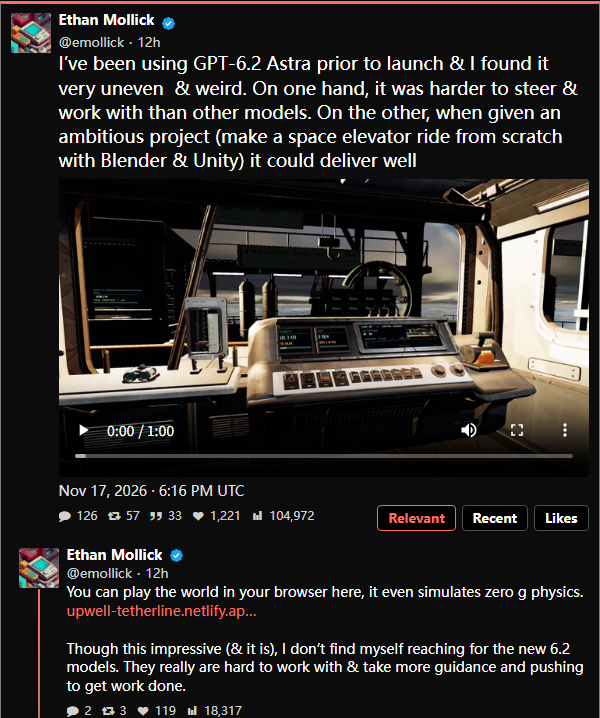
Ethan Mollick mô tả trải nghiệm ban đầu khá trái chiều. Có lúc GPT-6.2 Astra khó điều hướng hơn, nhưng nó cũng thực hiện được dự án tạo trải nghiệm thang máy không gian bằng Blender và Unity. Trong phần tiếp theo, ông vẫn nhấn mạnh rằng cần hướng dẫn nhiều hơn để model tiếp tục hoàn thành công việc. Một demo ấn tượng và một quy trình cần người theo sát có thể cùng tồn tại.
Dan Shipper và nhóm của ông nêu các quan sát ở ba loại việc: văn bản đôi khi quá ngắn để giải thích đầy đủ, tác vụ code từ đầu đến cuối có thể dừng sớm, còn thiết kế mặc định có điểm hay nhưng ít biến hóa. Đây là kinh nghiệm ban đầu của một nhóm người dùng, không phải phép đo chứng minh mọi agent đều dừng sớm hoặc phiên bản mới viết code kém hơn phiên bản trước.
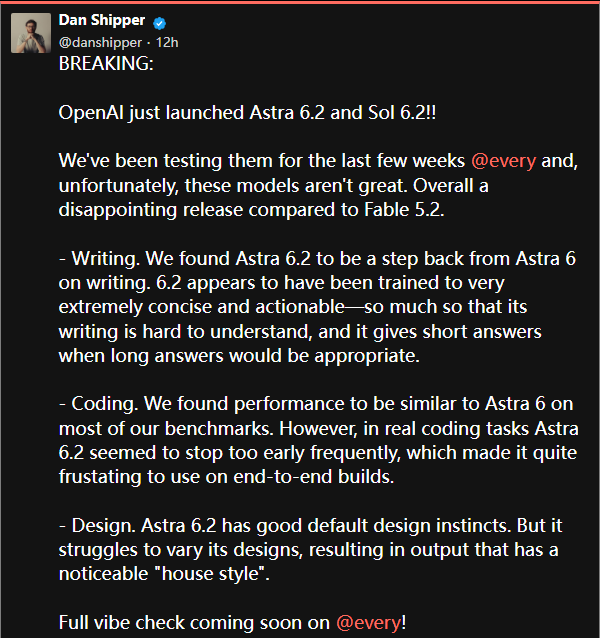
Những nhận xét này hữu ích khi đọc đúng vai trò của chúng. Chúng không thay thế số liệu chính thức. Chúng gợi ra những tiêu chí benchmark ngắn thường không thể bao quát: model có giữ toàn bộ ràng buộc trong nhiều bước không, có tiếp tục khi gặp trở ngại không, và sản phẩm cuối có đủ để người khác nghiệm thu không.
Một bảng quyết định trước khi thay model
Không cần biến toàn bộ ứng dụng sang phiên bản mới chỉ vì một con số tổng hợp. Hãy nhìn vào mục tiêu cụ thể của từng workflow:
| Loại công việc | Dữ liệu công khai liên quan nhất | Câu hỏi cần tự kiểm tra |
|---|---|---|
| Tài liệu chuyên môn dài, yêu cầu đúng biểu mẫu | GDPval v2 | Đầu ra có đủ mục bắt buộc, dẫn chứng và ngoại lệ không? |
| Nghiên cứu hoặc giải quyết vấn đề khoa học nhiều bước | Terminal-Bench-Science và Vals | Kết luận, bước lập luận và thời gian hoàn thành có chấp nhận được không? |
| Agent xử lý chuỗi việc kỹ thuật | Agents’ Last Exam và phản hồi sớm trên X | Agent có dừng giữa chừng, đổi mục tiêu hoặc bỏ bước nghiệm thu không? |
| Tìm thông tin kín trong dữ liệu dài | Bài kiểm tra Plotly | Những chi tiết quyết định có bị bỏ sót không? |
| Công việc nhạy với chi phí | Bảng giá API và cơ cấu token thực tế | Giá của toàn bộ tác vụ được chấp nhận, kể cả lần sửa, là bao nhiêu? |
Bảng này không phải một bảng xếp hạng model. Nó buộc mỗi quyết định gắn với bằng chứng phù hợp. Trường hợp lỗi nhỏ nhưng hậu quả lớn, tính đúng phải được xem trước chênh lệch phí. Trường hợp đầu ra ngắn có thể dễ dàng kiểm tra, đơn giá thấp hơn có thể có ý nghĩa hơn. Cùng một cặp model nhưng tiêu chí nghiệm thu khác nhau sẽ dẫn đến lựa chọn khác nhau.
Kết luận
Tính đến 18/11/2026, phần chắc chắn nhất của bản nâng cấp là GPT-6.2 Astra đạt điểm cao hơn ở một số benchmark chuyên môn, agent và khoa học được nêu tên; đơn giá API tiêu chuẩn cũng thấp hơn GPT-6 Astra. Vals bổ sung một kết quả thuận lợi về độ chính xác, thời gian và chi phí cho bài khoa học. Plotly giữ lại một phản ví dụ quan trọng: trong một lượt 43 câu phân tích dữ liệu, phiên bản mới rẻ hơn nhưng bỏ lỡ hai câu mà phiên bản cũ trả lời đúng.
Vì vậy, nếu workflow của bạn giống các nhiệm vụ chuyên môn hay khoa học được đo, GPT-6.2 Astra đáng được ưu tiên xem xét. Nếu sản phẩm phụ thuộc vào việc tìm chi tiết khó thấy hoặc để agent tự đi hết quy trình dài, hãy đánh giá trực tiếp những điểm đó khi chọn model. Phiên bản mới là một tín hiệu để bắt đầu so sánh; kết quả của nhiệm vụ mới là cơ sở để kết thúc quyết định.
Nguồn dữ liệu
- OpenAI, “Introducing GPT-6.2 Astra and Sol”, 17/11/2026.
- Tài liệu API OpenAI, “GPT-6 Astra Model” và “GPT-6.2 Astra Model”, truy cập 18/11/2026.
- Vals AI, “Vals Science Index”, truy cập 18/11/2026.
- Plotly, “GPT-6.2 Astra: Plotly Data Analytics Bench”, truy cập 18/11/2026.
- Bài đăng gốc trên X của Ethan Mollick và Dan Shipper, 17/11/2026.
All rights reserved
