

Để website được ChatGPT tìm thấy: robots.txt, JSON-LD và llms.txt theo đúng tài liệu chính thức
"Làm sao để website xuất hiện khi người dùng hỏi ChatGPT?" Câu hỏi này đang thay dần câu "làm sao lên top Google". Trên mạng có rất nhiều mẹo: thêm llms.txt, thêm schema đặc biệt, "câu lệnh bí mật"… Bài này chỉ dùng những gì OpenAI, Google và Microsoft đã công bố, kèm code thật từ website đặt phòng mà nhóm mình làm cho homestay, villa.
Bài gốc viết cho chủ nhà (tiếng Việt): Làm sao để homestay được ChatGPT gợi ý khi khách hỏi AI. Các nguồn được kiểm tra ngày 2/11/2026. Bài này là phiên bản kỹ thuật cho lập trình viên.
1. Các nền tảng thật sự nói gì
| Nền tảng | Điều họ nói là cần | Có cần tệp hoặc mã riêng cho AI? |
|---|---|---|
| Google AI Overviews, AI Mode | Trang được lập chỉ mục và đủ điều kiện hiển thị đoạn trích | Không. Google ghi "không có yêu cầu kỹ thuật bổ sung" |
| ChatGPT search | Cho phép OAI-SearchBot và dải IP của OpenAI đi qua hosting/CDN |
Không nhắc tới. Vị trí "không được đảm bảo" |
| Microsoft Bing, Copilot | Nội dung mới, có cấu trúc, HTML rõ ràng, thông tin chính không giấu trong tab, PDF hay ảnh | JSON-LD giúp gắn nhãn nội dung |
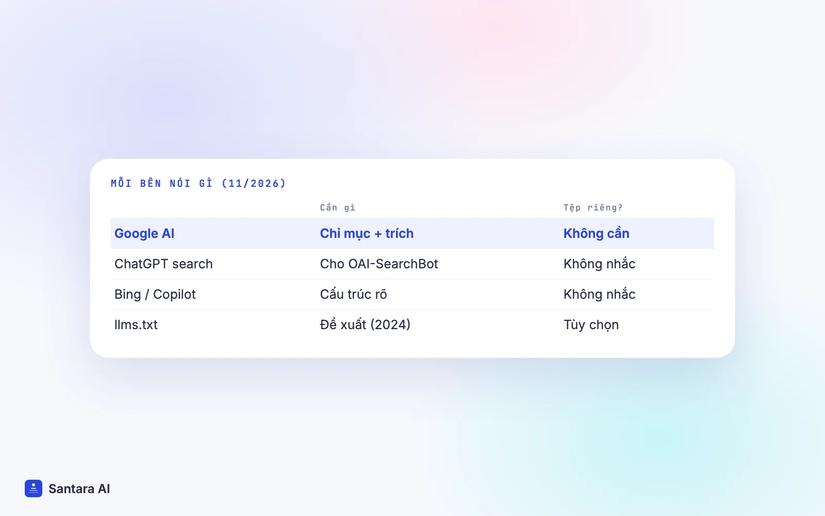
 Mỗi nền tảng nói cần gì, theo những gì họ công bố vào tháng 11/2026.
Điểm chung: không ai đòi mẹo. Họ cần trang mà bot vào được, đọc được, và thông tin viết thẳng bằng chữ. Phần còn lại của bài đi lần lượt từng thứ.
2. robots.txt: phân biệt ba bot của OpenAI
Đây là chỗ hay sai nhất. OpenAI có ba bot với ba mục đích khác nhau:
| User-agent | Dùng để | Chặn thì sao |
|---|---|---|
OAI-SearchBot |
Đưa website vào kết quả tìm kiếm của ChatGPT | Website không xuất hiện trong câu trả lời tìm kiếm của ChatGPT |
GPTBot |
Thu thập nội dung có thể dùng để huấn luyện mô hình | Không ảnh hưởng tìm kiếm |
ChatGPT-User |
Mở trang khi người dùng yêu cầu ChatGPT mở | Không dùng để quyết định nội dung nào xuất hiện |
Nhiều website chặn "bot AI" bằng một danh sách copy trên mạng, chặn luôn OAI-SearchBot, rồi thắc mắc vì sao ChatGPT không bao giờ nhắc tới mình.
Nếu bạn không muốn bị lấy dữ liệu huấn luyện nhưng vẫn muốn xuất hiện trong tìm kiếm:
User-agent: GPTBot
Disallow: /

User-agent: OAI-SearchBot
Allow: /

User-agent: *
Allow: /
Sitemap: https://example.com/sitemap.xml
OpenAI cho biết thay đổi robots.txt mất khoảng 24 giờ để có hiệu lực.
Đừng quên lớp thứ hai: CDN và WAF. robots.txt cho phép mà Cloudflare hay WAF của hosting chặn bot thì cũng như không. OpenAI công bố dải IP của các bot để bạn đưa vào danh sách cho phép.
Website nhiều tenant: robots.txt động
Website đặt phòng của nhóm mình chạy trên subdomain riêng cho từng chủ nhà, nên robots.txt là một route Next.js chứ không phải file tĩnh. Website chưa xuất bản thì chặn hết, đã xuất bản thì cho mọi bot và chỉ tới sitemap:
// app/(booking)/booking-site/[subdomain]/robots.txt/route.ts
export async function GET(_request: Request, { params }: { params: Promise<{ subdomain: string }> }) {
  const { subdomain } = await params;
  const site = await getBookingSiteBySubdomain(subdomain); // null nếu chưa xuất bản

  const body = site
    ? `User-agent: *\nAllow: /\nSitemap: ${bookingSiteOrigin(site)}/sitemap.xml\n`
    : `User-agent: *\nDisallow: /\n`;

  return new Response(body, {
    headers: {
      "Content-Type": "text/plain",
      "Cache-Control": "public, max-age=3600",
    },
  });
}
Chặn website chưa xuất bản là quan trọng: bản nháp với giá sai, ảnh tạm bị lập chỉ mục thì rất khó gỡ khỏi kết quả tìm kiếm, và khó gỡ hơn nữa khỏi câu trả lời của AI.
3. Sitemap: liệt kê đủ, bỏ trang noindex
Sitemap của mỗi website gồm: trang chủ, mọi trang cơ sở và trang phòng, mọi trang hoặc bài viết đã xuất bản, trừ những trang chủ nhà đánh dấu noindex.
Lỗi hay gặp là sitemap có trang mà chính trang đó lại có <meta name="robots" content="noindex">. Bot nhận hai tín hiệu ngược nhau. Hãy sinh sitemap từ cùng một nguồn với cờ noindex để hai thứ không bao giờ lệch nhau.
4. Dữ liệu có cấu trúc: VacationRental và LodgingBusiness
Schema.org định nghĩa VacationRental là loại hình lưu trú cho thuê từng bất động sản trong thời gian ngắn, thuộc nhóm LodgingBusiness. Website của nhóm mình gắn:
LodgingBusinesscho cả website: tên, mô tả, ảnh, email, số điện thoại.VacationRentalcho mỗi trang cơ sở và trang phòng.BlogPostingvàBreadcrumbListcho bài blog.
Hàm sinh JSON-LD cho một trang phòng. Hàm thuần (pure function) nên test được mà không cần render:
export function propertyJsonLdData({ site, property, canonicalUrl }): Record<string, unknown> {
  const p = property.property;
  const content = p.content;
  const price = p.basePrice != null ? Number(p.basePrice) : null;

  return {
    "@context": "https://schema.org",
    "@type": "VacationRental",
    name: content?.listingTitle ?? p.name,
    description: content?.description ? plainDescription(content.description) : site.tagline,
    url: canonicalUrl,
    image: (content?.imageUrls ?? []).slice(0, 8),
    numberOfBedrooms: p.bedrooms ?? undefined,
    occupancy: p.maxGuests != null ? { "@type": "QuantitativeValue", maxValue: p.maxGuests } : undefined,
    address: p.city || p.country
      ? { "@type": "PostalAddress", addressLocality: p.city, addressCountry: p.country }
      : undefined,
    ...(price != null
      ? {
          offers: {
            "@type": "Offer",
            price,
            priceCurrency: p.currency || site.currency,
            availability: "https://schema.org/InStock",
            url: canonicalUrl,
          },
        }
      : {}),
  };
}
Mấy quyết định đáng chú ý:
undefinedthay vìnull.JSON.stringifybỏ qua key có giá trịundefined, nên JSON-LD không có những trường rỗng mà công cụ kiểm tra sẽ cảnh báo.offerschỉ có khi có giá. MộtOfferkhông cópricecòn tệ hơn không cóOffer.- Tối đa 8 ảnh. Đủ cho bot hiểu chỗ ở trông thế nào, không làm HTML phình to.
Cố ý KHÔNG có aggregateRating
Đây là quyết định quan trọng nhất trong hàm này. Điểm đánh giá duy nhất hệ thống có là điểm của Airbnb, lấy từ kênh bán. Nguyên tắc về đoạn trích đánh giá của Google ghi rõ: không đánh dấu điểm đánh giá tổng hợp từ website khác. Làm vậy có thể khiến website của chủ nhà bị Google xử phạt thủ công phần dữ liệu có cấu trúc.
Nên trong code có comment giải thích vì sao không có, để người sau không "tiện tay" thêm vào:
/**
 * No `aggregateRating`, on purpose. The only rating we hold is the channel's (Airbnb's
 * number), and Google's review-snippet guidelines forbid marking up ratings aggregated
 * from other websites. Add it back only when it is computed from reviews collected on
 * the booking site itself.
 */
Hai lưu ý thẳng thắn về schema
- Google nói không cần schema đặc biệt cho tính năng AI. Schema là nhãn giúp máy hiểu, không phải công tắc xếp hạng.
- Kết quả nhiều định dạng (rich result) cho thuê nghỉ dưỡng của Google chỉ dành cho đối tác đã làm việc với Google và có quyền vào Hotel Center. Một website homestay độc lập thêm
VacationRentalsẽ không tự nhiên có rich result đó.
Và mọi thứ đánh dấu phải khớp với nội dung hiển thị trên trang.
5. llms.txt: có nên thêm không?
llms.txt là một đề xuất từ năm 2024: một file Markdown ở thư mục gốc website, chỉ cho công cụ AI các trang quan trọng. Đây là quy ước mới nổi, chưa phải tiêu chuẩn:
- Google nói rõ không cần tệp văn bản cho AI để xuất hiện trong tính năng AI của họ.
- Trang trợ giúp của OpenAI không nhắc tới
llms.txt.
Website đặt phòng của nhóm mình không sinh llms.txt. Thêm thì tốn ít công, nhưng đừng kỳ vọng nó thay đổi gì. Nếu phải chọn giữa viết llms.txt và kiểm tra lại robots.txt có đang chặn OAI-SearchBot không, hãy làm việc thứ hai.
6. Nội dung: viết bằng chữ, nhất quán ở mọi nơi
Phần này ít code nhưng ảnh hưởng nhiều nhất.
Thông tin chính viết bằng HTML thường. Microsoft lưu ý thông tin giấu trong tab, PDF hay ảnh có thể bị bỏ sót. Nội quy, giờ nhận phòng, chỗ đậu xe… nên là chữ trong HTML, không phải ảnh chụp tờ nội quy.
Thông tin giống nhau ở mọi nguồn. AI ghép nhiều nguồn: website, trang Airbnb, Booking.com, hồ sơ Google. Website ghi "4 phòng ngủ", Airbnb ghi "3 phòng ngủ" thì AI phải tự chọn, và người dùng không tin cái nào. Với lập trình viên, cách chắc nhất là sinh mọi thứ từ một nguồn dữ liệu: JSON-LD, trang HTML và dữ liệu đẩy lên các kênh bán đều đọc từ cùng một bản ghi.
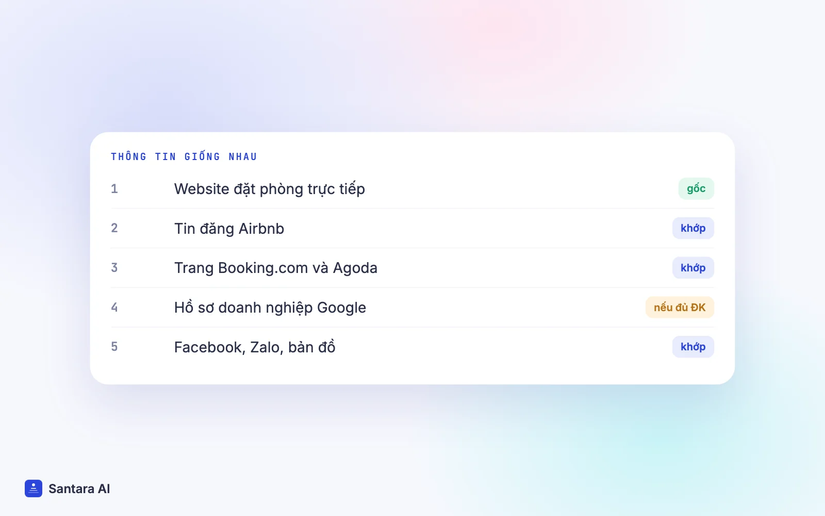
 Giữ cùng tên, địa chỉ và con số trên mọi trang công khai mà AI có thể đọc.
Đo được. Lưu lượng từ AI Overviews và AI Mode nằm trong báo cáo Hiệu suất của Search Console, mục "Web". Không cần công cụ mới.
7. Checklist
- robots.txt cho phép
OAI-SearchBot. ChặnGPTBotlà lựa chọn riêng, không ảnh hưởng tìm kiếm. - CDN/WAF không chặn dải IP của bot tìm kiếm.
- Website hoặc trang chưa xuất bản thì
Disallowhoặcnoindex. - Sitemap sinh từ cùng nguồn với cờ noindex.
- JSON-LD (
LodgingBusiness,VacationRental) khớp nội dung hiển thị, không có trường rỗng. - Không đánh dấu điểm đánh giá lấy từ website khác.
- Thông tin chính là chữ trong HTML, không nằm trong ảnh, PDF hay tab ẩn.
- Mọi nơi hiển thị thông tin đều đọc từ một nguồn dữ liệu.
llms.txt: tùy chọn, đừng kỳ vọng.
Không có cách nào đảm bảo được AI gợi ý. Việc làm được là khiến website dễ đọc và dễ tin với bot, và đó cũng chính là những gì các nền tảng đã viết ra.
Bài gốc (tiếng Việt, viết cho chủ nhà): Làm sao để homestay được ChatGPT gợi ý khi khách hỏi AI. Các bài khác của nhóm ở blog Santara AI.
Bài viết được soạn với sự hỗ trợ của AI, từ bài gốc trên blog Santara AI và mã nguồn của nhóm.
All rights reserved
