

Claude Sonnet 5.5 hay Opus 5.5: nên chọn cái nào khi mới dùng API?
Nếu bạn vừa bắt đầu gọi Claude qua API, câu hỏi đầu tiên thường là: dùng Sonnet 5.5 hay Opus 5.5? Bài này trả lời dựa trên 132 lần gọi API mà tôi đã thực hiện ngày 09/11/2026, trên 22 tác vụ chia làm hai nhóm. Mục tiêu không phải là tìm model "mạnh hơn", mà là giúp bạn hiểu cách chọn cho đúng việc của mình.
Hai model gọi như thế nào
Cả hai model đều dùng giao diện tương thích OpenAI. Địa chỉ gốc là https://api.crazyrouter.com/v1, tên model là claude-sonnet-5-5 và claude-opus-5-5. Trước khi chạy thử, nên kiểm tra tên model có nằm trong danh sách tài khoản của bạn hay không, vì tên viết sai thường không cho thông báo lỗi rõ ràng.
Nếu bạn đang tìm danh sách model khả dụng, có thể xem tại trang model của Crazyrouter.
Kết quả theo nhóm tác vụ
Nhóm đầu gồm các tác vụ quen thuộc: viết một hàm, sửa lỗi, chuyển văn bản thành JSON, phân tích log. Ở nhóm này, hai model đạt điểm ngang nhau và đều trả lời đúng.
Nhóm thứ hai khó hơn: sửa lỗi trên ba file liên quan đến nhau, tính toán mảng hậu tố trong giới hạn thời gian, giới hạn tốc độ kiểu token bucket, và bài toán xếp lịch. Opus đạt điểm tối đa, Sonnet đạt 9,58. Điểm thấp của Sonnet đến từ một lần chạy mà môi trường thiếu thư viện numpy, không phải lỗi của thuật toán.
Điểm khác biệt rõ nhất là tốc độ và độ dài đầu ra. Ở nhóm thứ hai, Sonnet trung bình trả lời trong 11,6 giây với khoảng 1.445 token đầu ra. Opus trung bình 17,6 giây với khoảng 1.843 token. Với người mới, đây là chi phí bạn sẽ thấy ngay khi dùng thật.
Khi nào nên cân nhắc Opus 5.5
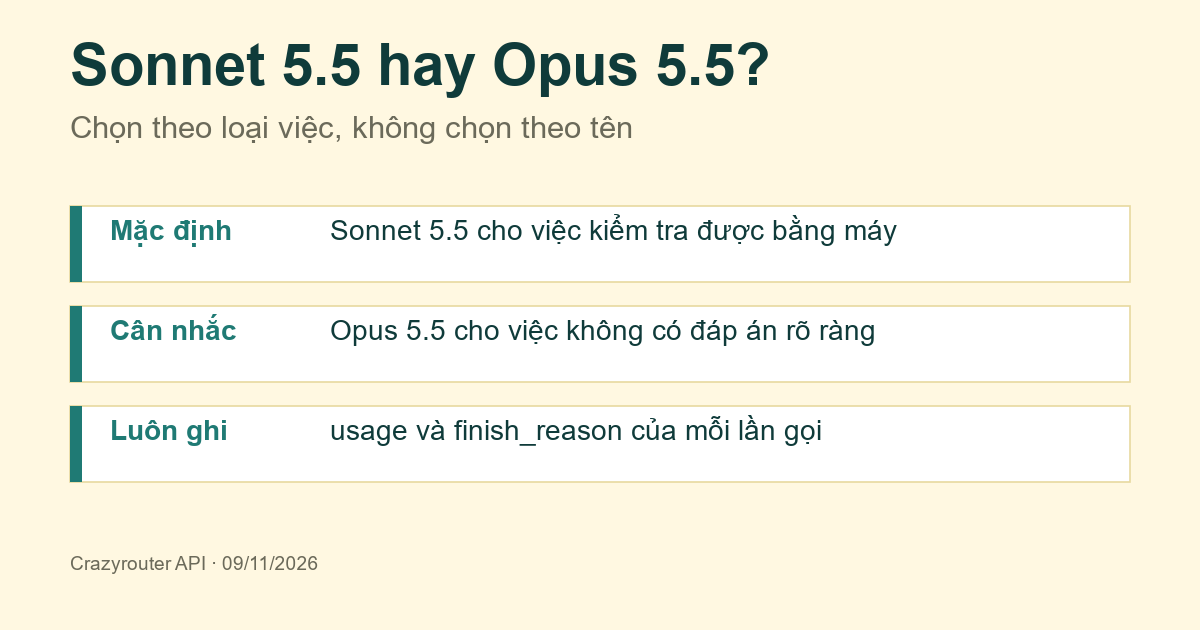
Từ dữ liệu này, mặc định nên chọn Sonnet 5.5 cho các việc có thể kiểm tra bằng máy: code chạy được, JSON đúng định dạng, kết quả có đáp án rõ ràng.
Opus đáng thử hơn khi việc bạn làm không có tiêu chí đúng sai rõ ràng, ví dụ đánh giá một thiết kế hệ thống. Thử nghiệm của tôi không bao phủ loại việc này, nên không có kết luận về chất lượng. Hãy tự chuẩn bị một vài ví dụ thật và tiêu chí chấm trước khi so sánh.
Đọc đúng kết quả của một lần gọi
Một lỗi dễ gặp là chỉ nhìn mã trạng thái HTTP. Trong thử nghiệm, tất cả 132 lần gọi đều trả về 200, nhưng điều đó chỉ cho biết máy chủ đã nhận yêu cầu.
Hai trường nên đọc thêm là finish_reason và usage. Nếu finish_reason là length, câu trả lời đã bị cắt vì giới hạn token. Trường usage cho biết số token đầu vào và đầu ra, là căn cứ để tính chi phí thực tế.
Một trường hợp khác tôi gặp là khi model gọi công cụ nhưng không trả lời câu hỏi bằng văn bản. Cách xử lý là ghi rõ trong prompt rằng cần trả lời người dùng trước, sau đó mới gọi công cụ, rồi kiểm tra nội dung trả về có trống hay không.
Giới hạn của thử nghiệm
Có 22 tác vụ, mỗi tác vụ chạy ba lần. Số lượng này đủ để nhìn thấy xu hướng, nhưng chưa đủ để kết luận cho mọi trường hợp. Tất cả yêu cầu đi qua cùng một cổng tương thích, nên kết quả có thể khác khi gọi trực tiếp đến nhà cung cấp. Giá không được kiểm tra trong bài này; hãy xem trang giá chính thức trước khi tính ngân sách.
Điều quan trọng nhất khi bắt đầu là ghi lại usage và finish_reason cho mọi lần gọi. Có hai trường này, bạn mới biết mình đang trả tiền cho cái gì.
All Rights Reserved
