

Chọn cổng trung chuyển AI API: bốn bài kiểm tra bạn tự chạy được trong mười phút
Chọn cổng trung chuyển AI API: bốn bài kiểm tra bạn tự chạy được trong mười phút
Khi tìm kiếm "API trung chuyển AI", bạn sẽ gặp hàng chục bài "tổng hợp nền tảng tốt nhất 2026". Mở ba bài thì có ba nhà cung cấp khác nhau đứng đầu — vì phần lớn trong số đó là nội dung được trả tiền để đăng.
Nên mình quyết định tự viết script đo thử. Và bài học đầu tiên mình nhận được không phải về nhà cung cấp nào cả — mà là mình suýt kết luận sai vì chính bug trong code của mình.
Bài này ghi lại bốn bài kiểm tra mình đã chạy, kèm những chỗ mình bị kẹt. Toàn bộ số liệu đến từ các request thật thực hiện ngày 14/10/2026.
1. Vấn đề: suýt nữa mình đã đổ lỗi nhầm cho nhà cung cấp
Lần đầu đo TTFT, script của mình trả về chunks = 0. HTTP status là 200, stream rõ ràng vẫn đang chạy, nhưng không đếm được một chunk nào.
Suy nghĩ đầu tiên của mình là: "chắc nhà này không hỗ trợ streaming thật, chỉ gom cả response rồi trả một lượt". Suýt nữa mình viết đúng câu đó vào ghi chú đánh giá.
Hoá ra có hai bug chồng lên nhau, và cả hai đều là của mình:
- Điều kiện lọc dòng SSE mình viết bằng wildcard của PowerShell, mà
[DONE]trong wildcard không phải chuỗi literal — nó là tập ký tự. HttpClientmặc định không tự giải nén, nên stream gzip đọc ra thành byte nén, không khớp dòngdata:nào.
Hai lỗi khác nhau nhưng triệu chứng giống hệt nhau: status 200, đếm được 0. Chi tiết cụ thể mình để ở mục 3.2.
Kể chuyện này trước vì nó dẫn tới điều quan trọng nhất của cả bài: khi đánh giá một cổng trung chuyển, thứ dễ sai nhất không phải là dịch vụ, mà là cách bạn đo nó. Một kết luận sai kiểu này mà đăng lên thì cũng chẳng khác gì mấy bài xếp hạng ở trên.
Còn đây là câu hỏi thật sự đáng đặt ra sau khi đổi sang cổng trung chuyển — câu mà khi gọi thẳng API chính hãng bạn không cần nghĩ tới: làm sao biết model trả lời đúng là model bạn đã yêu cầu?
2. Bối cảnh: cổng trung chuyển là gì và tại sao nó rẻ hơn
Về bản chất
Cổng trung chuyển (API relay / gateway) là nhà cung cấp tổng hợp: nó kết nối tới API chính thức của nhiều hãng, bạn gọi vào nó, nó chuyển tiếp lên trên rồi trả kết quả về. Hầu hết đều dựng theo định dạng tương thích OpenAI, nên bạn chỉ cần đổi base_url và api_key, SDK giữ nguyên.
Nguồn gốc của mức giá rẻ
Phần này quan trọng hơn vẻ ngoài của nó, bởi vì nguồn tiết kiệm đến từ đâu cho bạn biết khả năng dịch vụ biến mất là bao nhiêu. Có đúng hai loại câu trả lời.
Loại gọi tên được nguồn trên. Nhiều model có thể truy cập qua Azure, AWS Bedrock hay Google Vertex AI. Các cloud này có cơ chế giá và thoả thuận sản lượng riêng — đó đơn giản là một công cụ khác với bảng giá công khai của hãng. Cộng thêm mua số lượng lớn, và chi phí thanh toán xuyên biên giới được nền tảng gánh một lần thay vì từng khách hàng tự gánh.
Loại không gọi tên được. Có hai mô hình phổ biến. Một là reverse engineering: lấy giao thức của web client rồi đóng gói lại thành API, giá vốn gần bằng không. Hai là gom tài khoản và chia nhỏ gói thuê bao, điều phối số người dùng đồng thời để không ai nhận ra.
Cả hai đều vi phạm điều khoản của nhà cung cấp phía trên. Điều đáng nói không nằm ở khía cạnh đạo đức mà ở khía cạnh vận hành: những mô hình này không suy giảm từ từ, chúng hỏng toàn bộ cùng lúc. Dịch vụ chạy ổn nhiều tuần rồi một sáng thứ Ba mọi request đều lỗi.
Vì vậy thứ tự đánh giá là: hỏi nguồn trên trước, mọi thứ khác tính sau. Nhà cung cấp nói được model nào đi qua cloud nào là đang đưa ra một khẳng định kiểm chứng được. Nhà cung cấp chỉ nói "bên mình rẻ hơn" rồi né câu hỏi cũng đang nói với bạn một điều gì đó.
Ba rủi ro, và chúng dẫn tới bốn bài kiểm tra
- Ngừng hoạt động — rào cản gia nhập thị trường này rất thấp
- Âm thầm hạ cấp model — ngoài mặt là model flagship, bên trong route sang model rẻ hơn
- Riêng tư — prompt của bạn đi qua hạ tầng của bên thứ ba
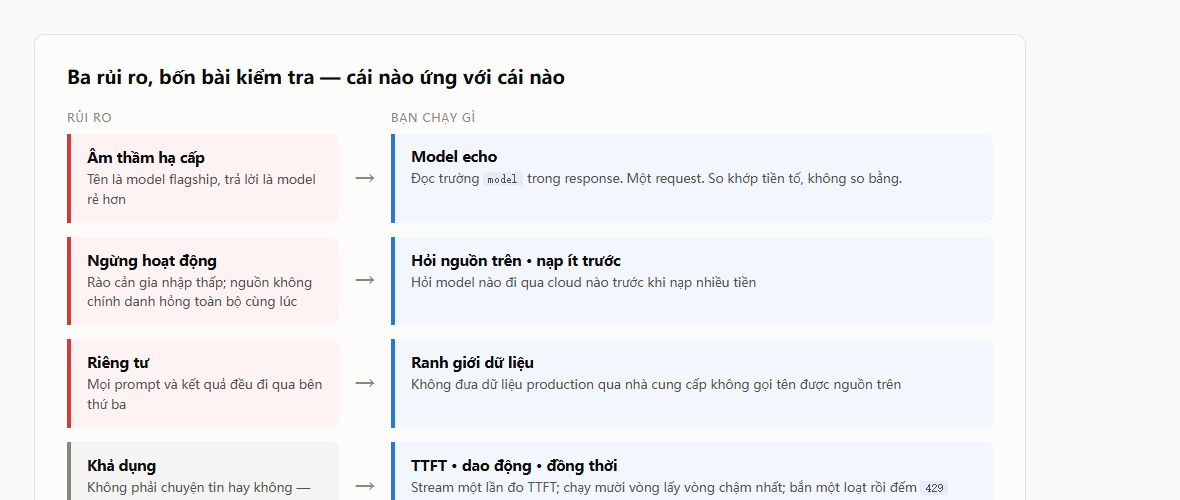
Hình minh hoạ do AI tạo, diễn giải nội dung đã mô tả trong bài. Không phải ảnh chụp màn hình.
3. Thực hành: bốn bài kiểm tra
| Kiểm tra | Chống rủi ro nào | Cách đánh giá |
|---|---|---|
| Model echo | Hạ cấp model | Trường model trong response có khớp với model bạn yêu cầu không |
| TTFT | Khả dụng | Thời gian tới chunk data: đầu tiên khi stream |
| Độ dao động | Khả dụng | Cùng một request chạy nhiều vòng, nhìn vòng chậm nhất |
| Giới hạn đồng thời | Khả dụng | Bắn một loạt request song song, đếm 429 |
Giải thích nhanh vài thuật ngữ. Model echo là trường
modelmà server trả về trong response — không phải thứ bạn gửi đi, mà là thứ server khai báo đã xử lý. TTFT (time to first token) là khoảng thời gian từ lúc gửi request tới khi nhận được ký tự đầu tiên. SSE (Server-Sent Events) là cơ chế server đẩy dữ liệu theo dòng, mỗi mẩu là một dòng bắt đầu bằngdata:. 429 là mã HTTP báo bạn đã vượt giới hạn tần suất.
3.1. Model echo — rẻ nhất, dễ bỏ qua nhất
Gửi một request bình thường, rồi bỏ qua hoàn toàn nội dung câu trả lời và đọc ba trường trong response:
curl https://api.crazyrouter.com/v1/chat/completions \
  -H "Authorization: Bearer $CR_API_KEY" \
  -H "Content-Type: application/json" \
  -d @req.json
Điều cần nhìn:
Trường model phải trả về chuỗi phiên bản đầy đủ có kèm ngày. Yêu cầu gpt-4o-mini mà nhận gpt-4o-mini-2024-07-18 là đúng — phía trên đã mở rộng tên viết tắt, nên khi viết assert bạn dùng so khớp tiền tố chứ đừng so bằng. Nhận về model của một hãng khác thì không đúng, và đó là lúc nên dừng lại hỏi cho rõ.
Cạnh đó còn một tín hiệu nữa. Những trường như system_fingerprint và service_tier gần như không ứng dụng nào đọc tới. Một cổng thật sự chuyển tiếp endpoint chính thức sẽ giữ nguyên chúng — lọc bỏ còn tốn công hơn là để nguyên. Còn một pipeline dựng lại response từ nội dung chat thì không có gì để điền vào những trường đó, nên thường là bỏ trống luôn.
Suy ra một nguyên tắc nghe hơi ngược: một response gọn gàng đến mức đáng ngờ — chỉ đúng những trường bạn cần, không thừa thứ gì — đáng để nhìn lại lần nữa.
3.2. TTFT — hai cái bẫy
Thêm "stream": true rồi đo thời điểm chunk data: đầu tiên về. Có hai thứ sẽ làm sai số đo:
Dòng heartbeat của SSE. Endpoint này gửi một dòng : PING trước khi có nội dung thật. Theo chuẩn SSE, dòng bắt đầu bằng dấu hai chấm là comment — không bỏ qua nó thì cái bạn đo được là thời điểm heartbeat tới, và con số sẽ nhỏ hơn thực tế.
HTTP client không tự giải nén. Nếu client không bật automatic decompression, stream nén gzip sẽ được đọc ra dưới dạng byte nén, không khớp được dòng data: nào cả — trong khi status code vẫn là 200. Rất dễ kết luận nhầm là "nhà này không hỗ trợ streaming".
3.3. Độ dao động — nhìn vòng chậm nhất
Chạy lại cùng request mười lần với -w "%{time_total}\n" và nhìn vào kết quả chậm nhất, không phải trung bình. Chưa có hệ thống cảnh báo nào kêu vì một giá trị trung bình cả.
3.4. Đồng thời — đếm 429
Vẫn lệnh đó nhưng đổi sang -w "%{http_code} ", cho chạy nền, rồi đếm 429. Chạy tuần tự sẽ không phát hiện được giới hạn chỉ kích hoạt khi có đột biến. Với hai bài 3.3 và 3.4, đặt max_tokens nhỏ cho nhanh và tiết kiệm.
Một lưu ý khi viết script: lỗi bắt tay TLS dưới tải đột biến về dưới dạng exception của tầng transport, không phải HTTP status. Nếu chỉ kiểm tra status code thì sẽ bỏ sót, và script có thể dừng giữa chừng kéo theo mất hết kết quả đã thu được. Nhớ bọc try/catch.
4. Kết quả đo được
Windows 10.0.19045, PowerShell 7, ba vòng mỗi model, temperature=0:
| Model | TTFT (ms) | Trọn vòng (ms) |
|---|---|---|
gpt-4o-mini |
1509 / 2102 / 2454 | 1732 / 2309 / 2622 |
glm-5.3-flash |
1395 / 1526 / 1789 | 2339 / 2431 / 2558 |
deepseek-v4-flash |
1453 / 1486 / 2867 | 2402 / 2412 / 3681 |
Model echo khớp ở cả ba. Ngoài ra claude-haiku-4-5 trả về claude-haiku-4-5-20251001 và gemini-3-flash trả về gemini-3-flash-preview — đều là mở rộng phiên bản bình thường, không phải thay model.
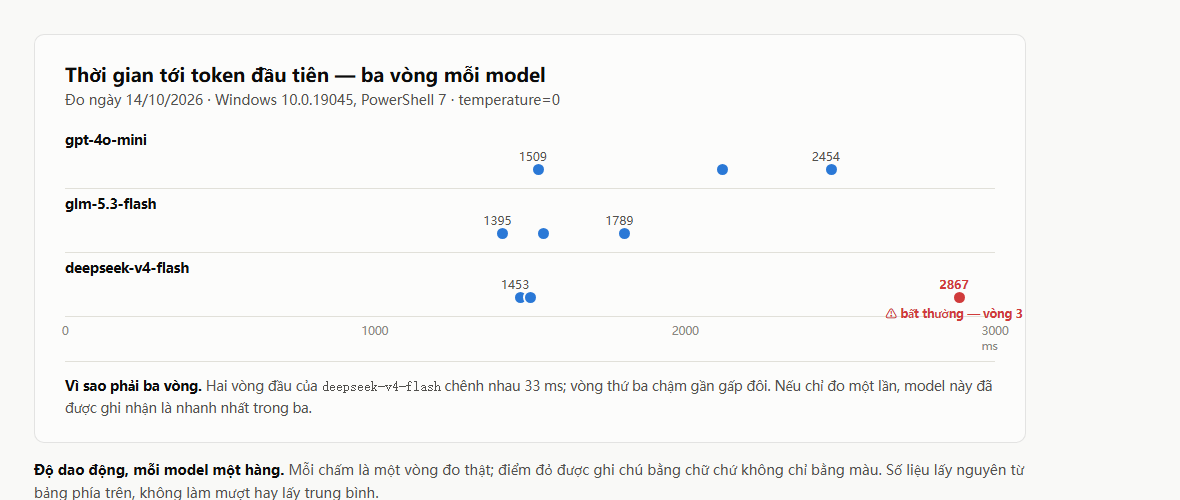
Biểu đồ do AI dựng từ chính các số liệu trong bảng trên. Không phải ảnh chụp màn hình.
Ba quan sát đáng giá hơn bản thân cái bảng:
Vòng thứ ba của deepseek-v4-flash là 2867 ms, so với 1453 và 1486 ở hai vòng đầu. Nếu chỉ đo một lần, model này đã được ghi nhận là nhanh nhất trong ba.
Mười request đồng thời không sinh ra 429 nào, nhưng có một request hỏng ở mốc 57 ms với lỗi The SSL connection could not be established. Retry xử lý được, nhưng nó chính là ví dụ cho lưu ý ở mục 3.4.
Ở một lần chạy riêng, một request gpt-4o-mini mất 77,6 giây trong khi các vòng khác của cùng model đều nằm trong hai tới bốn giây. Nếu client đặt timeout ba mươi giây thì riêng request đó đã là một sự cố production. Đây chính là lý do phải nhìn P100 thay vì trung bình.
5. Tổng kết và giới hạn
Hai giới hạn cần nói thẳng. Thứ nhất, các con số trên mô tả một điểm truy cập, ba model, một buổi chiều — điều kiện mạng, tải phía trên và phiên bản model đều thay đổi. Thứ chuyển giao được là phương pháp, không phải con số. Thứ hai, ba bài kiểm tra sau model echo nói về khả dụng, không nói về chất lượng: không có gì ở đây đo được model làm tốt tới đâu với bài toán của bạn.
Hướng đi thực tế mà nhiều nhóm chọn: dùng cổng trung chuyển cho phát triển, đánh giá model và các luồng không quan trọng; còn phần nghiệp vụ trọng yếu thì đặt sau gateway tự dựng (One API, LiteLLM...) với ít nhất hai nguồn trên, để một nhà cung cấp biến mất chỉ là suy giảm chứ không phải sập. Dữ liệu nhạy cảm thì đừng đưa qua nhà cung cấp mà bạn không gọi tên được nguồn trên của họ.
Dịch vụ dùng để đo ở trên hiện liệt kê 171 model qua /v1/models; cloud nào phục vụ model nào xem được ở trang danh mục model, còn cơ chế chuyển tiếp được mô tả trong bài giới thiệu về API trung chuyển. Đổi base URL là bốn bài kiểm tra trên chạy được với bất kỳ nhà cung cấp tương thích OpenAI nào.
Nạp một khoản nhỏ, chạy bốn bài kiểm tra, rồi mới quyết định nạp bao nhiêu.
Nếu bạn từng bắt được trường hợp model echo không khớp, rất mong được nghe thêm ở phần bình luận — dữ liệu thực tế từ nhiều người vẫn hữu ích hơn bất kỳ bảng xếp hạng nào.
All rights reserved
