

ChatGPT và Codex: mình mở cái nào trước khi nhận ticket?
ChatGPT và Codex: mình mở cái nào trước khi nhận ticket?
Ticket vừa rơi vào Slack: log 500, vài dòng stack, đôi khi kèm cả repo. Lúc đó mình không hỏi “tool nào thông minh hơn”, mà hỏi kết quả mình cần nằm ở đâu. Nếu chỉ cần câu trả lời đọc được trong cửa sổ chat, mình mở ChatGPT trước. Nếu cần thay đổi file trong project, chạy test rồi đọc diff trước khi merge, mình mở Codex trước. Hai công cụ đều trả lời được câu hỏi và đều xử lý được việc nhiều bước; điểm khác nằm ở ngữ cảnh, công cụ và cách mình kiểm tra kết quả.[1][2]
Quy tắc chọn của mình ngắn gọn:
- Cần câu trả lời đọc được trong chat → bắt đầu với ChatGPT
- Cần thay đổi file + test + review diff trong project → bắt đầu với Codex
Có vùng chồng lấn. Đây không phải bảng xếp hạng.
ChatGPT và Codex khác nhau ở chỗ nào khi nhận việc?
| Việc mình đang làm | Mở ChatGPT trước | Mở Codex trước |
|---|---|---|
| Hiểu vấn đề | Giải thích khái niệm, bàn phương án, tóm tài liệu | Đi theo call chain trong file project, tìm chỗ implement thật |
| Xuất bản | Soạn mail, báo cáo, bảng so sánh | Sửa docs/config/code trong repo rồi xem diff |
| Xử lý chương trình | Giải thích lỗi, đưa ví dụ code để mình tự dán | Sửa file trong project được cấp quyền, chạy lệnh và test |
| Kiểm tra xong việc | Đối chiếu câu trả lời, số liệu, nguồn | Đối chiếu diff, output test và phần chưa verify |
Ví dụ câu “vì sao API trả 500”: chưa có code lẫn log thì ChatGPT giúp mình xếp các nguyên nhân theo sức mạnh bằng chứng và liệt kê thông tin còn thiếu. Đã có repo, bước tái hiện và lệnh test thì nhờ Codex đọc implementation thường sát việc hơn. Cả hai lối vào đều cần ngữ cảnh đủ; một câu “sửa giúp” hiếm khi đủ để nhận kết quả đáng tin.[1][3]
Khi nào mình giao việc cho ChatGPT trước?
Muốn làm rõ ý trước, mình viết thẳng vào ChatGPT:
“Trong đoạn log API này, những nguyên nhân thất bại nào có thể xảy ra? Xếp theo sức mạnh bằng chứng, rồi nói mình còn phải thu thập thông tin gì.”
Nó cũng tóm file, so sánh tài liệu, soạn nháp hoặc viết ví dụ hàm. Muốn nhận một file dùng được, mình ghi rõ input, rule xử lý, định dạng đầu ra và tiêu chí nghiệm thu trong cùng một tin nhắn; xong thì tự mở file để kiểm số, trích dẫn và format. ChatGPT có chạm được file, trang web hay tool ngoài hay không phụ thuộc cửa vào, quyền tài khoản và phạm vi mình thực sự cấp.[1]
Nó bàn được code và viết được đoạn ví dụ. Nhưng “đoạn code trông dùng được” khác với “đã sửa trong project của mình và qua test”. Cái trước nằm trong chat; cái sau cần ngữ cảnh project thật và kết quả chạy thật.
Khi nào mình giao việc cho Codex trước?
Codex hợp với việc mục tiêu rõ, cần chạy trong môi trường phát triển. Ví dụ:
“Endpoint login trả 500 khi username rỗng. Hãy tìm đường tái hiện trước, giữ nguyên format response hiện tại, sửa xong thì bổ sung test liên quan và chạy; cuối cùng liệt kê file đã đổi và phần chưa verify.”
Mô tả kiểu này chốt hành vi, phạm vi, ràng buộc và cách nghiệm thu. Codex có thể đọc file trong project được cấp quyền, sửa code, chạy tool sẵn có, rồi đưa diff kèm output test để mình review. OpenAI cung cấp Codex qua desktop app, CLI và IDE; cửa vào và quyền cụ thể phụ thuộc tài khoản cùng môi trường của bạn.[2][3][4]
Codex không chỉ để viết code. Docs và config nằm trong repo, sửa xong phải qua build check thì diff và lệnh chạy đã có giá trị. Nhưng có diff không đồng nghĩa đã đúng: “test pass”, “test chưa chạy” và “người chưa đọc” là ba trạng thái khác nhau; mình ghi riêng trước khi merge.
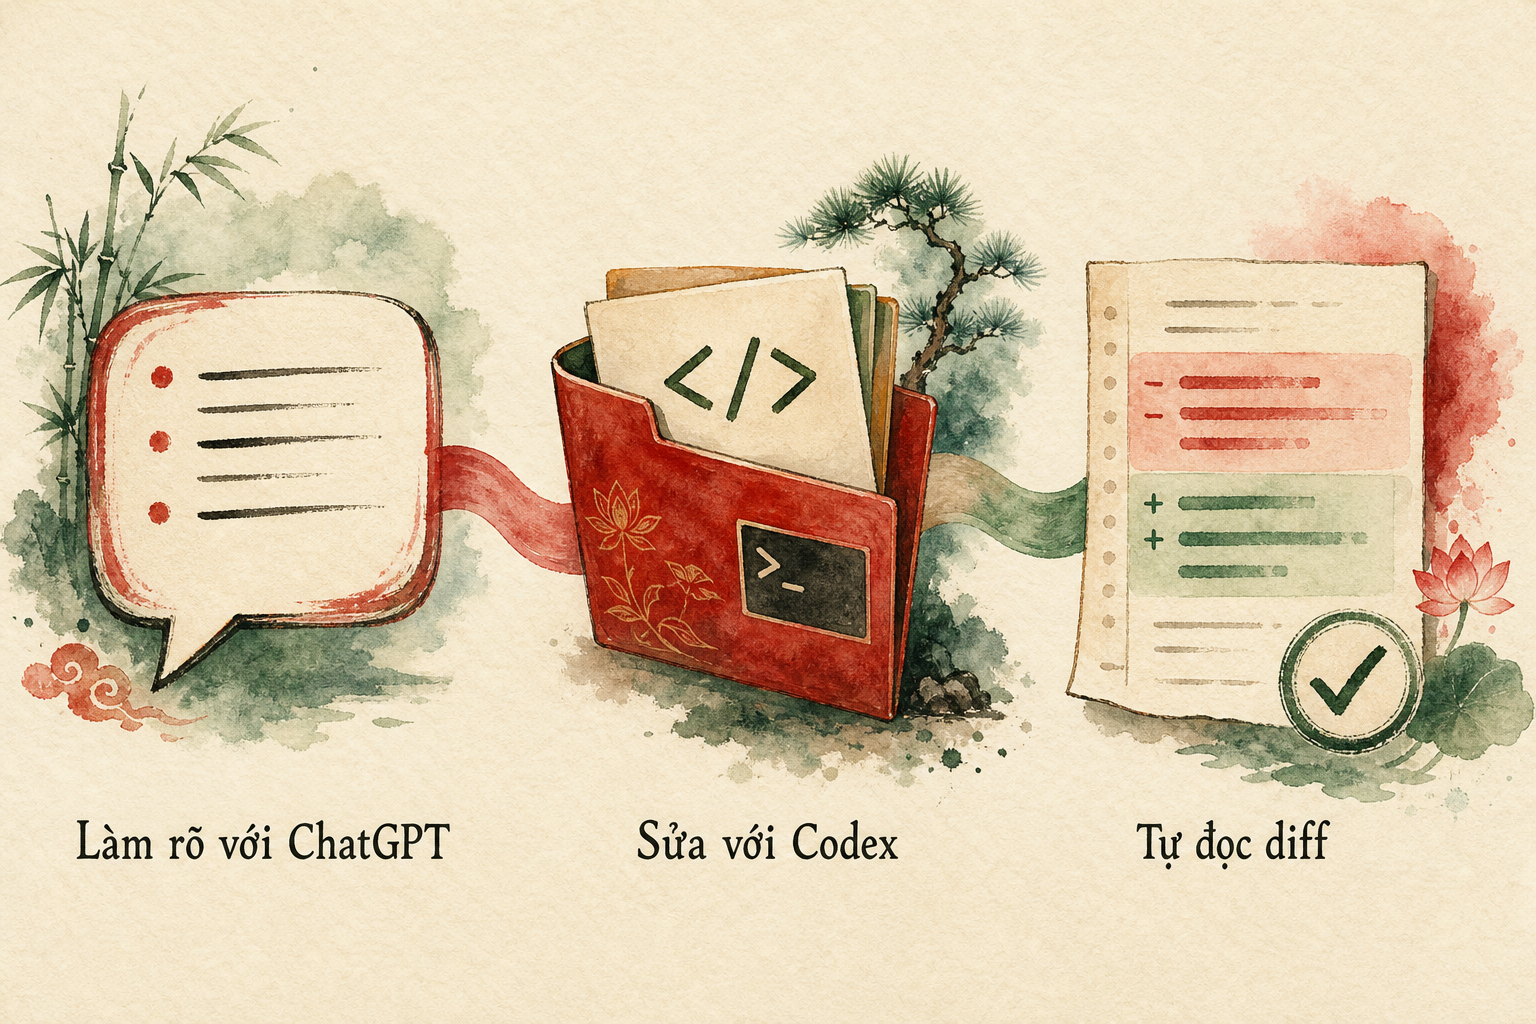
ChatGPT và Codex chuyển giao việc thế nào khi ticket chồng lấn?
Lấy lại case “500 khi username rỗng”, mình chia như sau.
- ChatGPT trước — chốt hành vi kỳ vọng: status code nên trả về, format response đã có, các biên thường bị bỏ quên. Nếu các fact này đã sẵn trong tay, bước này bỏ qua.
- Rồi Codex với yêu cầu bị giới hạn:
Tìm đường username rỗng kích hoạt 500. Giữ format response hiện tại; chỉ đụng validation và test. Viết trước test tái hiện vấn đề, chạy các test liên quan, rồi liệt kê file đã đổi, lệnh đã chạy và phần chưa verify.
- Cuối cùng mình đọc diff — test mới có thật sự phủ case ban đầu không, nhánh login khác có bị lệch không. Test nào chưa chạy thì ghi “chưa chạy”, không để chữ “xong” che mất. Hướng dẫn prompting của OpenAI cũng nhấn mục tiêu, ngữ cảnh và yêu cầu rõ ràng.[3]
ChatGPT, Codex và model API không cùng một lớp
ChatGPT và Codex là cửa sản phẩm cho người dùng; model API là kênh chương trình gửi request tới model chỉ định. Một lần gọi API thành công không chứng minh ChatGPT đã đọc file local bạn chưa chia sẻ, cũng không chứng minh Codex đã sửa project.[1][2]
Ngày 29/10/2026 mình gửi một request tóm tắt tiếng Trung không stream tới https://api.crazyrouter.com/v1/chat/completions, chỉ định gpt-4o-mini. Phản hồi HTTP 200, model thực tế trong response là gpt-4o-mini-2024-07-18, finish_reason là stop; 53 token prompt / 15 token completion / tổng 68 token. Đề bài yêu cầu không quá 20 chữ Hán, nhưng output thực tế có 22 chữ Hán — có nội dung nhưng chưa thỏa hết ràng buộc độ dài. Bản ghi đó chỉ chứng minh lần gọi API đó; không phải so sánh chất lượng giữa ChatGPT và Codex. Tài liệu Create Chat Completion của Crazyrouter mô tả field request và format response.[5]
Chưa tải Codex? Cài từ OpenAI rồi thử trên một vấn đề project nhỏ, cụ thể. Khi cần cấu hình Codex CLI với API bên thứ ba, xem hướng dẫn tích hợp Codex CLI của Crazyrouter. Cấu hình API bên thứ ba khác với quyền và hạn mức trong tài khoản sản phẩm OpenAI.
Mẫu prompt mình hay dùng với ChatGPT và Codex
Nhiệm vụ phân tích tài liệu cho ChatGPT:
Mục tiêu: So sánh ba báo giá và đưa đề xuất mua.
Input: Dùng ba báo giá mình đã upload.
Rule: Thống nhất đơn vị tiền và cách tính thuế; thiếu mục nào thì liệt kê riêng, không đoán.
Giao: Một bảng so sánh và đề xuất dưới 300 từ.
Nghiệm thu: Ghi rõ mỗi con số quan trọng lấy từ báo giá nào.
Nhiệm vụ sửa project cho Codex:
Mục tiêu: Sửa endpoint login trả 500 khi username rỗng.
Phạm vi: Endpoint, logic validate và các test liên quan.
Ràng buộc: Giữ format response hiện tại; không đụng module không liên quan.
Nghiệm thu: Bổ sung test tái hiện, chạy các test liên quan, nêu thay đổi và rủi ro còn lại.
Hai mẫu chung điểm: mục tiêu, input, rule, giao hàng, nghiệm thu. Việc Codex nên thêm đường dẫn project, bước tái hiện hoặc file liên quan; nếu không, bước đầu của nó sẽ mất vào việc tìm ngữ cảnh.
Lần sau đang phân vân, mình hỏi trước: mình cần câu trả lời đọc được, hay cần thay đổi có thể review trong project? Cái trước mở ChatGPT; cái sau mở Codex. Việc chồng lấn thì nhìn vị trí tài liệu, quyền tool và tiêu chí nghiệm thu — không biến hai cái tên thành ranh giới tuyệt đối của năng lực.
Nguồn (trang chính thức đối chiếu ngày 29/10/2026; API thực nghiệm ngày 29/10/2026):
[1] OpenAI, Use ChatGPT: phạm vi nhiệm vụ của ChatGPT và Codex, vùng chồng lấn, trình bày trên desktop.
[2] OpenAI, Codex: công việc project và công cụ phát triển.
[3] OpenAI, Prompting: mục tiêu, ngữ cảnh, ràng buộc và cách kiểm chứng.
[4] OpenAI, ChatGPT desktop app: cửa vào trên desktop.
[5] Crazyrouter Docs, LLMs Guide và Create Chat Completion; bản ghi request/response đã che khóa của lần gọi đơn lẻ.
All rights reserved
