

Cách đồng bộ hồ sơ trình duyệt giữa nhiều máy
Một đội bốn người ở TP.HCM thuê thêm một bạn làm ca tối. Sáng cấu hình 12 hồ sơ ở máy văn phòng, tối bạn ca tối mở máy ở nhà lên thì danh sách hiện đủ tên, nhưng đăng nhập lại từ đầu hết. Bạn quản lý nhắn cho mình: "Em tưởng lưu trên mây là mọi thứ sang hết, ai ngờ mới chỉ sang mỗi cái tên với cái nhãn". Mình nghe là biết ngay đội này đang gộp ba lớp dữ liệu khác nhau vào cùng một chữ đồng bộ.
Mình bảo họ tách ra mà nhìn. Phần siêu dữ liệu như tên, nhóm, nhãn, bộ thông số và cấu hình proxy vốn đã nằm trên máy chủ của BitBrowser, đăng nhập máy nào cũng thấy. Cái chưa sang là phiên đăng nhập, tức Cookie và vùng dữ liệu local. Và nếu muốn hai người cùng quản lý một nhóm hồ sơ, nên giao qua tài khoản phụ kèm phân quyền theo nhóm, thay vì chuyền file cho nhau. Đội sửa lại theo hướng đó thì ca tối hôm sau chạy bình thường, không còn cảnh đăng nhập lại mười mấy lần.
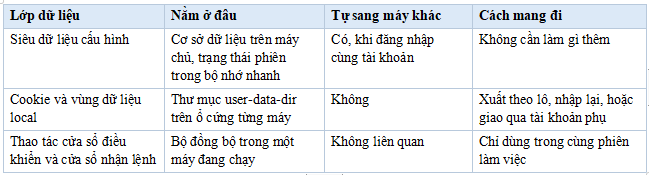
Có ba chữ đồng bộ đang bị dùng lẫn
Lớp thứ nhất là siêu dữ liệu cấu hình. Nó là các dòng văn bản nhẹ, thường nằm trong cơ sở dữ liệu trên máy chủ, còn trạng thái phiên hoạt động thì được giữ trong bộ nhớ nhanh để nhiều máy đọc cùng lúc. Đăng nhập ở máy mới, phần mềm kéo xuống và bạn thấy ngay danh sách hồ sơ. Lớp này vốn đã được thiết kế để đi cùng tài khoản, gần như không cần bạn làm gì.
Lớp thứ hai là trạng thái lúc chạy, gồm Cookie, localStorage, IndexedDB, bộ nhớ đệm, Service Worker và dữ liệu tiện ích mở rộng. Mỗi hồ sơ có một thư mục user-data-dir riêng ngay trên ổ cứng máy đó. Đây là phiên làm việc thật, là thứ giúp bạn mở lên đã ở trạng thái đăng nhập sẵn. Nó nặng, mang tính riêng tư và gắn chặt với máy đang chạy, nên không tự bay sang máy khác.
Lớp thứ ba là đồng bộ thao tác, kiểu đặt một cửa sổ điều khiển rồi để các cửa sổ còn lại nhận cùng một chuỗi bấm chuột và gõ phím. Cái này chạy trong cùng một máy, phục vụ việc làm đi làm lại nhiều cửa sổ cùng lúc, không phải chuyển dữ liệu giữa hai máy tính. Rất nhiều người nghe đến chữ đồng bộ là nghĩ ngay đến lớp ba, rồi thắc mắc sao cấu hình ở máy kia vẫn cũ. Điện thoại đám mây cũng có bộ đồng bộ thao tác riêng, cùng nguyên lý đó.
Vì sao không nên đẩy Cookie lên mây một cách vô tội vạ
Câu hỏi tiếp theo thường là vậy thì bật đồng bộ toàn bộ cho xong. Mình vẫn can. Một phiên đăng nhập không chỉ là chuỗi ký tự, nó đi cùng địa chỉ IP, múi giờ và bộ thông số thiết bị lúc phiên được tạo. Nếu hai máy cùng mở một hồ sơ, cùng dùng một Cookie, nhưng một bên đi proxy Singapore và một bên đi proxy Việt Nam, chuỗi tín hiệu sẽ tự mâu thuẫn với chính nó. Thêm nữa, hai người cùng sửa một hồ sơ một lúc thì bên ghi sau cùng đè lên bên ghi trước, và chẳng ai biết mình vừa mất cấu hình nào.
Cách làm gọn hơn là để con người đi cùng phân quyền, còn dữ liệu đi theo một chiều rõ ràng. Chia hồ sơ theo nhóm thương hiệu hoặc nhóm cửa hàng, tạo tài khoản phụ với vai trò quản trị, quản lý, thành viên hoặc vai trò tùy biến, rồi chỉ cấp quyền đúng nhóm người đó phụ trách. Ai làm ca nào thì đăng nhập máy đó và kéo cấu hình xuống, không cần copy thư mục. Khi thật sự cần mang cả phiên sang máy khác, dùng chức năng xuất Cookie theo lô, lưu mỗi hồ sơ thành một tệp văn bản đặt theo số thứ tự cửa sổ, gom lại rồi nhập ở máy mới. Với cấu hình, xuất ra file Excel rồi nhập lại để cập nhật hàng loạt, nhưng nhớ giữ nguyên cột mã định danh, vì sửa cột đó là toàn bộ lô cập nhật sẽ không khớp.
Trường hợp bàn giao cho người ngoài đội hoặc chuyển hẳn quyền quản lý, dùng liên kết chia sẻ có mật khẩu kèm thời hạn rồi làm bước chuyển quyền sở hữu, gọn hơn nhiều so với gửi file qua chat. Sau mỗi lần dời máy, nên đối chiếu lại IP, múi giờ và ngôn ngữ, vì đây là chỗ dễ lệch nhất. Một lưu ý hay gây kẹt: cùng một tài khoản chính không nên đăng nhập song song trên nhiều thiết bị, đội đông người thì chia tài khoản phụ theo số ghế của gói dịch vụ. BitBrowser, Hidemyacc, GPMlogin, Gemlogin và Hidemium đều có dạng phân quyền hoặc chia sẻ riêng, khác nhau ở độ chi tiết của vai trò và thời hạn liên kết, bạn nên đọc kỹ trước khi chọn.
import requests

BASE = "http://127.0.0.1:54345"
HEADERS = {"x-api-key": "token-cua-ban"}

def lay_tat_ca():
    ds, page = [], 0
    while True:
        r = requests.post(
            BASE + "/browser/list",
            json={"page": page, "pageSize": 100},
            headers=HEADERS,
            timeout=30,
        ).json()
        batch = r.get("data", {}).get("list", [])
        ds.extend(batch)
        if len(batch) < 100:
            return ds
        page += 1

for hs in lay_tat_ca():
    if hs.get("timezone") != "Asia/Ho_Chi_Minh" and hs.get("proxyType") == "socks5":
        print("Can doi chieu:", hs.get("id"), hs.get("name"))
Đoạn trên chỉ là cách mình rà cấu hình lệch giữa các máy: kéo toàn bộ danh sách theo trang rồi in ra những hồ sơ có múi giờ không khớp. Chạy một vòng trước mỗi ca làm việc tốn chưa tới một phút, mà đỡ được mấy tiếng dò lỗi về sau. Nếu đội bạn có nhật ký thao tác, nên ghi cả thời điểm và người thực hiện thay đổi, để lúc có sự cố còn biết bắt đầu từ đâu.
Đồng bộ không phải một việc mà là ba việc, và chỉ có siêu dữ liệu là tự đi cùng tài khoản. Cookie gắn với đường mạng và bộ thông số lúc nó được tạo, nên việc mang sang máy khác cần có chủ đích, có kiểm tra lại. Cuối cùng, phân quyền theo nhóm và nhật ký thay đổi quan trọng không kém bản thân chức năng xuất nhập, nhất là khi đội có người làm ca tối như ví dụ đầu bài.
Nghề này đang đi dần theo hướng coi cấu hình hồ sơ như một dạng tài sản có phiên bản, đại loại như cách đội kỹ thuật quản lý mã nguồn, có lịch sử, có người phê duyệt, có bước kiểm tra trước khi áp dụng. Mình nghĩ AI sẽ vào ở khâu soát lỗi này khá tự nhiên, nhất là khi kết nối qua MCP để đọc nhật ký, so sánh cấu hình giữa hai máy và nhắc hồ sơ nào vừa đổi proxy mà quên đổi múi giờ. Với một đội đang lớn dần, lời khuyên thực tế vẫn là viết ra một quy ước đặt tên, một bảng phân quyền và một danh sách kiểm tra ngắn cho mỗi lần bàn giao máy. Những thứ đó nhàm chán, nhưng giúp ca tối khỏi nhắn hỏi ca sáng lần nữa.
All rights reserved
